
Starburst (Trino)
基于Trino的企业级湖仓分析平台。无需先将全部数据集中加载到一处,即可用SQL分析多个数据源。Starburst Enterprise和全托管Galaxy提供安全、治理与运维功能。
一条SQL连接多个数据源
无需预先将全部数据集中到单一存储,即可连接所需数据开展分析。
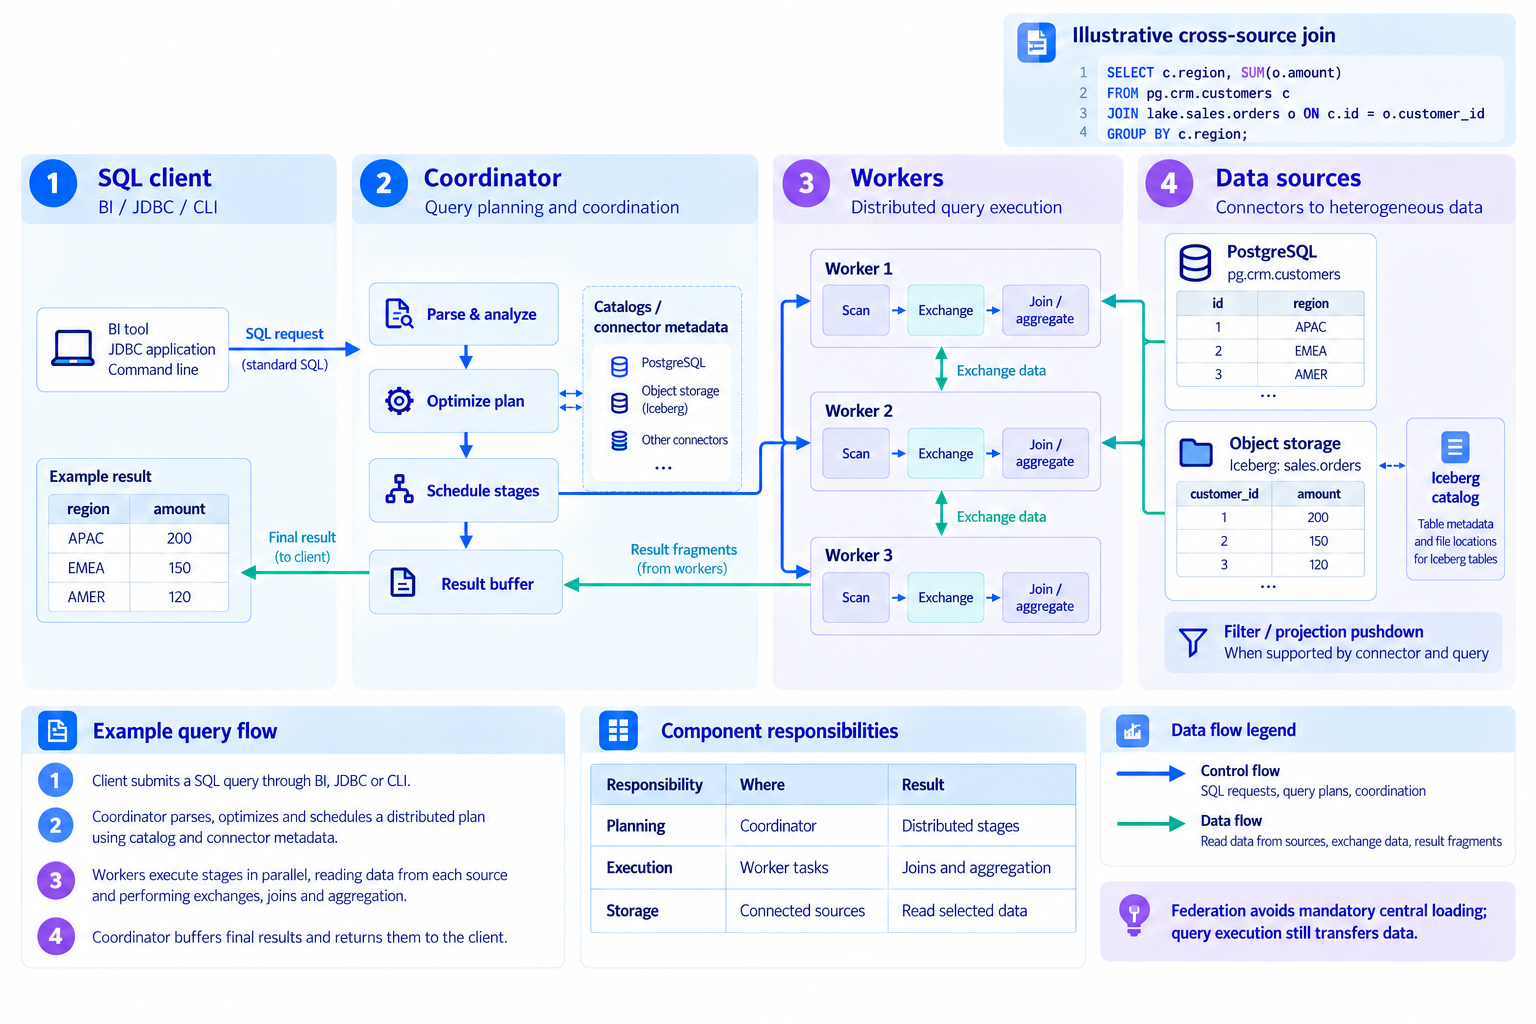
查看图示、产品与服务详情
- 1.SQL请求
- BI工具提交SQL,连接客户与订单表,按地区汇总订单金额。
- 2.执行计划
- 协调器解析查询,根据数据源和统计信息生成执行计划。
- 3.分布式处理
- 工作节点读取数据源,对返回数据进行连接与聚合;支持的条件和聚合可下推到源端。
- 4.数据源
- 按需读取PostgreSQL客户信息和Iceberg订单数据,并返回结果。
Starburst 与 Trino 概览
Starburst在Trino分布式SQL引擎基础上增加企业安全、运维与性能功能。通过连接器连接湖仓、数据库等数据源,无需预先将全部数据加载到一个位置即可开始SQL分析。应按产品和版本确认支持的数据源及功能。
- 基于 Trino 的 MPP 查询引擎:常驻协调器+工作节点架构,对 PB 级数据提供交互式响应
- 数据联邦:Iceberg、Delta Lake、RDBMS、NoSQL、Kafka、SaaS 等 50+ 连接器,单一 SQL 打通
- Warp Speed 加速:智能索引与缓存,查询最高提速 5 倍,CPU 最高节省 10 倍
- 企业级治理:行/列级 RBAC·ABAC、动态脱敏、Ranger 集成、查询审计
联邦查询性能受连接器、源系统负载、网络、数据分布和并发影响。重复查询可能更适合预计算或数据导入。
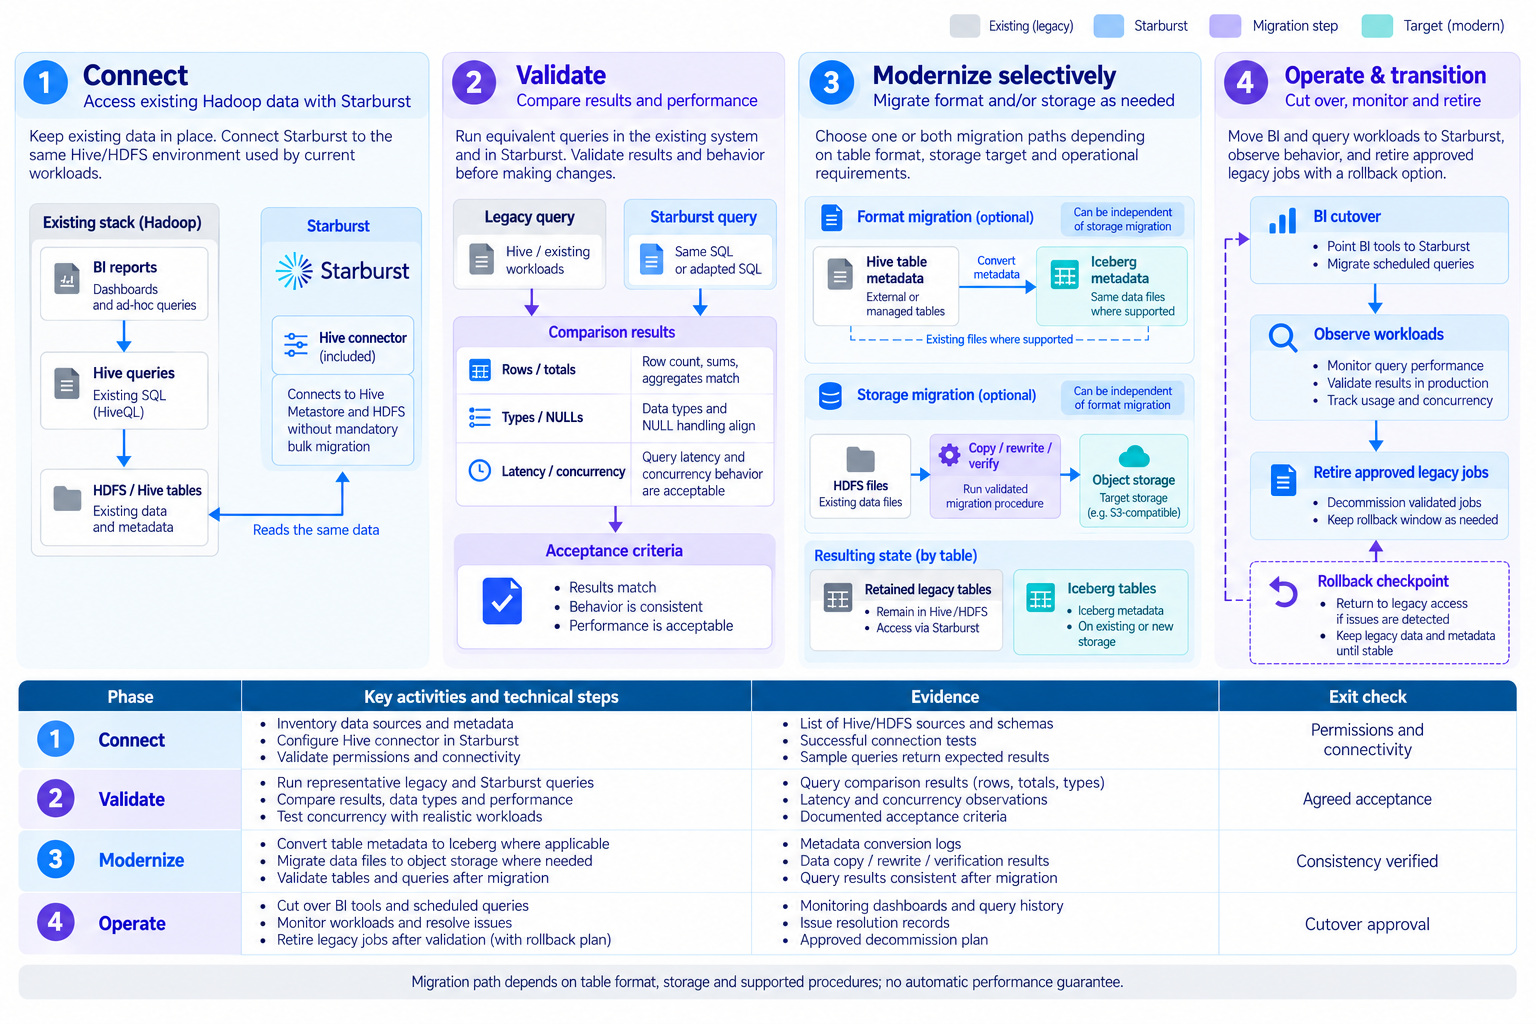
官方文档分阶段推进Hadoop与Hive现代化
通过连接、验证、选择性迁移和运维落地,逐步扩大迁移范围。
查看图示、产品与服务详情
- 1.连接
- 连接现有存储和元数据存储,检查权限与查询兼容性。
- 2.并行验证
- 并行执行部分分析查询,测量结果一致性、响应时间和源系统负载。
- 3.选择性迁移
- 区分表格式转换与存储位置迁移,选择受支持的流程,并验证数据、元数据及恢复步骤。
- 4.运维落地
- 建立监控、权限和培训体系,按验收与回退标准逐步扩大范围。
此图为迁移方式示例,不保证性能提升或零停机。需分别确认Enterprise与Galaxy的功能、部署方式及运维职责。
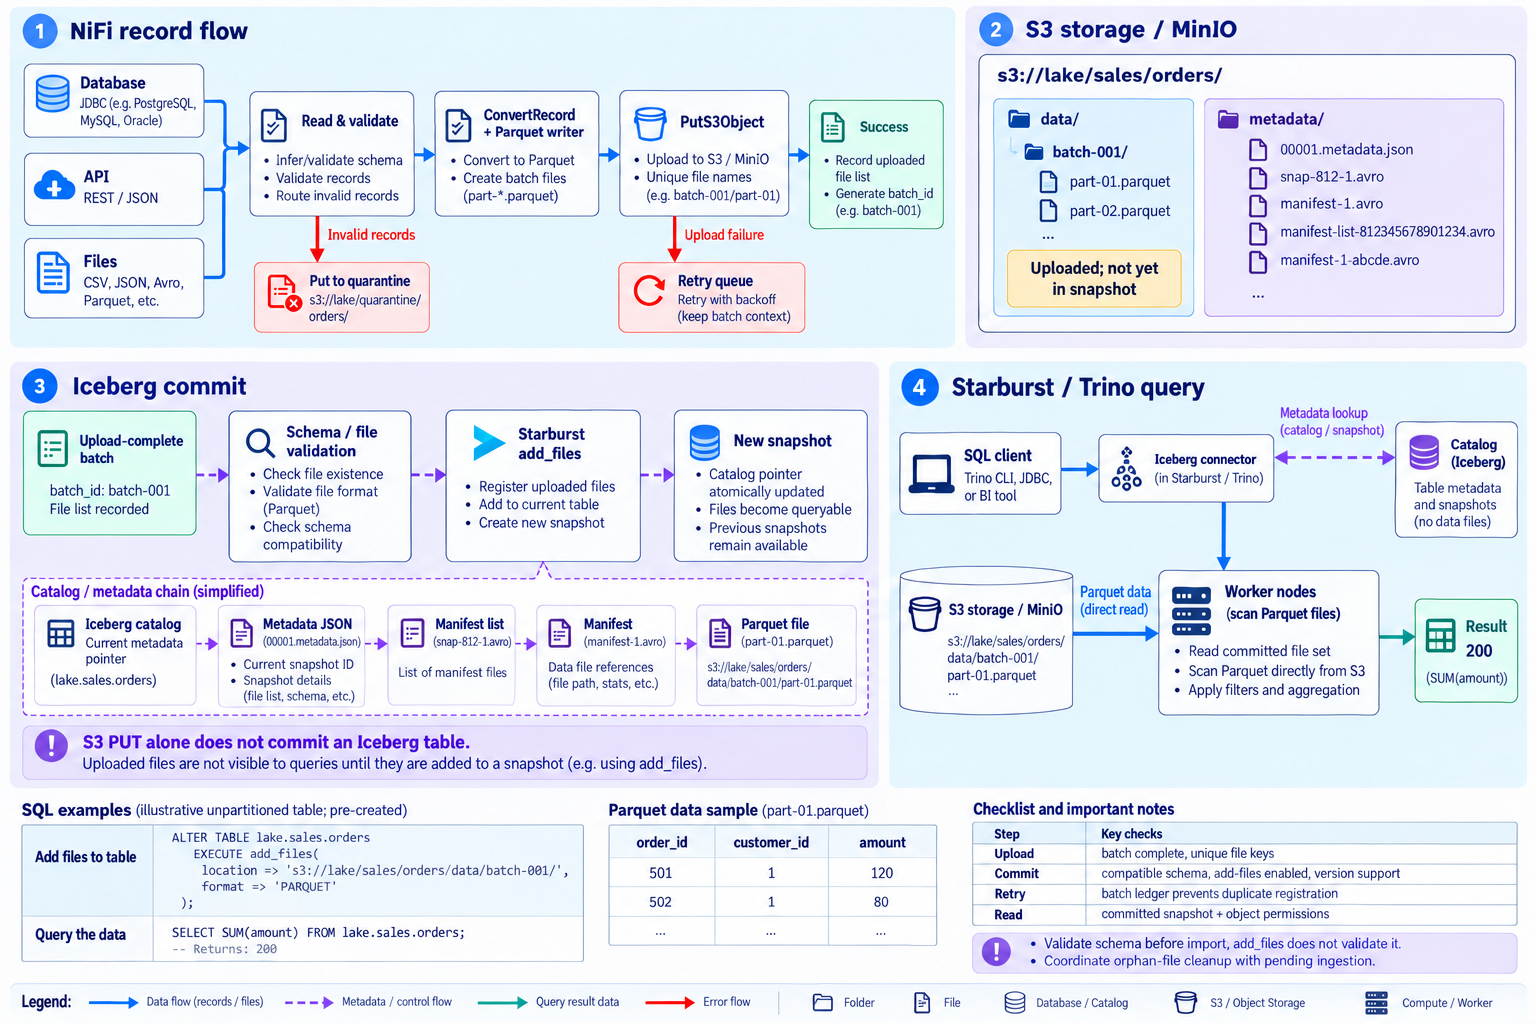
官方文档从 NiFi、S3 到 Iceberg 与 Starburst 查询
区分 Parquet 上传和 Iceberg 元数据提交,展示数据成为可查询表的过程。
查看图示、产品与服务详情
- 1.NiFi 记录处理
- 校验并转换为 Parquet,通过 PutS3Object 上传,记录成功批次的文件清单。
- 2.S3 文件存储
- 在 MinIO 等 S3 存储的表数据路径中保存文件。上传本身不会将文件加入 Iceberg 快照。
- 3.Iceberg 提交
- 事先校验批次模式,再通过 add_files 等支持的流程注册文件。add_files 本身不校验模式兼容性。
- 4.Starburst 查询
- 从目录解析已提交快照,工作节点直接读取引用的 Parquet 文件,区分元数据与数据路径。
示例使用预先创建的非分区表。检查 add_files 版本、配置、模式和权限,防止重复导入及清理尚未提交的文件。
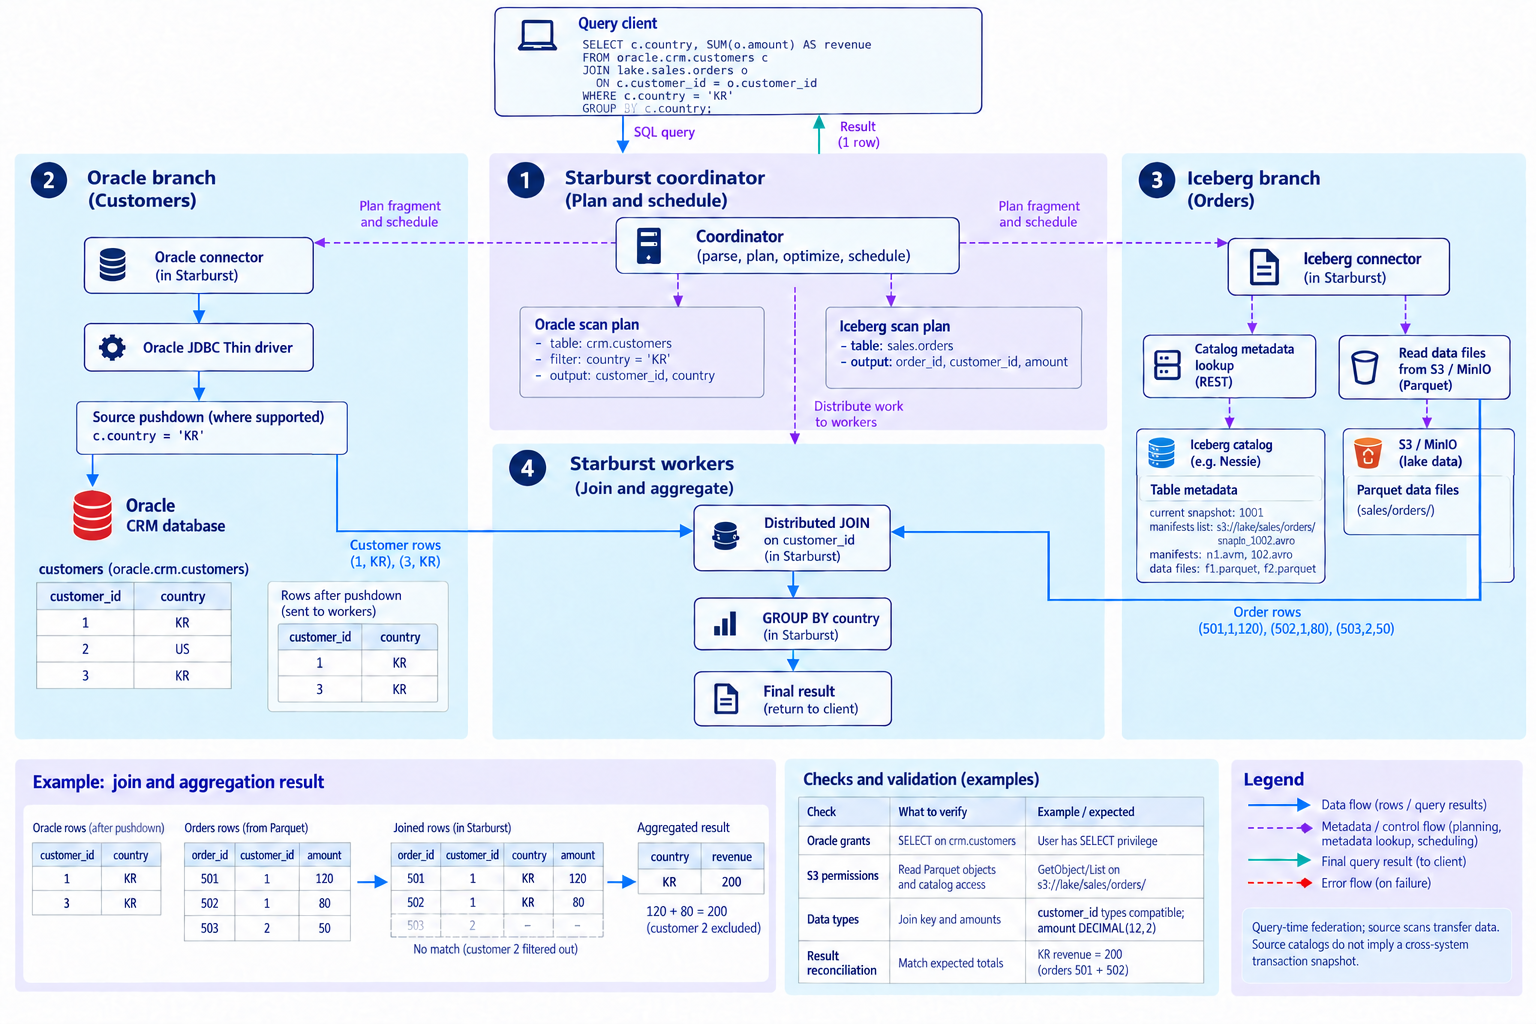
官方文档用一条 SQL JOIN Oracle 与 Iceberg
在 Starburst 工作节点中关联 Oracle 客户信息和 S3 上的 Iceberg 订单。
查看图示、产品与服务详情
- 1.业务 SQL
- 按 customer_id 关联客户与订单,按国家筛选并汇总收入。
- 2.读取 Oracle
- 使用 Oracle 连接器和 Oracle JDBC Thin 驱动,将支持的条件传递给数据库。
- 3.读取 Iceberg
- 分别解析目录中的已提交文件引用并读取 MinIO 或 S3 中的 Parquet。
- 4.分布式 JOIN
- 工作节点关联两侧输入。示例中 KR 客户的 120 和 80 两笔订单合计为 200。
图中的跨目录 JOIN 在 Starburst 中执行,不保证不同源系统具有同一事务快照。需验证关联键、类型和权限。
官方文档Oracle 下推与 Iceberg 扫描优化
区分 Oracle 的行列裁减与 Iceberg 的文件、列读取优化。
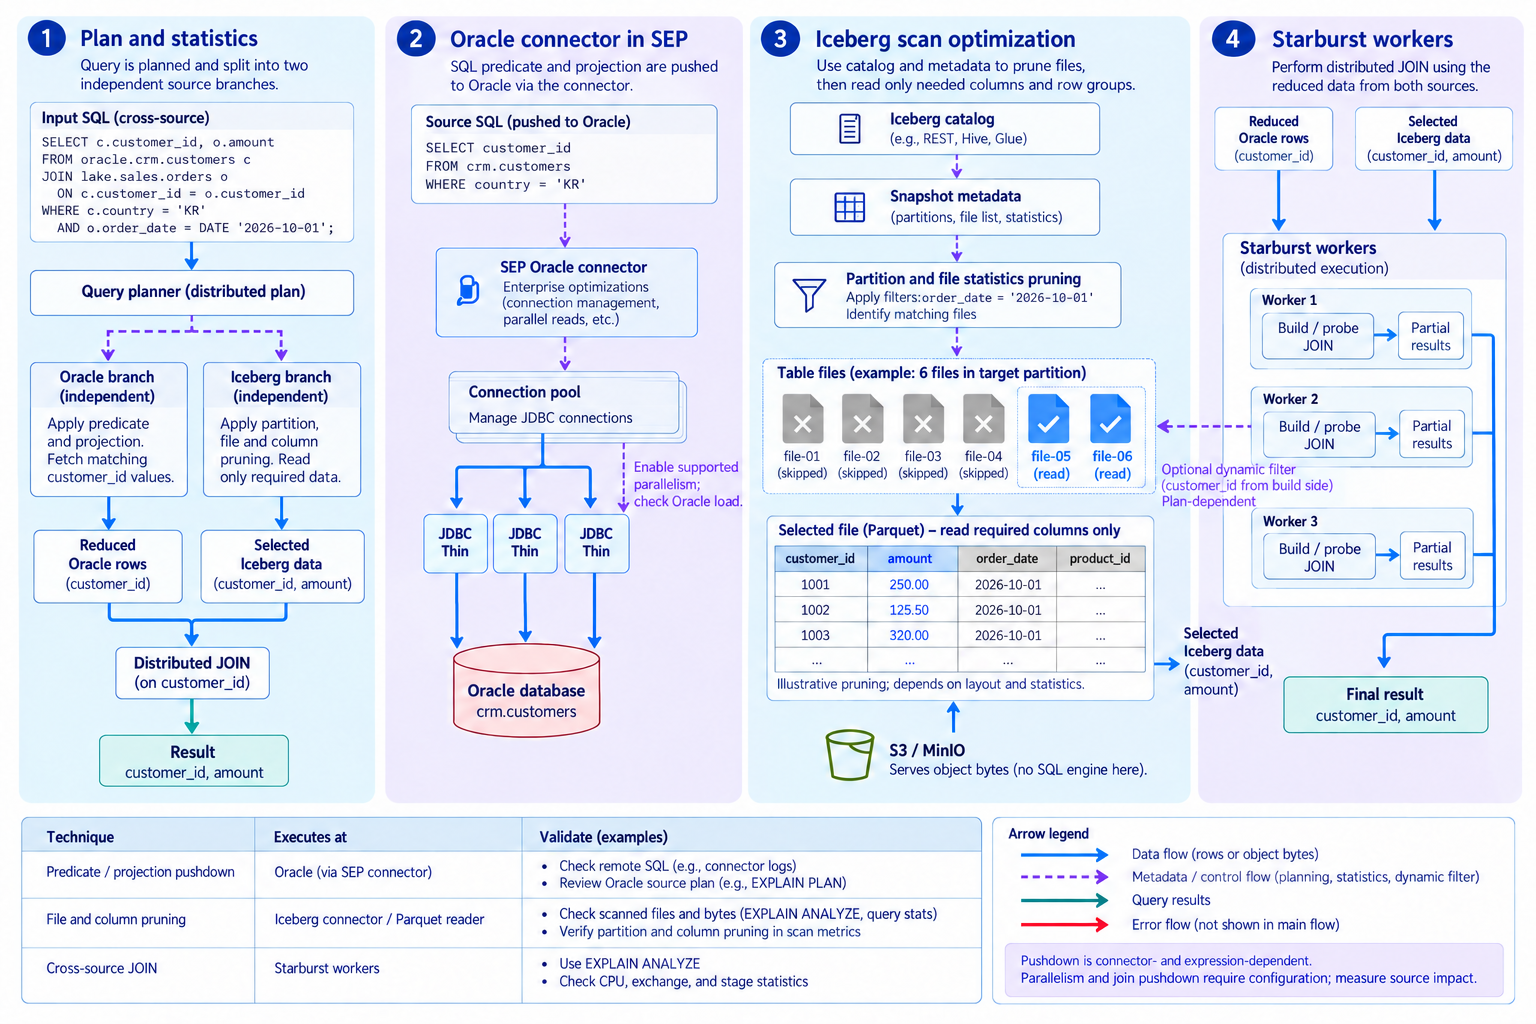
查看图示、产品与服务详情
- 1.计划与统计
- 根据条件和统计信息生成独立的 Oracle 与 Iceberg 扫描计划。
- 2.Oracle 优化
- 将支持的筛选和投影下推到 Oracle,并使用连接池与已配置的并行读取。
- 3.Iceberg 裁剪
- 利用分区、文件统计和 Parquet 列及行组读取减少扫描。S3 提供对象字节。
- 4.工作节点关联
- 在 Starburst 中关联缩减后的输入。动态过滤取决于执行计划,使用 EXPLAIN ANALYZE 和扫描量验证。
Oracle 连接器使用 Oracle JDBC Thin 驱动。需区分 SEP 连接器增强与驱动,通过执行计划和测量验证并行读取、下推条件及源库负载。
官方文档Starburst AI — 将企业数据连接到 AI 智能体
在数据联邦之上构建 MCP、自然语言分析、SQL AI 函数与 RAG,同时了解数据访问和模型上下文的传输路径。
文档核对基准:Starburst Enterprise 483-e STS · 2026-10-18。以下为参考流程;请确认部署版本、许可和模型的支持范围。
从企业数据到 AI 答案的三条连接路径
AIDA、外部智能体和 SQL 应用使用 Starburst 的数据访问基础。
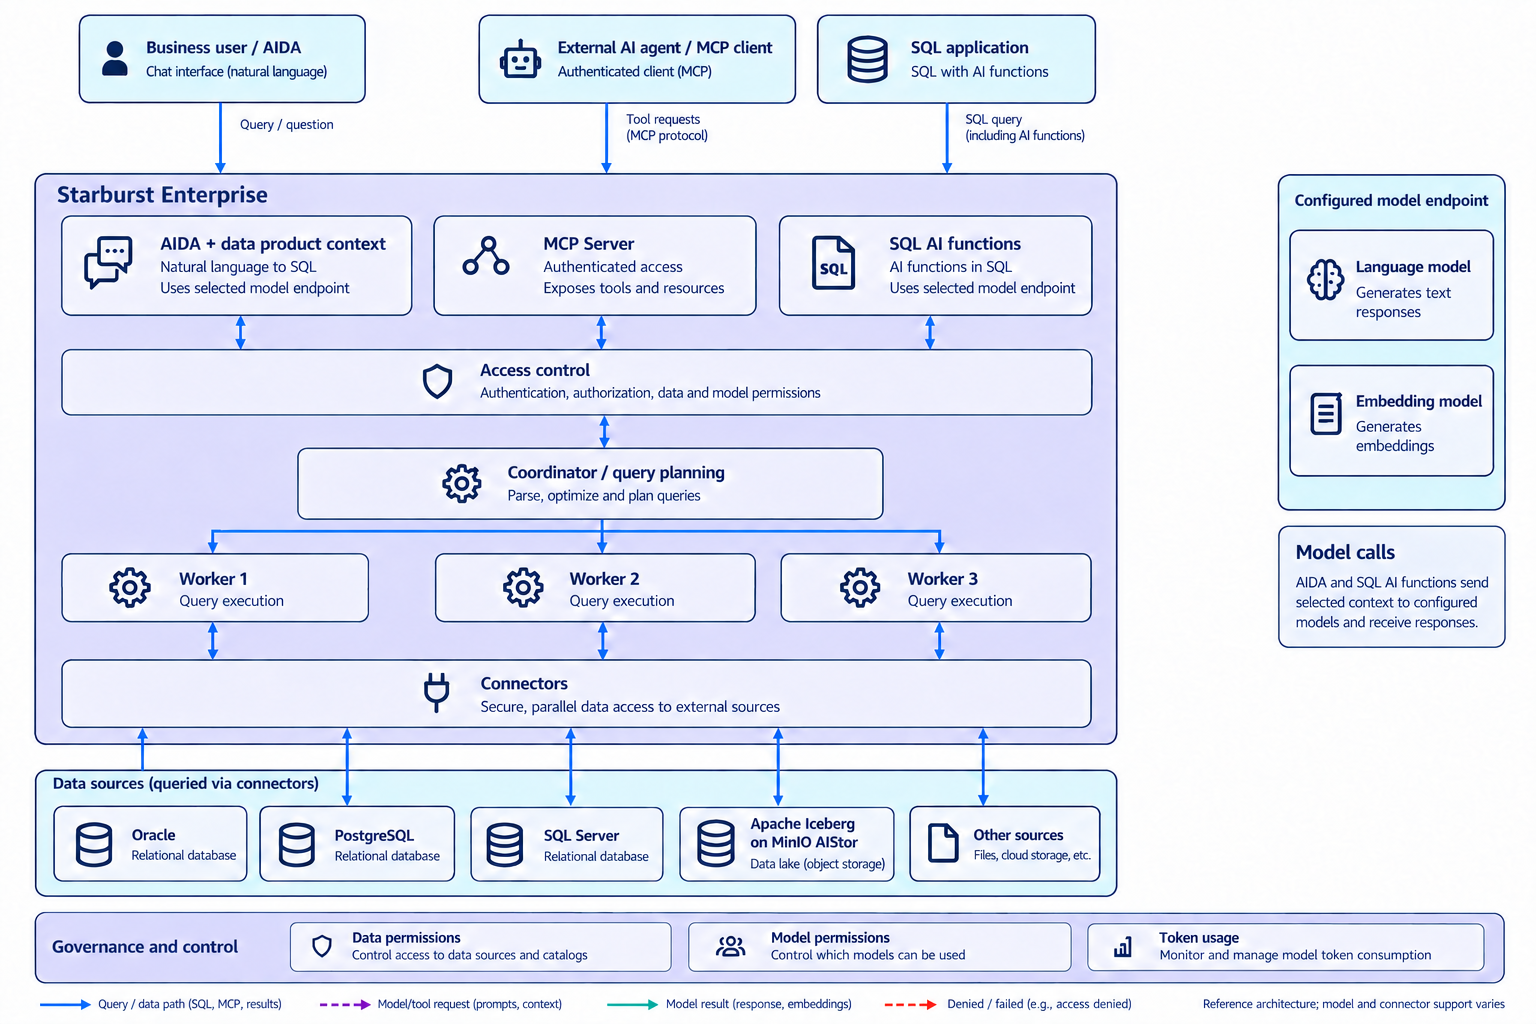
- 1.选择入口
- 业务用户使用 AIDA,外部智能体使用 MCP,开发者使用 SQL AI 函数。外部 MCP 客户端的模型配置独立于 SEP。
- 2.查询分布式数据
- 查询 Oracle、PostgreSQL、SQL Server 及 MinIO AIStor 上的 Iceberg 等数据。联邦减少全量预加载,但查询期间仍有数据传输。
- 3.连接模型上下文
- AIDA 与 AI 函数调用已配置模型。核实发送的问题、元数据、选定结果,并控制模型访问权限。
Starburst 并不训练或内置所有模型。需确认 AWS Bedrock、OpenAI 兼容 API 等连接方式以及各模型能力。
官方文档通过 MCP Server 为 AI 提供数据查询工具
经过认证的外部智能体可发现数据并获取只读 SQL 结果。
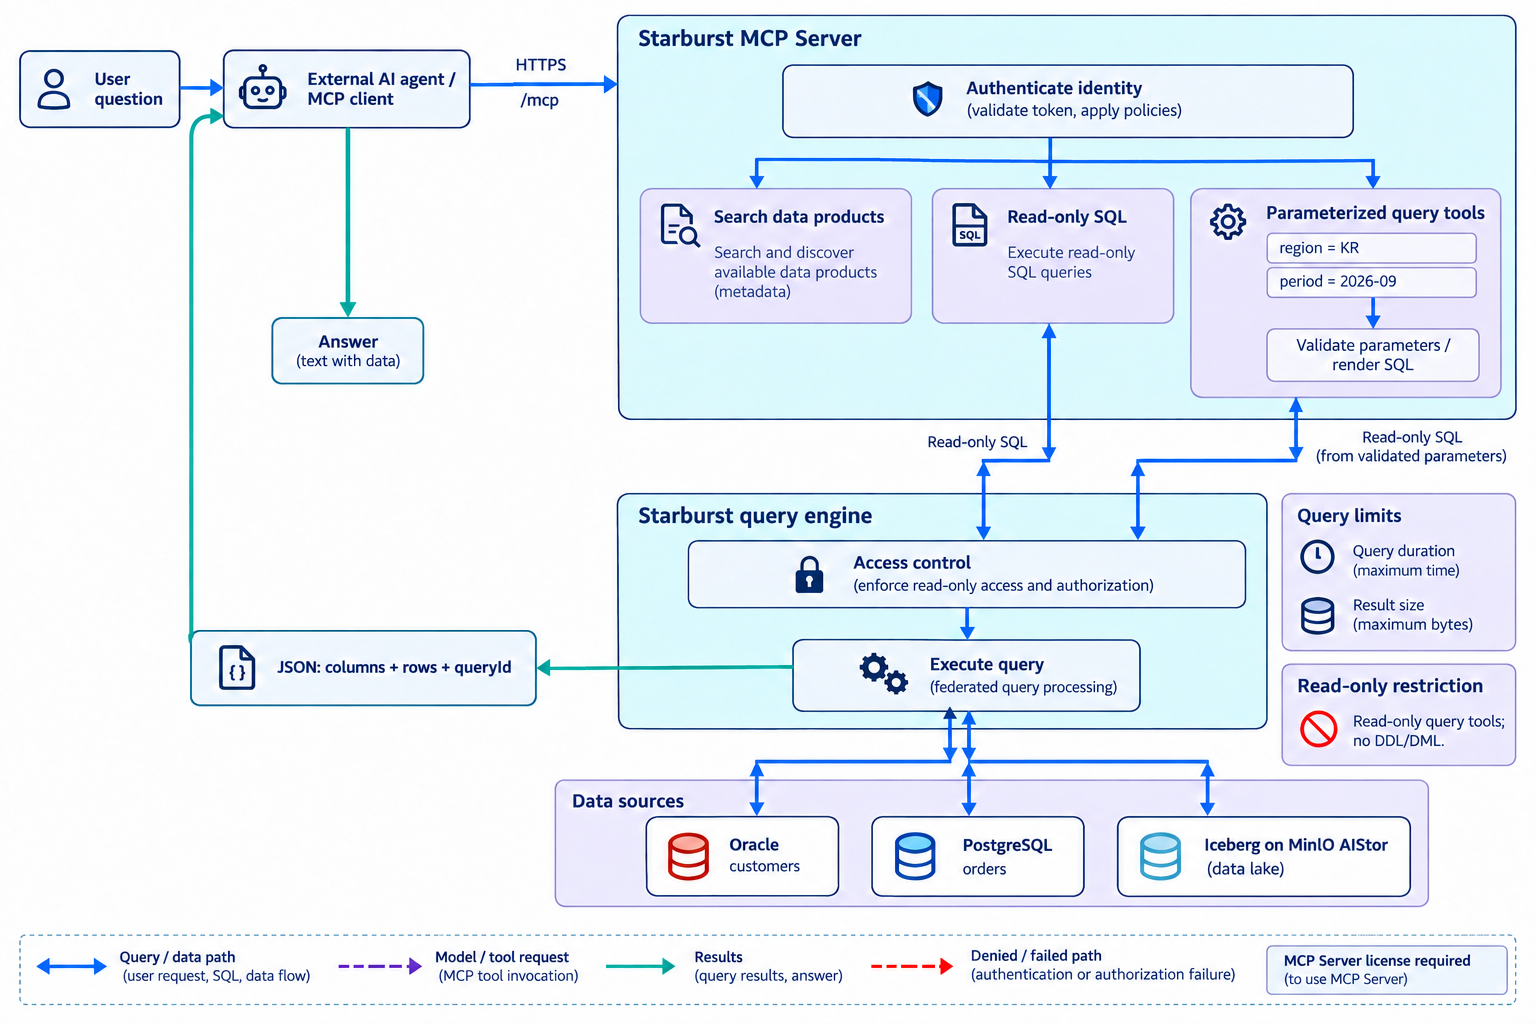
- 1.认证与发现
- 携带凭据连接协调节点的 HTTPS /mcp。需要时使用 searchDataProducts 等工具寻找合适的数据产品。
- 2.SQL 或参数工具
- 提交只读 SQL,或向预定义工具传入地区与期间。参数工具验证输入,并确保最终语句为只读查询。
- 3.执行与返回
- 以连接身份的权限执行分布式 SQL,返回包含 columns、rows、queryId 的 JSON,供外部智能体生成答案。
需要 MCP Server 许可。queryReadOnly 同步执行,并受执行时间与结果大小限制。这些工具不是通用数据库写入工具。
官方文档向 AIDA 提问并查看 SQL、表格和图表
数据产品描述与业务规则为自然语言分析提供上下文。
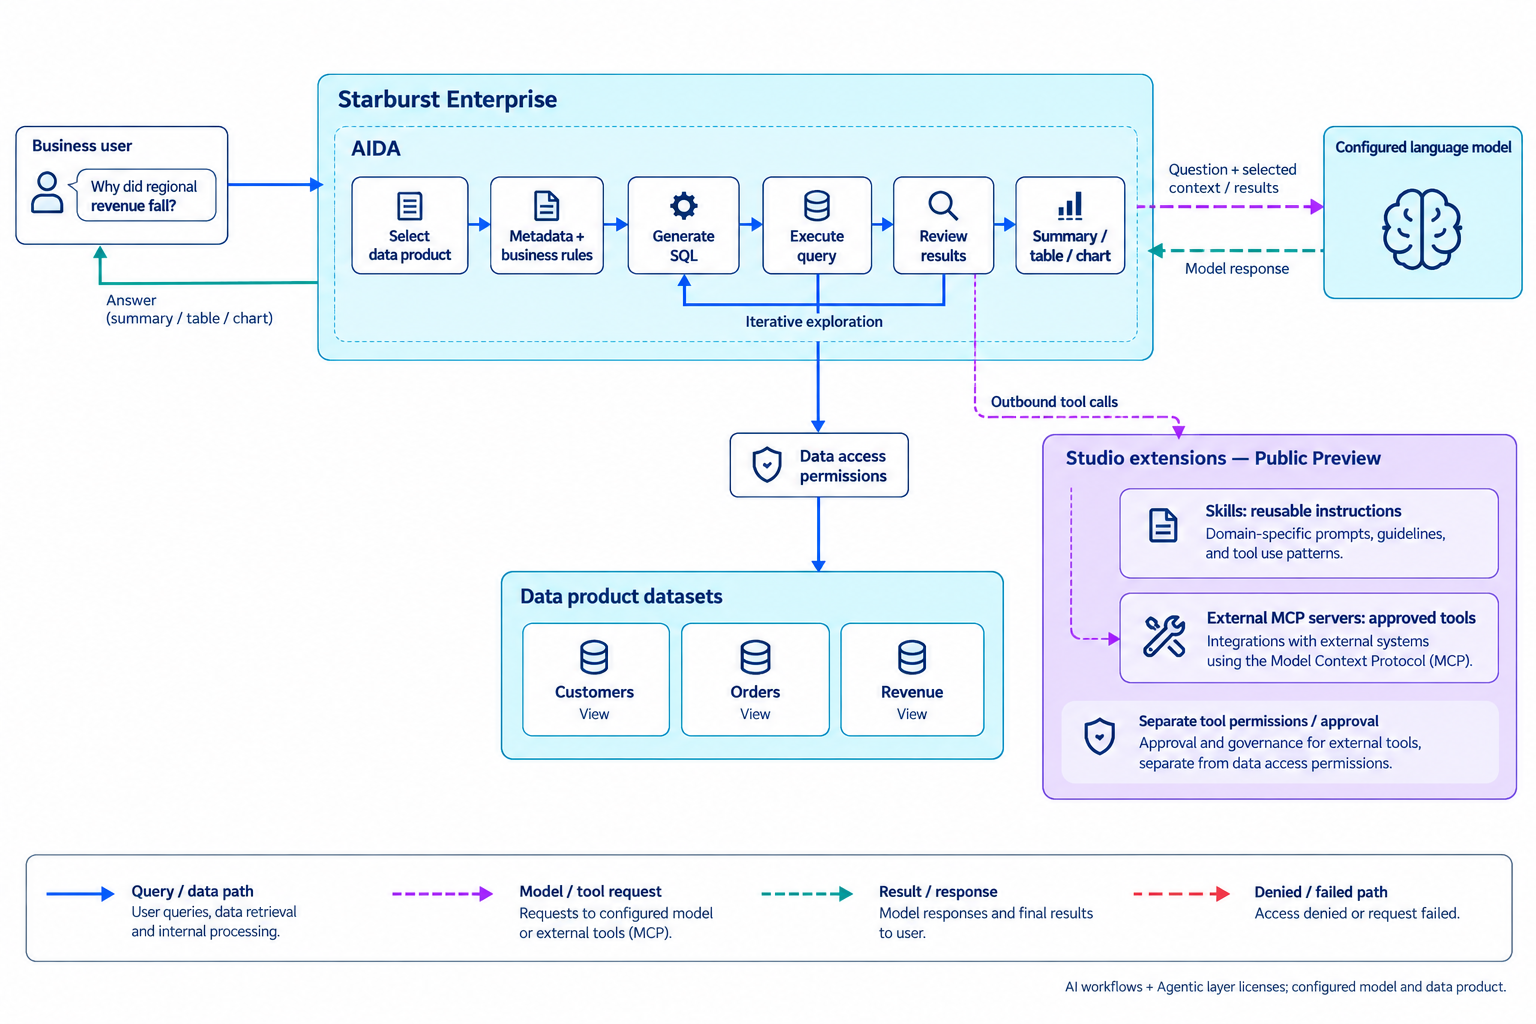
- 1.选择上下文
- 选择语言模型与数据产品,核实指标定义、时间约定和业务规则。默认分析范围为选定的数据产品。
- 2.提问、执行、核对
- AIDA 生成并运行 SQL,必要时进行探索查询和后续分析。核对 SQL、摘要、表格或图表,再逐步细化问题。
- 3.扩展外部工具
- 可选用 Skills 指令与外部 MCP 工具。AIDA → 外部服务器与外部智能体 → Starburst MCP 是不同方向;工具权限和调用审批需单独配置。
AIDA 需要 AI workflows、Agentic layer 许可、已配置模型及数据产品。Skills 和外部 MCP 连接为公开预览。
官方文档用 SQL AI 函数组合文本处理与 RAG
将嵌入生成、相似度检索和 LLM 调用融入数据流程。
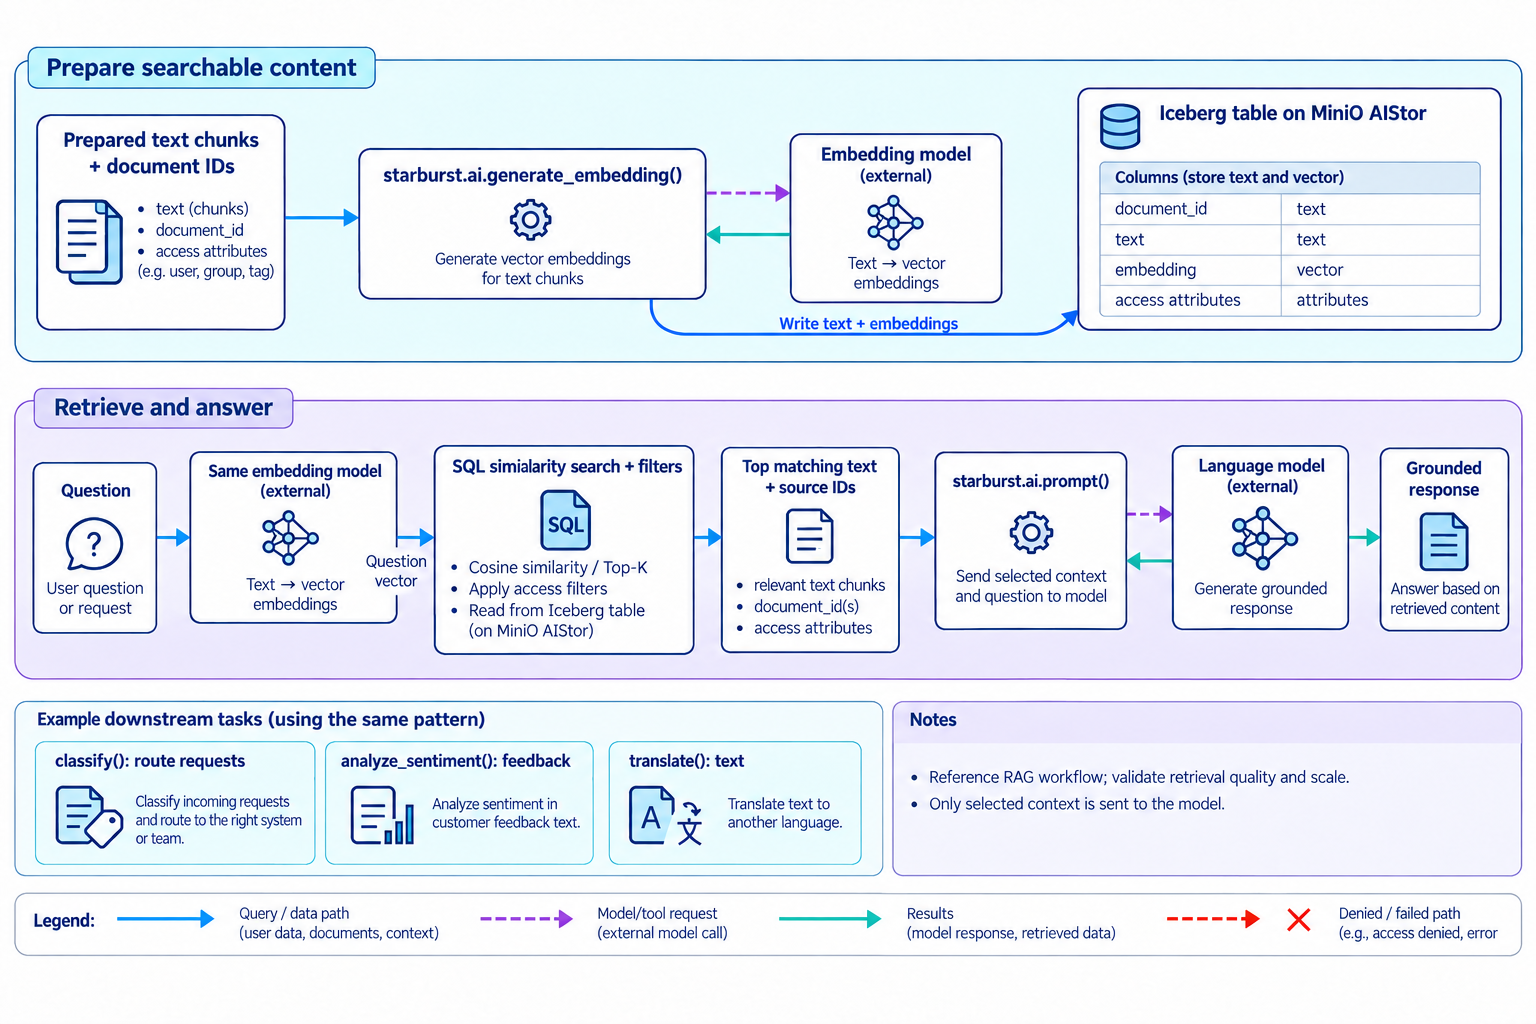
- 1.准备文本与向量
- 通过 starburst.ai.generate_embedding() 生成嵌入,将来源 ID、文本、嵌入及访问属性存入 Iceberg 等表。
- 2.检索并生成答案
- 用同一嵌入模型处理问题,通过相似度与过滤条件检索,将选定文本和来源 ID 传给 starburst.ai.prompt()。
- 3.用于业务 SQL
- 通过 starburst.ai.classify()、analyze_sentiment()、translate() 执行分类、情感分析与翻译。需要 AI workflows 许可、模型和内置访问控制。
这是参考 RAG 流程。PDF 解析与分块需单独准备,并验证检索质量、延迟、扫描量和模型成本;不意味着始终无需专用向量数据库或 ANN 索引。
官方文档完善数据产品描述,支持 AI 理解业务
AI 提出字段与数据集的含义建议,由负责人审核并保存。
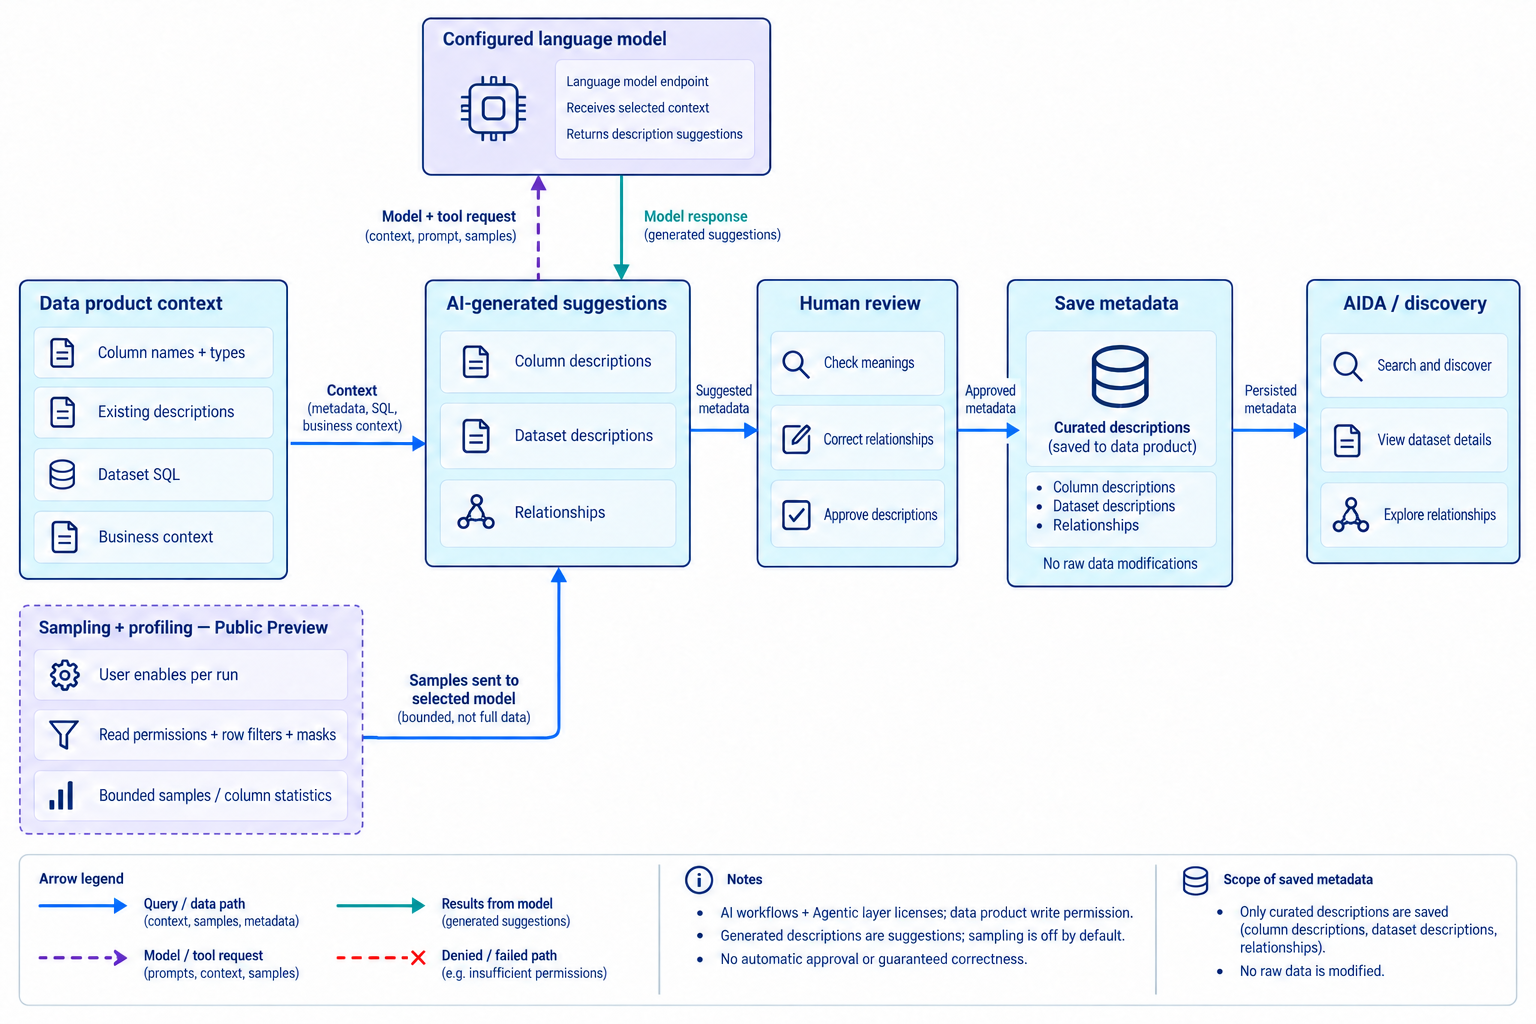
- 1.利用已有信息
- 根据字段名、类型、已有描述、数据集 SQL 和业务上下文生成字段、数据集及数据产品描述。
- 2.按需采样
- 用户每次运行单独启用,在其读取权限、行过滤与列掩码范围内收集有限样本和统计,并发送到选定模型。
- 3.人工审核保存
- 检查并修正推断的含义与关系后保存。更新的是描述,不是源数据值;可用于 AIDA 分析和数据发现。
需要 AI workflows、Agentic layer 许可及数据产品写权限。采样与剖析为公开预览,默认关闭。
官方文档分别管理数据权限、模型权限与 AI 行为
区分可以访问的数据、允许调用的模型和助手响应策略。
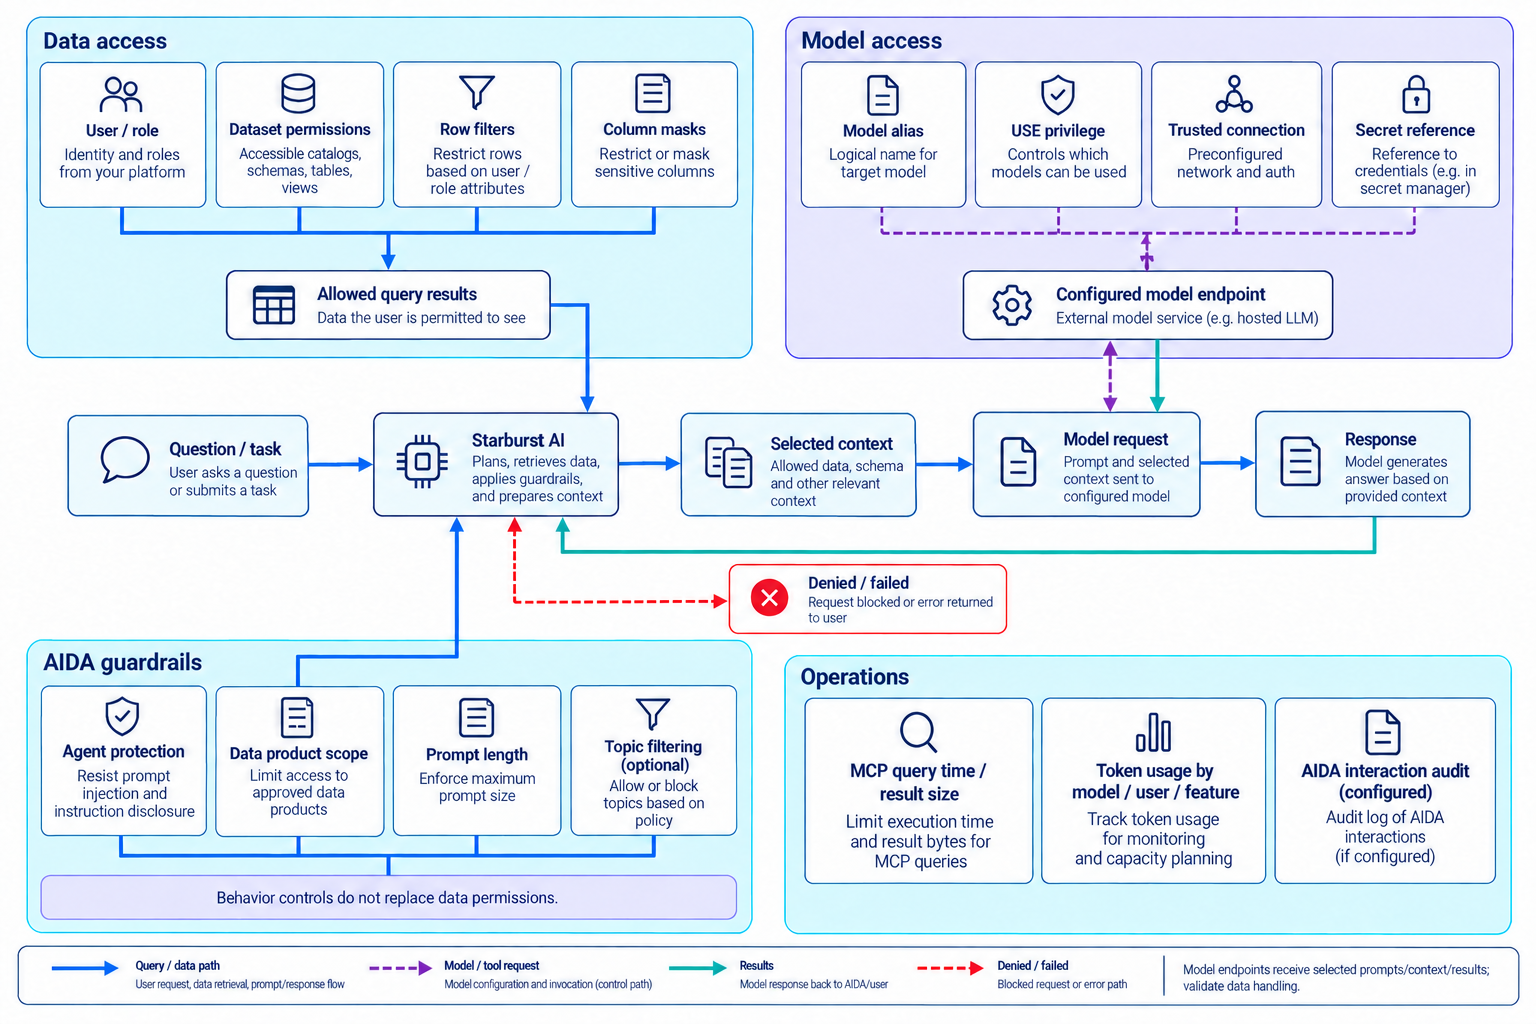
- 1.数据与模型权限
- 将数据权限、行过滤和列掩码与模型 USE 权限区分,通过机密引用管理 Trusted connection 的端点和凭据。
- 2.AIDA 护栏
- 配置智能体保护、数据产品范围、输入长度和可选主题过滤。部分控制依赖模型指令,仍需数据库安全控制。
- 3.监测与限制
- 按模型、功能和用户查看 Token 用量,限制 MCP 执行时间和结果大小,并配置运维所需的 AIDA 交互审计日志。
核实发往模型的问题、上下文和结果。不假定所有护栏拒绝事件均可在统一仪表盘审计。外部 MCP 工具权限单独管理。
官方文档功能要求与提供范围
按许可、连接配置和公开预览状态确定实施范围。
| 功能 | 许可与配置 | 需要核实的范围 |
|---|---|---|
| MCP Server | MCP Server 许可、服务启用和身份认证 | 只读查询、参数化工具、执行时间和结果大小限制。智能体工具还需相应的 AI 配置。 |
| SQL AI 函数与模型 | AI workflows 许可、已配置模型、内置访问控制 | 语言与嵌入模型能力、提供方 API 兼容性、调用费用与输出质量。 |
| AIDA | AI workflows + Agentic layer 许可、语言模型、数据产品 | 基于所选数据产品和业务规则分析,需核对生成的 SQL 和答案。 |
| 数据产品描述完善 | AI workflows + Agentic layer 许可、模型、数据产品写权限 | 采样还需数据读取权限。采样与剖析为公开预览,每次运行单独启用。 |
| AIDA 扩展 | AIDA 配置及功能相关的管理员与用户权限 | Skills 和外部 MCP 连接为公开预览。单独配置外部工具权限与调用审批。 |
| 运行管理 | 管理员权限和各功能配置 | 护栏、Token 用量及已配置的交互审计日志。用量报告与强制预算限制并不相同。 |
Data Dynamics 在确认 SEP 版本与合同范围后,支持模型连接、数据产品整理、MCP 工具设计、权限配置、典型问题验证及运维培训。图示为参考架构,并非产品截图或性能保证。
官方文档:AI Token 用量Data Dynamics 提供的服务
将产品和应用配置选择与需求分析、验证及运维交接相连接。
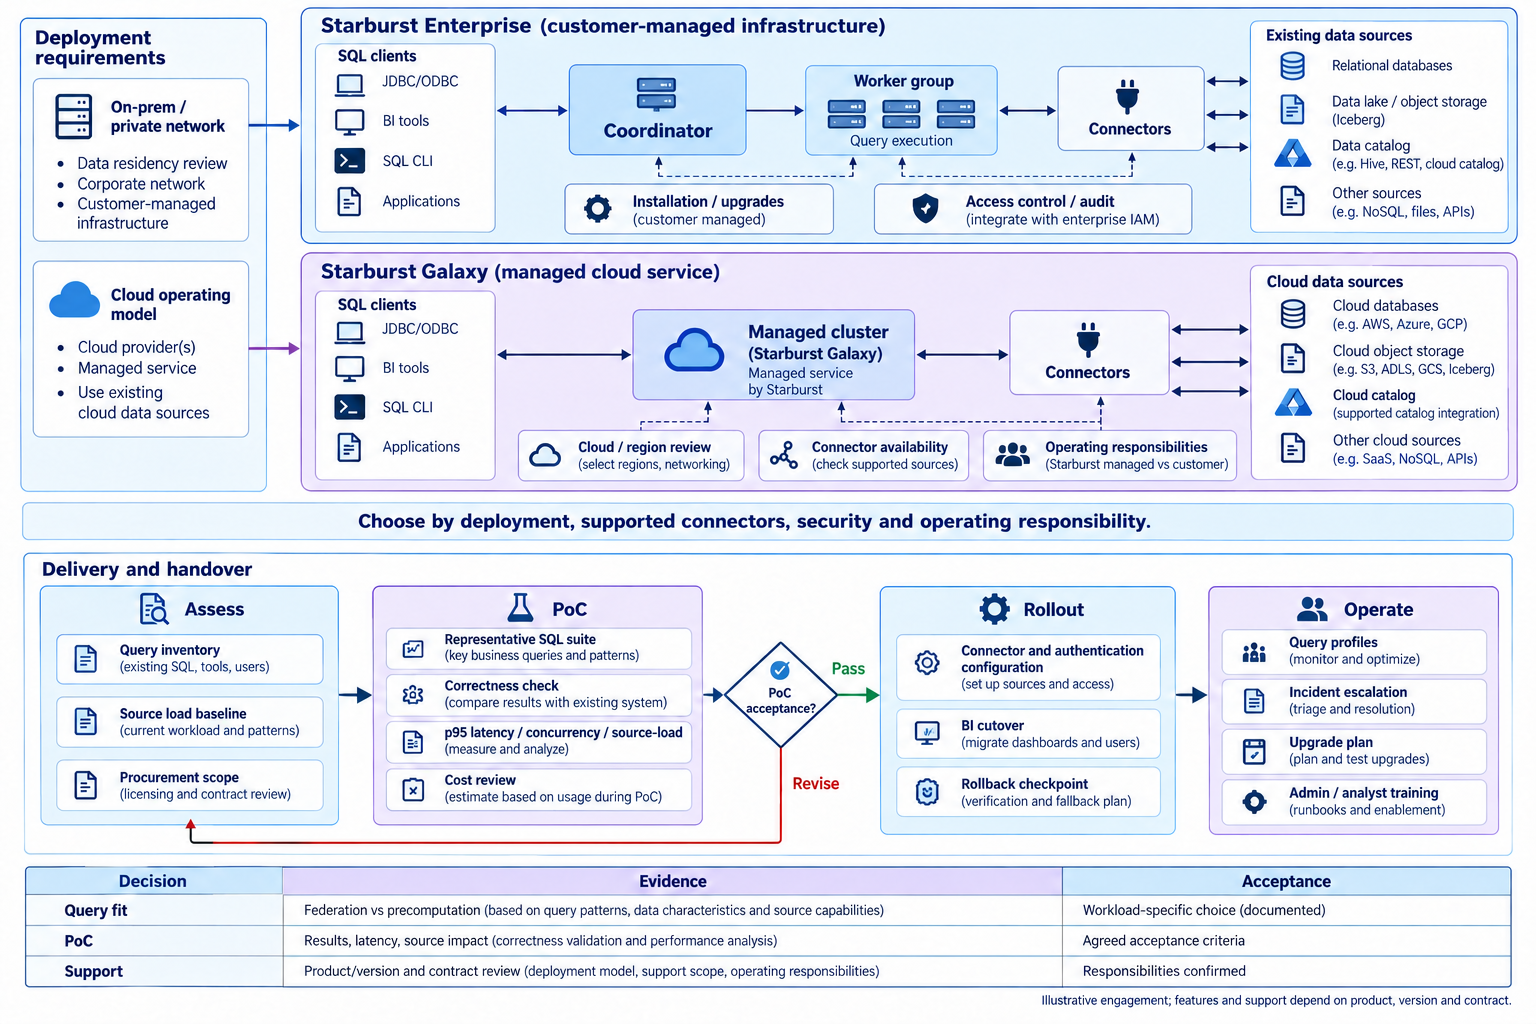
查看图示、产品与服务详情
- 1.需求分析
- 梳理现有系统、数据、工作负载和运维约束,确定实施范围。
- 2.产品与配置选择
- 根据应用目标评估产品、部署方式、容量、访问权限及采购范围。
- 3.验证与切换
- 使用代表性工作负载检查一致性、性能和集成,并评估验收标准与恢复流程。
- 4.运维与培训
- 通过监控、运维手册、升级计划和团队培训准备运维交接。
Starburst 产品家族
- Starburst Enterprise
直接部署在客户基础设施(On-prem·Private VPC)上的自管理商业 Trino 发行版。在保有数据控制权的同时使用企业级安全与运维能力,适合数据引力、网络隔离与合规驻留要求。
Self-managed · K8s · OpenShift · Ansible · LTS / STS · 数据主权 · 隔离网络
- Starburst Galaxy
运行于 AWS、Azure、GCP 的全托管 SaaS。集群自动扩缩容、按查询付费与跨云联邦,让您在几乎零运维负担下立即开始分析。
Fully Managed · Auto-scaling · Multi-cloud · Pay-per-query
以本地部署、私有环境为主的企业(尤其受监管行业)通常从 SEP 起步;云优先的组织则通常从 Galaxy 起步。
导入前共同确认的事项
结合实际数据需求和运营条件确定范围,而不仅是核对功能清单。
- 查询策略
区分适合联邦查询的数据和需要预处理、导入的数据。
- PoC验证
测量响应时间、并发能力、结果准确性、源数据库负载与执行成本。
- 部署与支持
确认Enterprise、Galaxy的连接器、功能、运维职责和合同支持条件。
Data Dynamics 提供的服务
- 许可销售
支持 Starburst Enterprise·Galaxy 许可的报价与订购。
- 按容量·节点测算
- PoC 许可支持
- 续订·扩容咨询
- 技术支持
提供覆盖实施到运维的 Starburst 全方位技术支持。
- 安装·升级支持
- 查询性能调优
- 故障响应·升级处理
- 培训 · PoC
提供 Trino·Starburst 技术培训及定制化 PoC。
- 管理员课程
- 数据分析师培训
- 定制 PoC 设计·执行
我们拥有基于 Trino·Iceberg·对象存储的湖仓建设与 Hive/Impala 迁移的实战经验,并在博客上持续公开相关技术资料。
图示为实施流程示例。产品和版本的支持范围、验收标准与服务范围需结合实际环境和合同确认。
查看 Starburst 功能对比、性能与客户案例
Trino 与 Starburst Enterprise 的关系
Starburst Enterprise是基于Trino的商业发行版,提供企业功能与支持。
Trino
开源分布式 MPP SQL 引擎(前 PrestoSQL)。常驻协调器+工作节点架构对 PB 级数据提供交互式响应,约每两周发布一个新版本。
Starburst
由 Trino 创始人创立的公司,2024 年贡献了约 84% 的 Trino 代码提交,是最大的 Trino 专家组织。
基于Trino的引擎
在上游Trino基础上加入产品特定功能、补丁与优化,需验证所选版本和配置的行为及性能。
扩展的能力面
在其之上叠加安全(BIAC·Ranger)、专属连接器、Warp Speed 加速、管理 UI·Insights、受支持的部署路径以及 24×7 支持合同。
SEP = Trino 引擎 + 企业级层
共同基于Trino并不保证所有版本和配置具有相同功能或性能。
Why Starburst — 四大核心价值
数据联邦
无需移动或复制数据,用单一 SQL JOIN 多个数据源 — 通过 ETL 预先集中数据的架构本身不再必要。
Iceberg 原生
完整支持隐藏分区、分区演进、时间旅行与 ACID,并自动化压缩、快照过期等表维护工作。
性能加速·稳定性
Warp Speed 智能索引与缓存带来查询最高 5 倍、CPU 10 倍的改善;容错执行(FTE)已针对最高 60TB 的批处理完成加固。
精细安全策略
行/列级 RBAC·ABAC、动态列脱敏、Apache Ranger 集成、查询审计 — 在平台层面满足受监管行业的要求。
连接器 — 覆盖企业数据的长尾
典型企业的数据往往存放在 Oracle、Teradata、SAP、Salesforce 等系统中。这正是 SEP 专属连接器占据许可价值相当大部分的原因。
SEP 专属连接器 (上游 Trino 没有)
Snowflake · Teradata · IBM Db2 · SAP HANA · Salesforce · Azure Synapse · Greenplum · Netezza · Cosmos DB · DynamoDB · Splunk · Neo4j · Generic JDBC · Stargate(跨集群联邦)
上游连接器的增强版
更强的下推、Warp Speed 集成、额外认证 — Hive · Iceberg · Delta Lake · Oracle · BigQuery · SQL Server · PostgreSQL · MySQL · MongoDB · Kafka · Elasticsearch · Redshift · ClickHouse 等
与上游 Trino 相同
DuckDB · Druid · Pinot · Prometheus · Redis · OpenSearch · Google Sheets 等全部社区连接器
判断标准:如果 "S3 + PostgreSQL 之上的 Trino" 就能覆盖需求,OSS 就足够了。当架构中出现 Snowflake、Oracle、Teradata、SAP、Salesforce 的那一刻,天平就倒向 SEP。
Apache Iceberg 湖仓 — 跨越分区之墙,运维亦自动化
Iceberg 是让对象存储上的文件堆像数据库表一样被使用的开放表格式。隐藏分区与分区演进是 Trino + Iceberg 的共同优势,SEP 则将其后剩余的运维课题(小文件、快照、统计信息)自动化。
Trino + Iceberg 的共同优势
- 隐藏分区 — 分区以列 transform(day·bucket·truncate)而非物理目录定义 — 仅凭原始列过滤即可自动裁剪,杜绝无意的全表扫描。
- 分区演进 — 无需重写数据即可变更分区策略 — 新旧规格并存时一条查询也能透明处理。
- ACID · 时间旅行 — 基于快照的事务、时点查询(FOR VERSION/TIMESTAMP AS OF)、模式演进,错误写入可通过快照回滚恢复。
- 清单裁剪 — 利用文件级 min/max 统计进行裁剪 — 无 RDBMS 元数据瓶颈,可扩展到数百万文件。
SEP 的增值 — 表自动维护
- 自动压缩 — 按计划自动执行 optimize(小文件合并)。
- 快照 · 孤儿文件清理 — 自动化 expire_snapshots · remove_orphan_files,防止元数据膨胀。
- 统计信息自动收集 — 保持 CBO 使用的表统计信息始终最新。
- 流式摄取 · 文件加载器 — 以托管方式提供从 Kafka 等到 Iceberg 表的持续加载 — 无需单独的 Spark/Flink 管道。
OSS Trino 也能手动或按计划执行相同命令,但运维责任落在平台团队身上。SEP 以托管·自动化方式提供这些能力,与 MinIO 等 S3 兼容对象存储结合即可构成完整的本地湖仓。
性能 — Warp Speed 与基准测试
按工作负载评估缓存、索引及数据布局的优化效果,以下数据来自特定基准测试条件。
查询执行时间缩短 — Warp Speed (TPC-DS SF1000)
CPU 时间节省 — Warp Speed
对比 Hive 的查询性能 (TPC-DS · Iceberg)
对比云数仓的成本效率
Warp Speed 效果 — 对比标准执行
标准执行 = 100 基准,越低越好 (TPC-DS SF1000 · Iceberg)
以标准执行为100归一化的基准示例,结果随产品、版本、配置和工作负载变化。
对比 Hive 的查询执行时间
秒,越低越好 — 1TB 源数据(S3·Parquet),Starburst 476-e vs Hive 3.1.3
来源:Concurrency Labs 基准测试报告 (2025-09) · TPC-H 9 节点 / TPC-DS 17 节点 (各 32 vCPU·128GB)
Warp Speed 智能索引·缓存
按块自动选择最优索引类型(bitmap·dictionary·tree),并将高频数据缓存到工作节点的 NVMe SSD — 无需人工索引设计即可加速重复性、选择性工作负载。
对比 Hive 最高 22 倍
TPC-DS·Iceberg 基准下 37,901 秒 → 1,737 秒(10.5 小时 → 29 分钟)。仅更换引擎即可获得 6~8 倍,迁移到 Iceberg 后可达 12~22 倍 — 无需大爆炸式切换即可逐步放大收益。
对比云数仓的价格性能
在开放表格式上执行 SQL 的基准下,查询最快提升 6.3 倍、成本最多降低 12.7 倍 — Runtime 与 Cost 同时处于最低区间的只有 Starburst。
容错执行 (FTE)
自动恢复长时批处理·ETL 查询,避免整体失败 — 已在最高 60TB 规模完成企业级验证。
性能数字基于 Starburst 公开基准测试,因工作负载而异 — 建议在采购前进行 PoC 验证。
安全与访问控制 — 受监管行业的基本功
认证方面 OSS Trino 已经足够。分水岭在于精细授权(Authorization)与审计 — 这正是金融、医疗、公共部门选择 SEP 的决定性原因。
Built-in Access Control (BIAC)
SEP 原生授权模型 — 以 UI 管理目录/模式/表/列/行级的基于角色(RBAC)与基于属性(ABAC)的权限。
列脱敏 · 行过滤
开箱即用的敏感列动态脱敏与行级过滤 — 满足个人信息、交易信息的保护要求。
Apache Ranger 集成
全局/目录/列/行级别 — 直接复用既有 Hive/HDFS 上的 Ranger 策略。
Credential Passthrough
Kerberos·密码凭证透传(含缓存) — 工作节点无需长期服务账号,以用户身份访问数据源。
认证集成
LDAP · OAuth2 · JWT · Kerberos 之外还包括 Okta 集成,并将用户模拟(Impersonation)普遍化。
Query Audit
持久记录谁在何时对哪个目录执行了什么查询 — 即时满足审计追踪要求。
实务效果:策略集中于一处(BIAC 或 Ranger),并统一应用到 SEP 暴露的所有连接器。
治理 · 运维 — 规模化运行后才显现的价值
这是纯查询引擎(Trino)与数据平台(SEP)差异最大的领域 — 在 OSS 中,以下每一项都需要拼接外部工具自行构建。
Data Products
在目录之上发布带有负责人、文档、SLO 与访问策略的精选数据集 — 数据网格架构的自助服务市场。
Starburst Insights
查询模式、资源使用量、慢查询分析仪表盘,以及数据血缘与 Apache Atlas 集成 — 回答"集群昨天凌晨 3 点在做什么"。
HA · 自动扩缩容
协调器高可用、不中断运行中查询的 Graceful Scaledown,以及自动暂停、闲置关停、集群调度带来的成本自动化。
质量 · 自动分类
提供数据质量规则、模式变更告警、自动数据分类(敏感信息检测)与跨源统一搜索。
Stargate
跨集群联邦 — 不复制数据即可跨区域、租户、国境路由查询,满足 GDPR 等数据主权要求。
受支持的部署路径
Kubernetes Helm Chart · Red Hat OpenShift · Starburst Admin(Ansible) · AWS/Azure/GCP Marketplace,并集成 CloudWatch·Stackdriver 可观测性。
OSS 能提供的止步于 JMX、日志与基础 UI — 其上的查询历史存储、尊重查询的自动扩缩器、指标管道都要自建。把工程时间折算成本后,"自建"占优的情况非常罕见。
OSS Trino vs Starburst Enterprise
引擎的新鲜度、开放性与成本上 OSS Trino 占优;安全、治理、性能加速、运维与支持 SLA 上 SEP 占优 — 越是受监管行业与企业级规模,SEP 越有利。
| 类别 | OSS Trino | Starburst Enterprise (SEP) | 判定 |
|---|---|---|---|
| 核心查询引擎 | 完整的 Trino 引擎 — 最快获得最新特性 | 基于Trino的发行版 + 产品特定功能、补丁与优化 | 相同 |
| 安全 · 授权 | 文件/OPA 手动配置,无 RBAC UI | BIAC(行/列 RBAC·ABAC) · 脱敏 · Ranger · 审计 UI | SEP 占优 |
| 治理 · 目录 | 依赖外部工具(OpenMetadata 等) | Data Products · 血缘 · 质量规则 · 探索门户 | SEP 占优 |
| 性能加速 | CBO · dynamic filtering | + Warp Speed(自动索引·缓存) · 工作负载管理 | SEP 占优 |
| 表维护 | optimize 等需自行调度 | 压缩 · 快照过期 · 统计收集自动化 | SEP 占优 |
| 连接器 | 50+ 社区连接器(质量参差) | 认证连接器 + 专属(Snowflake·SAP·Salesforce 等) | SEP 占优 |
| 部署 · 运维 | Helm 自行管理 | HA/DR · 自动扩缩 · OpenShift · Marketplace | SEP 占优 |
| 支持 | 社区 Slack · GitHub | 24×7 · 30 分钟 SLA · 专属 TAM · LTS 12 个月补丁 | SEP 占优 |
| 成本 · 许可 | Apache 2.0 免费 — 无厂商锁定 | 商业订阅(按节点/算力) | OSS 占优 |
如果 "S3 + PostgreSQL 之上的 Trino" 就能覆盖需求,OSS 就足够了 — 一旦出现安全、治理、支持 SLA 要求,请评估 SEP。
版本策略 — LTS / STS
Trino 约每两周发布一次。SEP 在其之上叠加可预测的发布节奏与 LTS 补丁生命周期,把节奏变成企业能够跟上的速度。版本号开头的整数始终对应上游 Trino 版本 — 有补丁后缀(-e.x)即 LTS,没有则为 STS。
| 项目 | LTS | STS |
|---|---|---|
| 支持期限 | 自发布起 12 个月 | 至下一个 STS |
| 补丁发布 | 提供 (-e.0 → -e.1 → …) | 无 (并入下一版本) |
| 发布节奏 | 每季度最多 1 个 (2·5·8·11 月) | 跟随 Trino (频繁) |
| 安全 (CVE) 修复 | 以补丁向后移植 | 仅在下一个 STS |
| 生产适配度 | 生产环境的默认选择 | 特性驱动 · 贴近上游 |
推荐操作手册
每年一次从 LTS 到下一个 LTS 的受控升级 — 以剩余支持期 9~12 个月的版本线为目标,按版本线处理 breaking changes。
EOL 是硬性截止线
支持结束后不再提供 CVE 补丁 — 任何时点都有约 4 条 LTS 版本线重叠支持,保证升级跑道充足。
全球落地案例 — 以金融业为中心
从 Hive/Hadoop、Teradata、DB2 等遗留平台迁移或联邦到基于 Trino 的 Starburst 的真实案例。
HDFC Bank
印度最大民营银行 — 从遗留 DB2 转向开放架构,Azure AKS 与本地 OpenShift 并行运营。
云与本地统一治理 · 降低 DB2 成本
Crédit Mutuel Arkéa
法国 — 在保持本地部署的前提下,于 Hadoop 之上构建联邦查询引擎。
Hadoop 查询提速 10~20 倍 · 一年内 550+ 用户
Bank Hapoalim
以色列 — 将运行 20 年的 Teradata 迁往数据湖,在基准测试 Hive·Spark 后选择 Starburst。
高并发即席 + BI 查询性能最优
Banco Inter
巴西 — 从 Amazon Athena 迁移到 Starburst,将探索、治理、自助分析统一到单一平台。
洞察产出 days → seconds · 每月节省 $100K
全球投资银行
以Starburst替代Hive,在100多个国家和地区进行就地查询的AML分析案例。减少原始数据的集中加载,但查询处理仍会传输数据。
遵守数据主权 · 降低监管罚款风险
全球银行集团 (62 国)
利用Stargate进行跨境分析的案例。保留原始数据的存储位置,同时设计各地区的处理范围与结果传输方式。
查询性能提升 20 倍 · 遵守数据主权