
Solutions · Open Source
Argus Flow
将 Apache NiFi 2.10.0 部署到生产环境所需的一切集中于一处的开源数据管道发行版。自定义扩展包(NAR)、发布包(tar.gz、RPM、容器镜像)、Kubernetes Operator,以及配置、证书与用户管理工具——把原本分散的仓库整合为单一 monorepo,由同一条构建流水线产出版本相互对齐的产物。
连接 NiFi 数据流程所需的扩展
组合 CDC 或文件列表采集、FlowFile 处理、目标写入和运行检查。
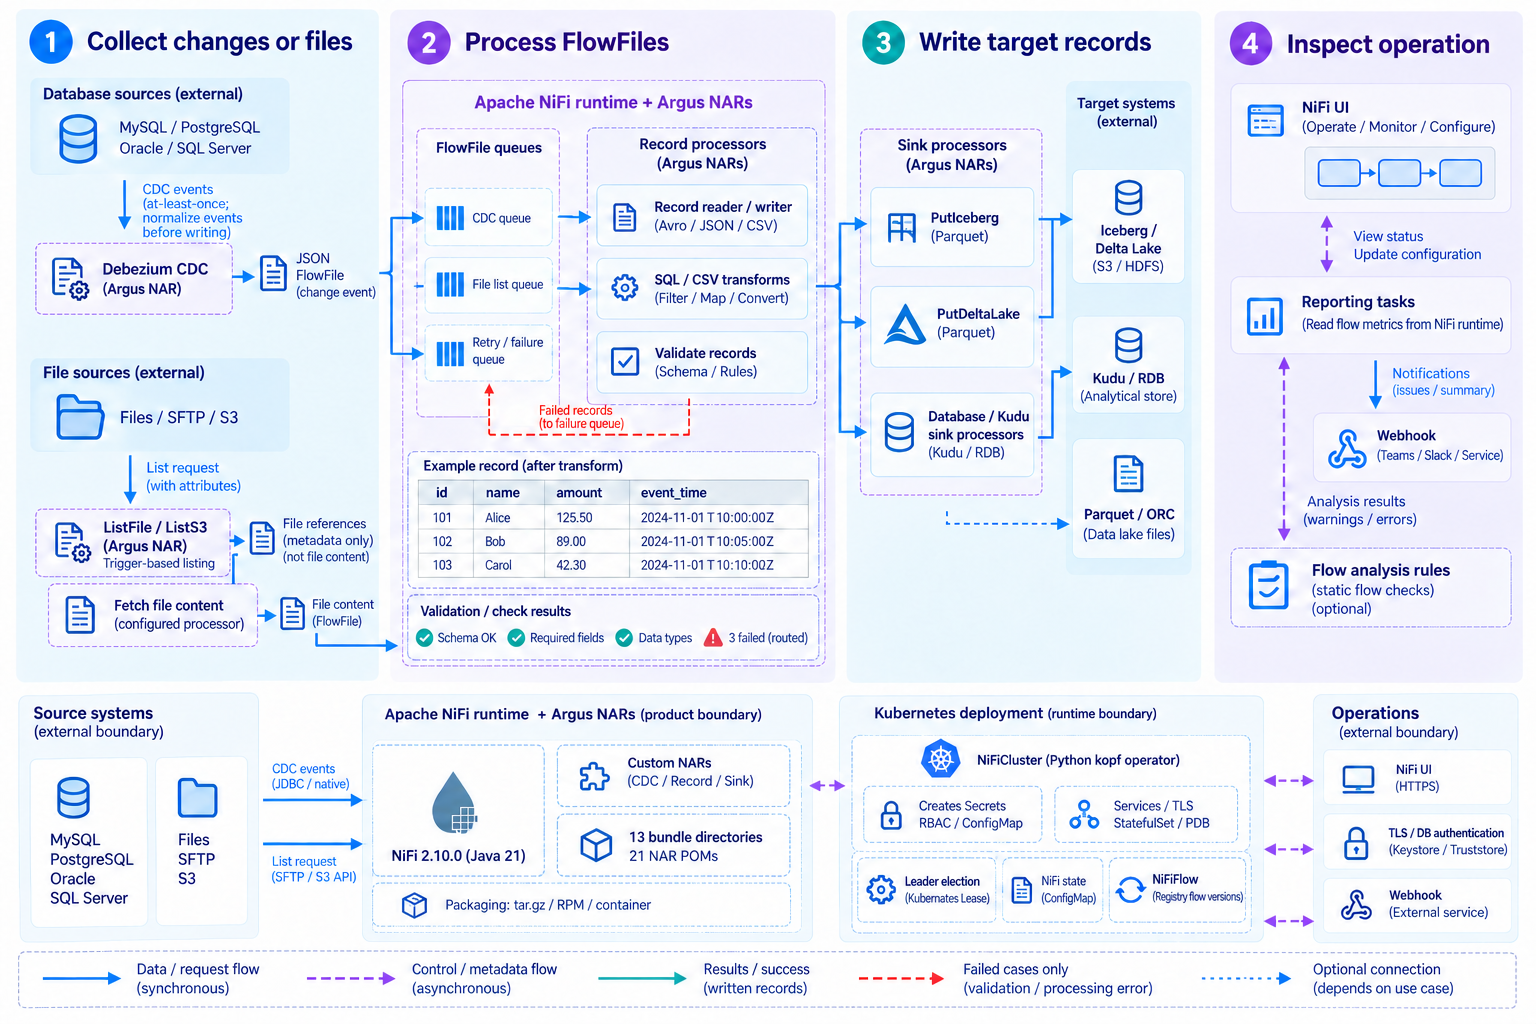
- 1.采集变更或文件列表
- 选择 Debezium CDC,或由输入 FlowFile 属性驱动的列表处理器。
- 2.处理 FlowFile
- 连接 NiFi 队列及记录读写器,配置转换和路由。
- 3.写入目标系统
- 使用 PutIceberg、PutDeltaLake 或 PutDatabaseRecord 写入已整理的记录。
- 4.检查运行
- 通过 NiFi UI、报告任务和流程分析规则查看运行状态与配置问题。
CDC 采用至少一次投递。需要配置事件到目标记录的转换;列出文件与获取文件内容是两个步骤。
查看GitHub文档与代码从发行包构建到 Kubernetes 运维
打包扩展并配置访问与 TLS,再通过 Operator 管理声明的集群和流程。
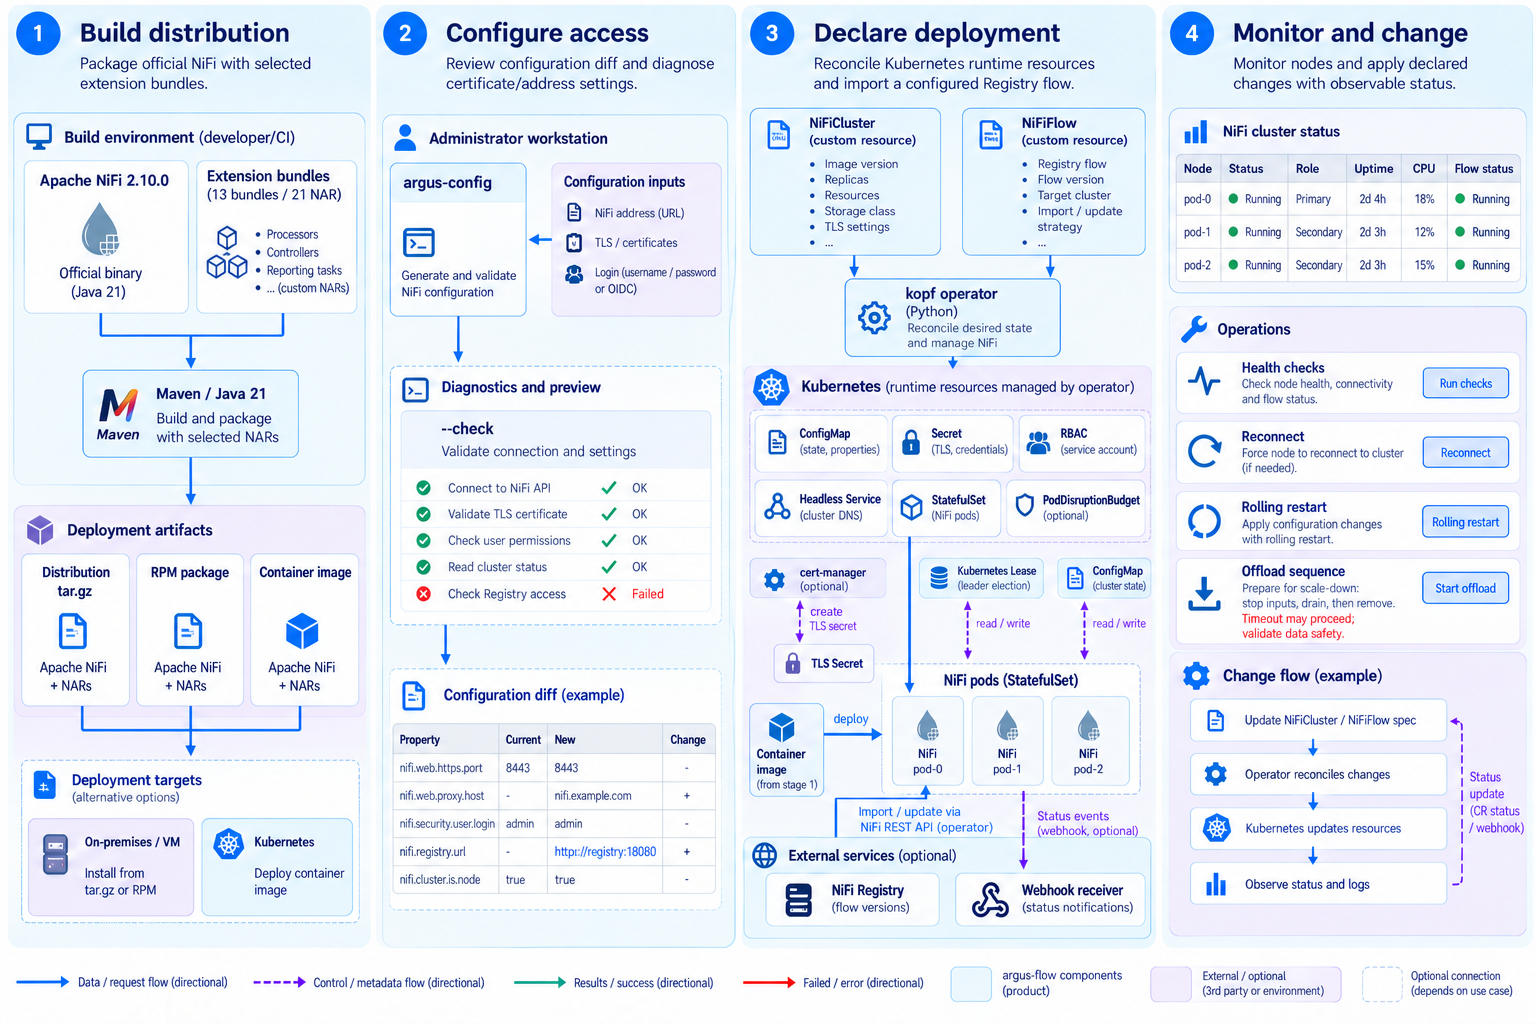
- 1.构建发行包
- 将官方 NiFi 与扩展 NAR 打包为 tar.gz、RPM 或容器镜像。
- 2.配置访问
- 通过 argus-config 设置地址、TLS 和登录方式,并检查差异与诊断结果。
- 3.声明部署
- 通过 NiFiCluster 和 NiFiFlow 指定运行资源及 Registry 流程版本。
- 4.监控与变更
- 通过健康检查、重连、滚动重启和卸载流程处理运维变更。
Kubernetes 配置使用 Lease 选举领导节点,并通过 ConfigMap 管理状态。滚动重启和缩容不保证零中断或零数据丢失。
查看GitHub文档与代码NiFi 处理器与控制器服务详情
30 种处理器负责采集、查询、转换和存储,8 种控制器服务共享连接、序列化和目录配置。
处理器30 种
处理器负责处理 FlowFile。CDC 采用至少一次投递,需配置重复、顺序和删除处理;List 类处理器需配合独立 Fetch 处理器获取文件内容。
| 组件 | 分类 | 支持功能 |
|---|---|---|
CaptureChangeMySQL | 变更数据捕获 | 从 MySQL binlog 捕获行级变更,输出 JSON FlowFile。 |
CaptureChangePostgreSQL | 变更数据捕获 | 通过 pgoutput 或 decoderbufs 逻辑复制捕获 PostgreSQL 行级变更。 |
CaptureChangeOracle | 变更数据捕获 | 通过 Oracle LogMiner 捕获行级变更,支持 CDB/PDB 连接配置。 |
CaptureChangeSQLServer | 变更数据捕获 | 读取 SQL Server CDC 表的行级变更并输出 JSON FlowFile。 |
ExecuteSQL | 数据库 | 将 SELECT 结果流式输出为 Avro,支持参数绑定、定时运行和输入触发。 |
ExecuteSQLRecord | 数据库 | 通过指定的 Record Writer 流式输出 SELECT 结果,支持查询参数绑定。 |
ExecuteFastSQL | 数据库 | 多线程获取 SQL 结果并输出 CSV;二进制值转为 Base64,CLOB 转为文本。 |
PutDatabaseRecord | 数据库 | 将记录转换为 INSERT、UPDATE、DELETE 等 SQL,支持事务及成功、重试、失败路由。 |
BulkOracleInsertProcessor | 数据库 | 使用参数化 Oracle INSERT ALL 批量写入,可配置批次行数和查询超时。 |
ListS3 | 文件列表 | 通过输入属性指定存储桶和 Prefix,逐对象生成 FlowFile,配合 FetchS3Object 下载内容。 |
ListHDFS | 文件列表 | 通过输入属性指定 HDFS 目录和过滤条件,将文件路径信息传给 FetchHDFS。 |
ListFile | 文件列表 | 在处理节点上列出允许的基础目录下的本地或挂载文件,配合 FetchFile 使用。 |
ListSFTP | 文件列表 | 通过输入属性指定 SFTP 连接目标和远程路径,输出文件列表供 FetchSFTP 使用。 |
ListFTP | 文件列表 | 通过输入属性指定 FTP 连接目标和远程路径,输出文件列表供 FetchFTP 使用。 |
QueryTrinoRecord | Trino 查询与维护 | 使用 Record Writer 流式输出 Trino SELECT 结果并按行数分片;记录查询 ID 和统计信息,停止时取消查询。 |
ExecuteTrinoStatement | Trino 查询与维护 | 执行 CTAS、INSERT SELECT、MERGE 等单条 DDL/DML/ELT 语句,支持同步、后台和无输入定时运行。 |
MaintainTrinoTable | Trino 查询与维护 | 支持 Iceberg OPTIMIZE、快照过期和孤立文件清理,Delta Lake OPTIMIZE/VACUUM,Hive 分区同步;三种格式均支持 ANALYZE。 |
PutIceberg | 湖仓写入 | 通过 Record Reader 和目录服务向已有 Iceberg 表追加记录;需匹配表结构,CDC 更新和删除需另行处理。 |
PutDeltaLake | 湖仓写入 | 使用 Delta Kernel 向路径型表追加 Parquet 并提交日志;可创建缺失表,基础范围为基本类型及 file/HDFS。 |
PutKudu | 湖仓写入 | 向 Kudu 写入记录,可配置操作类型、批次和 Flush 模式,支持逐列时间戳格式及小时偏移。 |
SelectHive3QL | Hive 集成 | 将 HiveQL SELECT 结果流式输出为 Avro 或 CSV,支持定时运行、输入触发及结果行数属性。 |
PutHive3QL | Hive 集成 | 执行 FlowFile 中的 HiveQL DDL/DML,通过 hiveql.args 属性绑定占位参数。 |
PutHive3Streaming | Hive 集成 | 通过 Hive 3 Streaming API 写入记录,支持静态分区值或记录中的分区字段。 |
UpdateHive3Table | Hive 集成 | 根据输入结构创建缺失的 Hive 表或添加列、分区,用于写入前的表结构准备。 |
TriggerHiveMetaStoreEvent | Hive 集成 | 根据输入路径及 put/delete 属性触发 Hive Metastore 通知,需配置通知监听器。 |
PutORC | 文件格式 | 通过 Record Reader 读取记录,写入指定文件系统路径的 ORC 文件。 |
PutParquet | 文件格式 | 按指定结构将记录写为 Parquet,临时文件写入成功后重命名为最终文件。 |
MergeParquet | 文件格式 | 合并 HDFS 上的 Parquet 文件并输出结果路径,可配置提交合并后保留或删除原文件。 |
MultilineCsvParser | 转换与外部命令 | 流式解析含多行字段的 CSV,可配置分隔符、编码、引号、表头和列数,错误输入转入失败分支。 |
PrePostExecuteStreamCommand | 转换与外部命令 | 将 FlowFile 内容传给外部命令,并支持配置前置和后置命令。 |
控制器服务8 种
控制器服务共享连接、读写和目录配置。表中名称与 NiFi 中选择的实际组件名称一致。
| 组件 | 分类 | 支持功能 |
|---|---|---|
CSVReader | 记录读取器与写入器 | 将 CSV 行读为记录,支持按表头推断结构或显式结构及时间戳格式配置。 |
TimestampFormatAvroRecordSetWriter | 记录读取器与写入器 | 输出二进制 Avro,可配置结构属性中的时间戳格式、小时偏移和压缩。 |
TimestampFormatParquetRecordSetWriter | 记录读取器与写入器 | 输出 Parquet,可配置结构属性中的时间戳格式、小时偏移和 INT96 字段。 |
Hive3ConnectionPool | 数据库连接 | 为 Hive 处理器提供 Hive 3 JDBC 连接池及 Kerberos 集成。 |
VendorHive3ConnectionPool | 数据库连接 | 使用外部厂商 Hive JDBC 驱动提供连接池,支持服务级驱动路径和 Kerberos;需另行提供驱动 JAR。 |
HiveCatalogService | Iceberg 目录 | 连接 Hive Metastore 管理 Iceberg 表元数据,作为 PutIceberg 的目录服务。 |
HadoopCatalogService | Iceberg 目录 | 在 HDFS 等支持原子重命名的文件系统上提供 Iceberg 目录。 |
StandardTrinoConnectionService | 数据库连接 | 提供兼容 DBCPService 的非池化 Trino JDBC 连接,支持 NONE/PASSWORD/JWT/Kerberos/OAuth2、会话属性及外部驱动 JAR。 |
以具体 NiFi 流程理解 PostgreSQL CDC
连接逻辑复制、JSON 变更事件、目标转换与恢复处理。
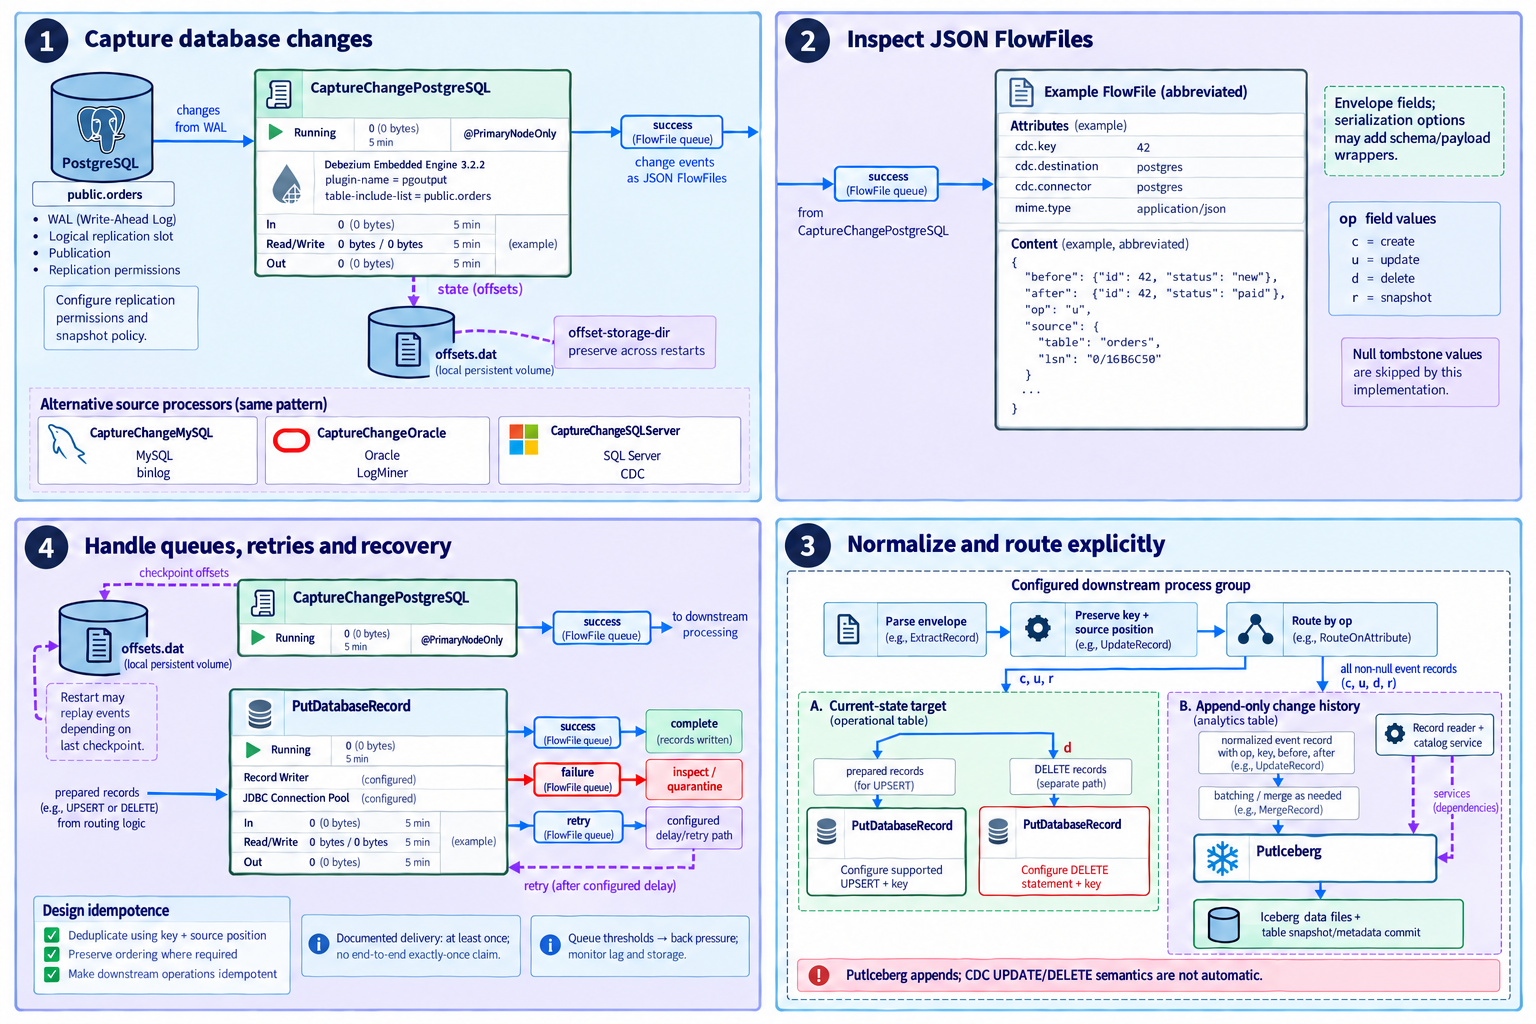
- 1.配置逻辑复制
- 准备权限、复制槽、publication 和持久化本地偏移量。
- 2.检查事件
- 检查 before、after、op 和 cdc.key 等 FlowFile 属性。
- 3.匹配目标语义
- 区分当前状态的 UPSERT/DELETE 与追加变更历史。
- 4.设计恢复
- 配置目标的失败与重试队列,并对重新传递的事件去重。
CDC 文档描述至少一次传递。去重、顺序与删除需显式配置;PutIceberg 的追加写入不会自动合并或执行 CDC 更新与删除。
查看GitHub文档与代码部署、安全、运维检查与版本比较
整理公开发行版的运维能力及 Enterprise 支持服务。
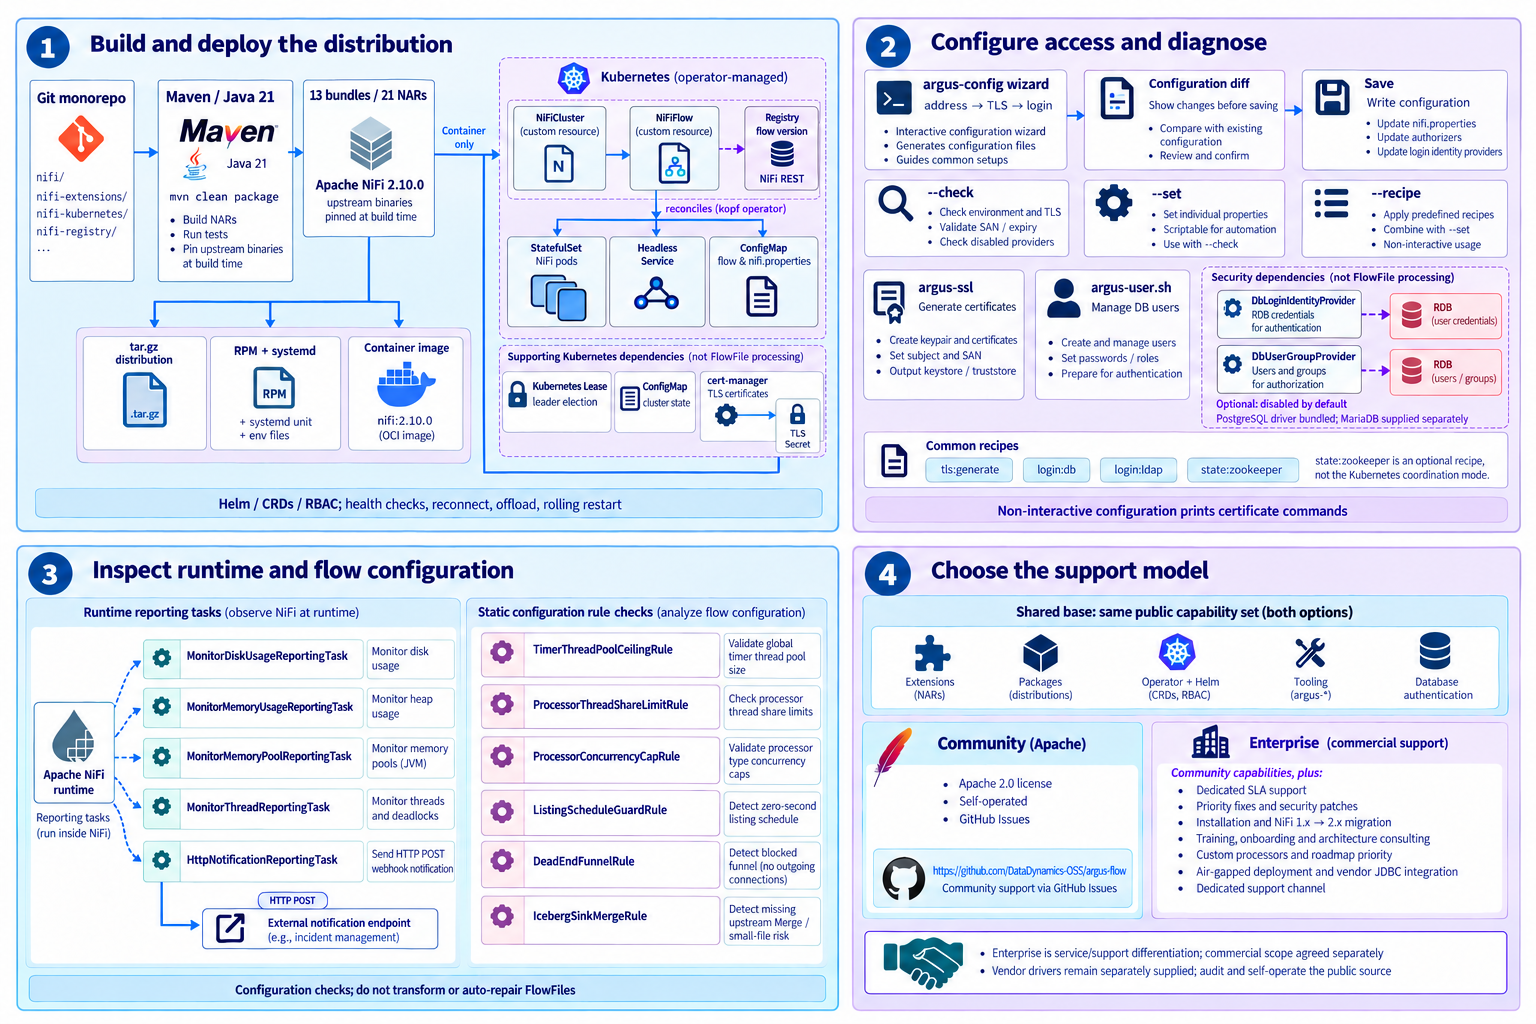
- 1.组装发行版
- 打包 13 个 bundle 与 21 个 NAR;Kubernetes 使用 Lease 选举与 ConfigMap 状态。
- 2.配置访问
- 诊断地址、TLS 和登录,按需启用数据库认证与授权。
- 3.检查运维
- 使用 5 类报告任务与 6 条静态规则检查运行时及流程配置。
- 4.选择支持
- 选择自行运维的 Community 或提供 SLA、迁移与定制开发的 Enterprise。
扩展、打包、Operator 和工具均为公开 Community 能力。Enterprise 增加 SLA 与专业服务;厂商驱动另行提供。滚动重启与缩容不保证无中断或无数据损失。
查看GitHub文档与代码