
Cloudera
作为Cloudera合作伙伴,Data Dynamics提供本地平台的规划、部署、运维支持和培训。
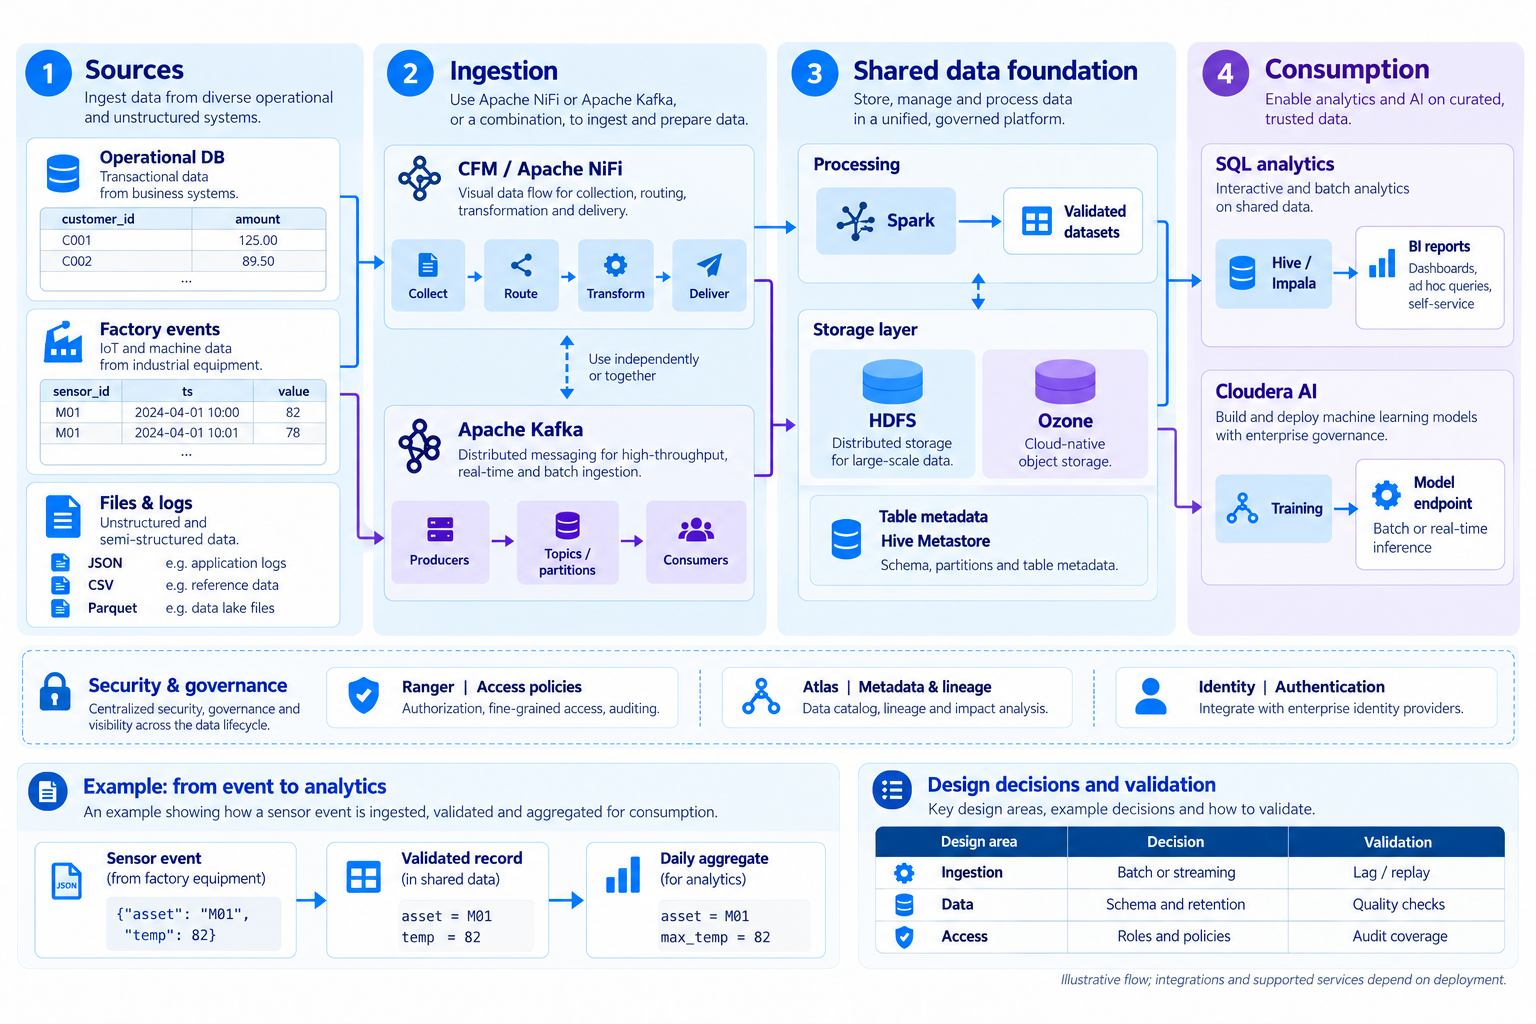
从企业数据到分析与AI
采集设备和业务系统的数据,在共享数据基础上运行分析和AI服务。
查看图示、产品与服务详情
- 1.数据源
- 采集设备传感器、业务数据库、日志和文档中的数据。
- 2.采集与传输
- 根据需求配置NiFi数据流和Kafka事件流,两者可作为并行路径。
- 3.共享数据基础
- 在Cloudera存储与处理环境中管理数据,并使用Spark等引擎进行加工。
- 4.分析与AI应用
- 在同一数据基础上分别开展SQL、BI分析以及模型训练和推理。
Cloudera本地数据平台
Cloudera提供面向存储、处理、分析与AI的数据平台。本地环境以Cloudera Base和Data Services为基础,使用SDX技术设计安全和元数据管理。结合现有资产及数据存储位置要求选择服务。
- Cloudera Base:HDFS、Ozone、Hive、Impala、Spark、Kafka 等核心数据服务
- Cloudera Data Services:基于 Kubernetes、计算分离的 CDW、CDE 与 Cloudera AI
- SDX (Shared Data Experience):通过 Ranger 与 Atlas 实现统一安全与治理
- 通过 Cloudera Manager 实现集成化的运维与监控
此图为概念示意。安全、治理与集成的适用范围应根据实际部署和支持的组件进行设计。
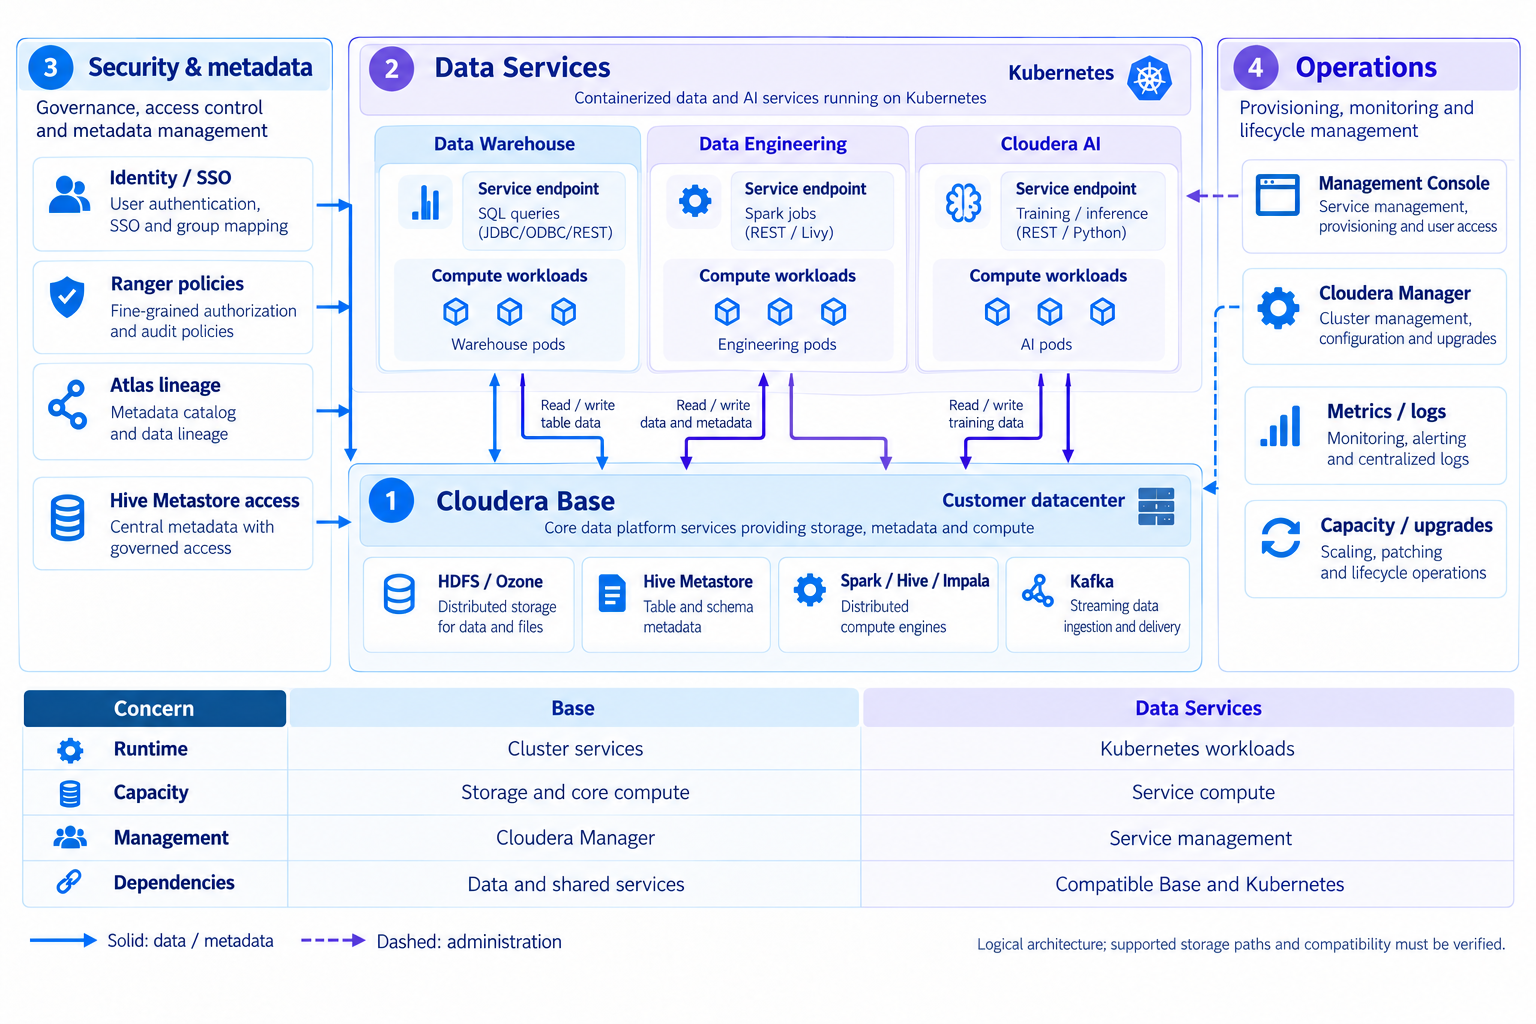
官方文档Cloudera Base与Data Services的关系
区分共享数据基础和各服务的计算资源,明确产品与运维职责。
查看图示、产品与服务详情
- 1.Cloudera Base
- 提供HDFS、Ozone等存储基础及基础处理服务。
- 2.Data Services
- 基于Kubernetes的Data Warehouse、Data Engineering和Cloudera AI使用共享数据基础。
- 3.安全与治理
- 利用Ranger、Atlas等SDX技术设计访问控制与元数据管理。
- 4.运营管理
- 区分Cloudera Manager的基础集群管理与Data Services的管理功能。
CDP Private Cloud Base/Data Services和CML为旧名称。导入时需确认受支持的配置和版本兼容性。
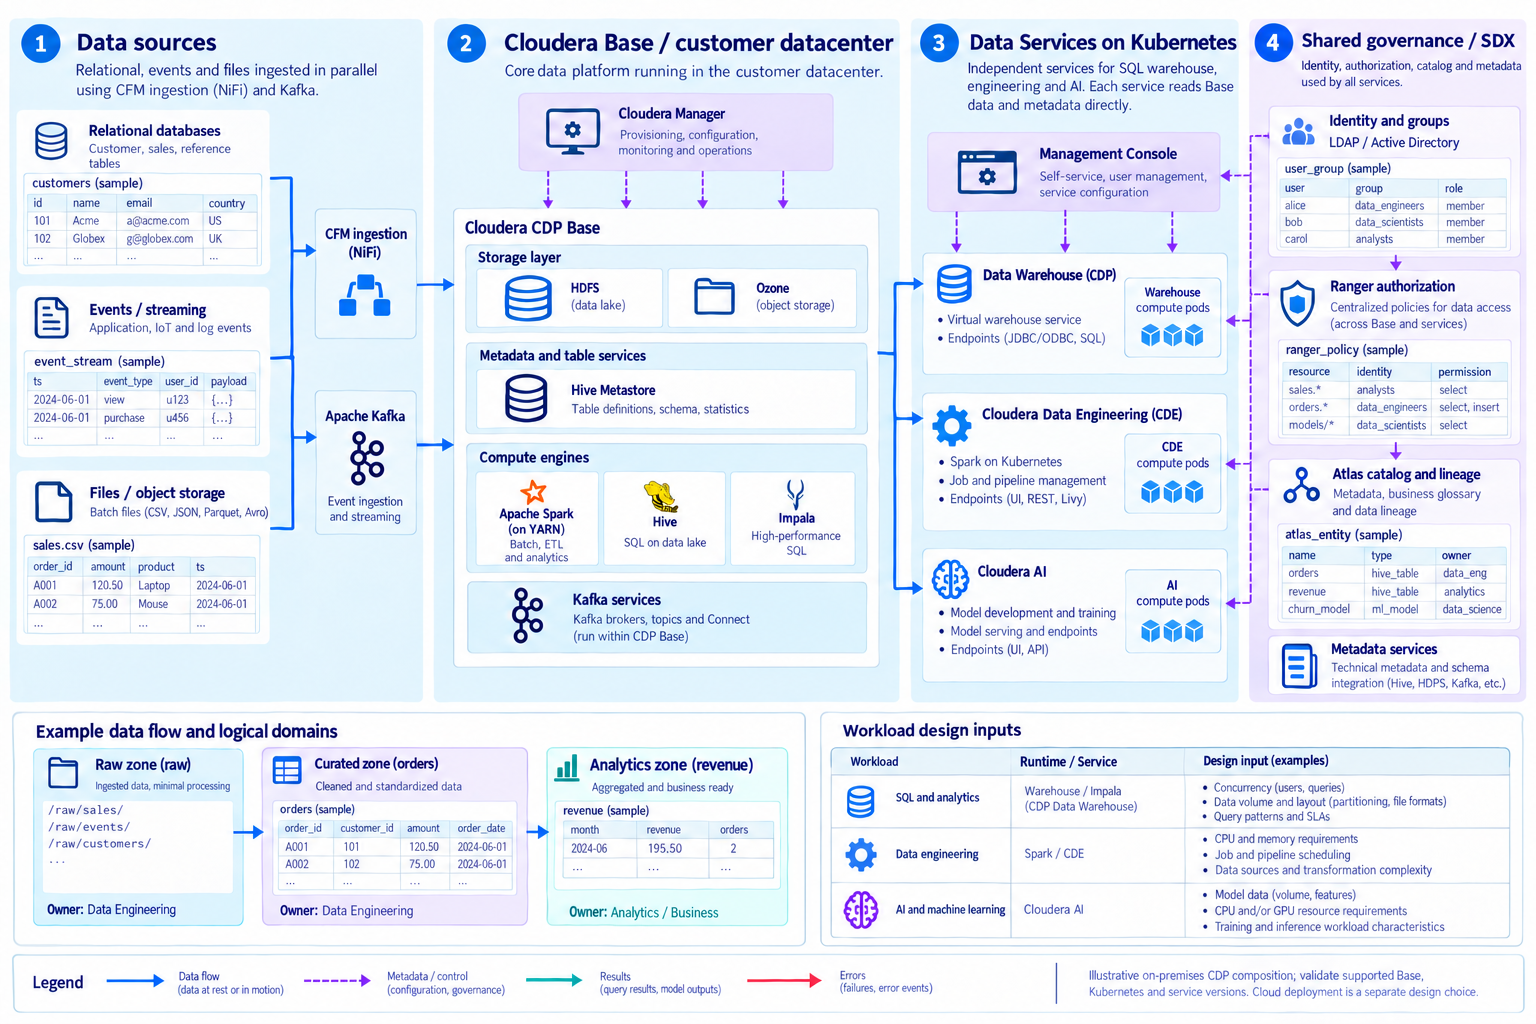
官方文档Cloudera CDP 数据、服务与治理架构
展示 Cloudera Base 与 Kubernetes Data Services 的组成和管理边界。
查看图示、产品与服务详情
- 1.数据接入
- 通过适当的 NiFi 或 Kafka 路径连接数据库、事件与文件。
- 2.Cloudera Base
- 提供 HDFS/Ozone、元数据和核心处理服务,由 Cloudera Manager 运维。
- 3.Data Services
- 数仓、CDE 和 Cloudera AI 独立访问共享数据,通过 Management Console 管理。
- 4.SDX 治理
- 使用身份和组、Ranger 策略、Atlas 血缘与元数据管理。
示例为本地部署。需验证 Base、Kubernetes 与服务版本兼容性;云部署需单独设计。
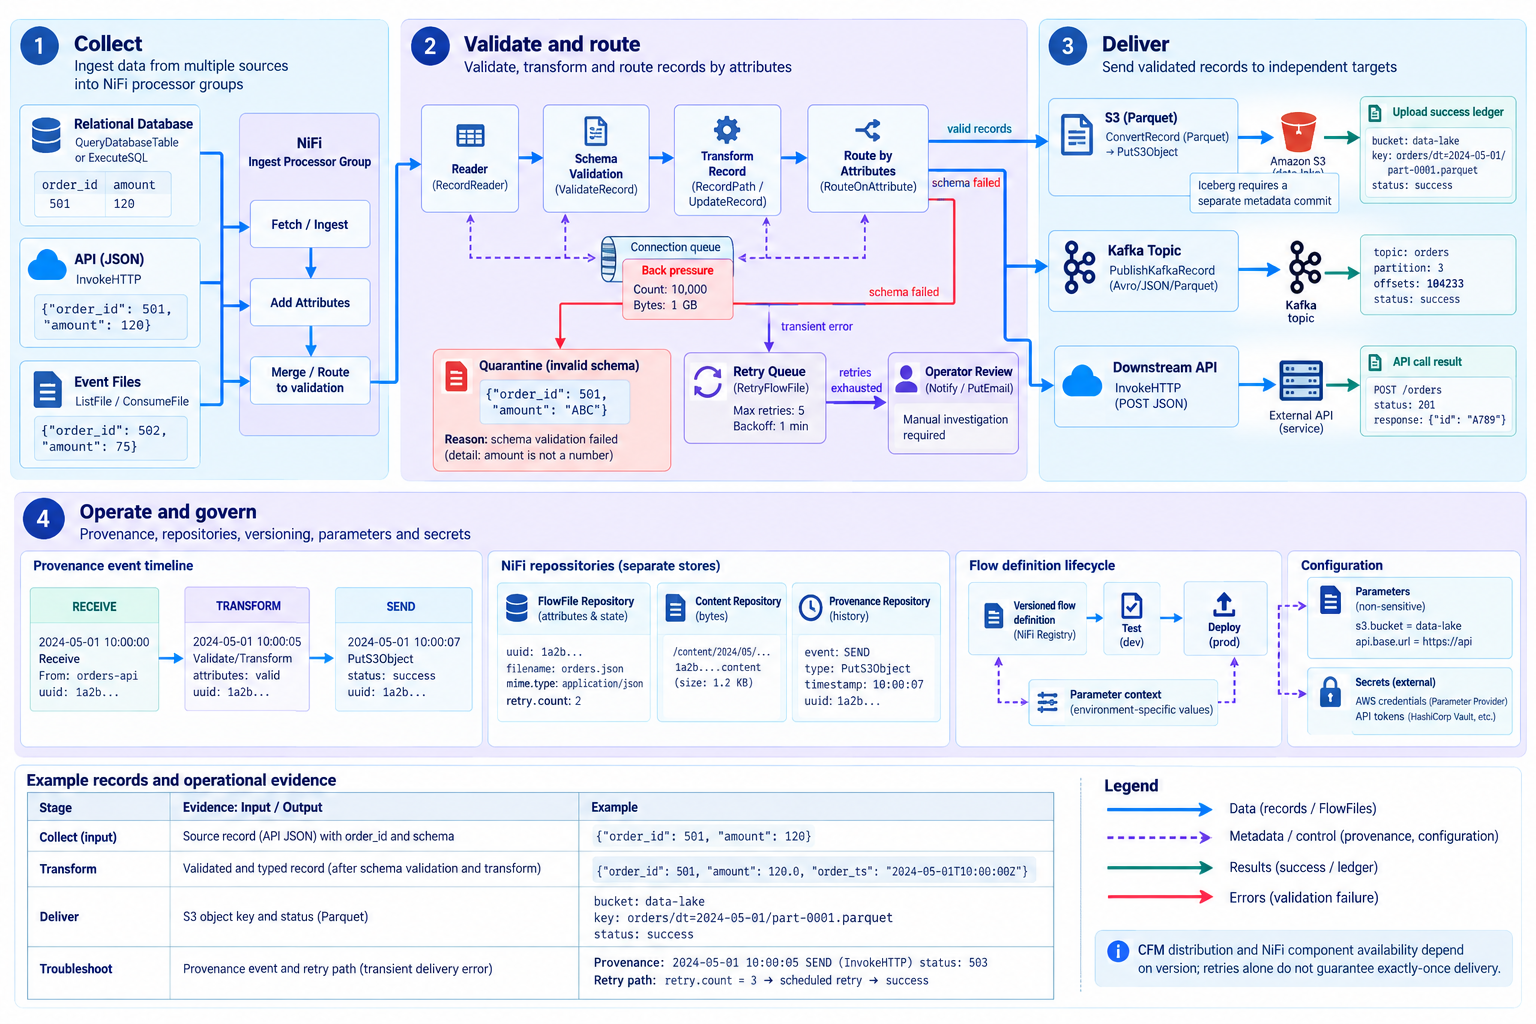
官方文档CFM 与 Apache NiFi 数据流工程
详细展示处理器、队列、背压、错误路径与数据处理溯源。
查看图示、产品与服务详情
- 1.采集
- 将数据库、API 和事件文件作为 FlowFile 与记录处理。
- 2.校验与路由
- 按模式和属性转换数据,通过队列阈值控制流入,区分隔离与重试路径。
- 3.交付
- 独立发送到 S3 Parquet、Kafka 或 API,记录状态与对象键。
- 4.运维与追踪
- 区分 FlowFile、内容和溯源仓库,部署版本化数据流及参数上下文。
可用组件取决于发行版本。仅重试不能保证恰好一次交付;S3 文件需提交 Iceberg 元数据后才可作为 Iceberg 表查询。
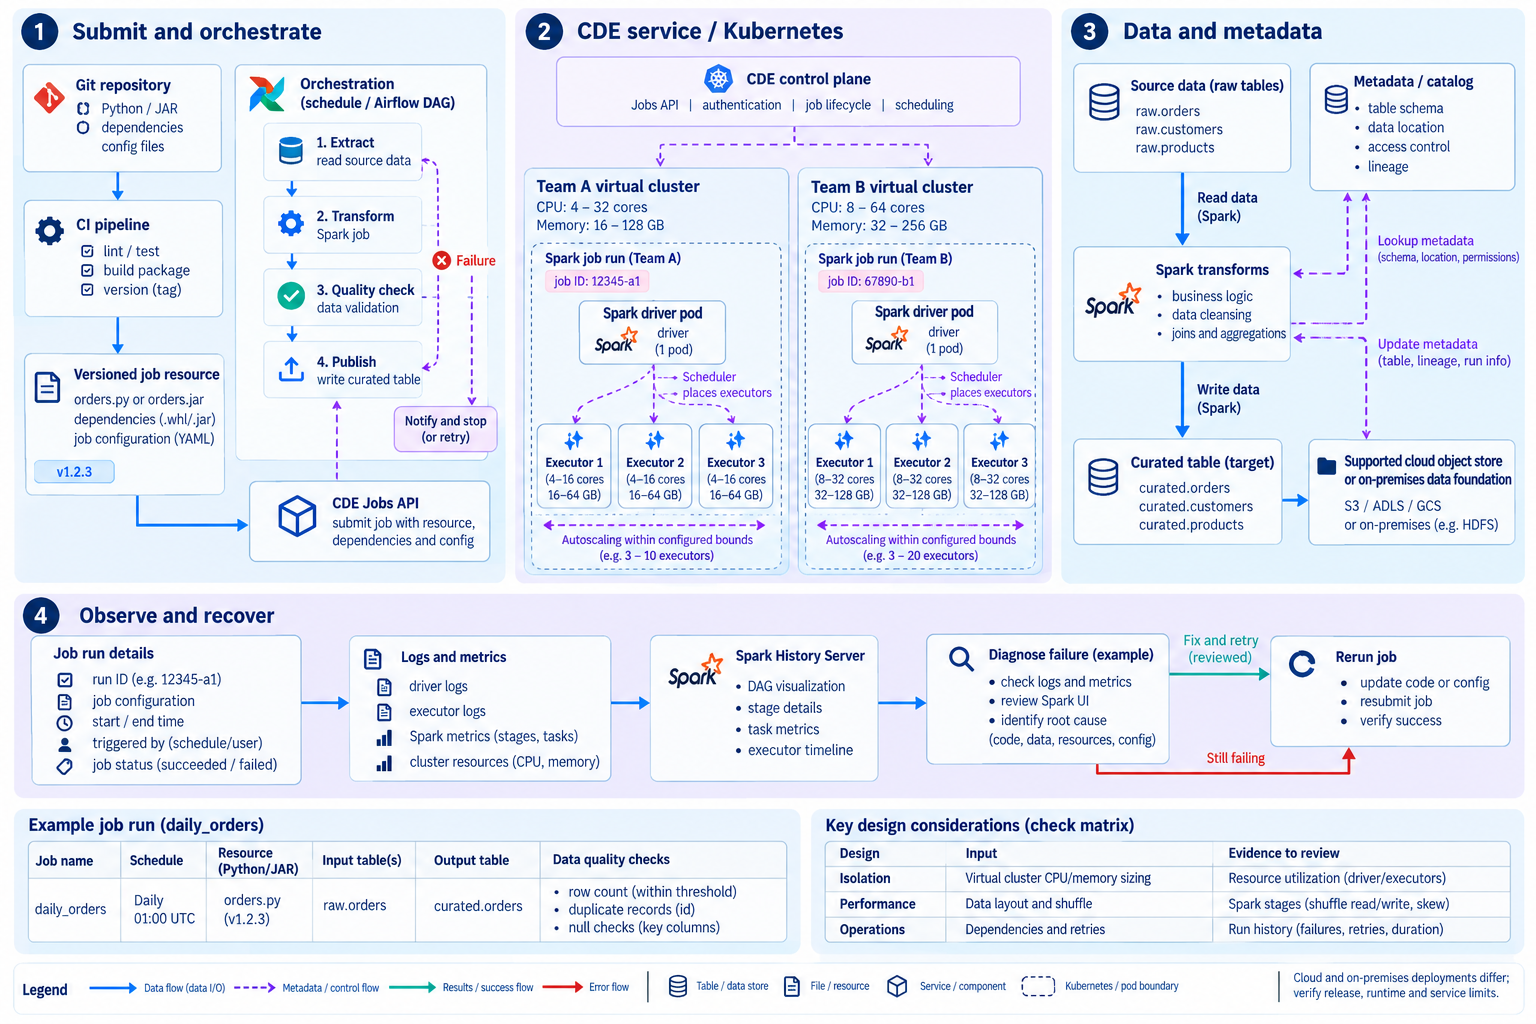
官方文档CDE 虚拟集群与 Spark 作业执行
连接代码和依赖提交、Spark 执行、质量检查与运维。
查看图示、产品与服务详情
- 1.提交与编排
- 将版本化 Python/JAR 和依赖绑定到 CDE 作业,通过计划或 Airflow DAG 执行。
- 2.虚拟集群
- 在团队各自的 CPU 和内存范围内运行驱动与执行器。
- 3.数据处理
- 读取受支持的数据存储,完成转换和校验后发布整理后的表。
- 4.观察与恢复
- 通过运行 ID、日志、指标和 Spark History Server 排查,再评估失败作业重试。
云端与本地部署的存储和运行时支持不同,需确认资源范围、扩缩容上限和作业依赖。
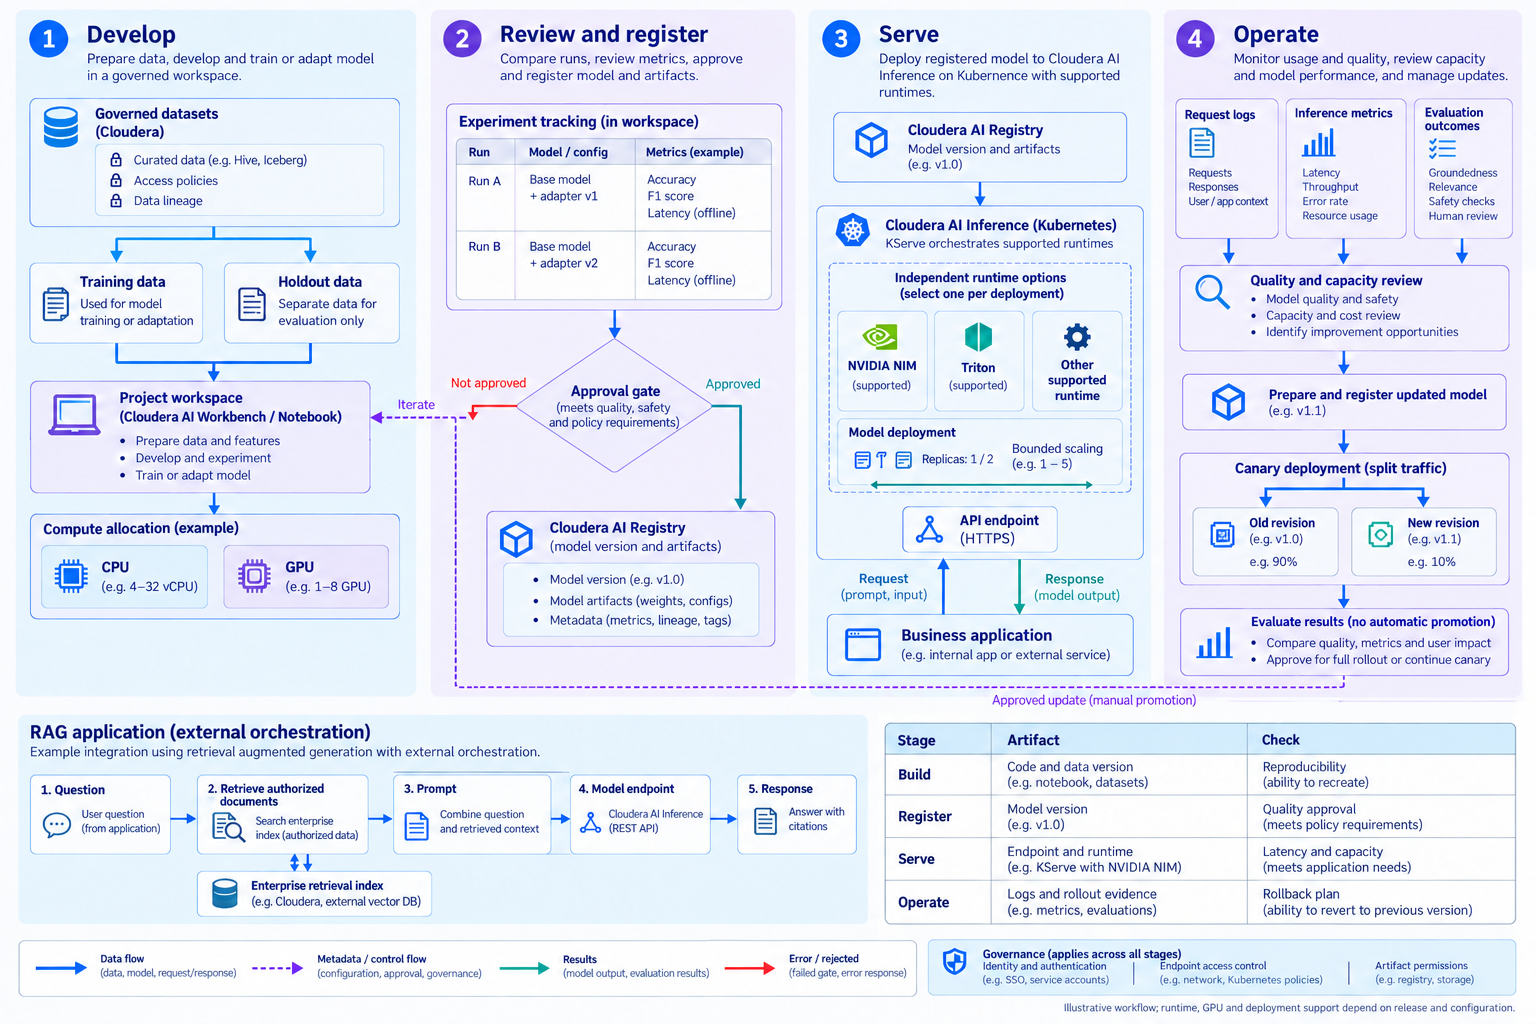
官方文档Cloudera AI 开发、注册、推理与运维
将模型开发评估连接到 AI Registry 和 Inference 服务。
查看图示、产品与服务详情
- 1.开发
- 在受控数据与项目环境中训练或调整模型,使用独立留出数据评估。
- 2.审核与注册
- 评审实验,将批准的模型版本和产物注册到 Cloudera AI Registry。
- 3.推理服务
- 在 KServe 平台配置支持的 NIM、Triton 等运行时及模型端点。
- 4.运维
- 审查请求日志、推理指标、质量和容量,管理分阶段发布与恢复。
运行时、GPU、部署和访问控制支持需按版本确认。RAG 检索和提示组装属于示例应用,不意味着推理服务提供向量存储。
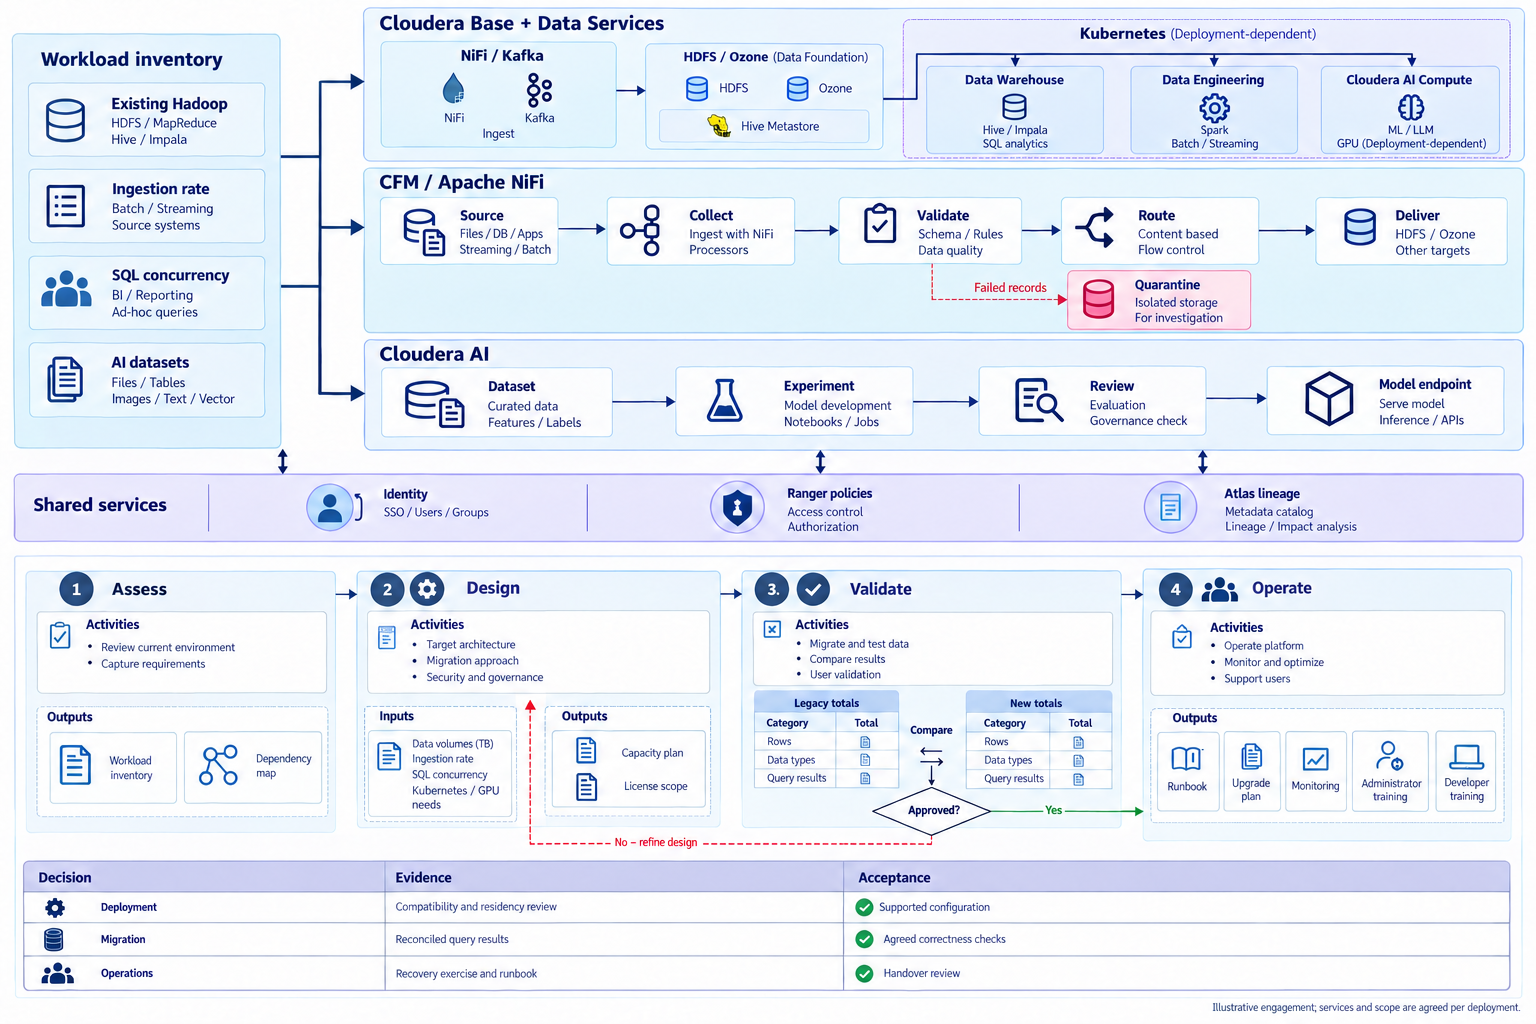
官方文档Data Dynamics 提供的 Cloudera 服务
将产品和应用配置选择与需求分析、验证及运维交接相连接。
查看图示、产品与服务详情
- 1.需求分析
- 梳理现有系统、数据、工作负载和运维约束,确定实施范围。
- 2.产品与配置选择
- 根据应用目标评估产品、部署方式、容量、访问权限及采购范围。
- 3.验证与切换
- 使用代表性工作负载检查一致性、性能和集成,并评估验收标准与恢复流程。
- 4.运维与培训
- 通过监控、运维手册、升级计划和团队培训准备运维交接。
Cloudera 产品组合
- Cloudera Base · Data Services
结合Cloudera Base数据基础与基于Kubernetes的Data Services,支持数据仓库、工程和AI工作负载。
Cloudera Base · Data Services · SDX · Cloudera Manager
- CFM (Cloudera Flow Management)
基于 Apache NiFi 构建的企业级数据流管理方案。数百种连接器在边缘、本地与云之间实时接入、转换并投递数据。
Apache NiFi · NiFi Registry · MiNiFi · Flow Designer
- Cloudera AI
通过 Cloudera Machine Learning (CML) 与 Cloudera AI Inference,数据科学家可在 CDP 数据之上训练、部署并服务模型 —— 包括生成式 AI 与 RAG 工作负载。
CML · MLflow · Model Serving · LLM / RAG
导入前共同确认的事项
结合实际数据需求和运营条件确定范围,而不仅是核对功能清单。
- 适用环境
评估自有数据中心、现有Hadoop资产及数据存储位置要求。
- 配置与容量
确认数据规模、采集量、并发用户及Kubernetes、GPU需求。
- 导入与运维支持
协商现状评估、架构设计、迁移验证、运维流程和培训范围。
Data Dynamics 提供的 Cloudera 服务
- 许可证销售
作为官方合作伙伴,我们以有竞争力的条件提供 Cloudera Base/Data Services、CFM 及 Cloudera AI 许可证,并结合客户环境提供规模测算与报价。
- Cloudera Base 与 Data Services 许可证
- CFM (NiFi) 许可证
- Cloudera AI (CML) 许可证
- 基于工作负载的规模测算与 TCO 分析
- 技术支持
围绕 CDP、CFM 及 Cloudera AI 的端到端技术支持 —— 从方案设计与实施到事件响应与性能调优。
- CDP Private Cloud 部署与升级
- CDH/HDP 至 CDP 的迁移
- Cloudera Manager、Ranger 及 Atlas 运维
- NiFi 数据流设计与性能调优
- CML 环境搭建与 MLOps 支持
- 事件响应与性能优化
- 培训
面向管理员、开发者及数据科学家的 Cloudera 实战培训,帮助客户快速构建内部专业能力。
- CDP 管理员课程
- Spark、Hive 及 Impala 开发者课程
- NiFi (CFM) 数据流实战课程
- Cloudera Machine Learning 实战课程
- 定制化工作坊与上门培训
图示为实施流程示例。产品和版本的支持范围、验收标准与服务范围需结合实际环境和合同确认。