
Argus RAG Studio
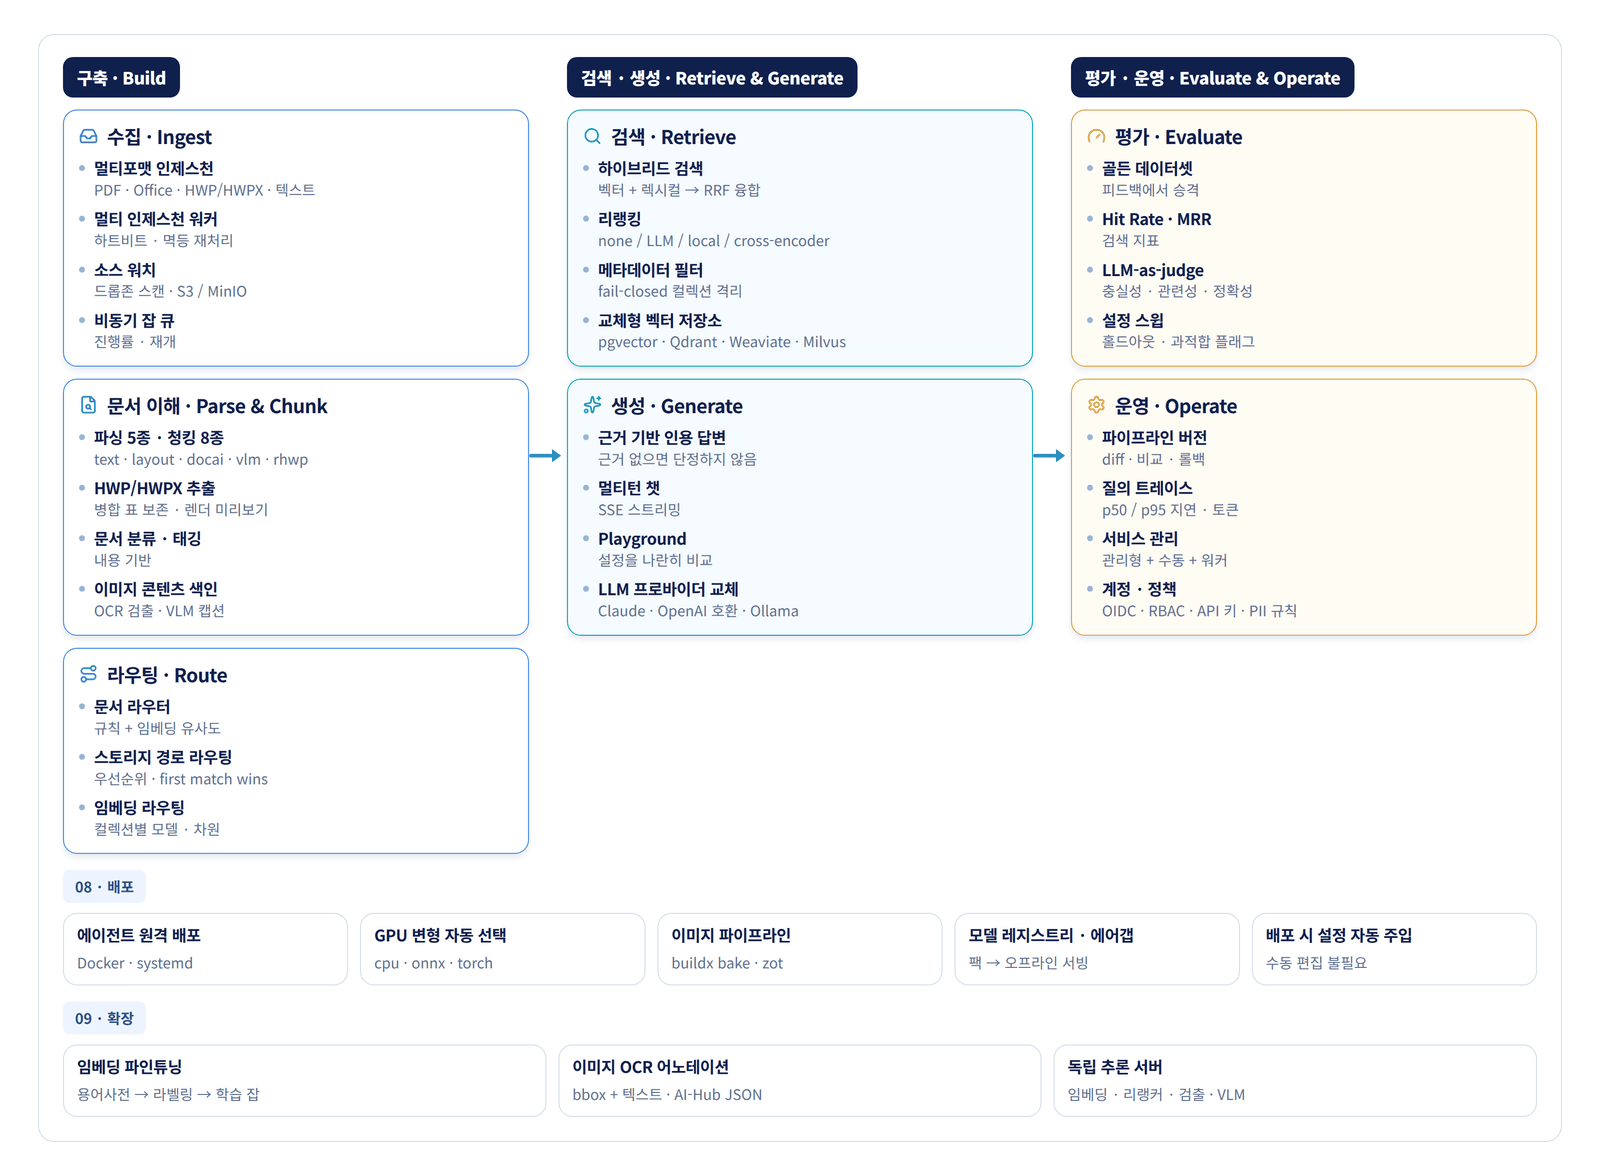
RAG 파이프라인의 구축(Build) · 검색/생성(Retrieve & Generate) · 평가(Evaluate) · 운영/배포(Operate & Deploy)를 한곳에서 통합 관리가능한 RAG 플랫폼입니다. "한 번 동작하는 RAG 데모"가 아니라 — 품질을 숫자로 측정하는 평가 하니스, 최적 설정을 자동 탐색하는 스윕, 피드백 환류, 에이전트 기반 원격 배포까지 갖춰 온프레미스·에어갭(폐쇄망)에서 운영할 수 있습니다.
01 · RAG 개념과 전체 흐름
먼저 RAG가 문서를 근거로 답변하는 방식을 이해하고, 준비부터 운영까지의 흐름을 살펴봅니다.
RAG란 무엇인가
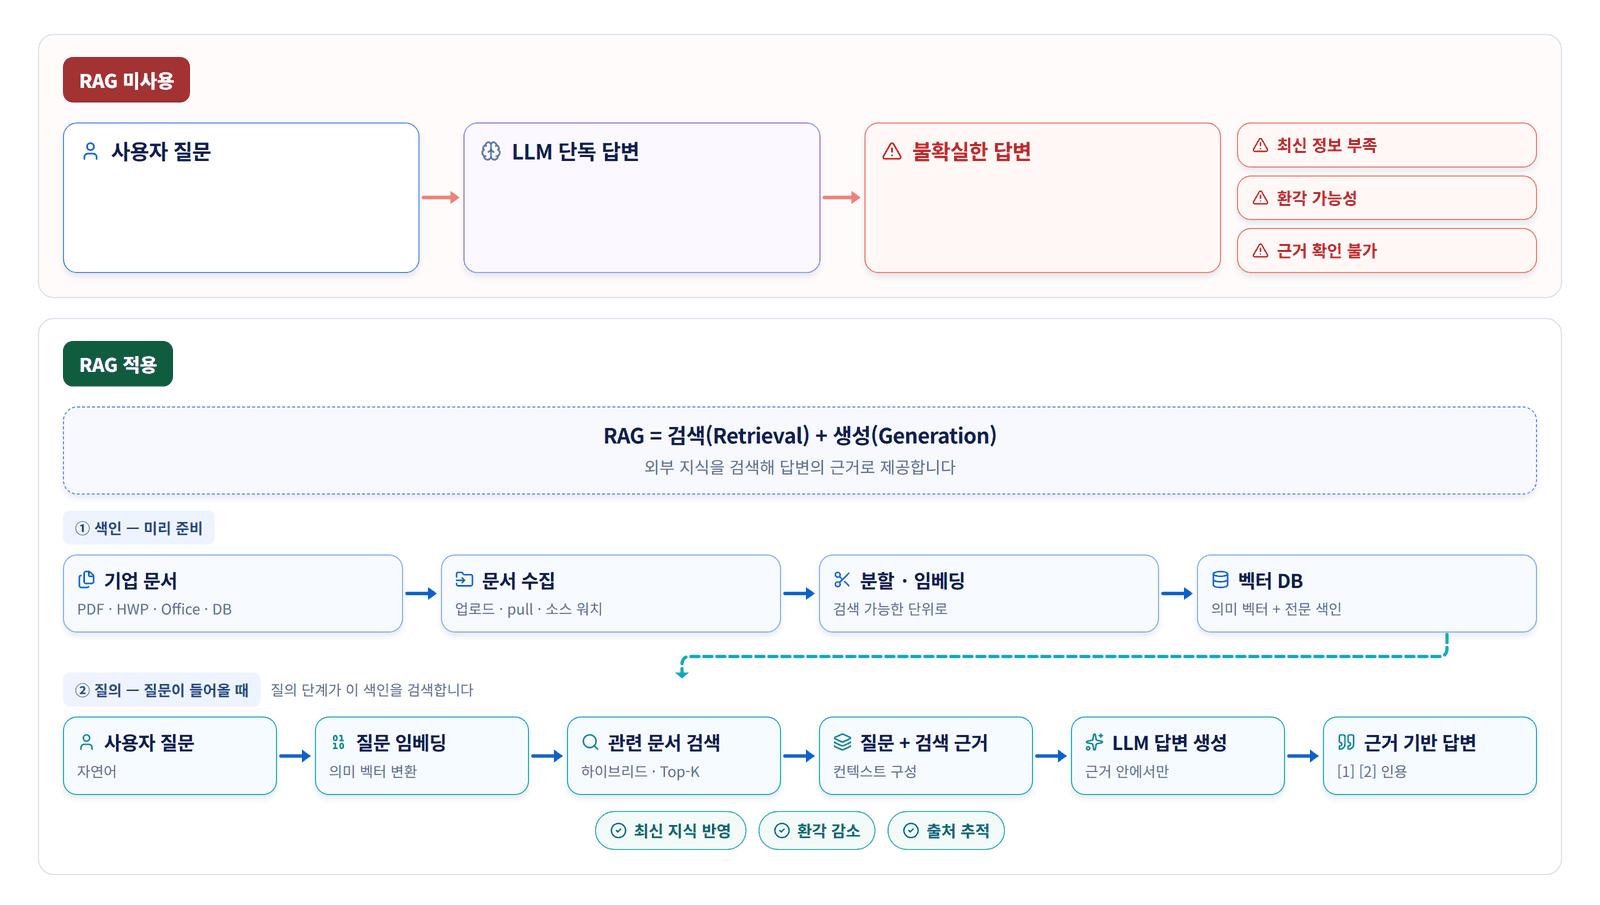
RAG는 질문과 관련된 문서를 먼저 검색하고, 검색된 내용을 대규모 언어 모델의 컨텍스트로 제공합니다. 답변과 함께 제시되는 인용을 통해 사용자가 근거를 확인할 수 있습니다.
RAG 전 주기
문서를 검색 가능한 지식으로 준비하고, 질문에 필요한 근거를 찾아 답변을 생성합니다. 평가 결과로 설정을 개선하고, 실행 버전·서비스 상태·배포를 관리합니다.
02 · 검색할 문서 준비
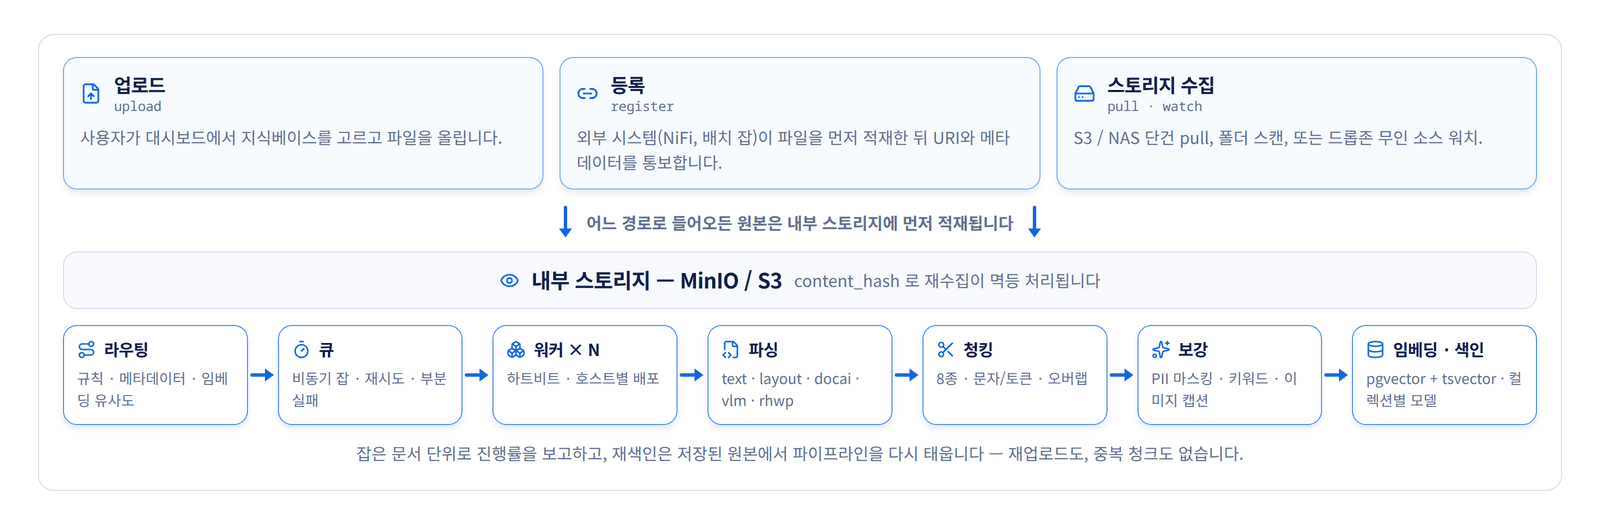
문서를 읽고 민감정보를 처리한 뒤, 검색할 수 있는 작은 단위와 벡터로 만드는 순서입니다.
구축
문서를 가져와 지식베이스를 정하고, 파싱·청킹·인덱싱하는 단계
문서 라우팅
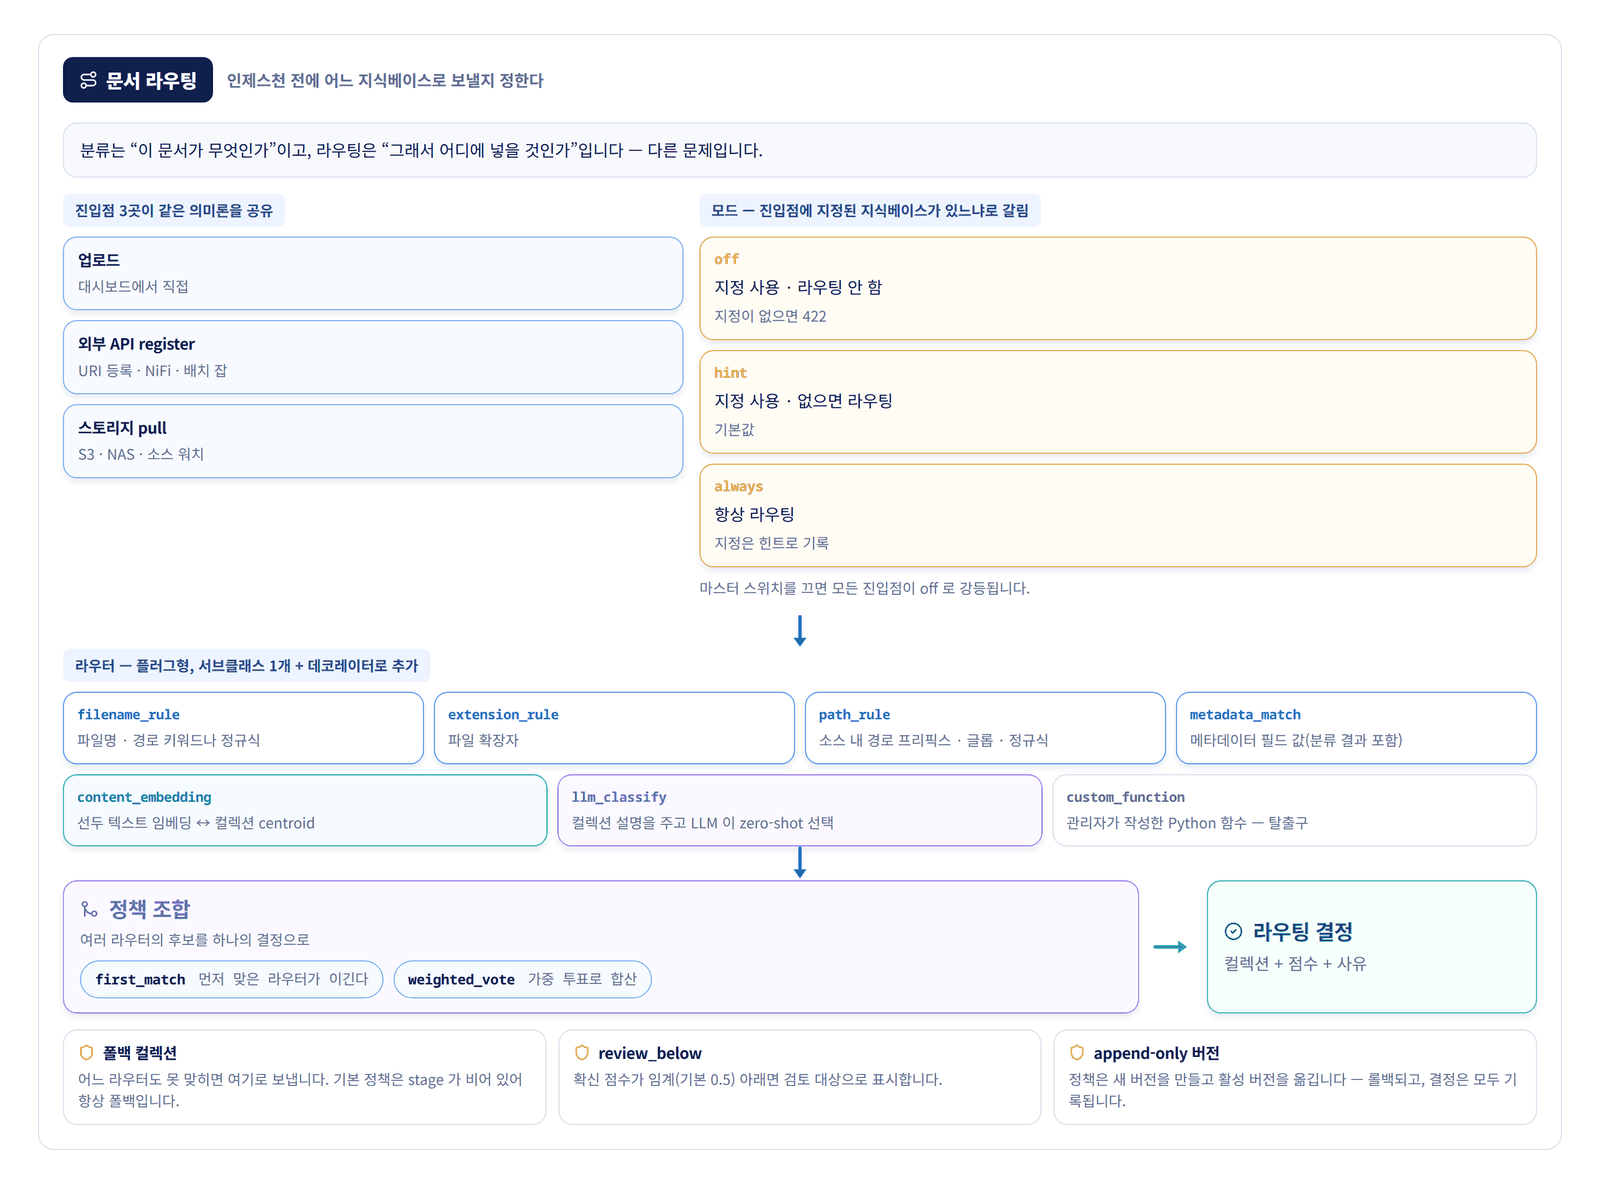
문서 라우팅은 인제스천 전에 문서를 넣을 지식베이스를 정하는 과정입니다. 파일명·경로·메타데이터·임베딩 유사도·LLM 판단 등의 규칙을 정책으로 구성하고, 목적지와 판단 이유를 기록합니다.
문서 파싱
파싱은 파일에서 검색에 사용할 텍스트와 구조를 추출하는 과정입니다. 파일 유형과 문서 특성에 맞는 파서를 선택하고, 추출한 Markdown의 표·제목·읽기 순서를 원본과 비교해 확인합니다.
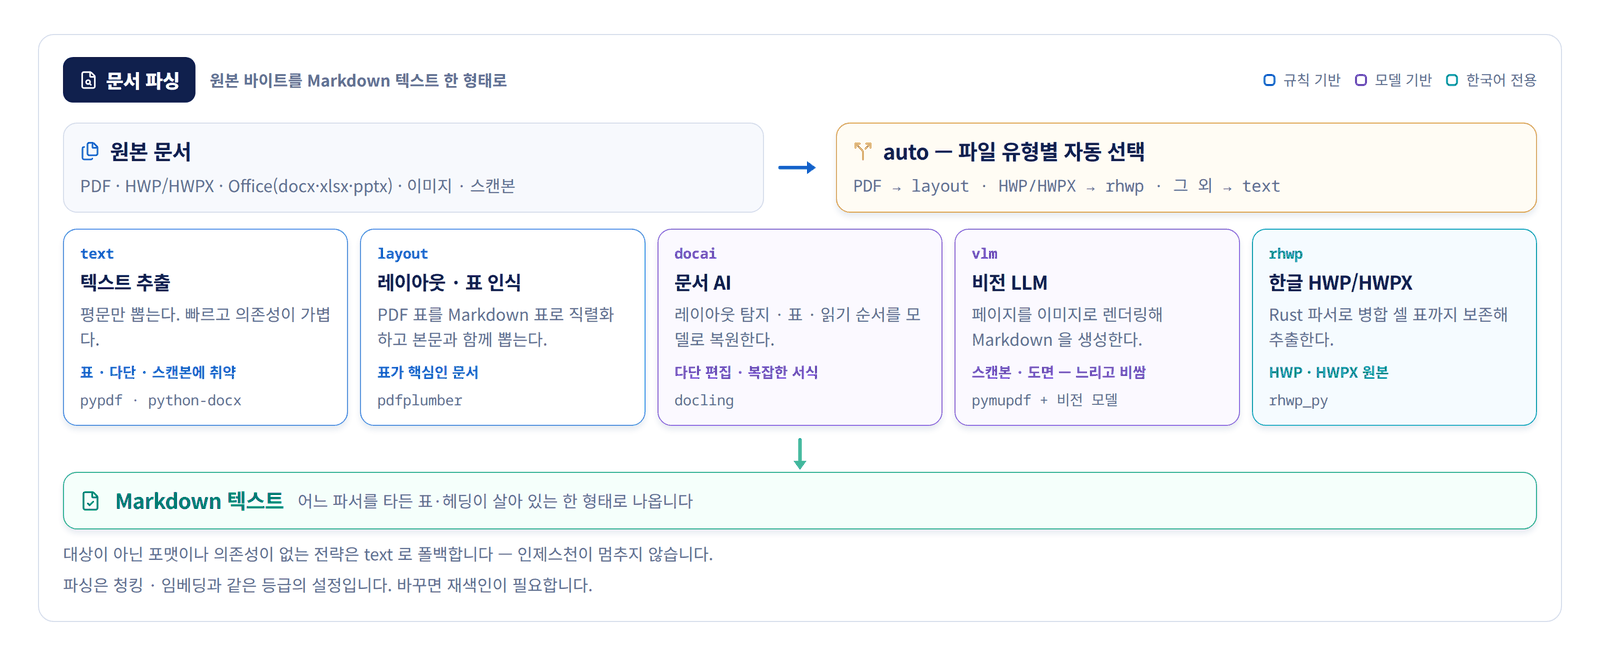
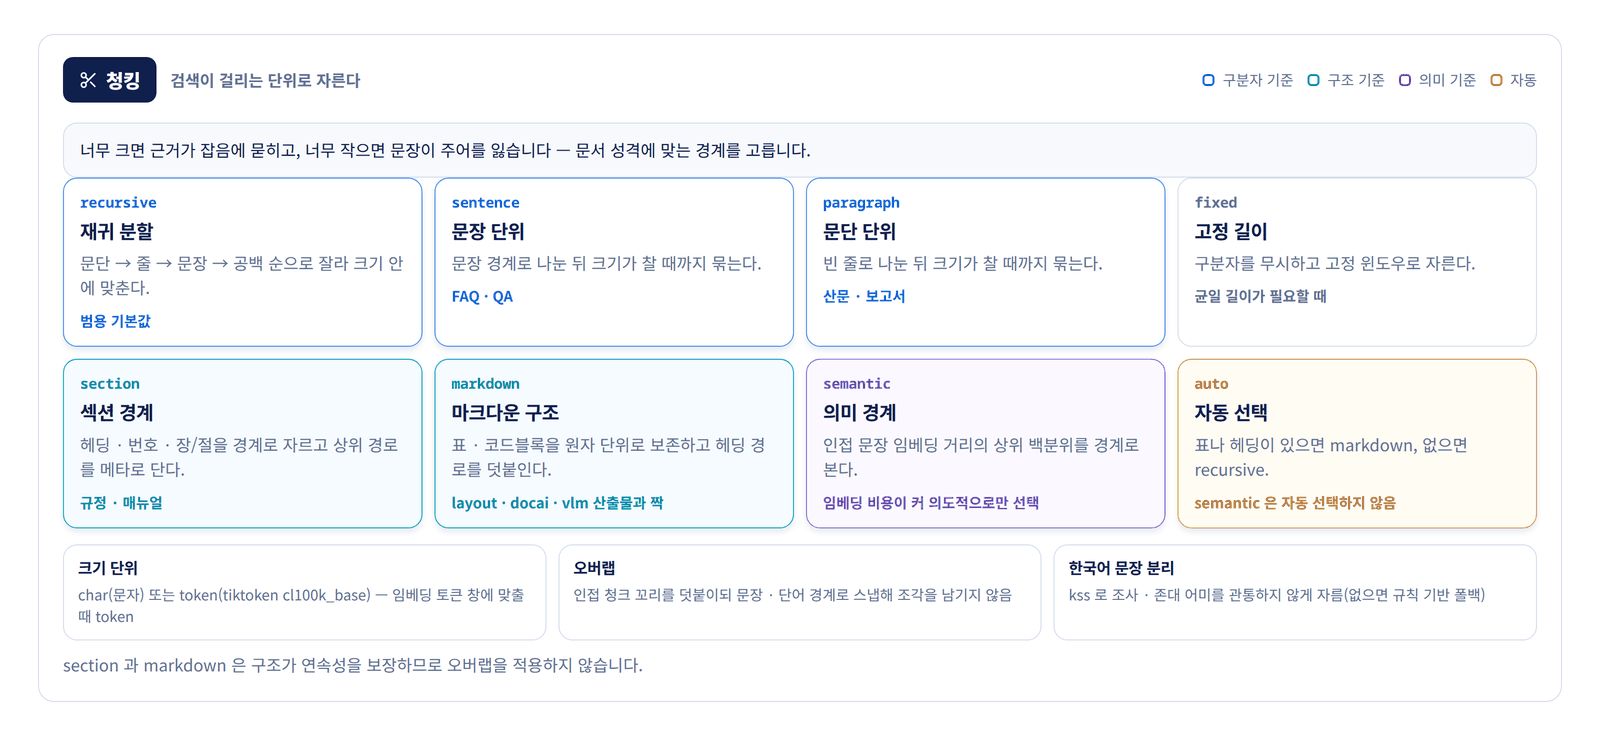
한국 문서를 위한 파이프라인
HWP/HWPX의 표, 스캔 PDF, 다단 편집과 한국어 문장 경계에 맞춰 처리 경로를 선택합니다. 추출 결과와 원본을 비교하고, 문서 버전과 이미지 라벨을 검토해 검색에 반영합니다.
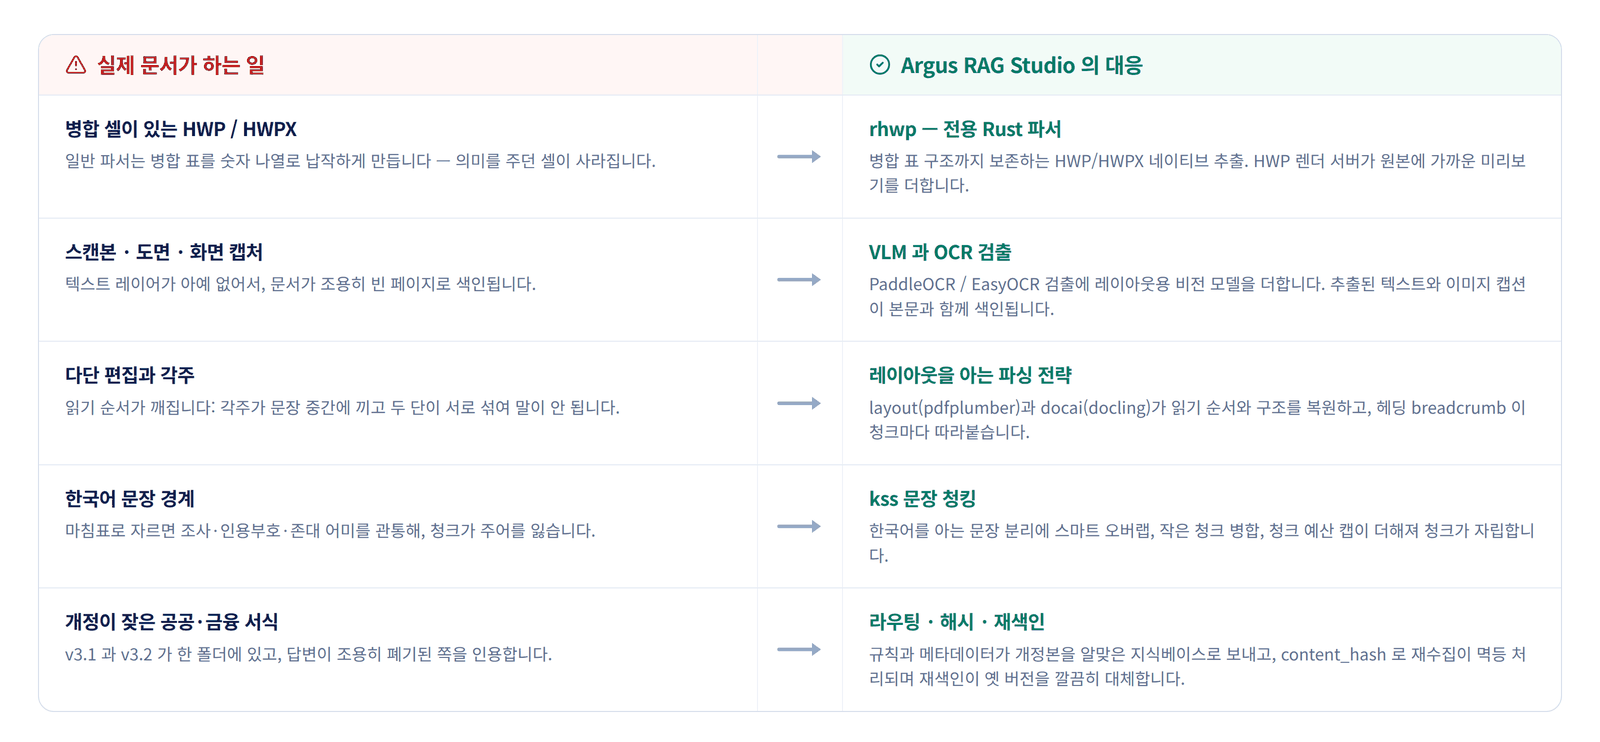
PII 마스킹
PII는 개인을 식별할 수 있는 정보입니다. 변환을 활성화하면 파싱한 본문에서 설정한 규칙에 일치하는 내용을 청킹·임베딩 전에 마스킹합니다. 탐지 누락을 점검하고, 원본 파일의 저장과 접근 정책은 별도로 관리합니다.
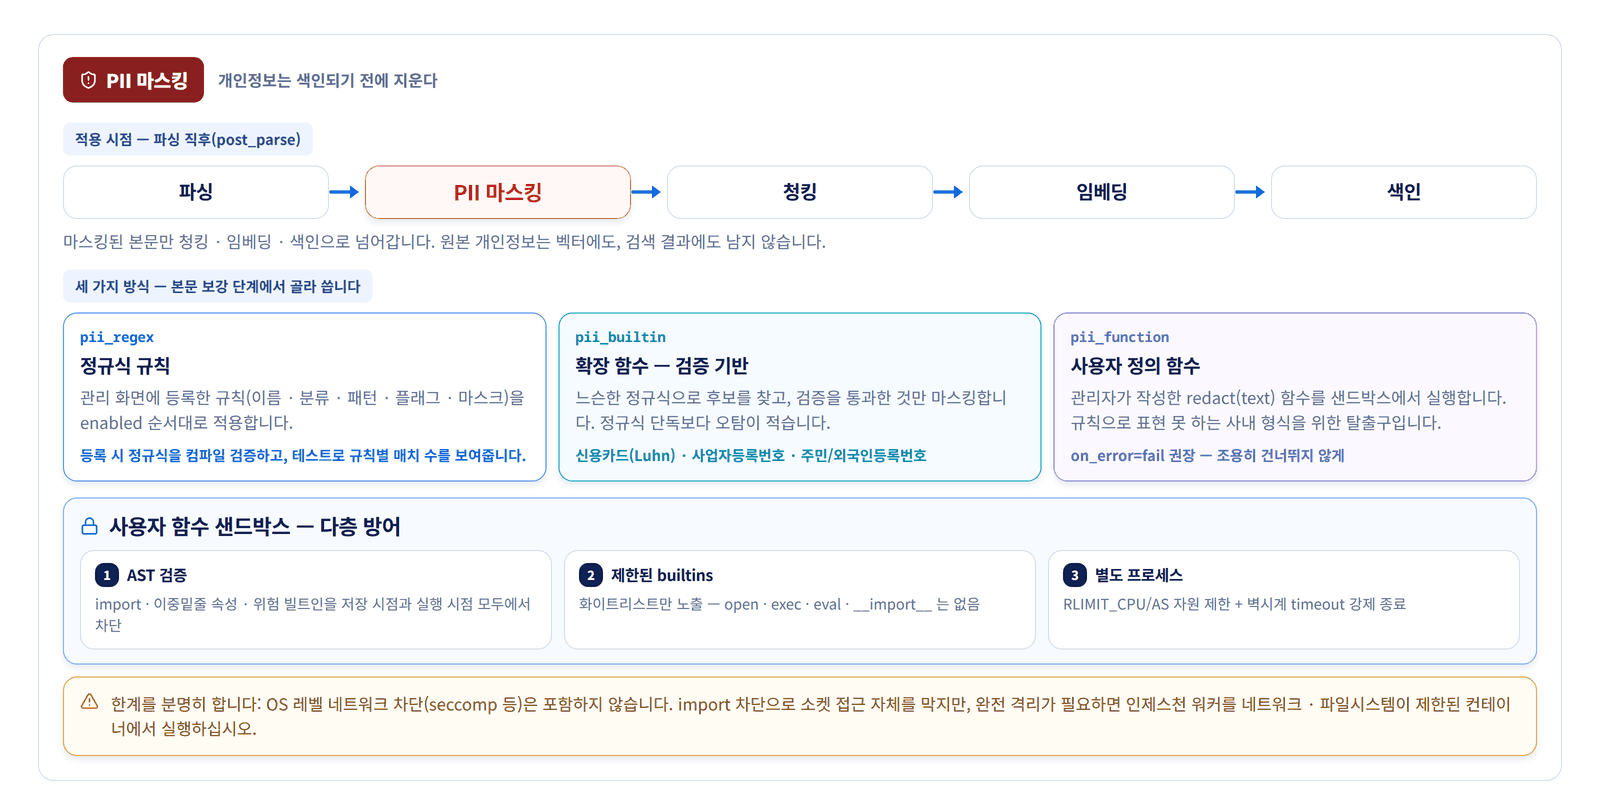
청킹
청킹은 문서를 검색 가능한 구절인 청크로 나누는 과정입니다. 청크가 너무 크면 관련 없는 내용이 섞이고, 너무 작으면 필요한 컨텍스트가 끊길 수 있습니다. 문서에 맞는 경계·크기·겹침을 선택하고 검색 결과로 확인합니다.
임베딩
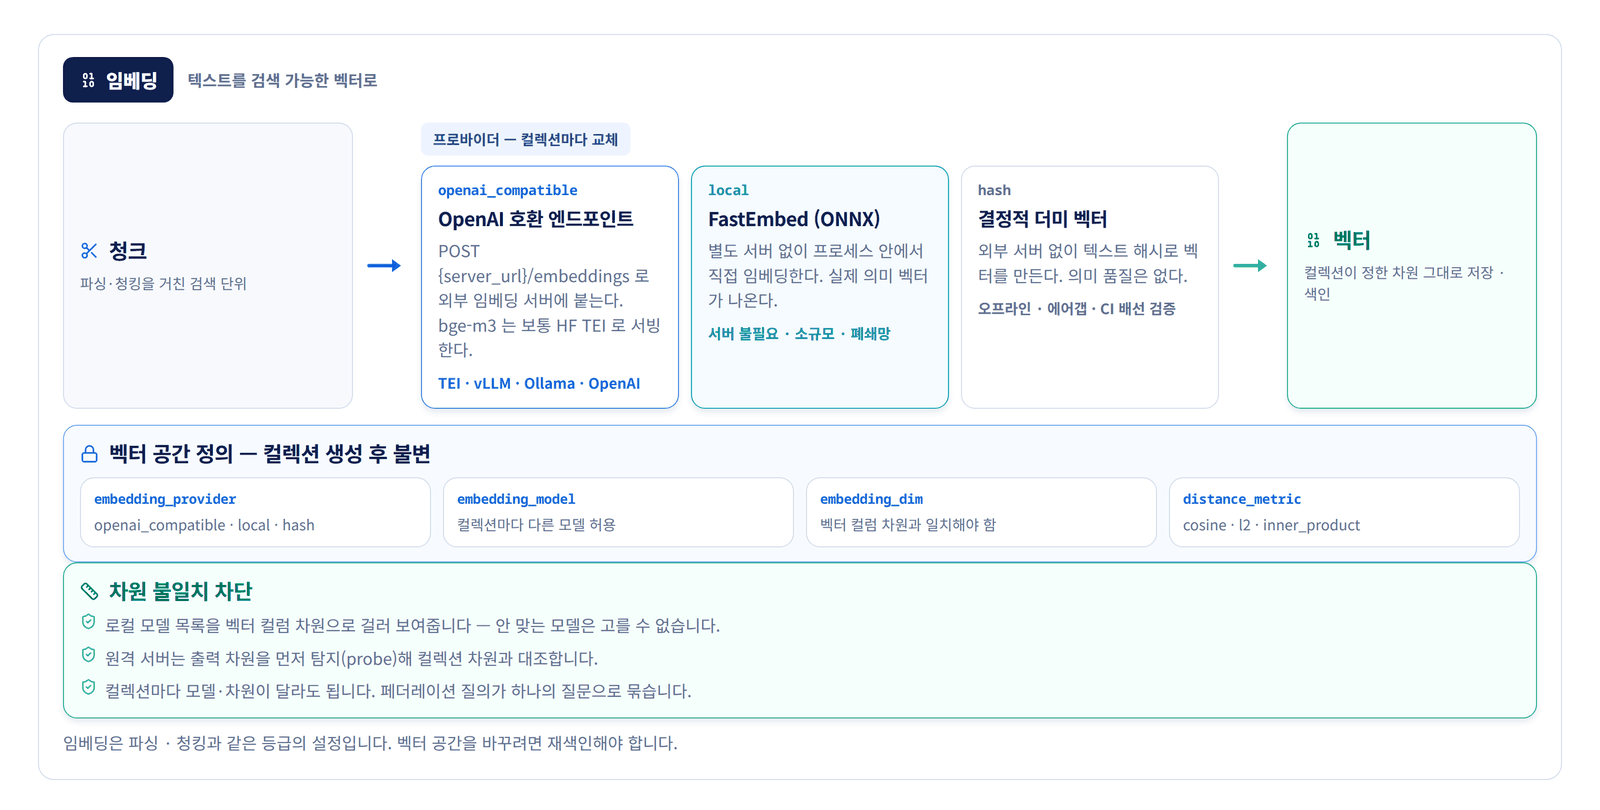
임베딩 설정이 컬렉션의 벡터 공간을 정합니다. 프로바이더 · 모델 · 차원 · 거리 지표는 컬렉션을 만들 때 확정되고, 이후 변경하려면 재인덱싱이 필요합니다.
03 · 근거 검색과 답변 생성
준비한 문서에서 질문에 맞는 근거를 찾고, 우선순위를 정해 인용이 있는 답변으로 연결합니다.
검색 · 생성
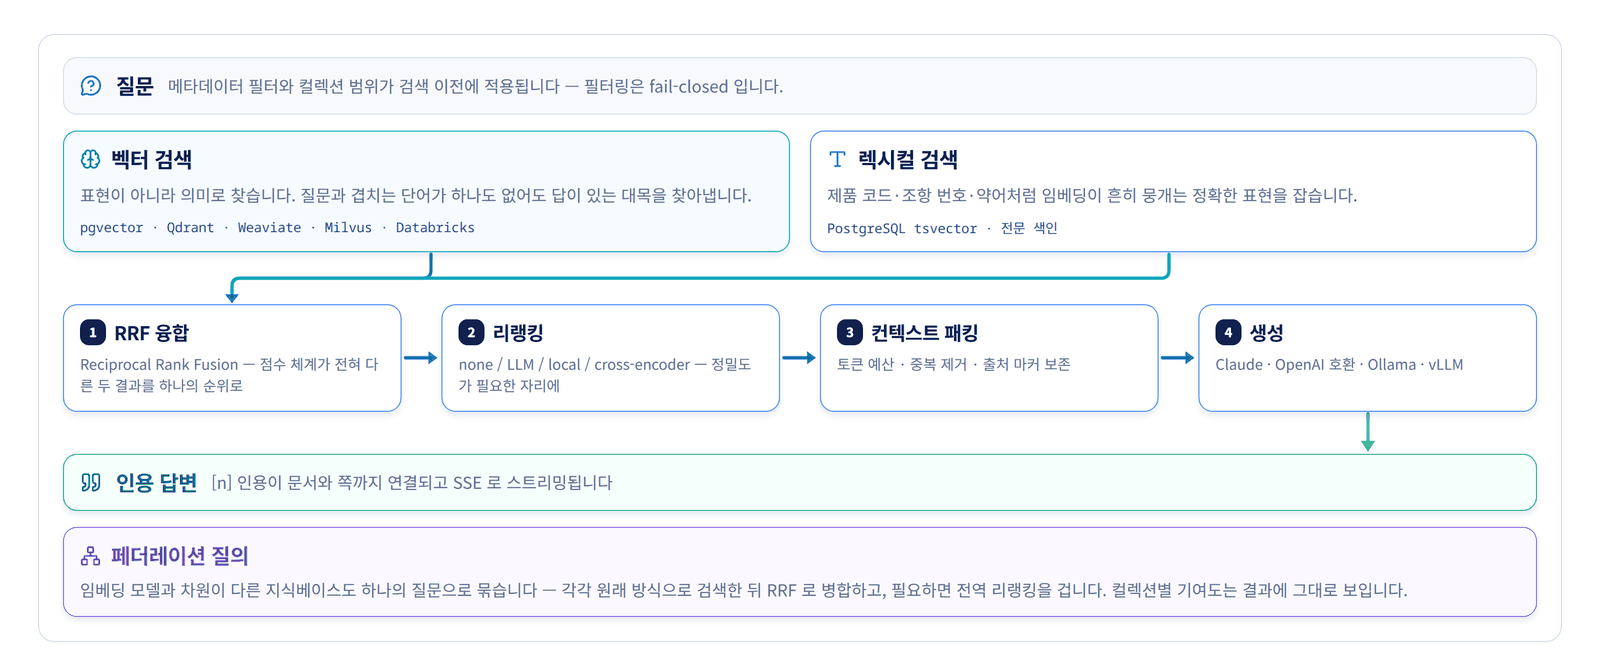
질문에 맞는 근거를 찾아 인용을 포함한 답변을 만드는 단계
검색
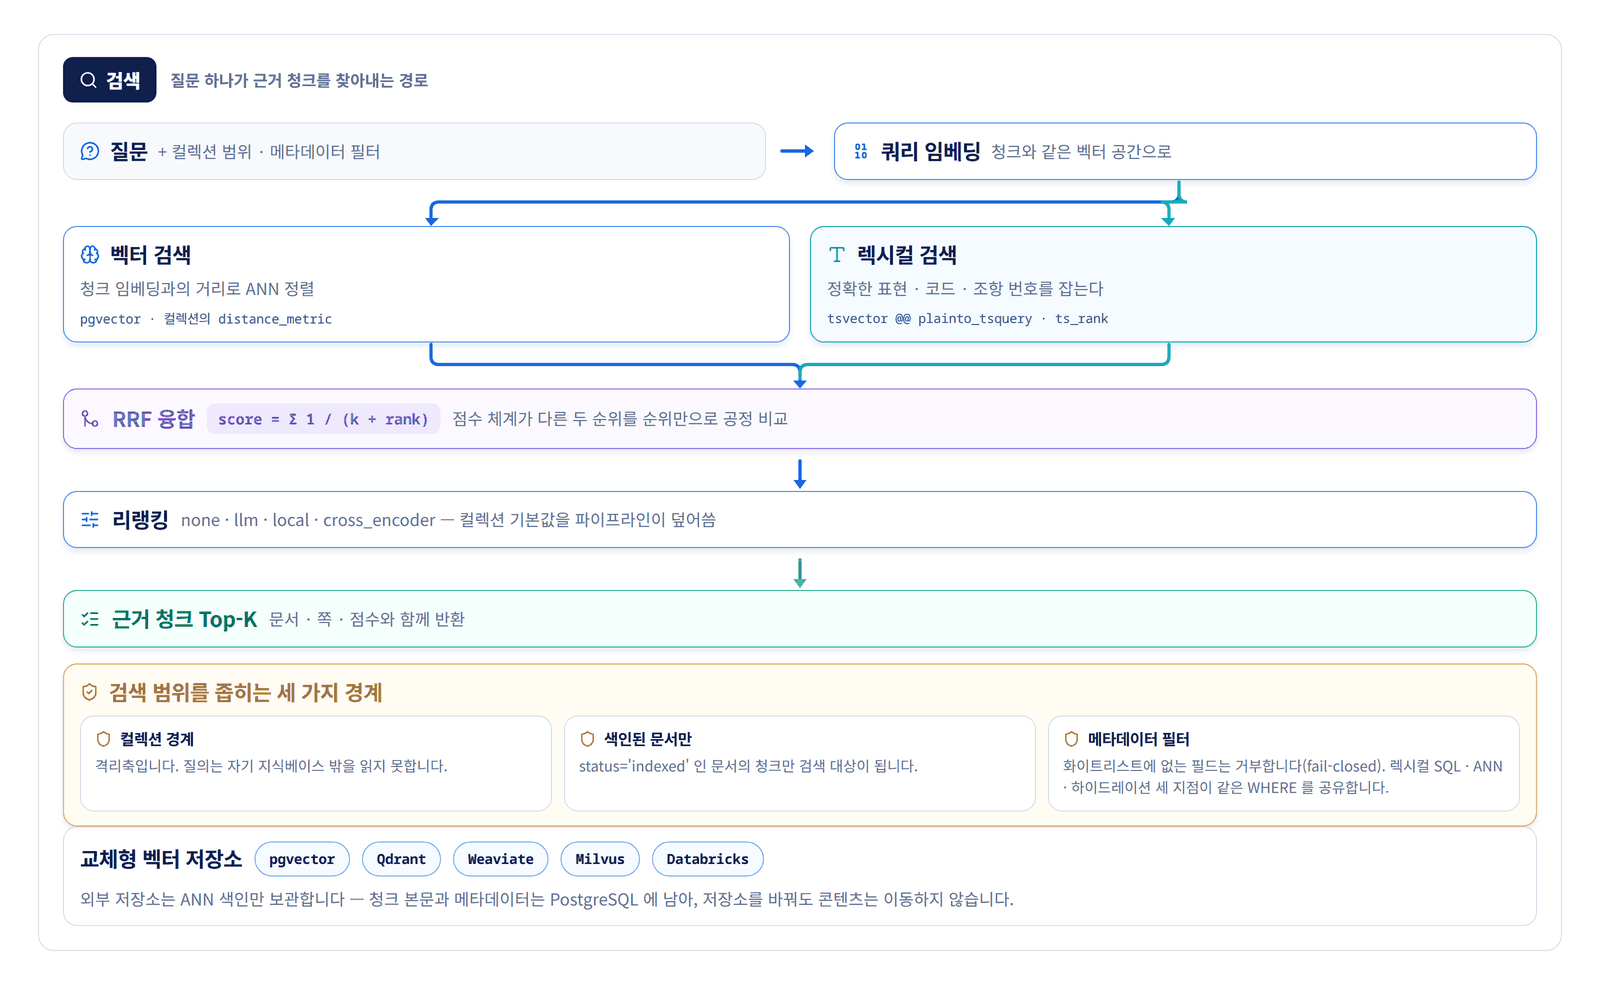
질문에서 만든 벡터와 질문의 단어로 후보 청크를 찾고, 두 검색 순위를 RRF로 통합합니다. 컬렉션 범위와 메타데이터 필터로 결과를 좁히며, 본문과 메타데이터는 PostgreSQL에서 읽습니다.
리랭킹
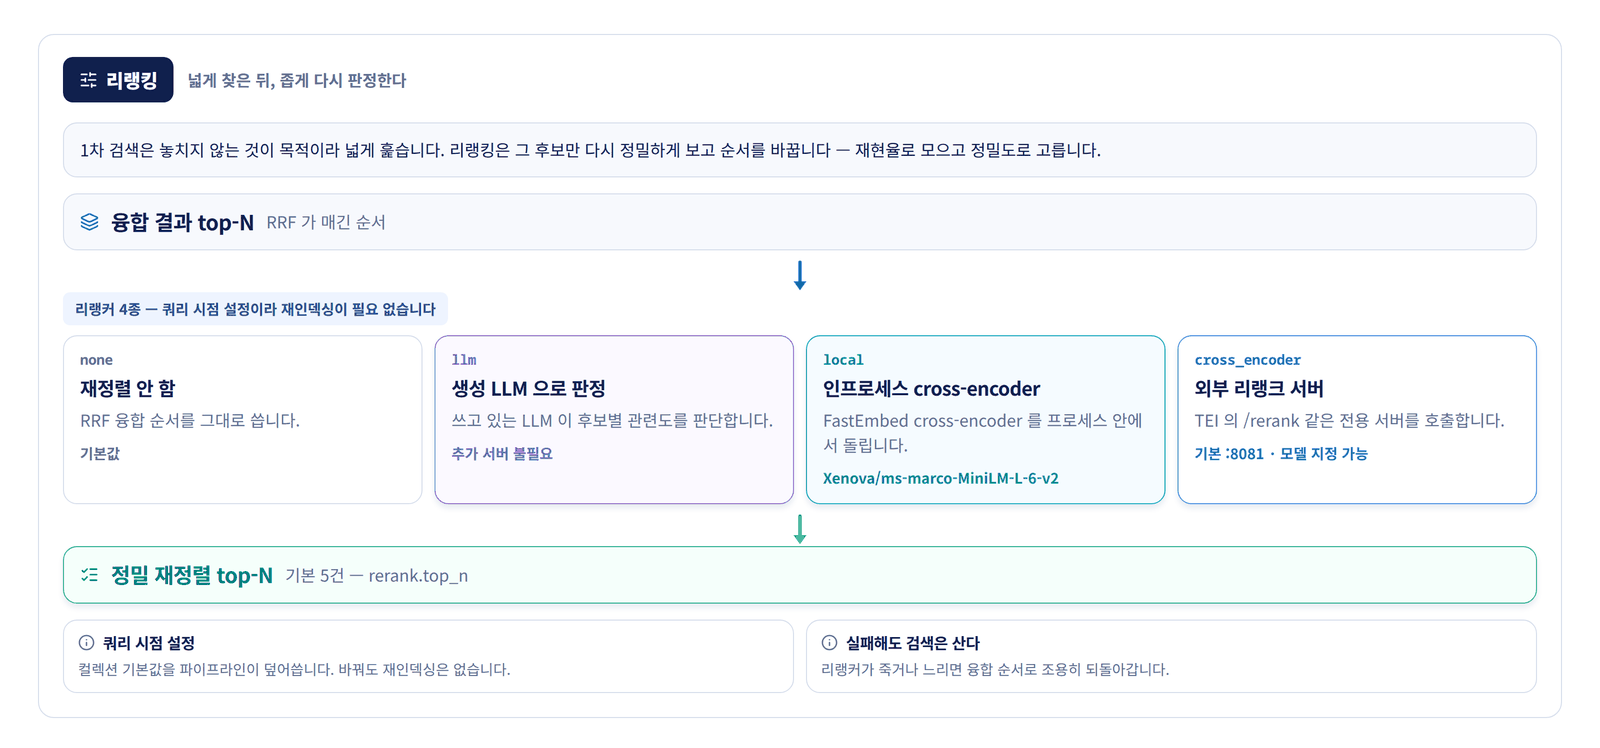
1차 검색이 모은 후보를 질문과 함께 다시 평가해 순서를 바꿉니다. 리랭킹은 후보에 없는 근거를 새로 찾지는 않으며, 설정 변경에는 재인덱싱이 필요하지 않습니다.
사내 문서에서 인용을 포함한 답변까지
문서 인덱싱 경로와 질문 처리 경로를 나누어 구성하고, 검색된 근거를 답변의 컨텍스트로 전달합니다.
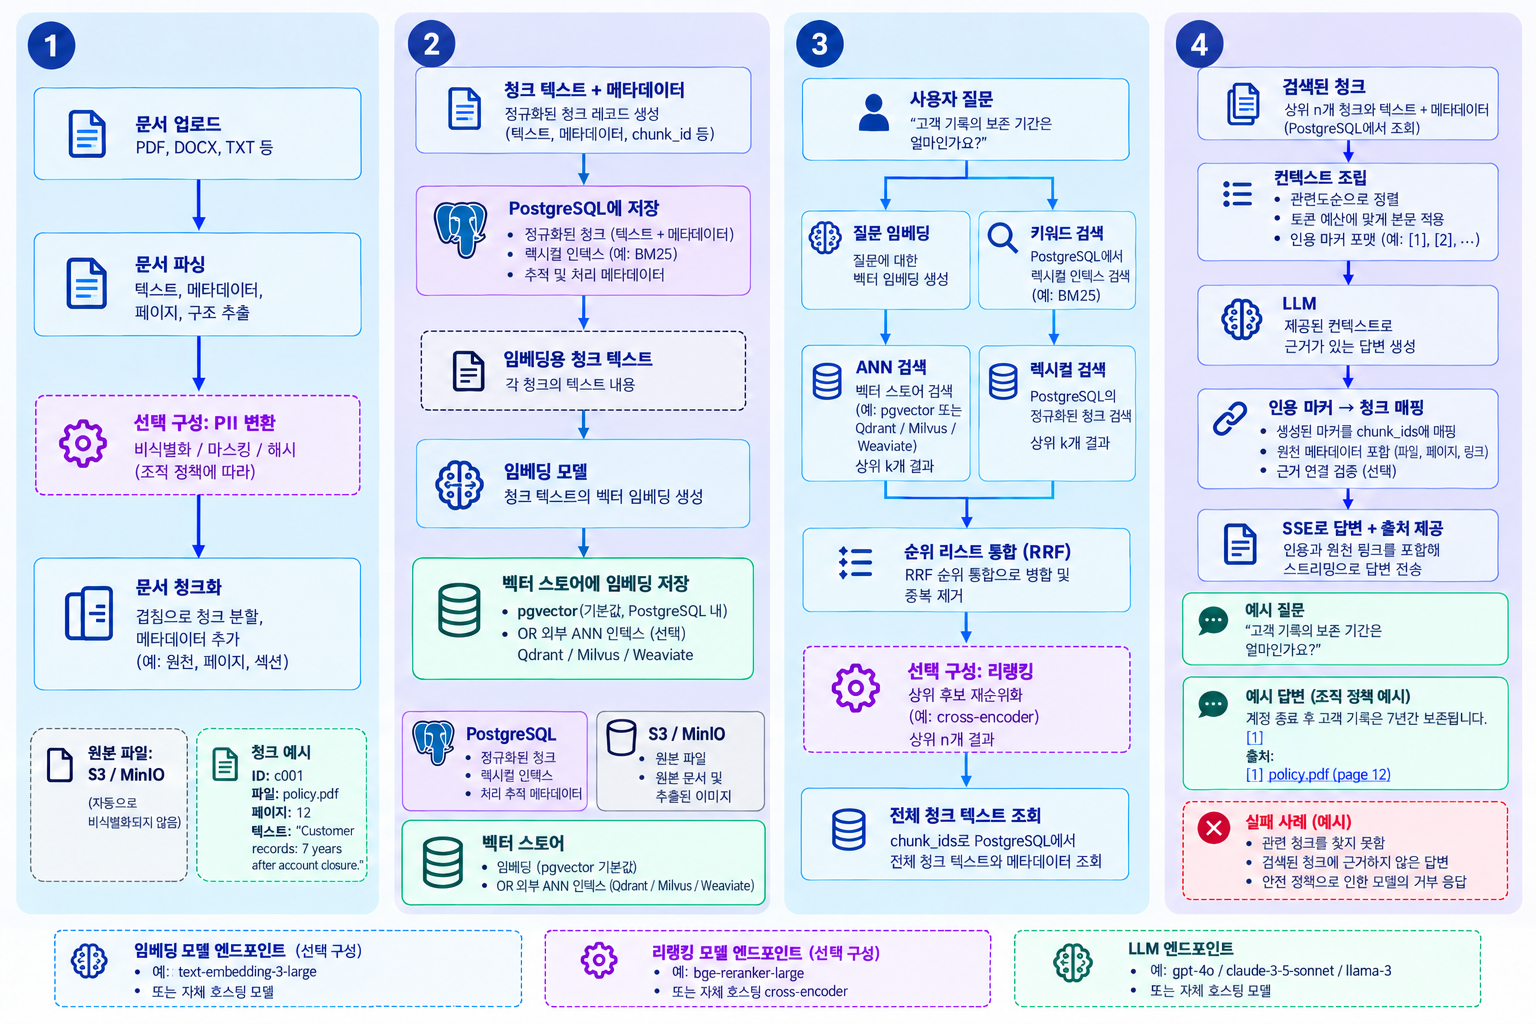
- 1.문서 준비
- 라우팅으로 컬렉션을 정하고 문서를 파싱한 뒤 활성화된 PII 변환을 적용합니다.
- 2.인덱스 구축
- 청크·메타데이터·벡터를 저장하고 원본 문서는 오브젝트 스토리지에서 관리합니다.
- 3.근거 검색
- 벡터·렉시컬 검색 순위를 RRF로 통합하고 필요한 경우 리랭킹합니다.
- 4.인용 답변 생성
- 검색된 구절을 모델에 전달하고 스트리밍 답변의 인용 마커를 청크와 연결합니다.
PII 변환과 외부 추론 서버는 선택 구성입니다. 인용 마커를 검색 청크에 연결하지만, 모든 답변 문장의 정확성을 보장하지는 않습니다.
GitHub 문서·코드 확인04 · 품질 평가와 개선
검색과 답변의 품질을 확인한 뒤, 설정을 비교하고 검증된 버전을 운영에 적용합니다.
평가
검색은 LLM 없이 Hit Rate · MRR 로 계산하고, 답변은 LLM 평가자가 충실성 · 관련성 · 정확성으로 평가를 합니다. 설정 변경은 재인덱싱이 필요한 것과 아닌 것으로 나눠 탐색하고, 홀드아웃과 과적합 플래그가 최고 점수 설정을 검증합니다.
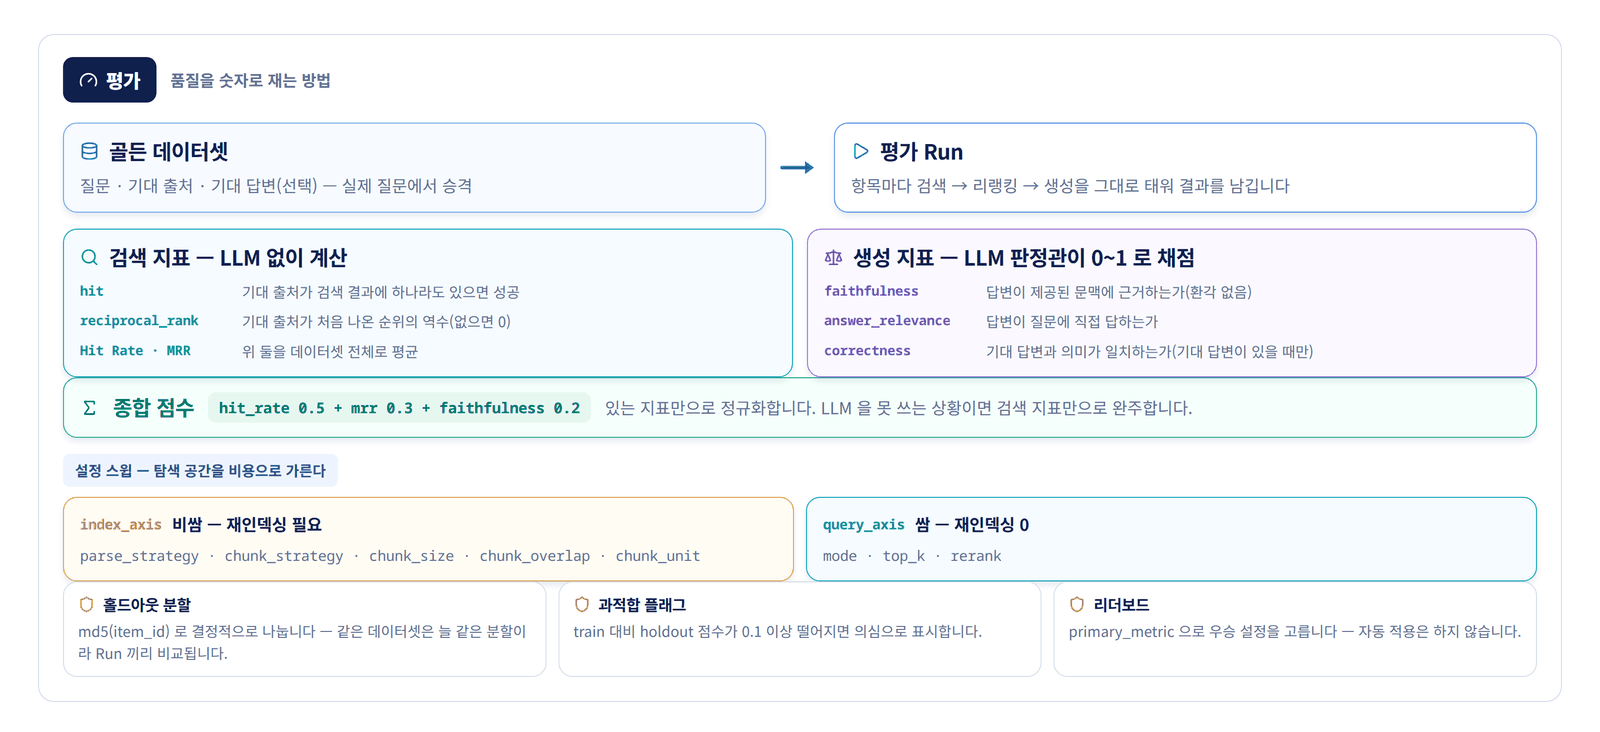
평가 · 운영
품질을 평가하고 설정·실행 버전과 운영 상태를 관리하는 단계
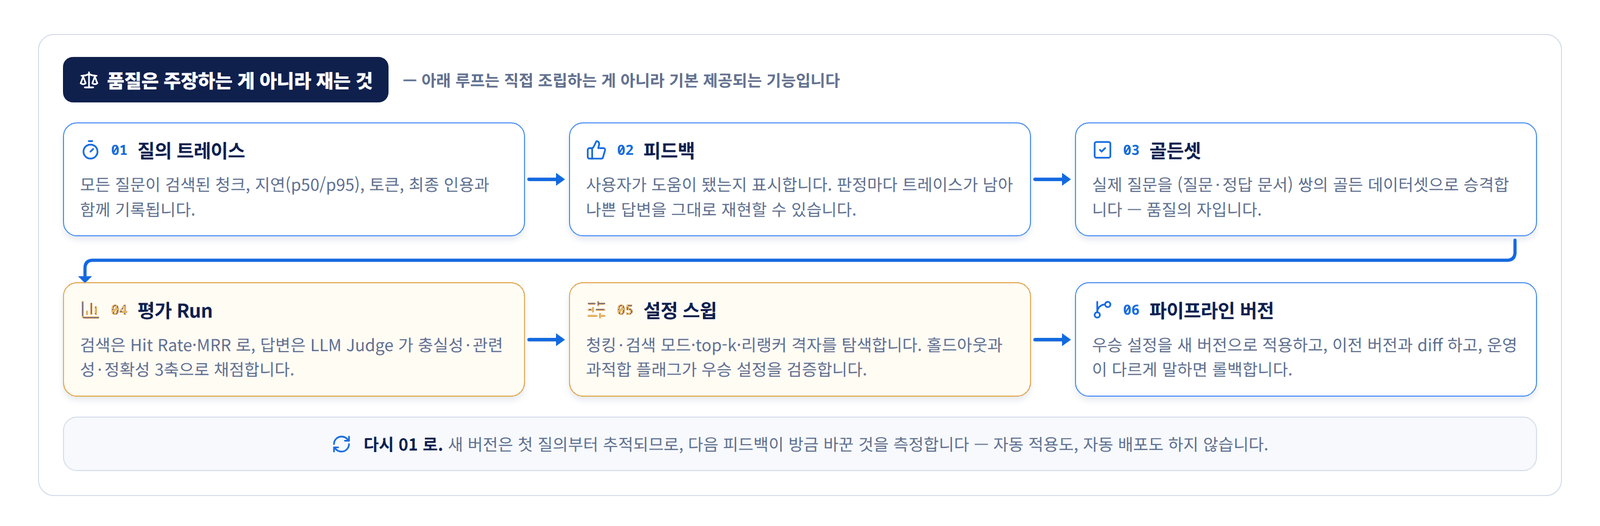
평가 결과를 다음 운영 설정으로
골든셋으로 품질을 측정하고, 설정을 비교·선택한 뒤 파이프라인 버전과 배포 상태를 관리합니다.
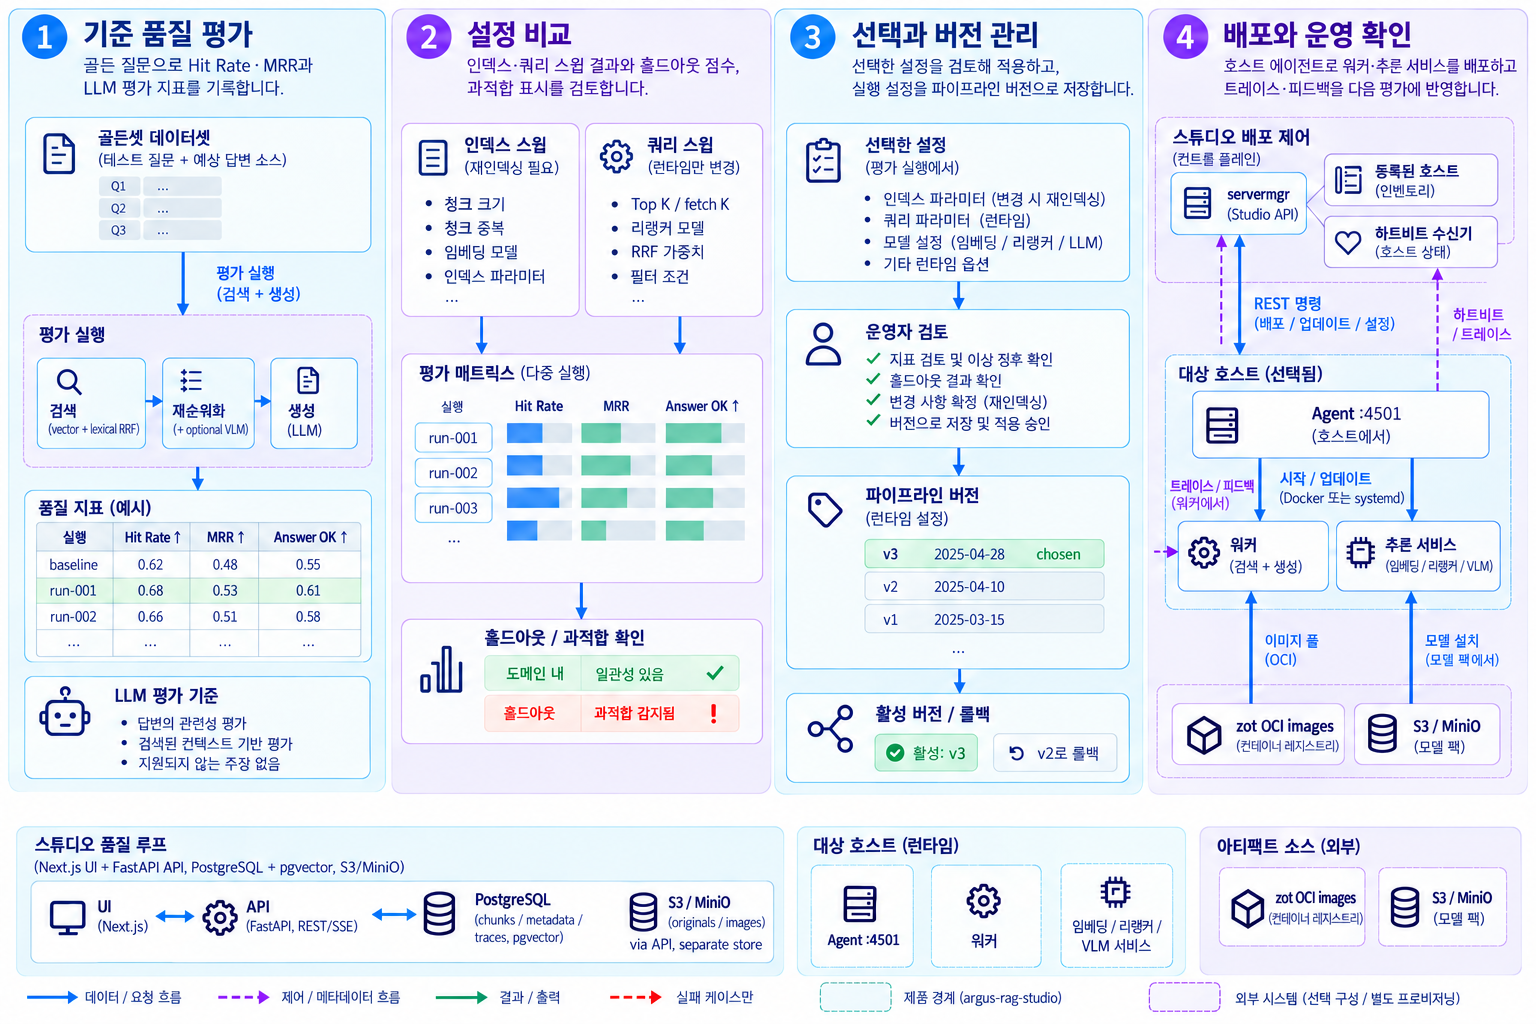
- 1.기준 품질 평가
- 골든 질문으로 Hit Rate·MRR과 LLM 평가 지표를 기록합니다.
- 2.설정 비교
- 인덱스·쿼리 스윕 결과와 홀드아웃 점수, 과적합 표시를 검토합니다.
- 3.선택과 버전 관리
- 선택한 설정을 검토해 적용하고, 실행 설정을 파이프라인 버전으로 저장합니다.
- 4.배포와 운영 확인
- 호스트 에이전트로 워커·추론 서비스를 배포하고 트레이스·피드백을 다음 평가에 반영합니다.
스윕은 지정한 탐색 범위에서 설정을 비교합니다. 인덱스 변경은 재인덱싱이 필요할 수 있으며, 쿼리 설정 권장값 적용과 서비스 배포는 별도 작업입니다.
GitHub 문서·코드 확인05 · 시스템 구성 이해
앞에서 살펴본 문서 처리·검색·평가 기능을 실제 서비스와 저장소가 어떻게 나누어 맡는지 봅니다.
개념도
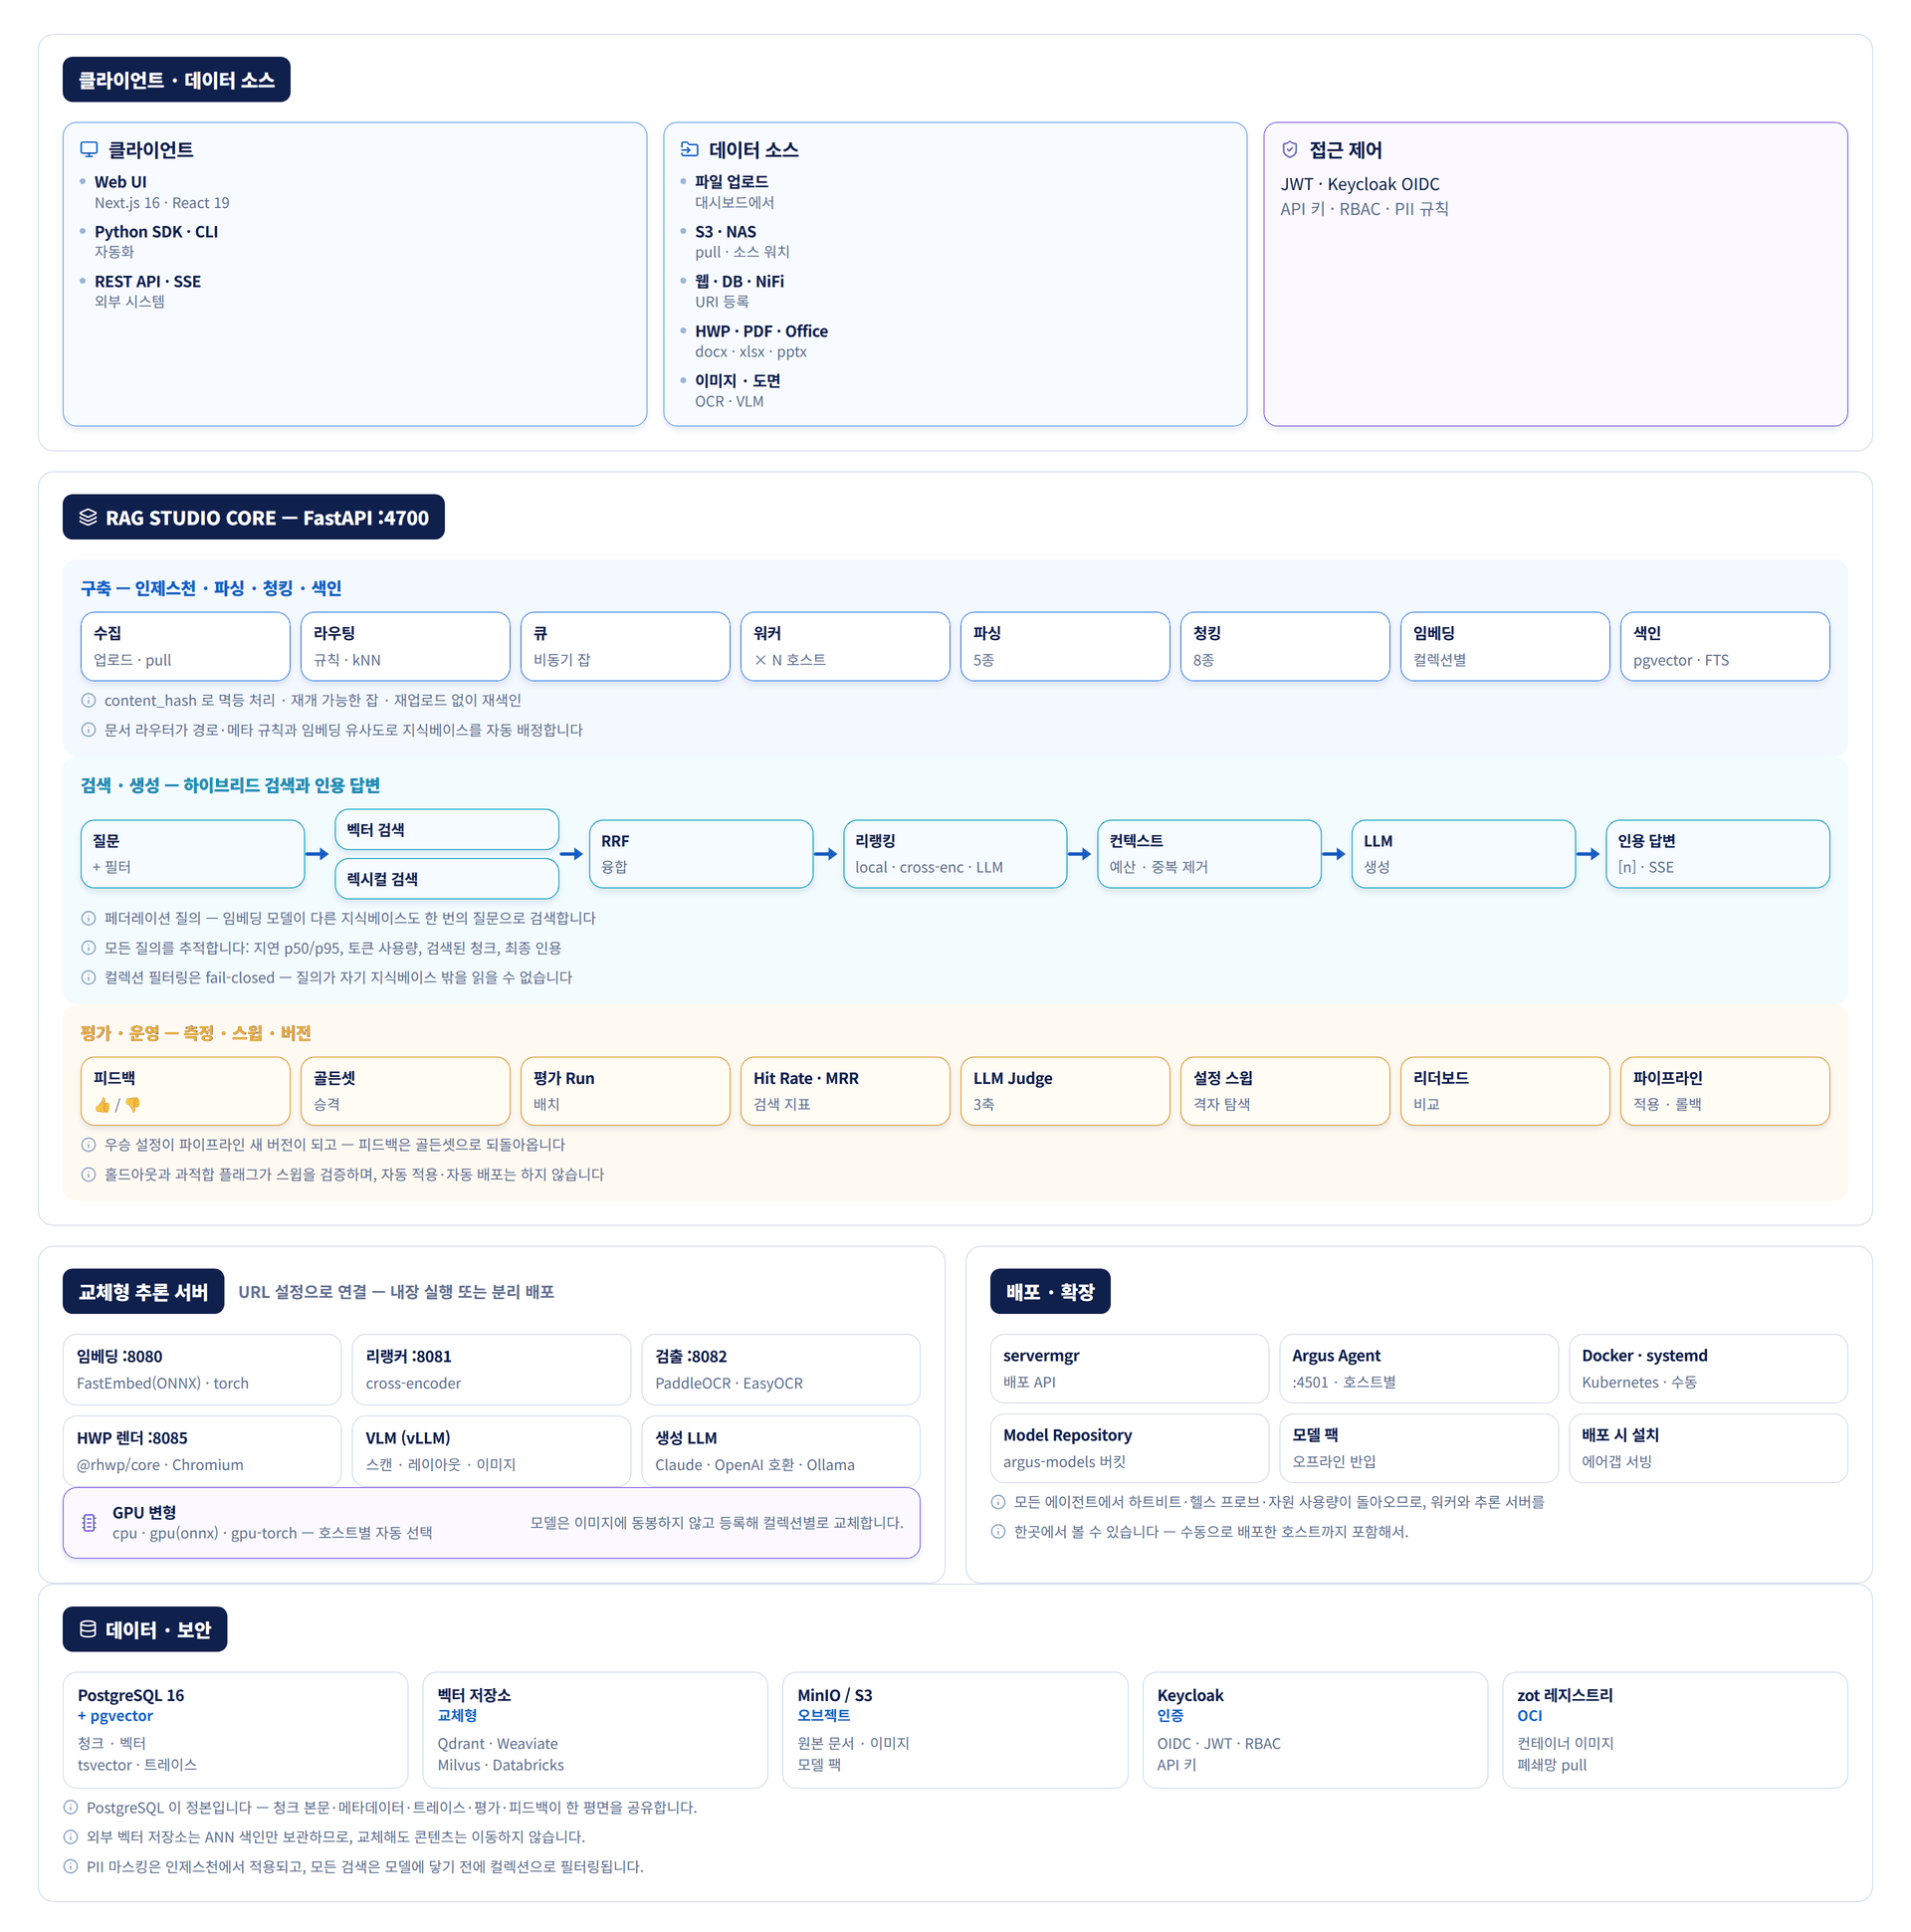
문서 준비와 질문 처리를 API·워커가 연결합니다. PostgreSQL은 청크와 운영 데이터를, S3/MinIO는 원본과 이미지를 관리하며, 추론 서비스와 호스트 에이전트가 필요한 처리·배포를 담당합니다.
06 · 배포와 운영 확장
기본 흐름을 이해했다면 에어갭 환경, 에이전트, 연동과 운영 기능을 살펴봅니다.
폐쇄망(에어갭) 배포
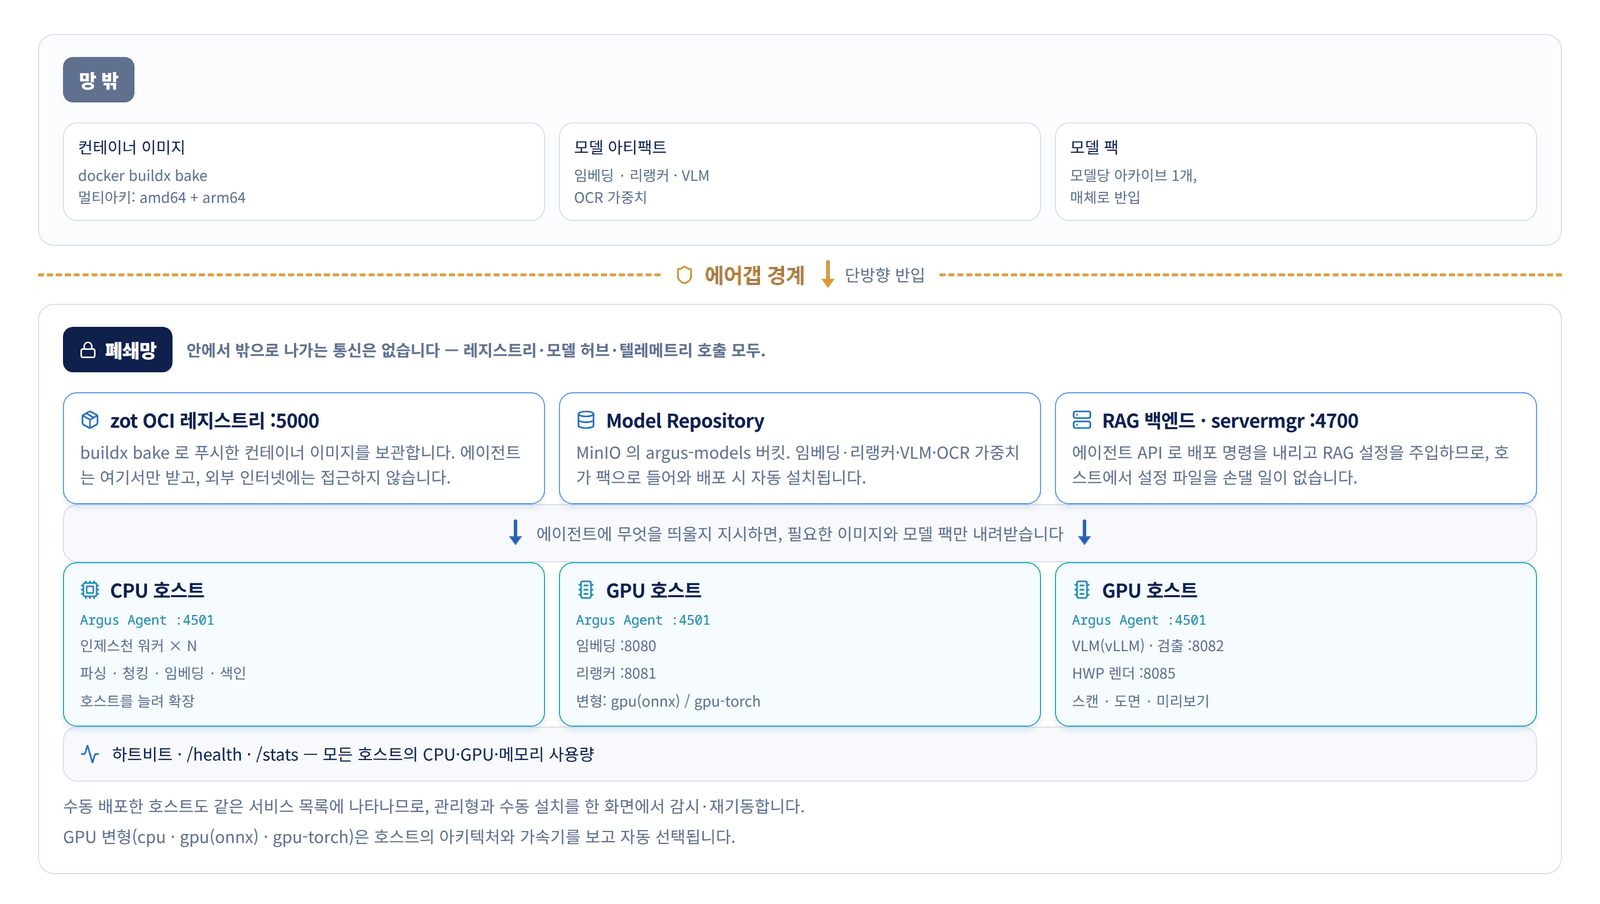
컨테이너 이미지와 모델 팩을 각각 반입하고, 호스트의 Argus Agent로 워커와 추론 서비스를 배포합니다. 오프라인 운영에는 내부 레지스트리·모델 저장소·로컬 엔드포인트를 준비해야 합니다.
품질 개선과 폐쇄망 운영
기존 RAG 파이프라인에 평가·검색 학습·호스트 에이전트·이미지 검토를 연결합니다.
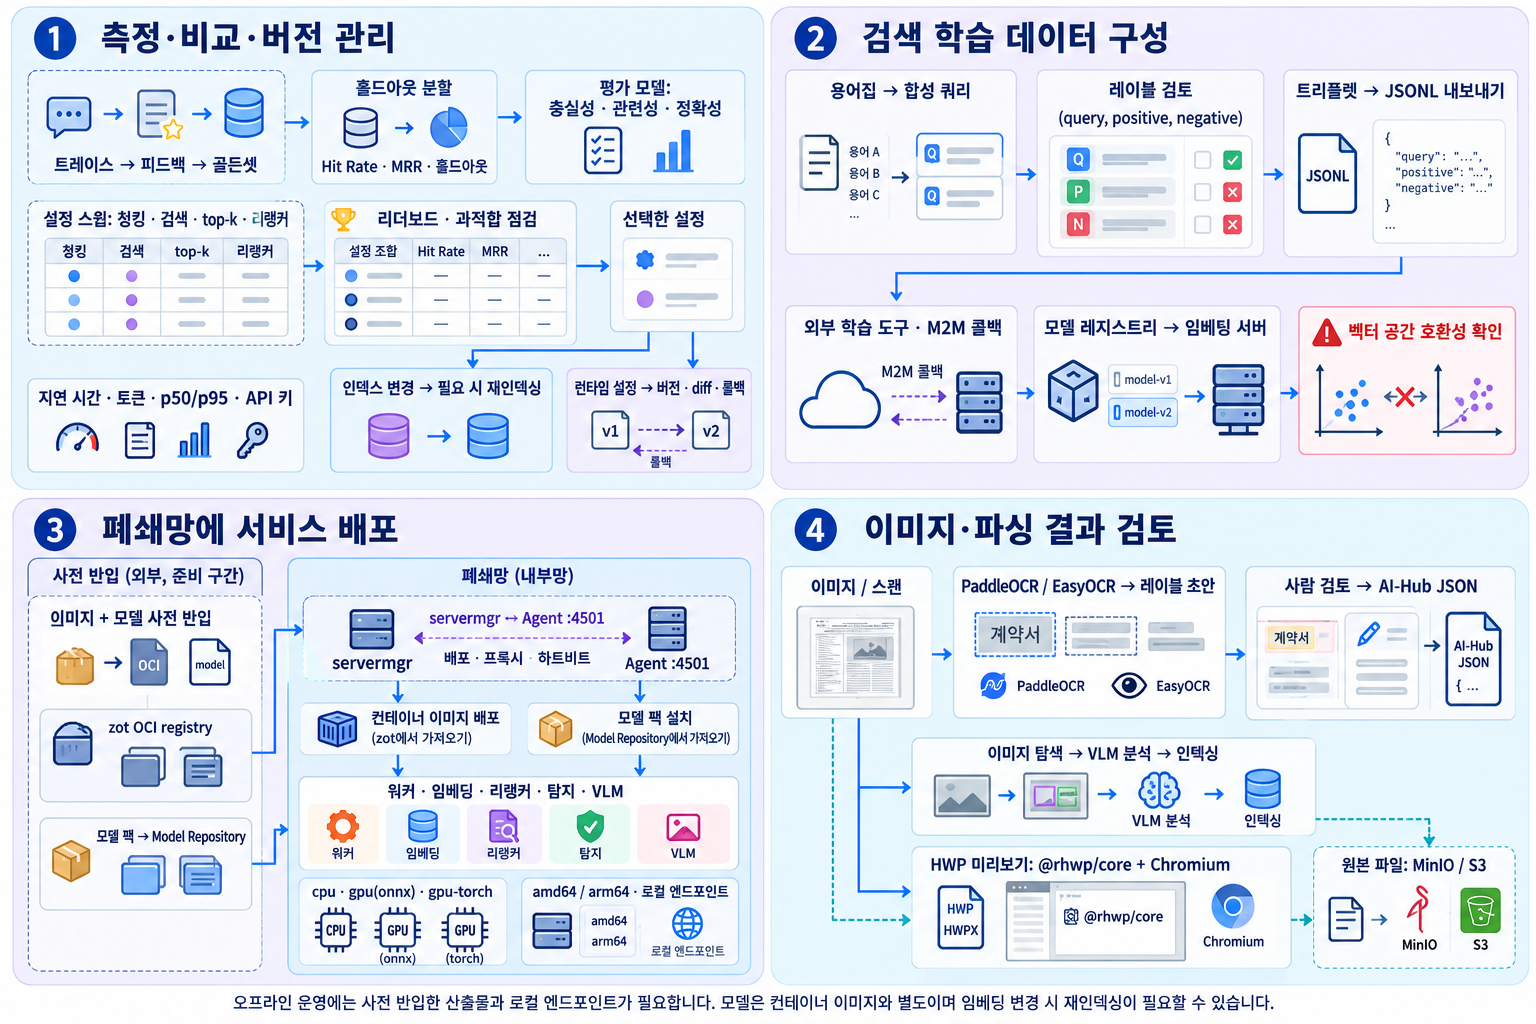
- 1.평가·버전
- 홀드아웃 지표를 비교하고 인덱스 변경과 런타임 버전을 구분해 적용합니다.
- 2.검색 학습
- 합성 트리플렛을 검토하고 외부 학습·모델 등록을 연결합니다.
- 3.폐쇄망 배포
- 이미지와 모델을 별도 반입하고 호스트 에이전트로 서비스를 배포합니다.
- 4.이미지 처리
- OCR 어노테이션을 검토하고 이미지를 탐색하며 VLM 분석 내용을 인덱싱합니다.
오프라인 운영에는 사전 반입한 산출물과 로컬 엔드포인트가 필요합니다. 모델은 컨테이너 이미지와 별도이며 임베딩 변경 시 재인덱싱이 필요할 수 있습니다.
GitHub 문서·코드 확인오픈소스로 공개되는 RAG 플랫폼
Argus RAG Studio는 Apache License 2.0으로 GitHub에 공개됩니다. 백엔드(FastAPI)·프론트엔드(Next.js)·독립 임베딩/리랭커 서버까지 RAG 엔진 전체를 공개해, 기업이 코드를 직접 검증하고 자사 환경에 맞게 확장하며 데이터를 외부로 내보내지 않고 운영할 수 있습니다.
- 상용 활용 제약 없는 Apache 2.0
- 코드 직접 검증·확장 가능
- 에어갭·온프레미스 자체 운영