
Starburst (Trino)
Trino 기반 엔터프라이즈 레이크하우스 분석 플랫폼입니다. 여러 소스의 데이터를 한곳에 사전 적재하지 않아도 SQL로 분석할 수 있습니다. Starburst Enterprise와 완전 관리형 Galaxy를 통해 보안·거버넌스·운영 기능을 활용합니다.
하나의 SQL이 여러 데이터 소스를 연결하는 과정
모든 데이터를 한 저장소로 사전 통합하지 않고, 필요한 데이터를 연결해 분석합니다.
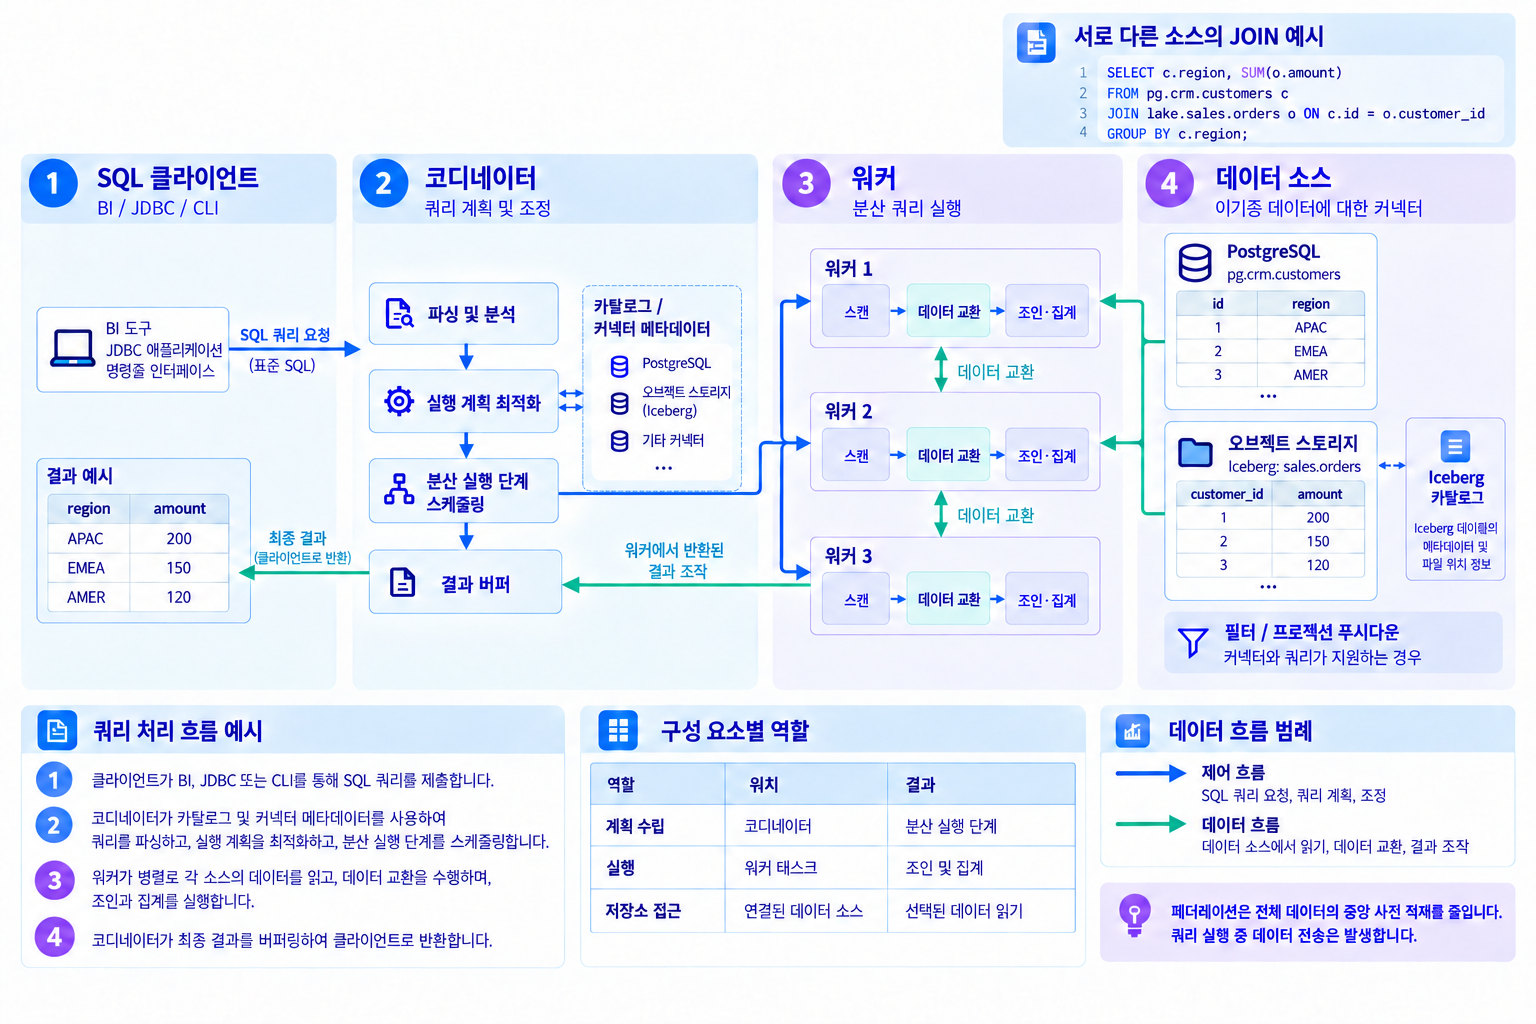
그림 설명과 제품·서비스 상세 보기
- 1.SQL 요청
- BI 도구가 고객·주문 테이블을 조인해 지역별 주문 금액을 집계하는 SQL을 요청합니다.
- 2.실행 계획
- 코디네이터가 쿼리를 분석하고 데이터 소스와 통계에 맞는 실행 계획을 수립합니다.
- 3.분산 처리
- 워커가 소스를 조회하고 반환된 데이터를 조인·집계합니다. 지원되는 조건·집계는 소스로 푸시다운할 수 있습니다.
- 4.데이터 소스
- PostgreSQL의 고객 정보와 Iceberg의 주문 데이터를 필요한 범위만 읽고 결과를 반환합니다.
Starburst와 Trino 개요
Starburst는 Trino 기반 분산 SQL 엔진에 엔터프라이즈 보안·운영·성능 기능을 더한 데이터 분석 플랫폼입니다. 커넥터를 통해 레이크하우스·데이터베이스 등 여러 소스의 데이터를 연결하고, 모든 데이터를 한곳에 사전 적재하지 않아도 SQL 분석을 시작할 수 있습니다. 지원 소스와 기능은 제품·버전에 따라 확인합니다.
- Trino 기반 MPP 쿼리 엔진: 상시 코디네이터+워커 구조로 페타바이트급 데이터에 대화형 응답
- 데이터 페더레이션: Iceberg·Delta Lake·RDBMS·NoSQL·Kafka·SaaS 등 50+ 커넥터를 단일 SQL로
- Warp Speed 가속: 스마트 인덱싱·캐싱으로 쿼리 최대 5배, CPU 최대 10배 개선
- 엔터프라이즈 거버넌스: 행/열 단위 RBAC·ABAC, 동적 마스킹, Ranger 연동, 쿼리 감사
페더레이션 성능은 커넥터, 원천 시스템 부하, 네트워크, 데이터 분포와 동시성의 영향을 받습니다. 반복 조회는 사전 가공·적재가 더 적합할 수 있습니다.
공식 문서기존 Hadoop·Hive 환경의 단계적 현대화
연결부터 검증, 선택적 전환, 운영 정착까지 단계별 결과를 확인하며 전환 범위를 넓힙니다.
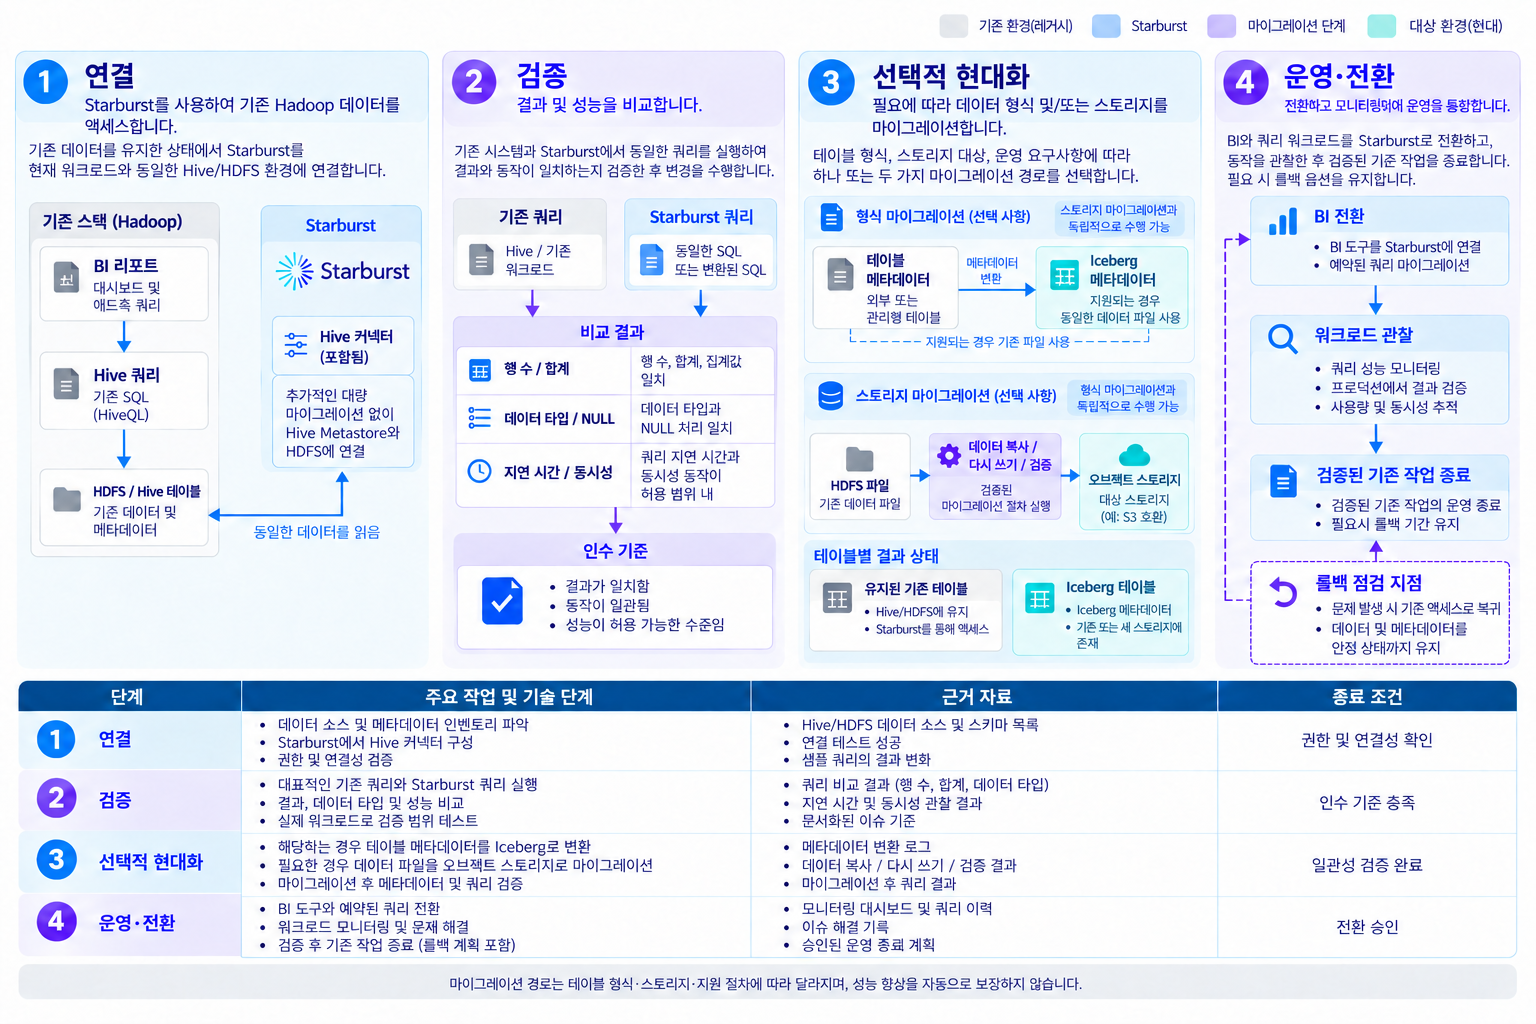
그림 설명과 제품·서비스 상세 보기
- 1.연결
- 기존 저장소·메타스토어에 연결하고 권한과 쿼리 호환성을 확인합니다.
- 2.병행 검증
- 일부 분석 쿼리를 병행 실행해 결과 일치, 응답 시간과 원천 시스템 부하를 측정합니다.
- 3.선택적 전환
- 테이블 포맷 전환과 저장 위치 변경을 구분합니다. 지원되는 절차를 선택하고 데이터·메타데이터의 정합성과 복구 절차를 검증합니다.
- 4.운영 정착
- 모니터링·권한·운영 교육을 정리하고 전환 승인과 되돌리기 기준에 따라 범위를 확대합니다.
그림은 전환 방식의 예시이며 성능 향상이나 무중단 전환을 보장하지 않습니다. Enterprise와 Galaxy의 기능·배포·운영 책임은 별도로 확인합니다.
공식 문서NiFi에서 S3·Iceberg를 거쳐 Starburst 조회까지
Parquet 업로드와 Iceberg 메타데이터 커밋을 분리해, 조회 가능한 테이블이 되는 과정을 보여줍니다.
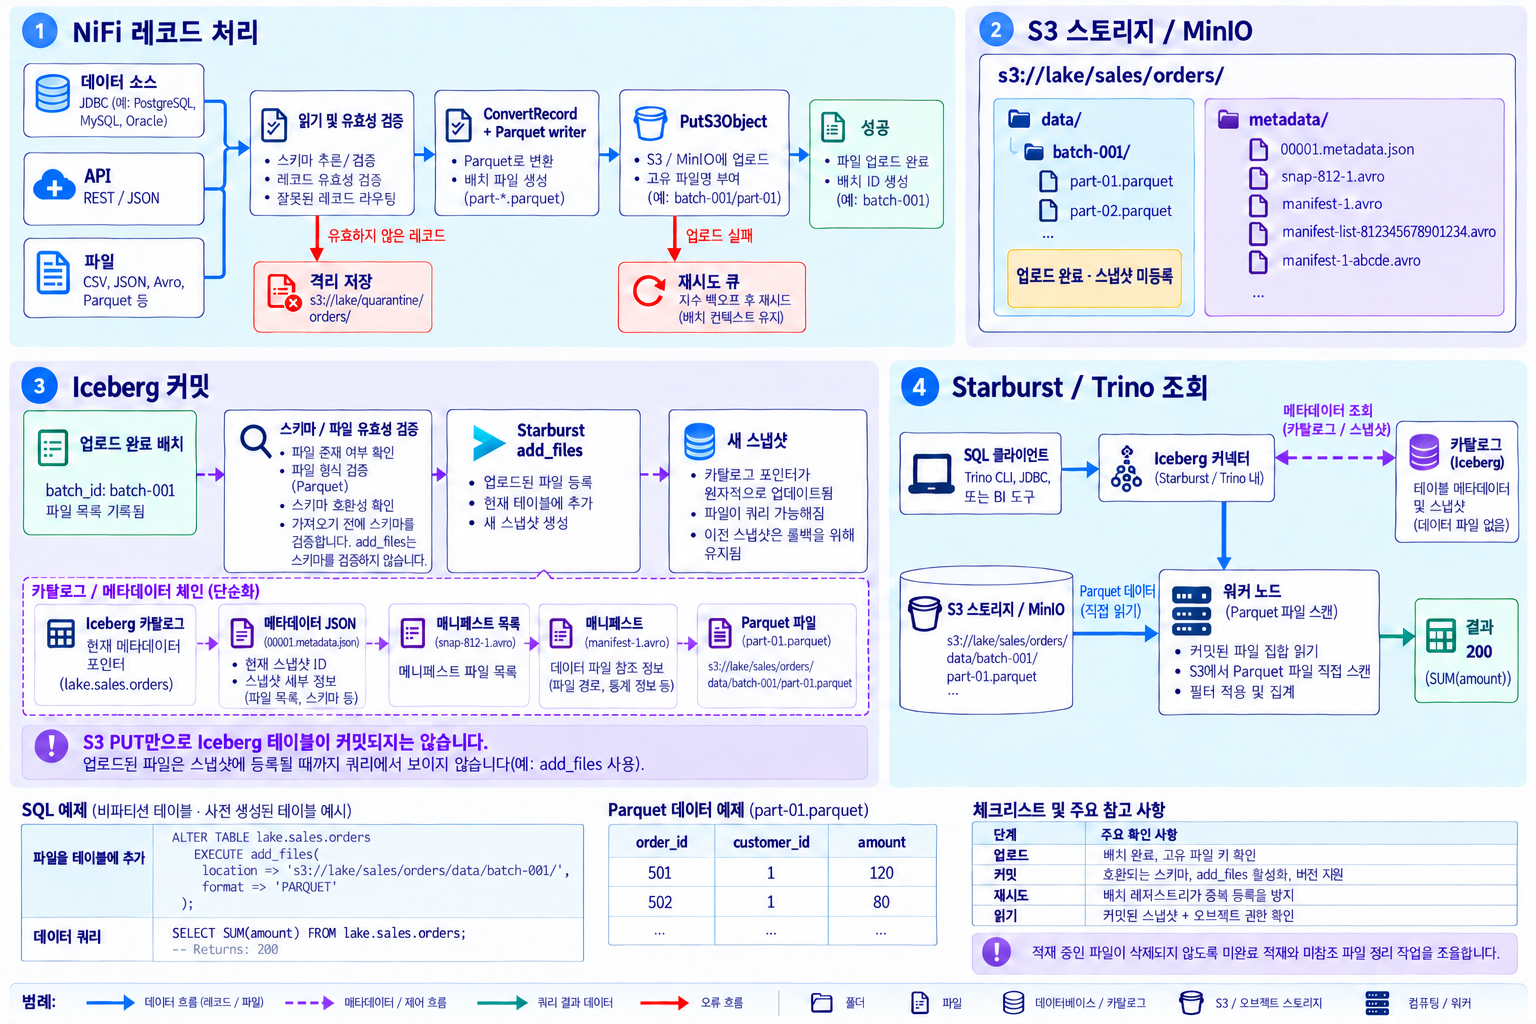
그림 설명과 제품·서비스 상세 보기
- 1.NiFi 레코드 처리
- 입력 검증과 Parquet 변환 후 PutS3Object로 배치 파일을 업로드하고 성공한 파일 목록을 기록합니다.
- 2.S3 파일 저장
- MinIO 등 S3 스토리지의 테이블 데이터 경로에 파일을 저장합니다. 업로드만으로 Iceberg 스냅샷에 포함되지는 않습니다.
- 3.Iceberg 메타데이터 커밋
- 완료된 배치의 스키마를 사전 검증한 뒤 add_files 등 지원 절차로 파일을 등록합니다. add_files 자체는 스키마 호환성을 검증하지 않습니다.
- 4.Starburst 조회
- 카탈로그에서 스냅샷을 확인하고 워커가 해당 Parquet 파일을 읽습니다. 메타데이터와 데이터의 접근 경로를 분리합니다.
미리 생성한 비파티션 테이블의 배치 적재 예시입니다. add_files 지원 버전·설정, 파일 스키마와 권한을 확인하고 중복 등록 및 적재 중 파일 정리를 방지해야 합니다.
공식 문서Oracle과 Iceberg 테이블을 하나의 SQL로 JOIN
Oracle 고객 정보와 S3의 Iceberg 주문 데이터를 읽어 Starburst 워커에서 결합·집계합니다.
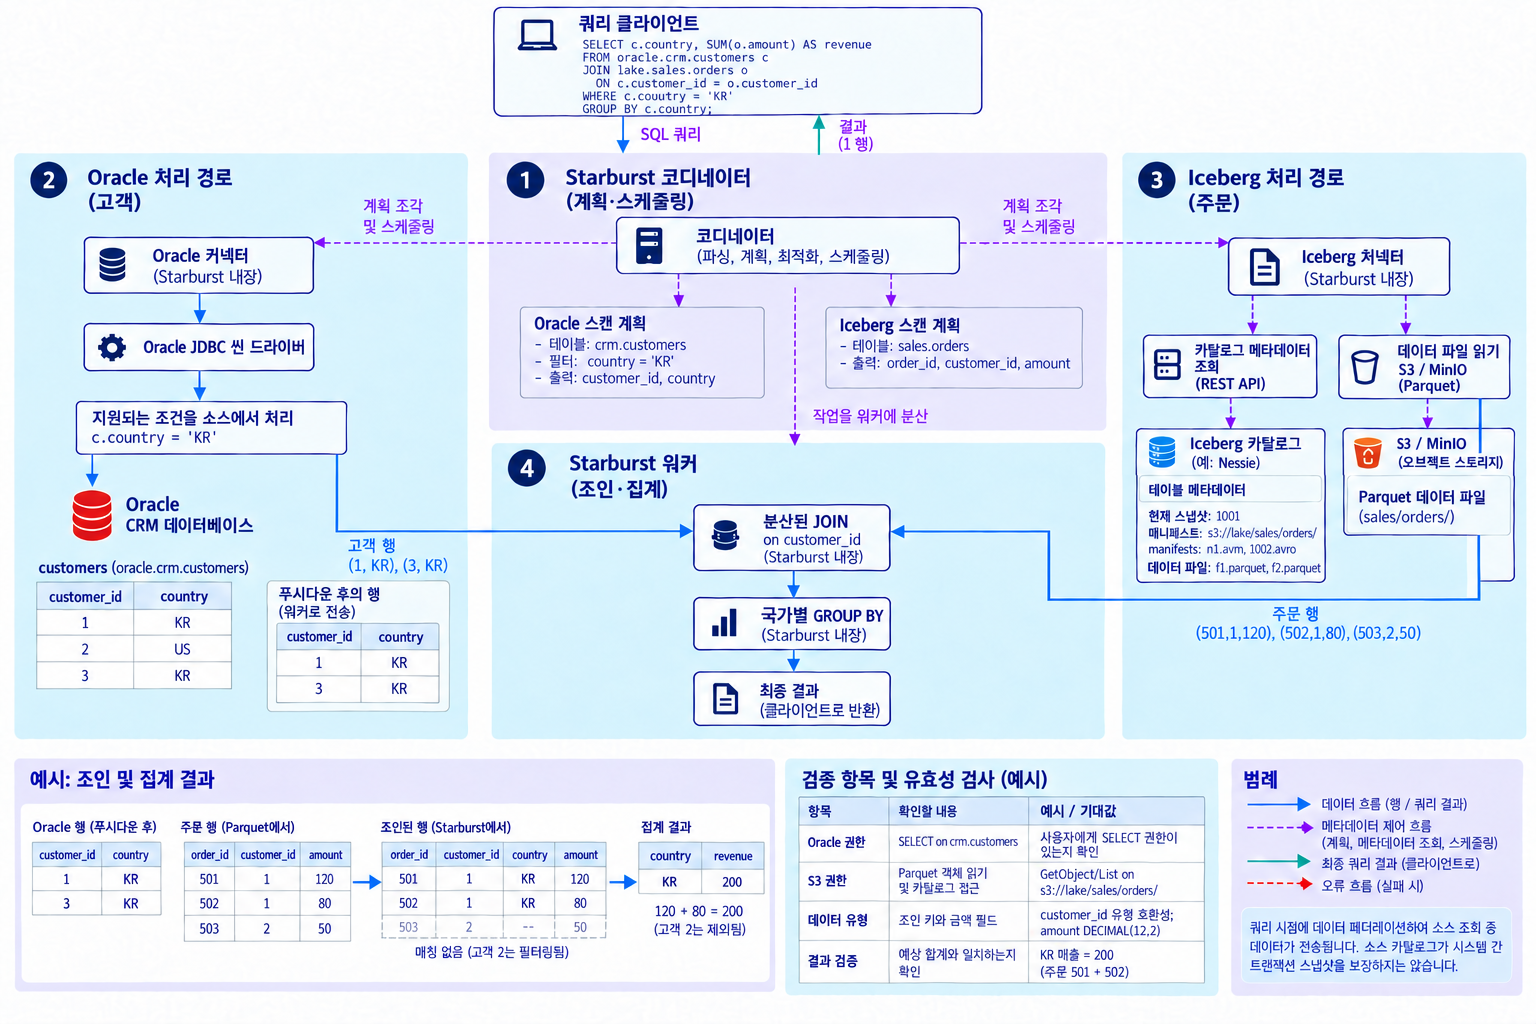
그림 설명과 제품·서비스 상세 보기
- 1.업무 SQL
- 고객 테이블과 주문 테이블을 customer_id로 결합하고 국가 조건을 적용해 매출을 집계합니다.
- 2.Oracle 읽기
- Oracle 커넥터와 Oracle JDBC Thin 드라이버로 필요한 행을 읽고 지원되는 조건을 Oracle에 전달합니다.
- 3.Iceberg 읽기
- 카탈로그의 커밋된 파일 목록과 MinIO·S3의 Parquet 데이터를 각각 조회합니다.
- 4.분산 JOIN과 집계
- 워커가 양쪽 데이터를 결합합니다. 예시의 KR 고객 주문 120과 80을 합산한 결과는 200입니다.
서로 다른 카탈로그의 JOIN은 이 그림에서 Starburst가 실행합니다. 원본 시스템 사이의 동일 시점 트랜잭션 스냅샷을 보장하지 않으며 키·타입·권한을 검증해야 합니다.
공식 문서Oracle 푸시다운과 Iceberg 스캔 최적화
Oracle에서 줄이는 행·컬럼과 Iceberg에서 제외하는 파일·컬럼을 나눠 성능 개선 지점을 설명합니다.
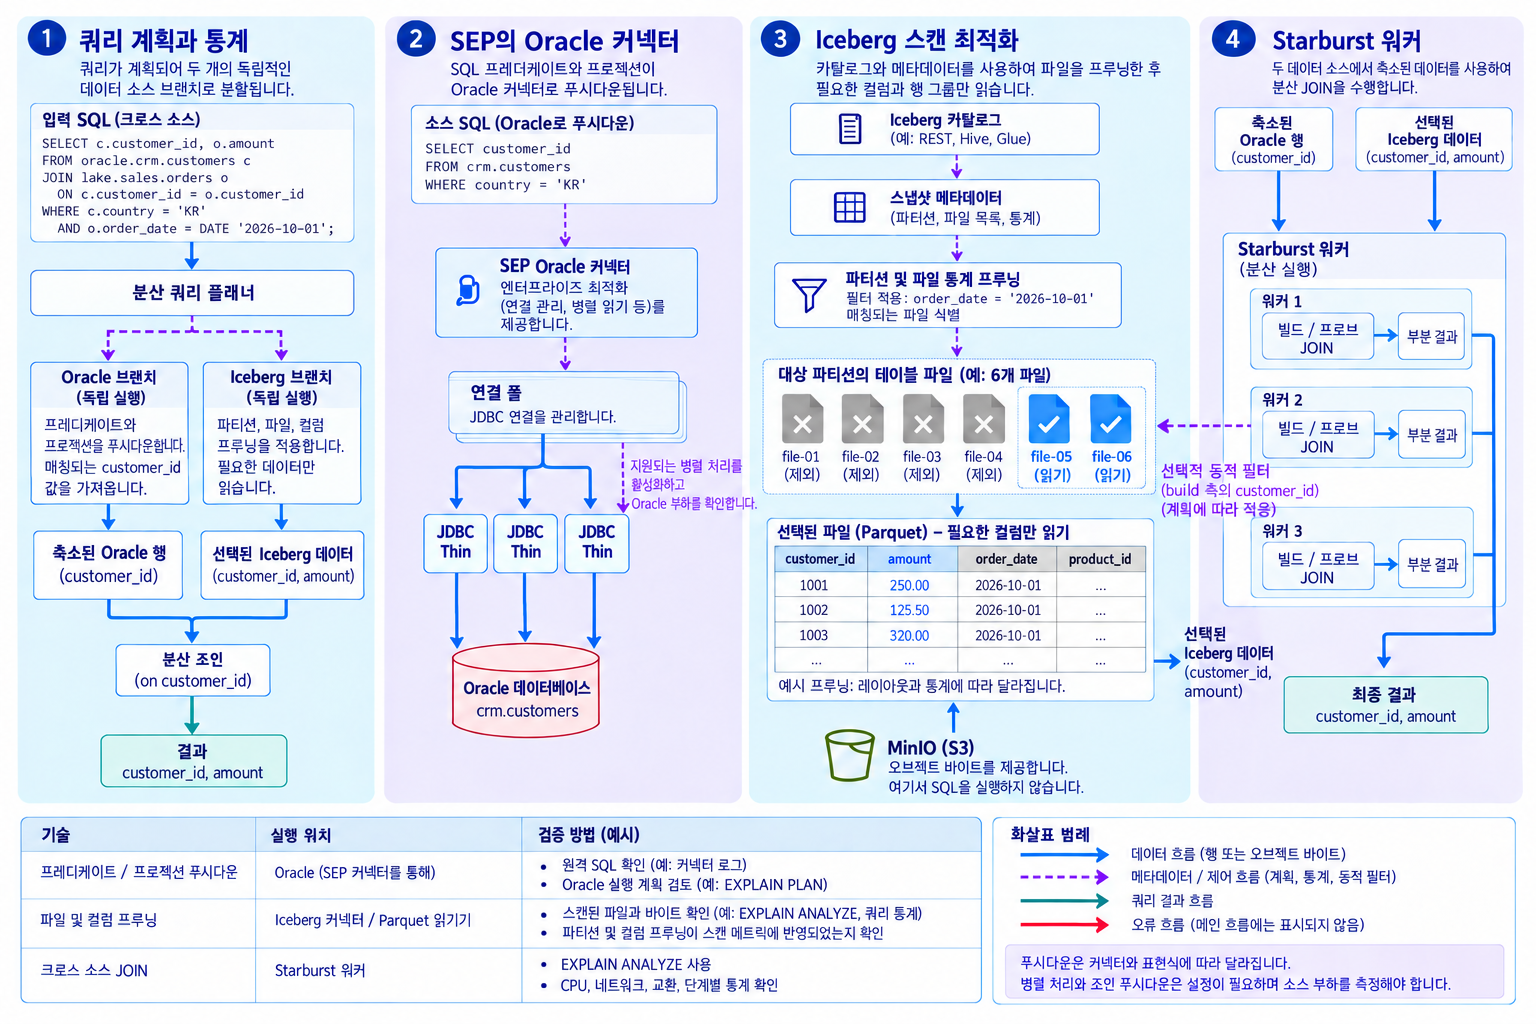
그림 설명과 제품·서비스 상세 보기
- 1.계획과 통계
- 옵티마이저가 조건과 통계를 활용해 Oracle 및 Iceberg의 독립적인 읽기 계획을 만듭니다.
- 2.Oracle 커넥터 최적화
- 지원되는 필터·컬럼 선택을 Oracle에 전달하고 연결 풀과 설정된 병렬 읽기를 활용합니다.
- 3.Iceberg 프루닝
- 파티션·파일 통계로 읽을 범위를 줄이고 Parquet 리더가 필요한 컬럼·행 그룹을 선택합니다. S3는 오브젝트 바이트를 제공합니다.
- 4.워커의 JOIN
- 줄어든 입력을 Starburst에서 결합합니다. 동적 필터링은 지원 조건과 계획에 따라 적용하며 EXPLAIN ANALYZE와 스캔량을 검증합니다.
Starburst의 Oracle 커넥터는 Oracle JDBC Thin 드라이버를 사용합니다. SEP의 커넥터 확장과 드라이버를 구분하며, 병렬 읽기·푸시다운 적용 여부와 원본 DB 부하는 실행 계획과 실측으로 확인합니다.
공식 문서Starburst AI — 기업 데이터를 AI 에이전트와 연결
데이터 페더레이션 위에 MCP, 자연어 분석, SQL AI 함수와 RAG를 연결합니다. 데이터에 접근하는 경로와 모델에 전달되는 컨텍스트를 함께 살펴보세요.
공식 문서 확인 기준: Starburst Enterprise 483-e STS · 2026-10-18. 아래 구성은 활용 예시이며, 도입 버전·라이선스·모델별 지원 범위를 확인합니다.
기업 데이터에서 AI 응답까지, 세 가지 연결 경로
AIDA, 외부 AI 에이전트, SQL 애플리케이션이 Starburst의 데이터 접근 기반을 활용합니다.
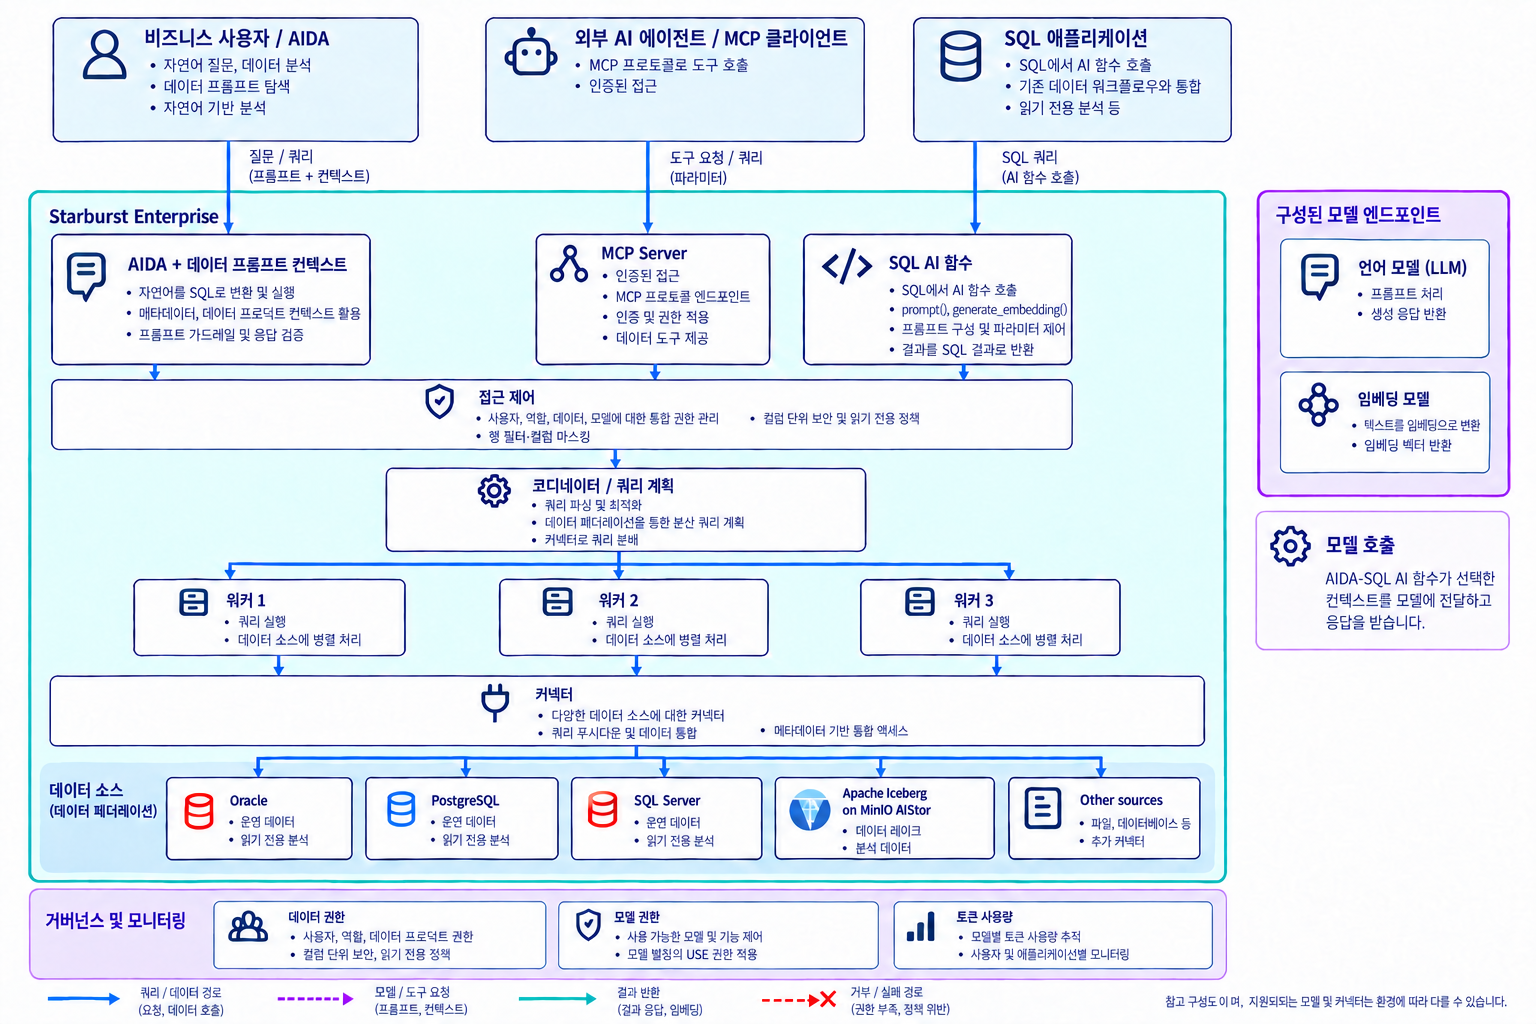
- 1.사용 방식 선택
- 업무 사용자는 AIDA, 외부 에이전트는 MCP, 개발자는 SQL AI 함수를 활용합니다. 외부 MCP 클라이언트의 모델 구성은 SEP 모델 설정과 별개입니다.
- 2.분산 데이터 조회
- Oracle·PostgreSQL·SQL Server 등 연결한 소스와 MinIO AIStor의 Iceberg 데이터를 쿼리합니다. 페더레이션은 전체 사전 적재를 줄이며 쿼리 실행 중 데이터 전송은 발생합니다.
- 3.모델과 컨텍스트 연결
- AIDA와 AI 함수가 구성한 모델 엔드포인트를 호출합니다. 질문·메타데이터·선택한 조회 결과 등 전달 범위를 확인하고 모델 접근 권한을 적용합니다.
Starburst가 모델 자체를 학습하거나 모든 모델을 내장하는 구성은 아닙니다. AWS Bedrock·OpenAI 호환 API 등 지원 연결 방식과 모델별 기능을 확인합니다.
공식 문서MCP Server로 AI 에이전트에 데이터 조회 도구 제공
외부 에이전트가 인증된 연결을 통해 데이터를 탐색하고 읽기 전용 쿼리 결과를 받습니다.
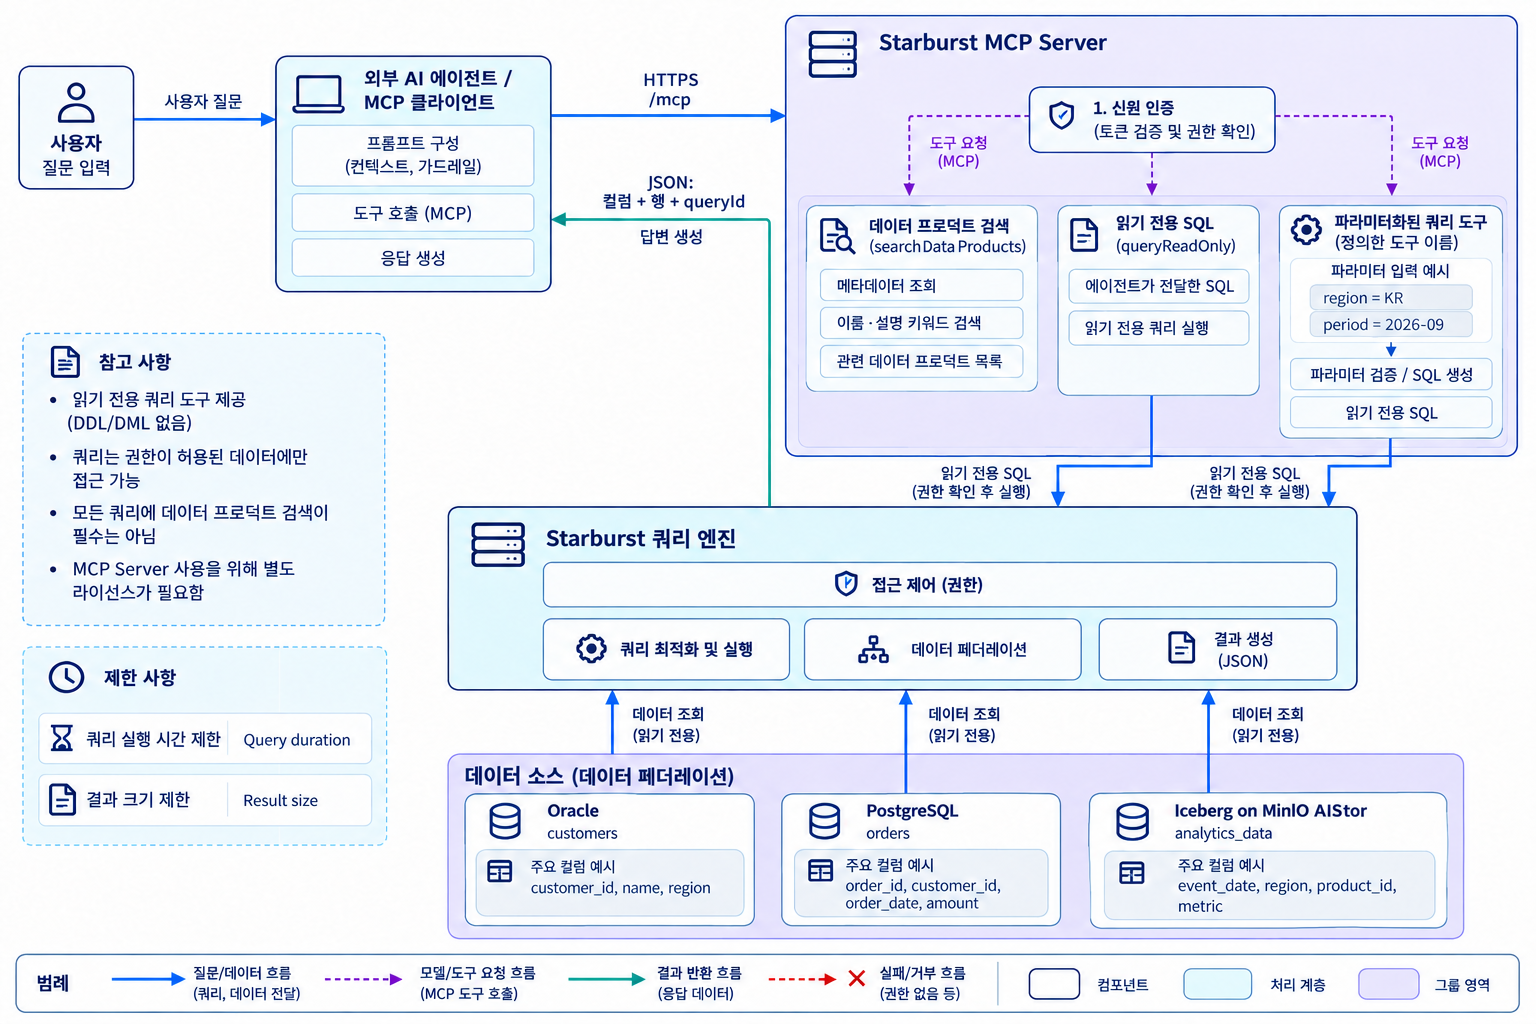
- 1.인증과 데이터 탐색
- 에이전트는 코디네이터의 HTTPS /mcp 엔드포인트에 인증합니다. 필요한 경우 searchDataProducts 등으로 데이터 프로덕트를 찾아 분석 대상을 확인합니다.
- 2.SQL 또는 파라미터 도구
- 읽기 전용 SQL을 전달하거나, 미리 정의한 도구에 지역·기간 등 값을 전달합니다. 파라미터 도구는 입력을 검증하고 최종 SQL이 읽기 전용인지 확인합니다.
- 3.권한 안에서 실행·반환
- 연결된 사용자의 권한으로 분산 쿼리를 실행하고 컬럼·행·queryId가 포함된 JSON 결과를 반환합니다. 외부 에이전트가 이 결과를 답변에 활용합니다.
MCP Server 라이선스가 필요합니다. queryReadOnly는 동기 실행이며 실행 시간·결과 크기 제한을 적용합니다. 쓰기 작업을 허용하는 범용 DB 관리 도구로 설명하지 않습니다.
공식 문서AIDA로 질문하고 SQL·표·차트로 결과 확인
데이터 프로덕트의 설명과 업무 규칙을 활용해 자연어 질문을 분석 작업으로 연결합니다.
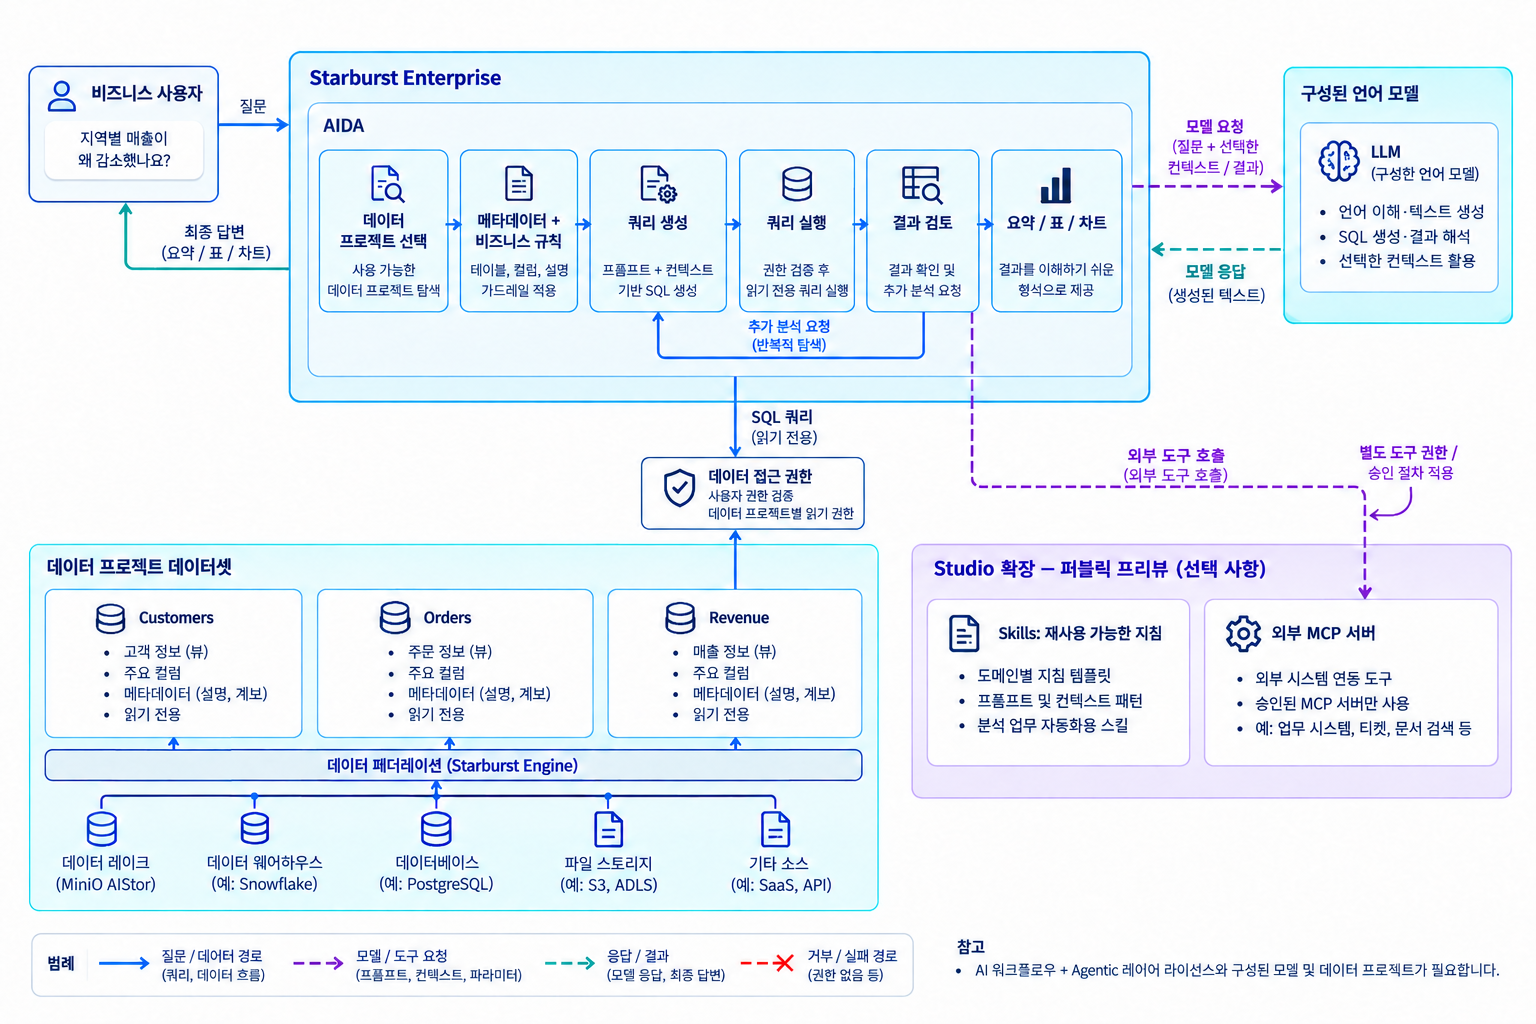
- 1.분석 컨텍스트 선택
- 언어 모델과 데이터 프로덕트를 선택하고, 지표 정의·기간 기준·업무 규칙을 확인합니다. 기본 분석 범위는 선택한 데이터 프로덕트입니다.
- 2.질문에서 실행 결과까지
- AIDA가 SQL을 생성·실행하고 필요에 따라 탐색 쿼리와 후속 분석을 수행합니다. 생성 SQL, 요약, 표 또는 차트를 확인하며 질문을 구체화합니다.
- 3.외부 도구로 확장
- 선택적으로 Skills의 업무 지침과 외부 MCP 도구를 사용합니다. 이 방향은 AIDA → 외부 서버이며, 외부 에이전트 → Starburst MCP Server 접속과 구분합니다. 도구 권한·호출 승인도 별도로 확인합니다.
AIDA에는 AI workflows와 Agentic layer 라이선스, 구성한 모델과 데이터 프로덕트가 필요합니다. Studio의 Skills·외부 MCP 서버 연결은 퍼블릭 프리뷰입니다.
공식 문서SQL AI 함수로 텍스트 처리와 RAG 구성
임베딩 생성·유사도 검색·LLM 호출을 데이터 처리 흐름에 결합합니다.
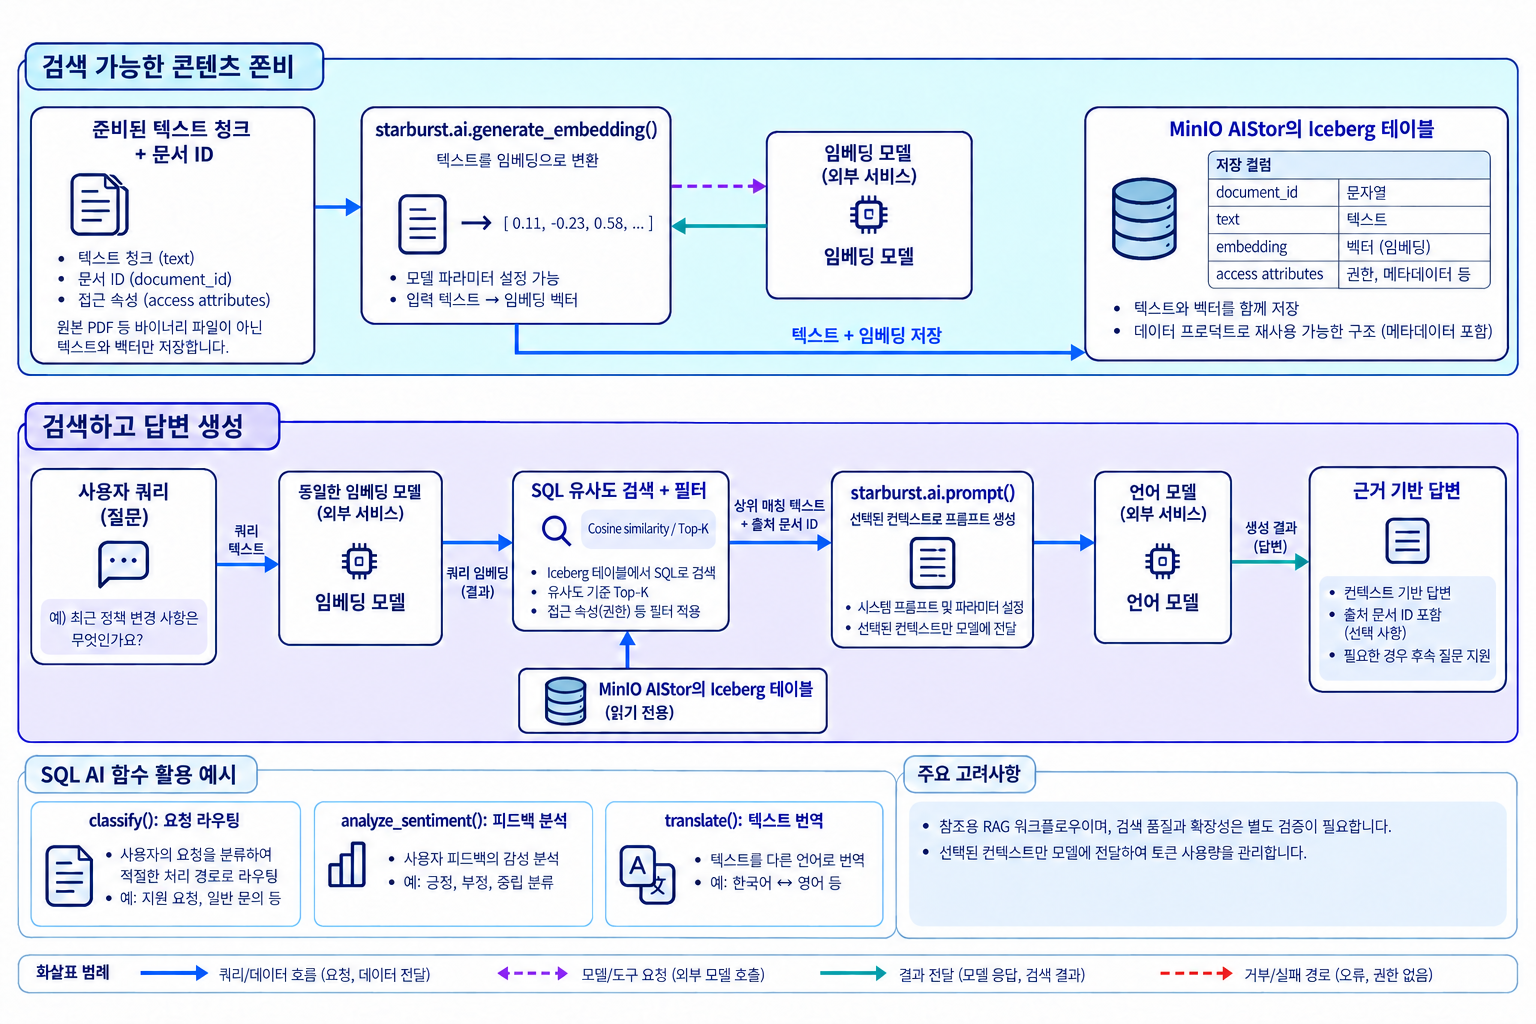
- 1.텍스트와 임베딩 준비
- 준비한 텍스트에 starburst.ai.generate_embedding()을 적용합니다. 원문 ID·텍스트·임베딩·접근 속성을 Iceberg 등 선택한 테이블에 저장합니다.
- 2.검색 결과로 답변 생성
- 같은 임베딩 모델로 질문을 변환하고 유사도 계산·필터로 관련 데이터를 찾습니다. 선택한 텍스트와 원문 ID를 starburst.ai.prompt()의 컨텍스트로 사용합니다.
- 3.업무 SQL에 AI 적용
- starburst.ai.classify(), analyze_sentiment(), translate() 등으로 문의 분류·감정 분석·번역을 수행합니다. AI 함수에는 AI workflows 라이선스, 구성한 모델과 내장 접근 제어가 필요합니다.
참조 RAG 구성입니다. PDF 파싱·청크 분할은 별도 준비 단계이며, 검색 품질·지연·스캔량과 모델 비용을 검증합니다. 전용 벡터 DB나 ANN 인덱스가 항상 불필요하다는 뜻은 아닙니다.
공식 문서AI가 이해할 수 있도록 데이터 프로덕트 설명 보강
컬럼과 데이터셋의 의미를 AI가 제안하고 담당자가 검토해 저장합니다.
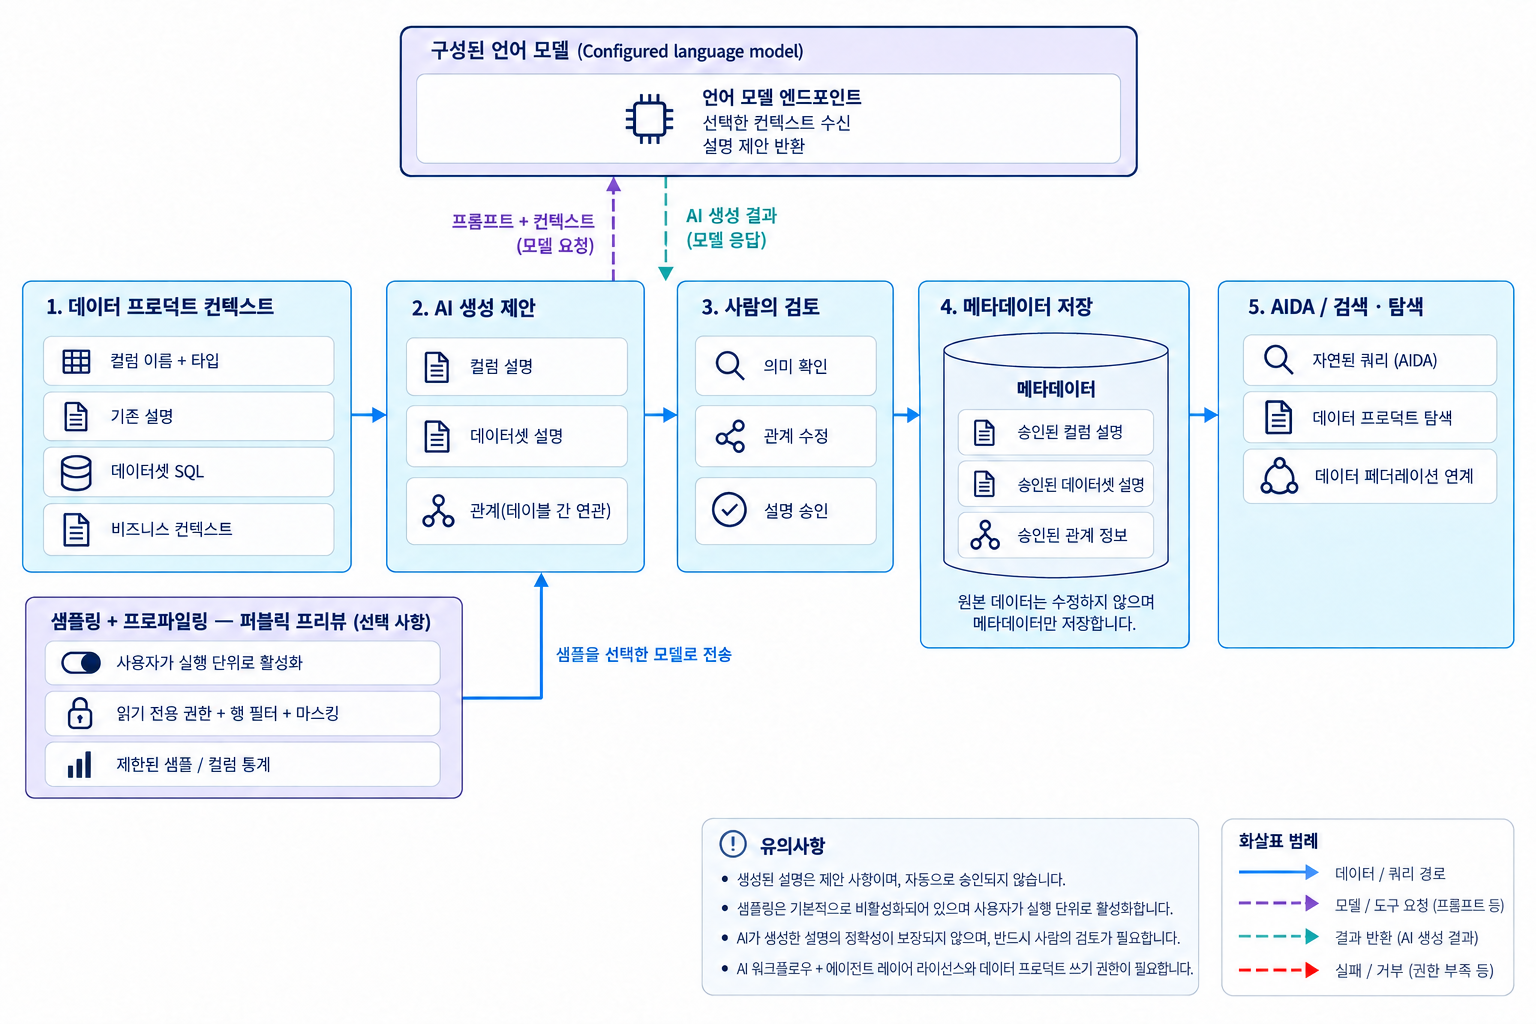
- 1.기존 정보 활용
- 컬럼명·타입·기존 설명·데이터셋 SQL·업무 문맥을 바탕으로 컬럼, 데이터셋과 데이터 프로덕트의 설명을 생성합니다.
- 2.필요할 때만 샘플링
- 사용자가 실행마다 허용하면 자신의 읽기 권한, 행 필터와 컬럼 마스킹 안에서 제한된 샘플·통계를 수집합니다. 이 정보가 선택한 모델에 전달됩니다.
- 3.사람이 검토·저장
- 추론한 컬럼 의미와 데이터 관계를 검토·수정한 뒤 저장합니다. 원본 데이터 값을 바꾸는 기능이 아니며, 정리한 설명은 AIDA 분석과 데이터 탐색에 활용합니다.
AI workflows·Agentic layer 라이선스와 데이터 프로덕트 쓰기 권한이 필요합니다. 샘플링·프로파일링은 퍼블릭 프리뷰이고 기본적으로 꺼져 있습니다.
공식 문서데이터 권한·모델 권한·AI 동작을 각각 관리
조회할 수 있는 데이터, 호출할 수 있는 모델, 에이전트의 응답 정책을 구분합니다.
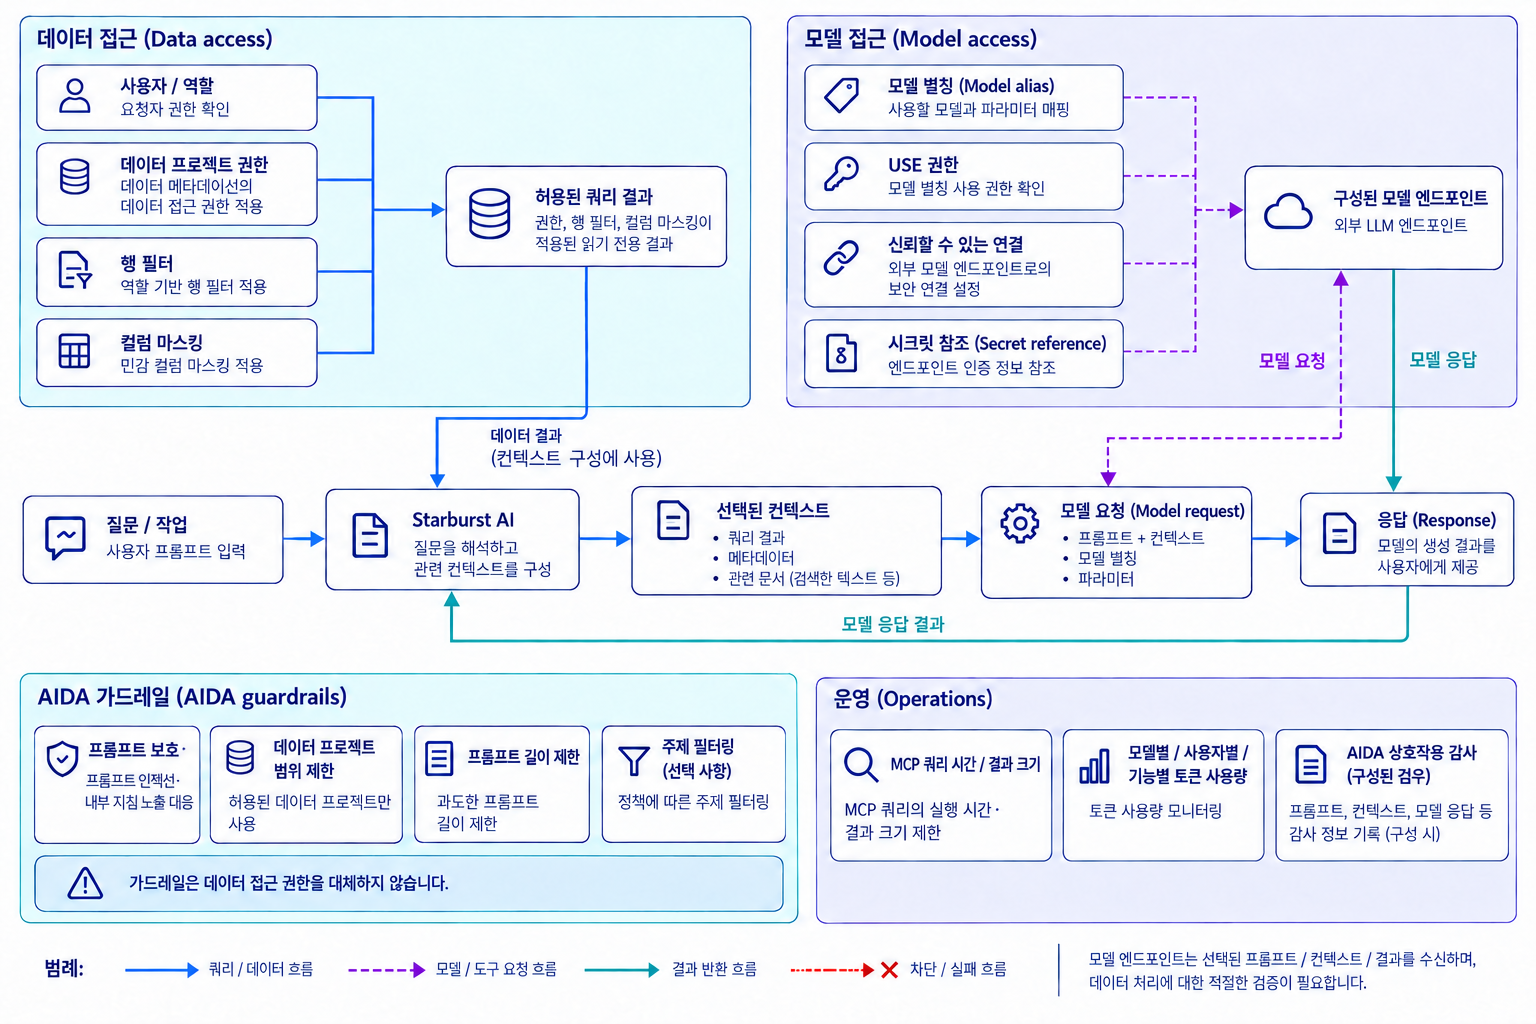
- 1.데이터·모델 접근 제어
- 데이터 권한·행 필터·컬럼 마스킹과 모델 USE 권한을 구분합니다. Trusted connection의 엔드포인트·자격 증명은 시크릿 참조로 관리합니다.
- 2.AIDA 가드레일
- 에이전트 보호, 데이터 프로덕트 범위, 입력 길이와 선택적 주제 필터를 설정합니다. 모델 지침 기반 제어를 포함하므로 데이터베이스 보안 정책과 함께 적용합니다.
- 3.사용량과 실행 확인
- 모델·기능·사용자별 토큰 사용량을 확인하고 MCP 실행 시간·결과 크기를 제한합니다. 필요한 AIDA 상호작용 감사 로그를 구성해 운영 절차에 반영합니다.
외부 모델에 전달되는 질문·컨텍스트·결과의 범위를 확인합니다. 가드레일의 모든 차단 이벤트를 통합 대시보드에서 감사할 수 있다고 보장하지 않습니다. 외부 MCP 도구의 권한은 별도로 관리합니다.
공식 문서기능별 도입 조건과 지원 범위
라이선스, 연결 설정과 퍼블릭 프리뷰 기능을 구분해 도입 범위를 정합니다.
| 기능 | 라이선스·구성 | 확인할 범위 |
|---|---|---|
| MCP Server | MCP Server 라이선스, 서버 활성화와 인증 설정 | 읽기 전용 쿼리·파라미터 도구, 실행 시간·결과 크기 제한. AI 에이전트 도구를 사용하면 해당 AI 구성 조건도 확인합니다. |
| SQL AI 함수·모델 연결 | AI workflows 라이선스, 구성한 모델, 내장 접근 제어 | 언어·임베딩 모델별 기능과 제공사 API 호환성, 모델 호출 비용·응답 품질을 확인합니다. |
| AIDA | AI workflows + Agentic layer 라이선스, 언어 모델, 데이터 프로덕트 | 선택한 데이터 프로덕트와 업무 규칙을 기반으로 분석합니다. 생성 SQL과 답변을 검증합니다. |
| 데이터 프로덕트 설명 보강 | AI workflows + Agentic layer 라이선스, 모델, 데이터 프로덕트 쓰기 권한 | 샘플링 사용 시 데이터 읽기 권한도 필요합니다. 샘플링·프로파일링은 퍼블릭 프리뷰이며 실행할 때마다 선택합니다. |
| AIDA 확장 기능 | AIDA 구성과 기능별 관리자·사용자 권한 | Skills와 외부 MCP 서버 연결은 퍼블릭 프리뷰입니다. 외부 도구 권한과 호출 승인을 별도로 구성합니다. |
| 운영 관리 | 관리자 권한과 기능별 설정 | 가드레일, 토큰 사용량, 구성한 상호작용 감사 로그를 확인합니다. 사용량 조회와 예산 강제 제한은 구분합니다. |
Data Dynamics는 대상 SEP 버전과 계약 범위를 확인한 뒤, 모델 연결·데이터 프로덕트 정비·MCP 도구 설계·권한 구성·대표 질문 검증·운영 교육을 지원합니다. 그림은 제품 UI 캡처나 성능 보장 자료가 아닙니다.
공식 문서: AI 토큰 사용량Data Dynamics가 제공하는 서비스
제품과 활용 구성을 선택하고, 요구사항 분석부터 검증·운영 인수인계까지 연결합니다.
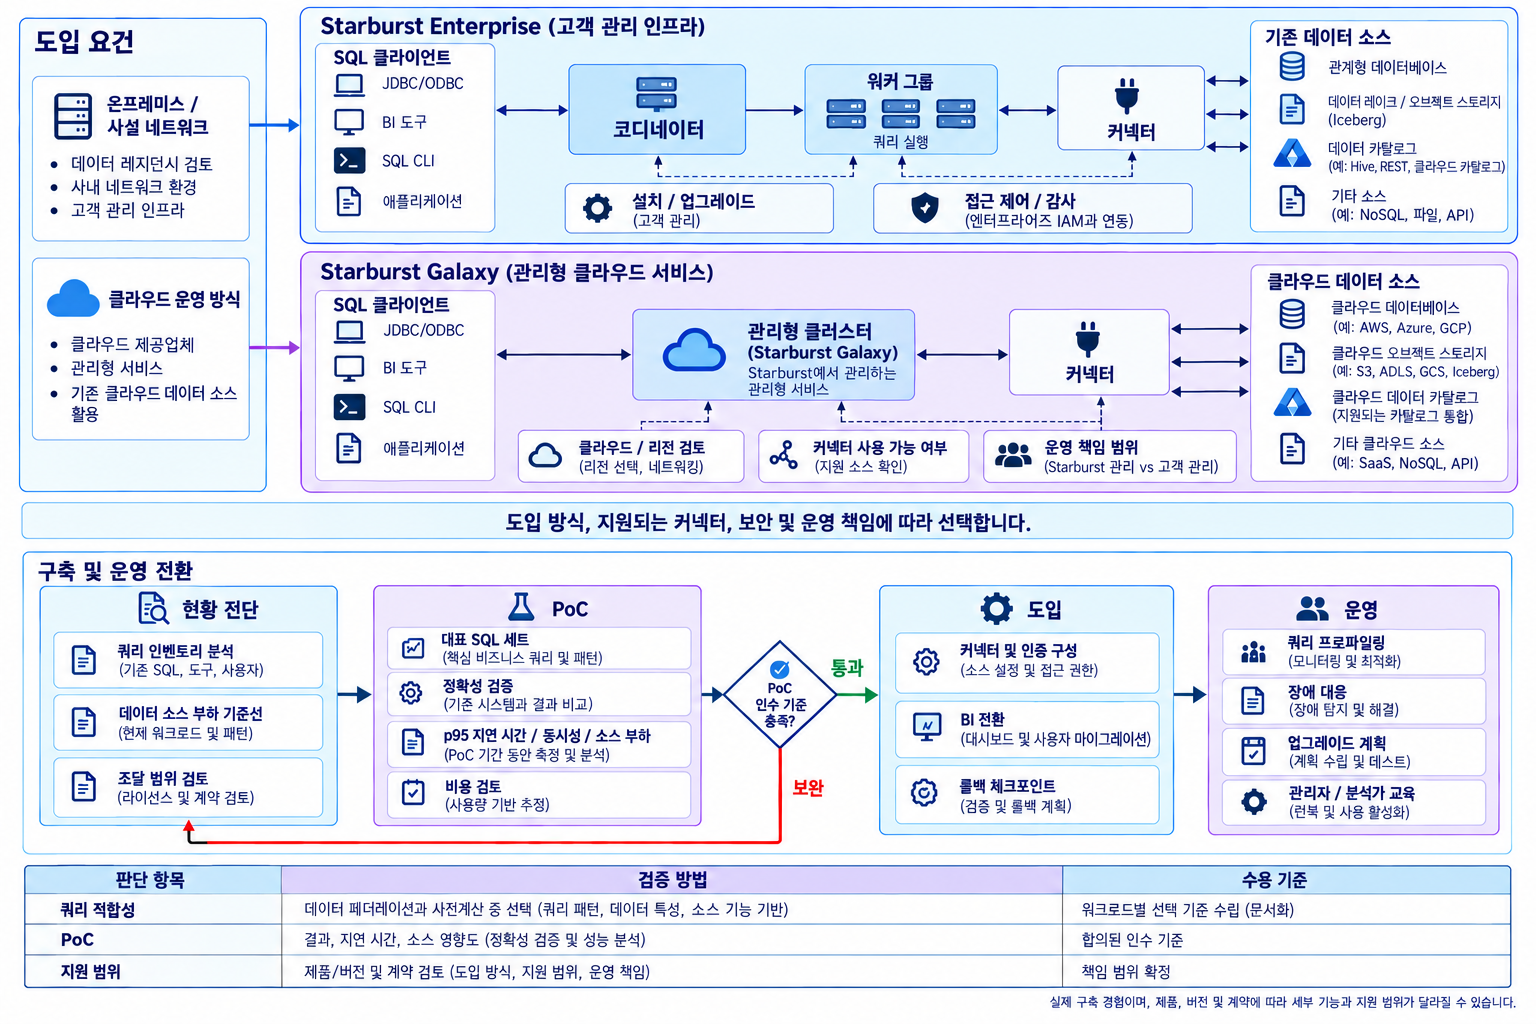
그림 설명과 제품·서비스 상세 보기
- 1.요구사항 분석
- 기존 시스템과 데이터, 워크로드, 운영 제약을 조사해 도입 범위를 정합니다.
- 2.제품과 구성 선택
- 활용 목적에 맞는 제품, 배포 방식, 용량, 접근 권한과 계약 범위를 검토합니다.
- 3.검증과 전환
- 대표 워크로드로 정합성·성능·연동을 확인하고 승인 기준과 복구 절차를 검토합니다.
- 4.운영과 교육
- 모니터링, 운영 절차서, 업그레이드 계획과 담당자 교육으로 인수인계를 준비합니다.
Starburst 제품군
- Starburst Enterprise
고객 인프라(On-prem·Private VPC)에 직접 배포하는 자가관리형 상용 Trino 배포판. 데이터 통제권을 유지하면서 엔터프라이즈 보안·운영 기능을 활용할 수 있어, 데이터 그래비티·망분리·데이터 레지던시 요건에 적합합니다.
Self-managed · K8s · OpenShift · Ansible · LTS / STS · 데이터 주권 · 망분리
- Starburst Galaxy
AWS·Azure·GCP에서 동작하는 완전 관리형 SaaS. 클러스터 자동 스케일링과 페이-퍼-쿼리, 크로스클라우드 페더레이션을 제공하여 운영 부담 없이 즉시 분석을 시작할 수 있습니다.
Fully Managed · Auto-scaling · Multi-cloud · Pay-per-query
온프레미스·프라이빗 환경 중심의 국내 엔터프라이즈(특히 규제 산업)에는 SEP가, 클라우드 퍼스트 조직에는 Galaxy가 일반적인 출발점입니다.
도입 전에 함께 확인할 사항
기능 목록을 넘어 실제 데이터·운영 조건으로 도입 범위를 정합니다.
- 조회 방식
페더레이션으로 조회할 데이터와 사전 가공·적재할 데이터를 구분합니다.
- PoC 검증
쿼리 응답 시간, 동시성, 결과 정확성, 원천 DB 부하와 실행 비용을 측정합니다.
- 배포·지원 범위
Enterprise·Galaxy의 커넥터, 기능, 운영 책임과 계약별 지원 조건을 확인합니다.
Data Dynamics가 제공하는 서비스
- 라이선스 판매
Starburst Enterprise·Galaxy 라이선스 견적 및 발주를 지원합니다.
- 용량·노드 기반 산정
- PoC 라이선스 지원
- 갱신·확장 컨설팅
- 기술지원
구축부터 운영까지 Starburst 전반에 대한 기술지원을 제공합니다.
- 설치·업그레이드 지원
- 쿼리 성능 튜닝
- 장애 대응·에스컬레이션
- 교육·PoC
Trino·Starburst 기술 교육 및 맞춤 PoC를 수행합니다.
- 관리자 과정
- 데이터 분석가 교육
- 맞춤 PoC 설계·수행
Trino·Iceberg·오브젝트 스토리지 기반 레이크하우스 구축과 Hive/Impala 마이그레이션 실무 경험을 보유하고 있으며, 관련 기술 자료를 블로그에 지속 공개하고 있습니다.
도입 절차의 예시입니다. 제품·버전별 지원 범위, 검증 기준과 제공 서비스는 고객 환경 및 계약에 맞춰 확정합니다.
Starburst 기능 비교·성능·도입 사례 더 보기
Trino와 Starburst Enterprise의 관계
Starburst Enterprise는 Trino를 기반으로 엔터프라이즈 기능과 지원을 제공하는 상용 배포판입니다.
Trino
오픈소스 분산 MPP SQL 엔진(이전 PrestoSQL). 상시 코디네이터+워커 구조로 페타바이트급 데이터에 대화형 응답을 제공하며, 약 2주마다 새 버전을 릴리스합니다.
Starburst
Trino 창시자들이 설립한 회사로, 2024년 Trino 코드 커밋의 약 84%를 기여한 최대 Trino 전문가 조직입니다.
Trino 기반 엔진
업스트림 Trino 기반에 제품별 기능·패치·최적화가 더해집니다. 버전과 설정에 따른 동작·성능 차이를 검증해야 합니다.
확장되는 기능 범위
그 위에 보안(BIAC·Ranger), 전용 커넥터, Warp Speed 가속, 관리 UI·Insights, 지원되는 배포 경로, 24×7 지원 계약이 얹힙니다.
SEP = Trino 엔진 + 엔터프라이즈 레이어
Trino 기반이라는 공통점이 모든 버전·설정에서 동일한 기능이나 성능을 보장하지는 않습니다.
Why Starburst — 4가지 핵심 가치
데이터 페더레이션
데이터를 이동·복제하지 않고 여러 소스를 단일 SQL로 JOIN합니다. ETL로 미리 옮겨 모으는 구조 자체가 필요 없어집니다.
Iceberg 네이티브
히든 파티셔닝·파티션 진화·시간 여행(time travel)·ACID를 완전 지원하고, 컴팩션·스냅샷 만료 등 테이블 유지관리를 자동화합니다.
성능 가속·안정성
Warp Speed 스마트 인덱싱·캐싱으로 쿼리 최대 5배·CPU 10배 개선, 내결함성 실행(FTE)은 최대 60TB 배치까지 하드닝되어 있습니다.
세밀한 보안 정책
행/열 단위 RBAC·ABAC, 동적 컬럼 마스킹, Apache Ranger 통합, 쿼리 감사까지 — 규제 산업 요건을 플랫폼에서 충족합니다.
커넥터 — 엔터프라이즈 데이터의 롱테일까지
일반적인 엔터프라이즈의 데이터는 Oracle·Teradata·SAP·Salesforce 같은 곳에 살아 있습니다. SEP 전용 커넥터가 라이선스 가치의 상당 부분을 차지하는 이유입니다.
SEP 전용 커넥터 (업스트림 Trino에 없음)
Snowflake · Teradata · IBM Db2 · SAP HANA · Salesforce · Azure Synapse · Greenplum · Netezza · Cosmos DB · DynamoDB · Splunk · Neo4j · Generic JDBC · Stargate(클러스터 간 페더레이션)
업스트림 커넥터의 개선판
푸시다운 강화·Warp Speed 통합·추가 인증 — Hive · Iceberg · Delta Lake · Oracle · BigQuery · SQL Server · PostgreSQL · MySQL · MongoDB · Kafka · Elasticsearch · Redshift · ClickHouse 외
업스트림 Trino와 동일
DuckDB · Druid · Pinot · Prometheus · Redis · OpenSearch · Google Sheets 등 커뮤니티 커넥터 전체
판단 기준: "S3 + PostgreSQL 위의 Trino"만으로 요건이 커버되면 OSS로 충분합니다. 아키텍처에 Snowflake·Oracle·Teradata·SAP·Salesforce가 등장하는 순간 저울은 SEP로 기웁니다.
Apache Iceberg 레이크하우스 — 파티션의 벽을 넘고, 운영까지 자동화
Iceberg는 오브젝트 스토리지 위의 파일 더미를 데이터베이스 테이블처럼 다루게 하는 개방형 테이블 포맷입니다. 히든 파티셔닝·파티션 진화는 Trino + Iceberg의 공통 이점이고, SEP는 그 이후 남는 운영 숙제(작은 파일(small files)·스냅샷·통계)를 자동화합니다.
Trino + Iceberg 공통 이점
- 히든 파티셔닝 — 파티션을 디렉터리가 아닌 컬럼 transform(day·bucket·truncate)으로 정의 — 원본 컬럼 필터만으로 자동 프루닝되어 무심코 전체 스캔이 사라집니다.
- 파티션 진화 — 데이터 재작성 없이 파티션 전략 변경 — 구·신 스펙이 혼재해도 한 쿼리가 투명하게 처리합니다.
- ACID · 시간 여행 — 스냅샷 기반 트랜잭션, 시점 조회(FOR VERSION/TIMESTAMP AS OF), 스키마 진화, 잘못된 쓰기는 스냅샷 롤백으로 복구합니다.
- 매니페스트 프루닝 — 파일 단위 min/max 통계로 프루닝 — RDBMS 메타데이터 병목 없이 수백만 파일로 확장합니다.
SEP가 더하는 것 — 자동 테이블 유지관리
- 자동 컴팩션 — optimize(작은 파일 병합)를 스케줄 기반으로 자동 실행합니다.
- 스냅샷 · 고아 파일 정리 — expire_snapshots · remove_orphan_files 자동화로 메타데이터 비대화를 방지합니다.
- 통계 자동 수집 — CBO가 사용하는 테이블 통계를 최신으로 유지합니다.
- 스트리밍 인제스트 · 파일 로더 — Kafka 등에서 Iceberg 테이블로의 연속 적재를 관리형으로 제공 — 별도 Spark/Flink 파이프라인이 필요 없습니다.
OSS Trino에서도 같은 명령을 수동/스케줄로 실행할 수 있지만, 운영 책임은 플랫폼 팀의 몫입니다. SEP는 이를 관리형·자동화로 제공하며, MinIO 등 S3 호환 오브젝트 스토리지와 결합하면 온프레미스 레이크하우스가 완성됩니다.
성능 — Warp Speed와 벤치마크
캐싱·인덱싱과 데이터 배치 등 최적화 효과를 워크로드별로 평가합니다. 아래 수치는 특정 벤치마크 조건의 결과입니다.
쿼리 실행 시간 단축 — Warp Speed (TPC-DS SF1000)
CPU 시간 절감 — Warp Speed
Hive 대비 쿼리 성능 (TPC-DS · Iceberg)
클라우드 DW 대비 비용 효율
Warp Speed 효과 — 표준 실행 대비
표준 실행 = 100 기준, 낮을수록 좋음 (TPC-DS SF1000 · Iceberg)
표준 실행을 100으로 정규화한 벤치마크 예시입니다. 제품·버전·구성과 워크로드가 달라지면 결과도 달라집니다.
Hive 대비 쿼리 실행 시간
초, 낮을수록 좋음 — 1TB 원본(S3·Parquet), Starburst 476-e vs Hive 3.1.3
출처: Concurrency Labs 벤치마크 리포트 (2025-09) · TPC-H 9노드 / TPC-DS 17노드 (각 32 vCPU·128GB)
Warp Speed 스마트 인덱싱·캐싱
블록 단위 최적 인덱스(bitmap·dictionary·tree)를 자동 선택하고 자주 접근하는 데이터를 워커의 NVMe SSD에 캐싱 — 수동 인덱스 설계 없이 반복적이고 필터로 대상 범위를 좁히는 워크로드를 가속합니다.
Hive 대비 최대 22배
TPC-DS·Iceberg 기준 37,901초 → 1,737초(10.5시간 → 29분). 엔진만 바꿔도 6~8배, Iceberg 이관까지 하면 12~22배 — 빅뱅 없이 단계적으로 이득을 키울 수 있습니다.
클라우드 DW 대비 가격·성능
오픈 테이블 포맷 위 SQL 실행 기준 최대 6.3배 빠른 쿼리와 최대 12.7배 비용 절감 — Runtime과 Cost가 모두 최하위권인 것은 Starburst뿐입니다.
내결함성 실행 (FTE)
장시간 배치·ETL 쿼리가 통째로 실패하지 않도록 자동 복구 — 최대 60TB 규모까지 엔터프라이즈급으로 검증되어 있습니다.
성능 수치는 Starburst 공개 벤치마크 기준이며 워크로드에 따라 달라집니다 — 도입 전 PoC 검증을 권장합니다.
보안과 접근 제어 — 규제 산업의 기본기
인증은 OSS Trino도 충분합니다. 갈리는 곳은 세밀한 인가(Authorization)와 감사 — 금융·의료·공공에서 SEP가 결정적인 이유입니다.
Built-in Access Control (BIAC)
SEP 네이티브 인가 모델 — 카탈로그/스키마/테이블/컬럼/로우 단위 역할 기반(RBAC)·속성 기반(ABAC) 권한을 UI로 관리합니다.
컬럼 마스킹 · 로우 필터링
민감 컬럼 동적 마스킹과 행 단위 필터를 기본 제공 — 개인정보·거래정보 보호 요건을 충족합니다.
Apache Ranger 통합
글로벌/카탈로그/컬럼/로우 레벨 — 기존 Hive/HDFS에서 쓰던 Ranger 정책을 그대로 공유합니다.
Credential Passthrough
Kerberos·비밀번호 자격 증명 전달(캐싱 포함) — 워커가 장기간 유지되는 서비스 계정 없이 사용자 신원으로 소스에 접근합니다.
인증 통합
LDAP · OAuth2 · JWT · Kerberos에 더해 Okta 통합, 사용자 임퍼소네이션을 일반화합니다.
Query Audit
누가, 언제, 어떤 카탈로그에, 어떤 쿼리를 실행했는지 영속 기록 — 감사 추적 요건에 즉시 대응합니다.
실무 효과: 정책이 한 곳(BIAC 또는 Ranger)에 모이고, SEP가 노출하는 모든 커넥터에 균일하게 적용됩니다.
거버넌스 · 운영 — 규모 있게 돌려본 뒤에 보이는 가치
순수 쿼리 엔진(Trino)과 데이터 플랫폼(SEP)의 차이가 가장 크게 드러나는 영역 — OSS에서는 전부 별도 도구를 붙여 직접 구축해야 하는 항목입니다.
Data Products
오너·문서·SLO·액세스 정책이 부여된 큐레이션 데이터셋을 게시 — 데이터 메시 아키텍처의 셀프서비스 마켓플레이스입니다.
Starburst Insights
쿼리 패턴·자원 사용량·슬로우 쿼리 분석 대시보드와 데이터 리니지·Apache Atlas 통합 — "클러스터가 어제 새벽 3시에 뭘 했는가"에 답합니다.
HA · 오토스케일링
코디네이터 고가용성, 진행 중인 쿼리를 죽이지 않는 Graceful Scaledown, 자동 일시중지·유휴 종료·클러스터 스케줄링으로 비용을 자동화합니다.
품질 · 자동 분류
데이터 품질 규칙, 스키마 변경 알림, 자동 데이터 분류(민감정보 탐지), 소스 전반 통합 검색을 제공합니다.
Stargate
클러스터 간 페더레이션 — 데이터를 복제하지 않고 리전·테넌트·국경을 넘어 쿼리를 라우팅해 GDPR 등 데이터 주권 요건을 준수합니다.
지원되는 배포 경로
Kubernetes Helm 차트 · Red Hat OpenShift · Starburst Admin(Ansible) · AWS/Azure/GCP Marketplace, CloudWatch·Stackdriver 옵저버빌리티 도구 연동.
OSS는 JMX·로그·기본 UI까지 — 그 위의 쿼리 이력 저장소, 쿼리를 존중하는 오토스케일러, 메트릭 파이프라인은 직접 만들어야 합니다. 엔지니어링 시간을 비용으로 환산하면 "직접 만들기"가 우세한 경우는 드뭅니다.
OSS Trino vs Starburst Enterprise
엔진의 최신성·개방성·비용은 OSS Trino, 보안·거버넌스·성능 가속·운영·지원 SLA는 SEP 우위 — 규제 산업과 엔터프라이즈 규모일수록 SEP가 유리합니다.
| 카테고리 | OSS Trino | Starburst Enterprise (SEP) | 판정 |
|---|---|---|---|
| 핵심 쿼리 엔진 | 완전한 Trino 엔진 — 최신 기능 우선 반영 | Trino 기반 배포판 + 제품별 기능·패치·최적화 | 공통 |
| 보안 · 인가 | 파일/OPA 수동 구성, RBAC UI 없음 | BIAC(행/열 RBAC·ABAC) · 마스킹 · Ranger · 감사 UI | SEP 우위 |
| 거버넌스 · 카탈로그 | 외부 도구 의존(OpenMetadata 등) | Data Products · 리니지 · 품질 규칙 · 탐색 포털 | SEP 우위 |
| 성능 가속 | CBO · dynamic filtering | + Warp Speed(자동 인덱싱·캐싱) · 워크로드 관리 | SEP 우위 |
| 테이블 유지관리 | optimize 등 직접 스케줄링 | 컴팩션 · 스냅샷 만료 · 통계 수집 자동화 | SEP 우위 |
| 커넥터 | 50+ 커뮤니티 커넥터(품질 편차) | 인증 커넥터 + 전용(Snowflake·SAP·Salesforce 등) | SEP 우위 |
| 배포 · 운영 | Helm 자체 관리 | HA/DR · 오토스케일 · OpenShift · Marketplace | SEP 우위 |
| 지원 | 커뮤니티 Slack · GitHub | 24×7 · 30분 SLA · 전담 TAM · LTS 12개월 패치 | SEP 우위 |
| 비용 · 라이선스 | Apache 2.0 무료 — 벤더 종속 없음 | 상용 구독(노드/컴퓨트 기반) | OSS 우위 |
"S3 + PostgreSQL 위의 Trino"만으로 요건이 커버되면 OSS로 충분합니다 — 보안·거버넌스·지원 SLA 요건이 등장하는 순간 SEP를 검토하십시오.
버전 정책 — LTS / STS
Trino는 약 2주마다 릴리스됩니다. SEP는 그 위에 예측 가능한 릴리스 주기와 LTS 패치 수명 주기를 얹어, 엔터프라이즈가 따라갈 수 있는 속도로 바꿉니다. 버전 앞의 정수는 언제나 업스트림 Trino 버전 — 패치 접미사(-e.x)가 있으면 LTS, 없으면 STS입니다.
| 항목 | LTS | STS |
|---|---|---|
| 지원 기간 | 릴리스로부터 12개월 | 다음 STS까지 |
| 패치 릴리스 | 제공 (-e.0 → -e.1 → …) | 없음 (다음 릴리스에 반영) |
| 릴리스 주기 | 분기당 최대 1개 (2·5·8·11월) | Trino를 따라감 (빈번) |
| 보안(CVE) 수정 | 패치로 백포트 | 다음 STS에서만 |
| 운영 적합도 | 운영 환경의 기본값 | 기능 주도 · 업스트림 근접 |
권장 플레이북
1년에 한 번 LTS → 다음 LTS로 통제된 업그레이드 — 남은 지원 기간 9~12개월인 라인을 타깃으로, breaking changes를 라인 단위로 처리합니다.
EOL은 하드 데드라인
지원 종료 후에는 CVE 패치가 제공되지 않습니다 — 어느 시점이든 약 4개의 LTS 라인이 겹쳐 지원되어 업그레이드 준비 기간이 확보됩니다.
글로벌 도입 사례 — 금융권을 중심으로
Hive/Hadoop·Teradata·DB2 등 레거시에서 Trino 기반 Starburst로 전환·페더레이션한 실제 사례입니다.
HDFC Bank
인도 최대 민간은행 — 레거시 DB2에서 개방형 아키텍처로 전환, Azure AKS·온프레미스 OpenShift 병행 운영.
클라우드·온프레 통합 거버넌스 · DB2 비용 절감
Crédit Mutuel Arkéa
프랑스 — 온프레미스를 유지한 채 Hadoop 위에 페더레이션 쿼리 엔진 구축.
Hadoop 쿼리 10~20배 향상 · 1년 내 550+ 사용자
Bank Hapoalim
이스라엘 — 20년 운영한 Teradata를 데이터레이크로 전환, Hive·Spark 벤치마크 후 Starburst 채택.
고동시성 ad-hoc + BI 쿼리 성능 최우수
Banco Inter
브라질 — Amazon Athena에서 Starburst로 전환, 탐색·거버넌스·셀프서비스 분석을 단일 플랫폼화.
인사이트 도출 days → seconds · 월 $100K 절감
글로벌 투자은행
Hive를 Starburst로 대체해 100+개국 데이터에 원위치 쿼리를 수행하는 AML 분석 사례입니다. 원본의 중앙 적재를 줄이되 쿼리 처리 중 데이터 전송은 발생합니다.
데이터 주권 준수 · 규제 과징금 리스크 감소
글로벌 은행그룹 (62개국)
Stargate를 활용한 국경 간 분석 사례입니다. 원본 저장 위치를 유지하면서 지역별 처리와 결과 전송 범위를 설계합니다.
쿼리 성능 20배 향상 · 데이터 주권 준수