
构建湖仓
采集数据库、文件与 API 数据,通过 Iceberg 表管理历史并支持数据复用。
从数据采集与存储到分布式数据的统一分析。将 Argus Flow、Apache Airflow 3、Starburst Enterprise 和MinIO AIStor 作为统一的部署与运维方案交付。
结合对象存储的扩展能力与分析表的管理功能。分离存储与计算,并使用Apache Iceberg管理模式、快照和数据变更。
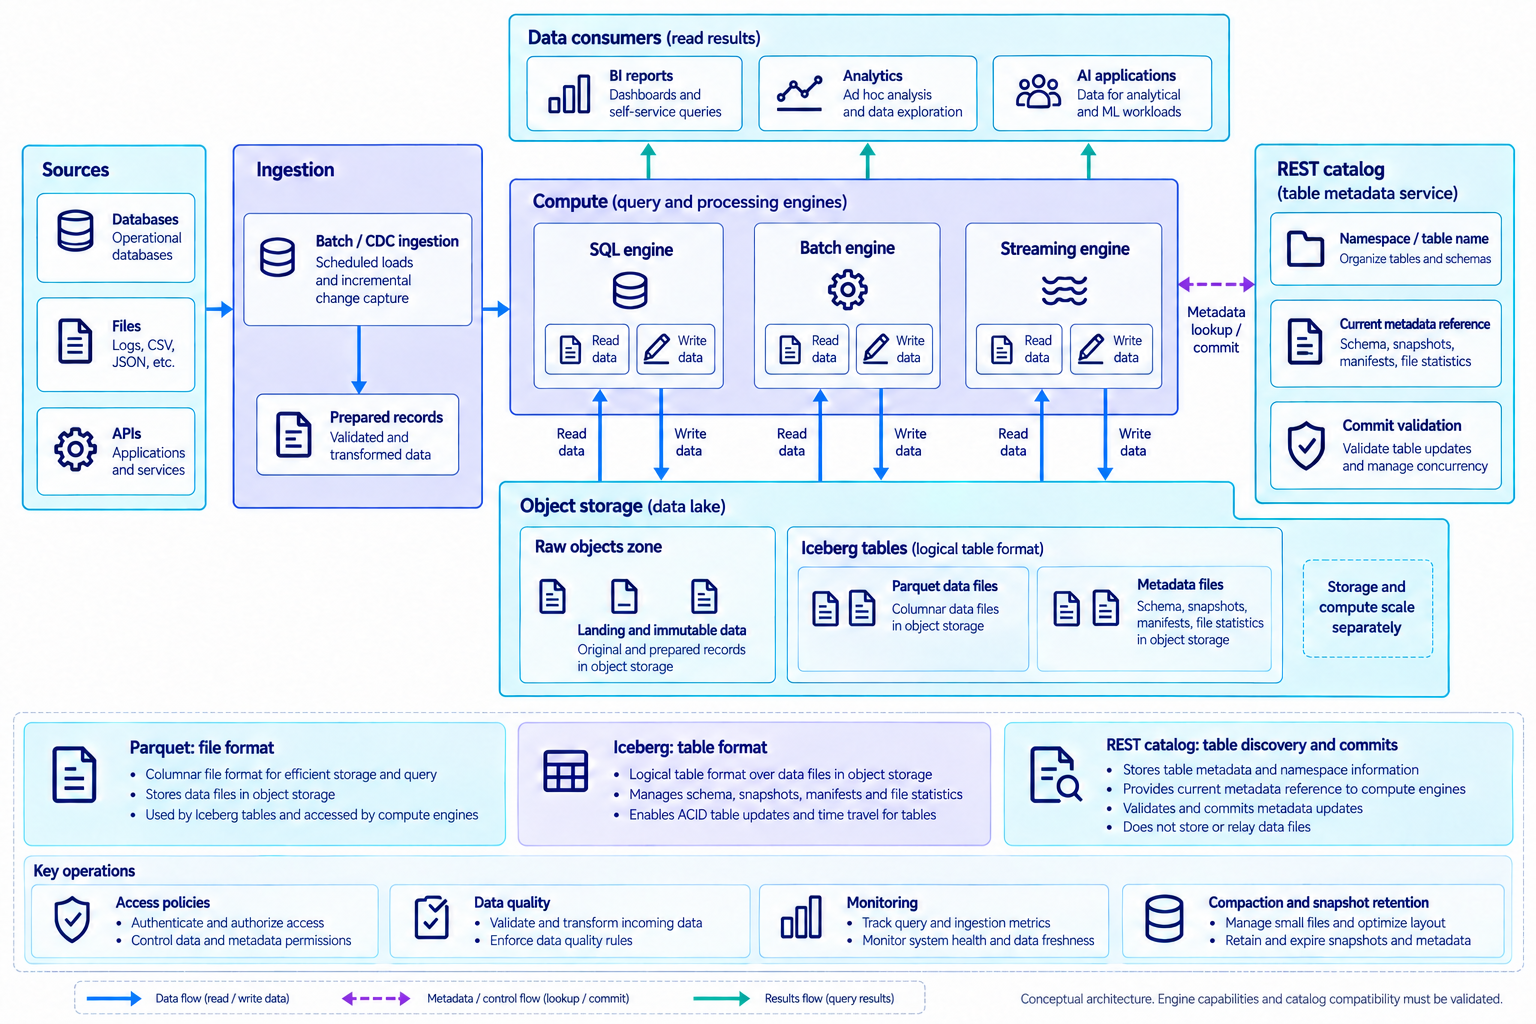
此图为概念架构。SQL、批处理和流处理表示使用类型;需确认各引擎的读写能力与目录兼容性,并分别规划存储和计算资源。
查看官方技术文档组合不同职责,以一致的表状态保存和使用数据。
| 组成概念 | 职责 |
|---|---|
| Parquet · 文件格式 | 以列式文件保存记录。单个文件不负责管理整张表的快照与提交状态。 |
| Apache Iceberg · 表格式 | 将多个数据文件管理为一张表,提供模式、分区定义、快照和文件统计。 |
| REST目录 | 将表名解析为当前元数据引用并处理提交请求。引擎直接从存储读取数据文件。 |
| 对象存储 | 保存数据文件和元数据文件。在此平台中,MinIO AIStor提供兼容S3的存储层。 |
在Open Lakehouse中,Argus Flow与NiFi 2负责采集和转换,Airflow 3协调任务,Starburst负责SQL分析和表处理,MinIO AIStor负责存储。下方平台架构图展示产品之间的连接。
通过向orders表追加数据的示例,了解文件保存与快照提交的区别。
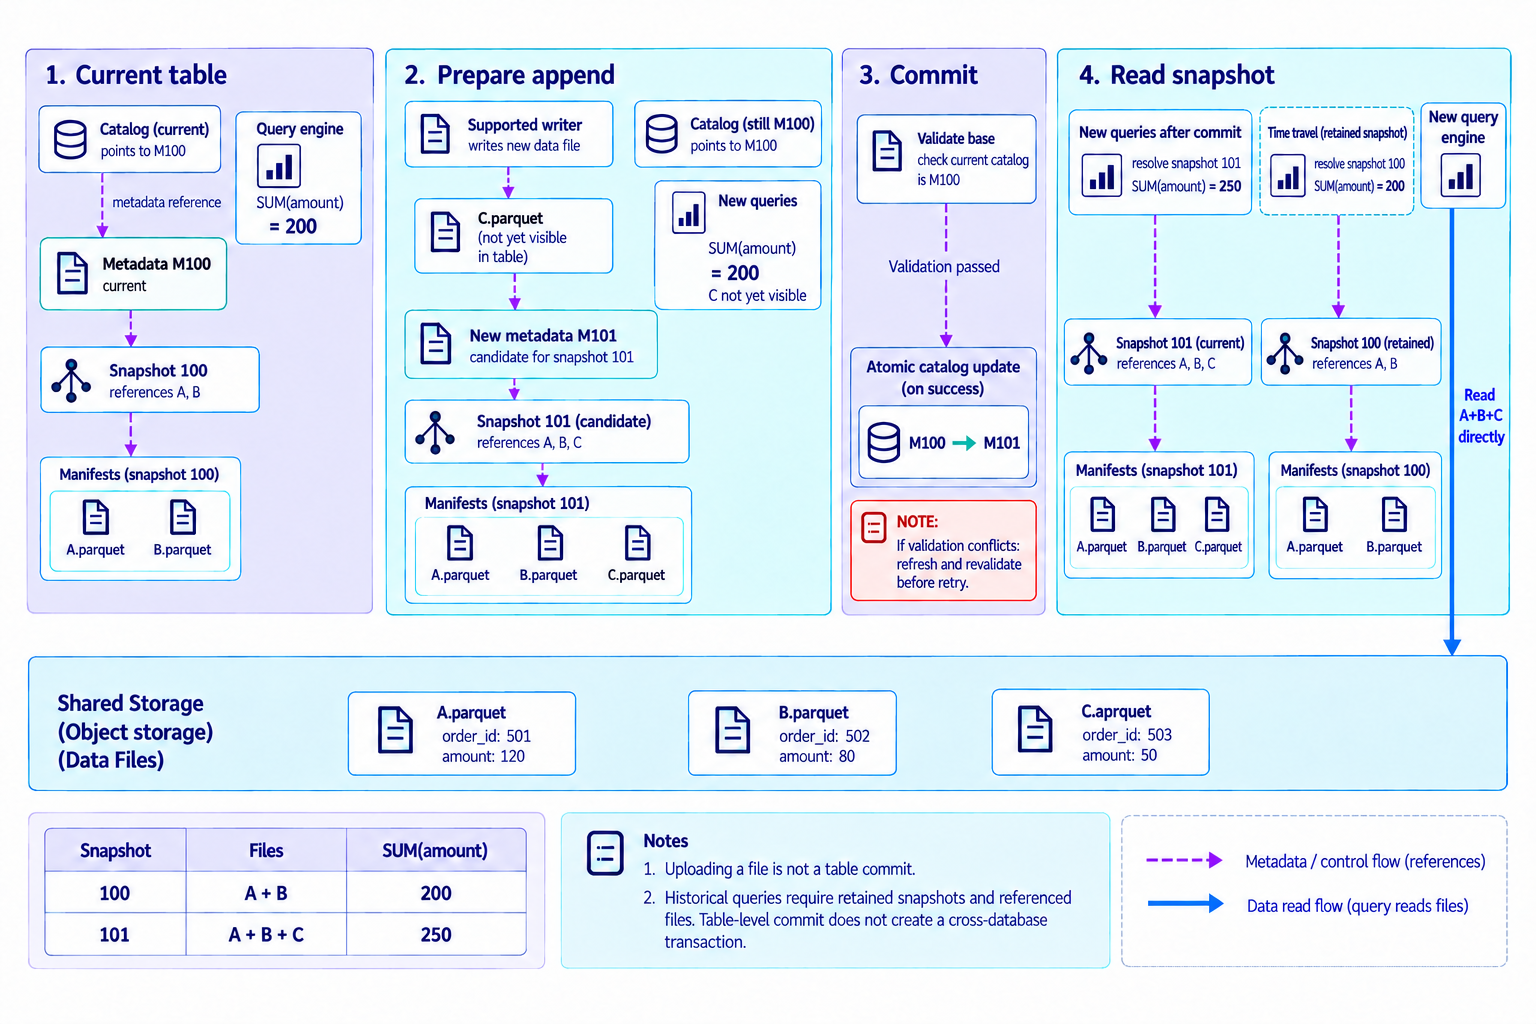
上传文件与提交表是不同的阶段。时间旅行需要保留快照及其引用的文件。表级提交不代表跨外部数据库的分布式事务。
查看官方技术文档将数据变更、历史查询和维护与业务需求连接。
| 功能 | 应用价值 |
|---|---|
| 表级事务 | 不向当前表查询暴露尚未提交的变更,并基于选定快照读取数据。 |
| 时间旅行 | 利用保留的历史快照重现分析结果,比较变更前后的状态。 |
| 模式与分区演进 | 通过受支持的列和分区定义变更适应数据与查询变化,而不是自动重排所有已有文件。 |
| 文件裁剪 | 使用分区和列统计缩小文件读取范围。效果取决于数据布局、统计和查询。 |
| 反映数据变更 | 通过受支持的引擎执行INSERT、UPDATE、DELETE和MERGE。CDC采集、去重和变更排序需要单独设计。 |
| 表维护 | 执行小文件合并、快照过期和未引用文件清理,并考虑运行中的任务及历史保留期限。 |
按引擎、连接器、Iceberg表版本和目录实现确认支持范围。在目标环境验证多引擎并发使用及写入兼容性。
Starburst Iceberg读写与维护文档将历史数据积累在湖仓中,并按需直接访问业务系统的数据。
采集数据库、文件与 API 数据,通过 Iceberg 表管理历史并支持数据复用。
无需预先复制全部数据,即可通过 Starburst SQL 和 JOIN 分析多个数据源。
Data Dynamics 提供架构、安装、集成、数据验证、性能测量和操作流程。
结合湖仓采集与对现有数据源的直接联邦访问。
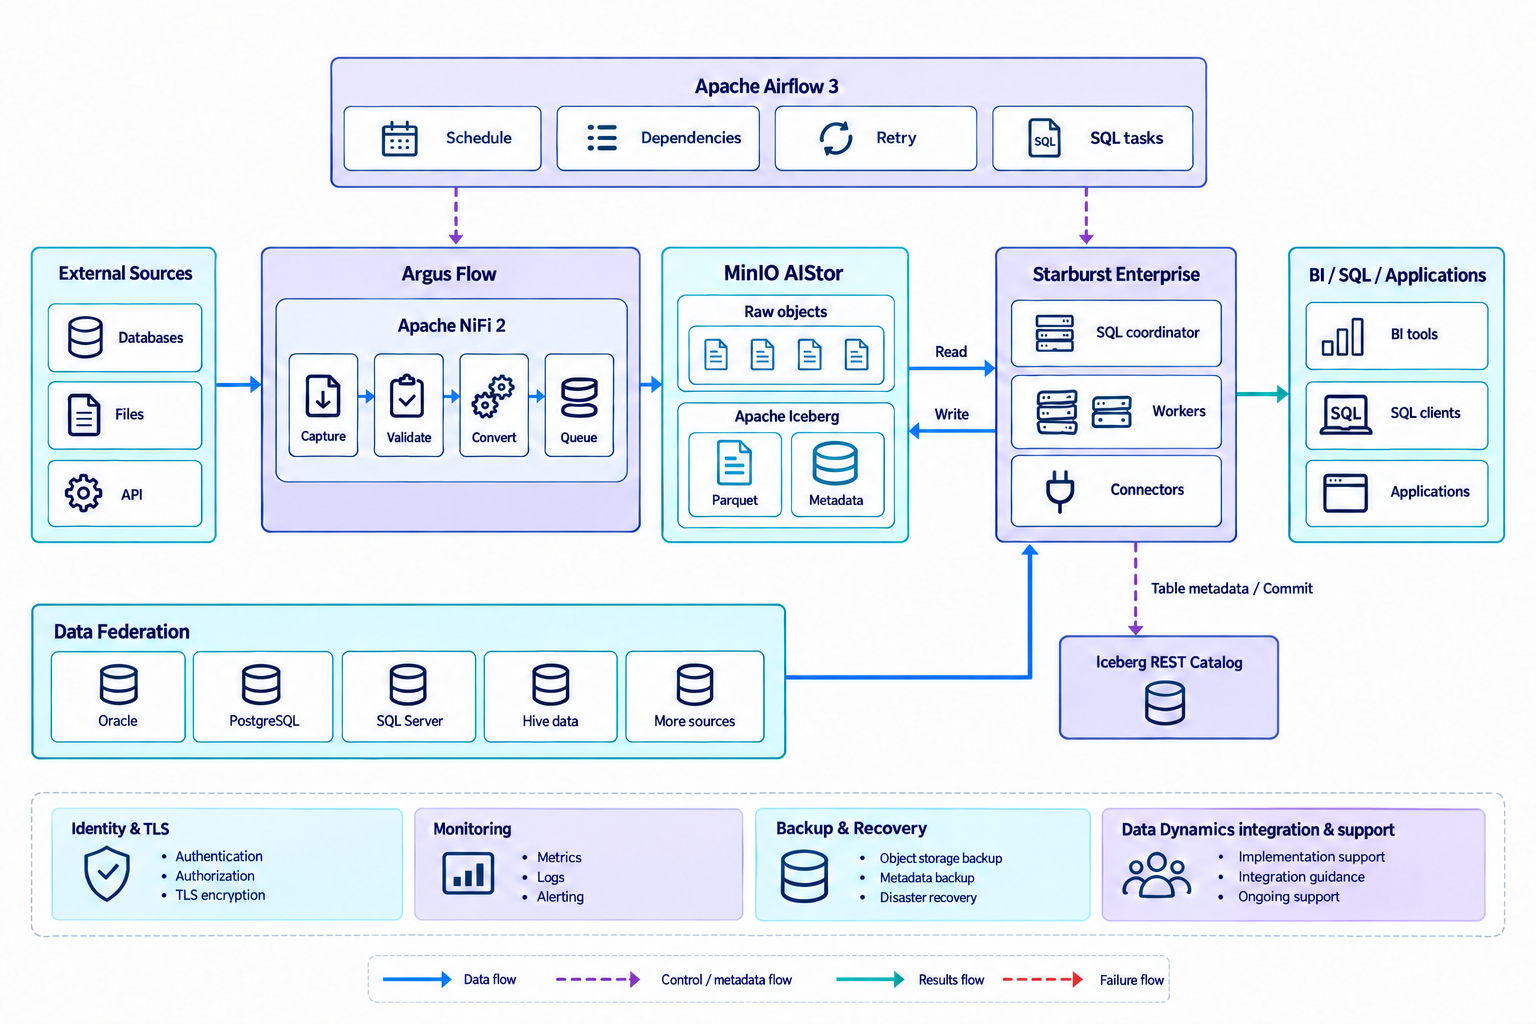
Iceberg 是表格式,MinIO AIStor 是存储层。REST 目录为参考配置,交付时一并验证实现、版本、认证与写入路径。
查看官方技术文档根据业务需求设计数据流程与运维标准,连接各产品。
| 组件 | 职责 |
|---|---|
| Argus Flow · Apache NiFi 2 | 通过处理器与控制器服务实现采集、CDC、转换、传输、队列和重放。 |
| Apache Airflow 3 | 管理调度与依赖,编排后续 SQL、质量检查与表维护。 |
| Starburst Enterprise | 跨数据库联邦、跨源 JOIN、Iceberg 读写和分布式 SQL。 |
| MinIO AIStor | 通过 S3 兼容存储保存原始对象、Parquet 和 Iceberg 元数据,并配套商业订阅与技术支持。 |
| Apache Iceberg · REST 目录 | 管理快照和表元数据,交付时验证目录实现、认证与写入兼容性。 |
设计 Oracle、Hive、Impala 环境及更多数据源的接入。
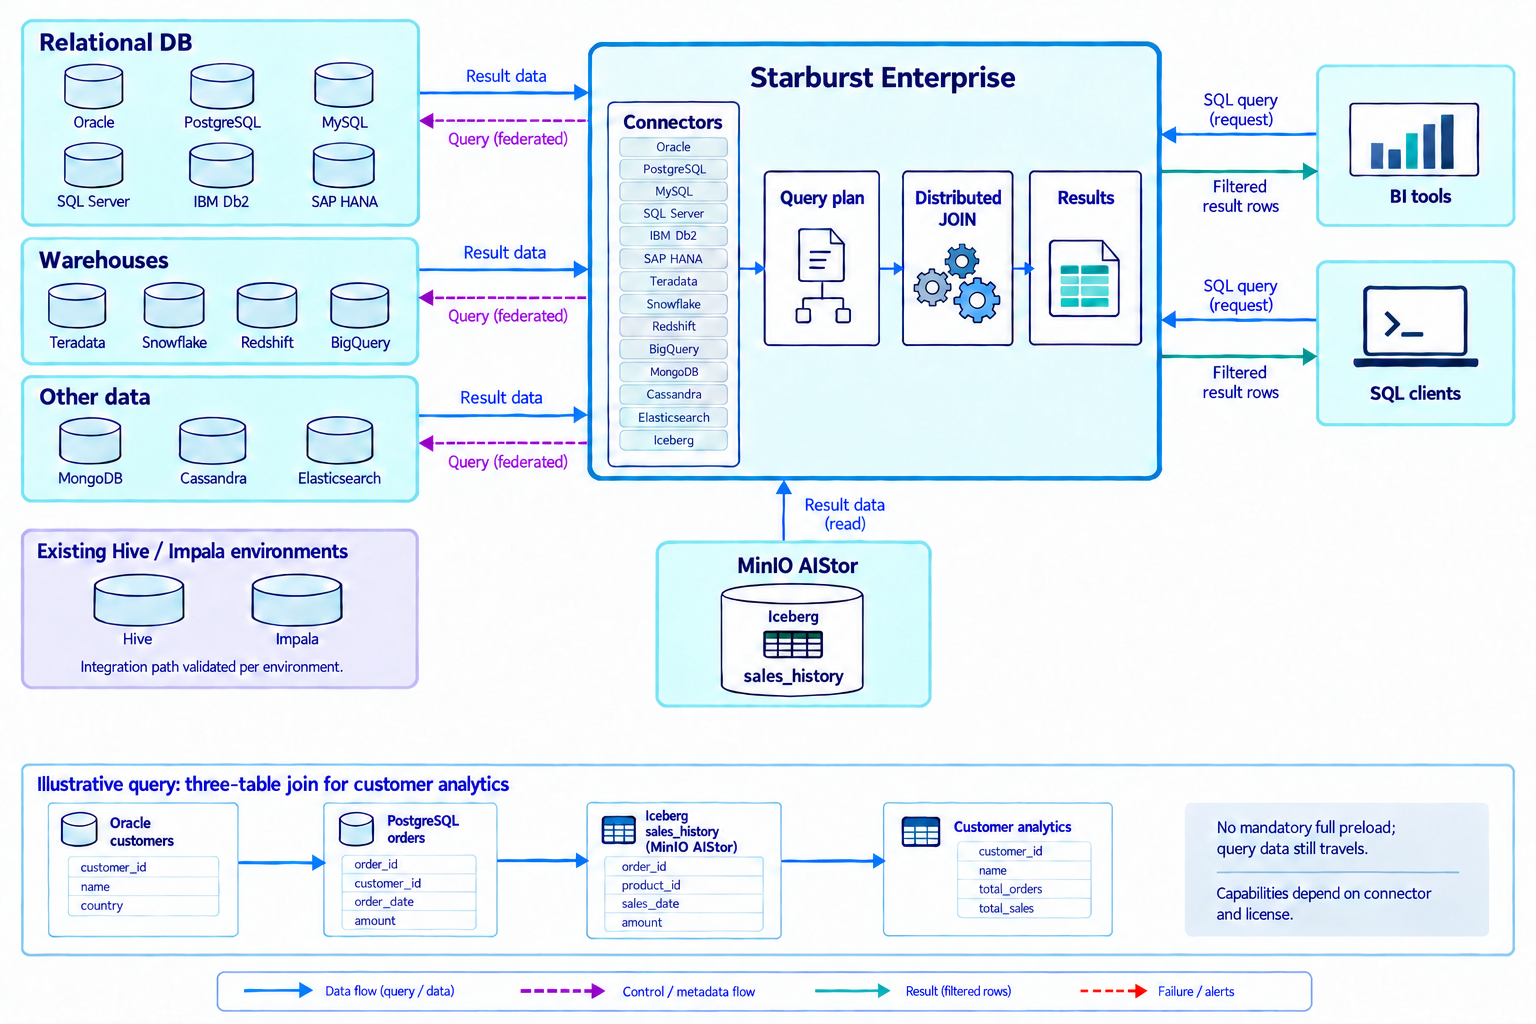
联邦减少全量预加载的需要,但查询期间仍会传输数据;必须管理数据源负载与访问权限。
查看官方技术文档以统一 SQL 访问路径连接业务数据库、现有分析平台、云数仓与湖仓。
| 数据源类别 | 典型数据源 |
|---|---|
| 关系型数据库 | Oracle · PostgreSQL · MySQL · SQL Server · IBM Db2 · SAP HANA |
| 数据仓库 | Teradata · Snowflake · Amazon Redshift · Google BigQuery |
| NoSQL 与搜索 | MongoDB · Cassandra · Elasticsearch |
| 现有大数据平台 | Hive · Impala 环境 — 按现有表、存储与访问方式设计集成路径 |
| 平台湖仓 | 存储在MinIO AIStor 上的 Apache Iceberg 表 |
功能、认证和许可因连接器而异。不预设专用 Impala 连接器的正式支持,需验证现有环境的数据访问路径与兼容性。Generic JDBC 用于 PoC 评估,生产支持范围另行确认。
Starburst 连接器支持范围将处理器级的数据处理与后续任务顺序连接起来。
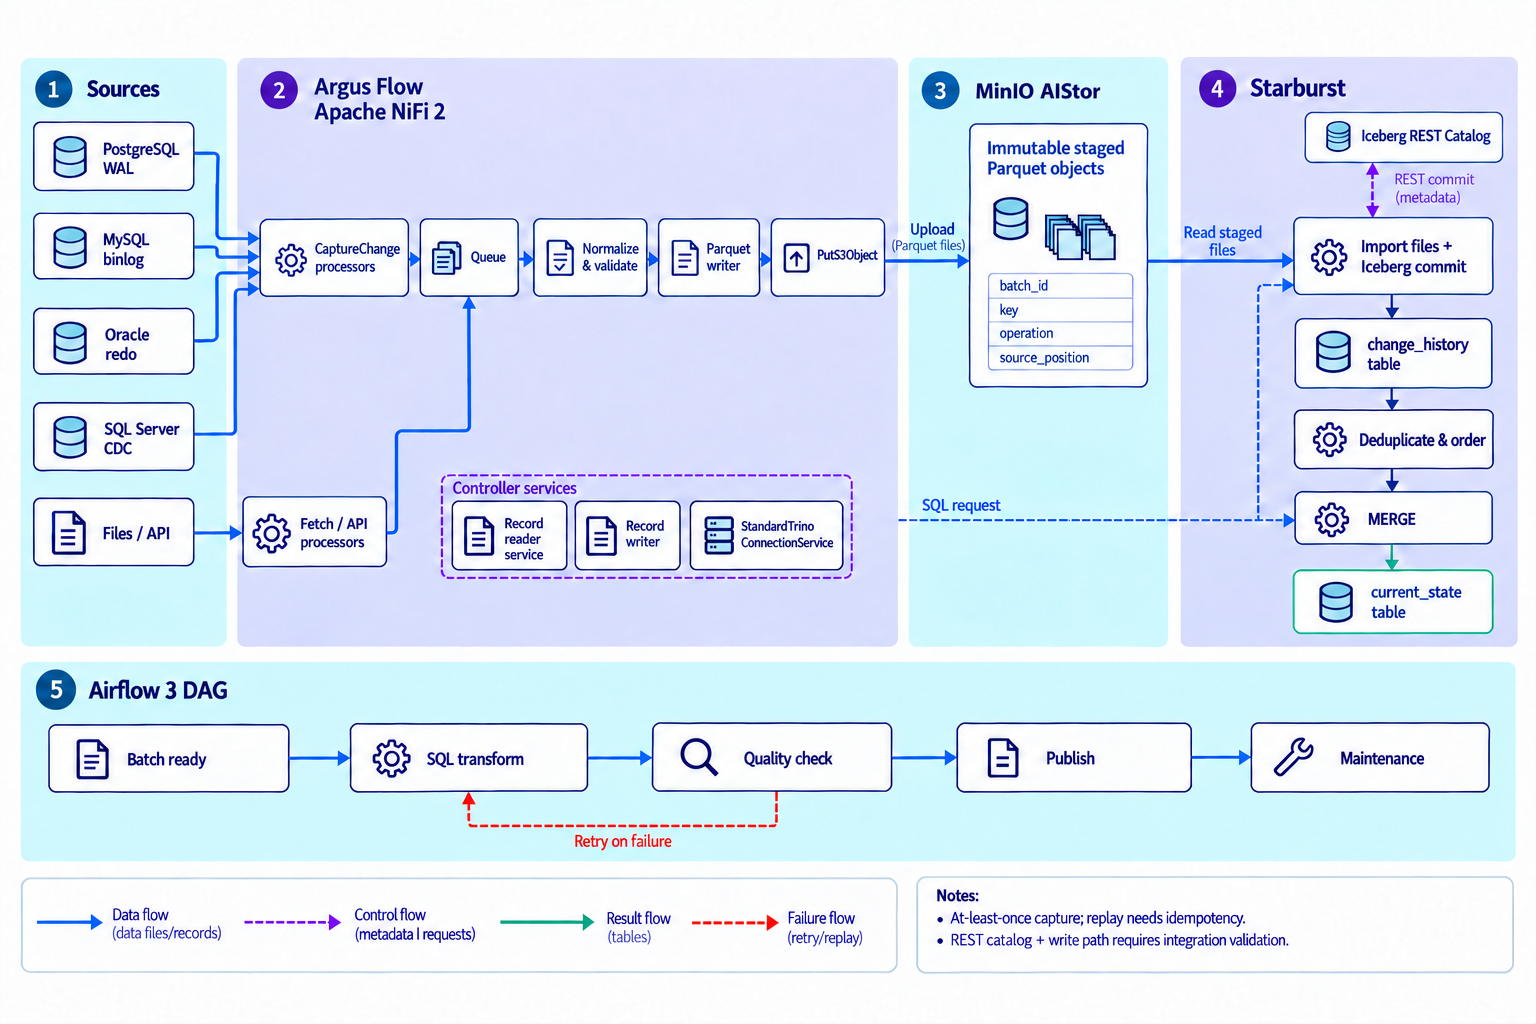
参考路径结合 S3 上传和 Starburst 文件导入。add_files 不验证文件模式,需配置模式与分区检查、防重复导入及已注册文件的保留策略。不预设 NiFi PutIceberg 可直接写入 REST 目录。
查看官方技术文档配套商业订阅和技术支持的企业存储方案。
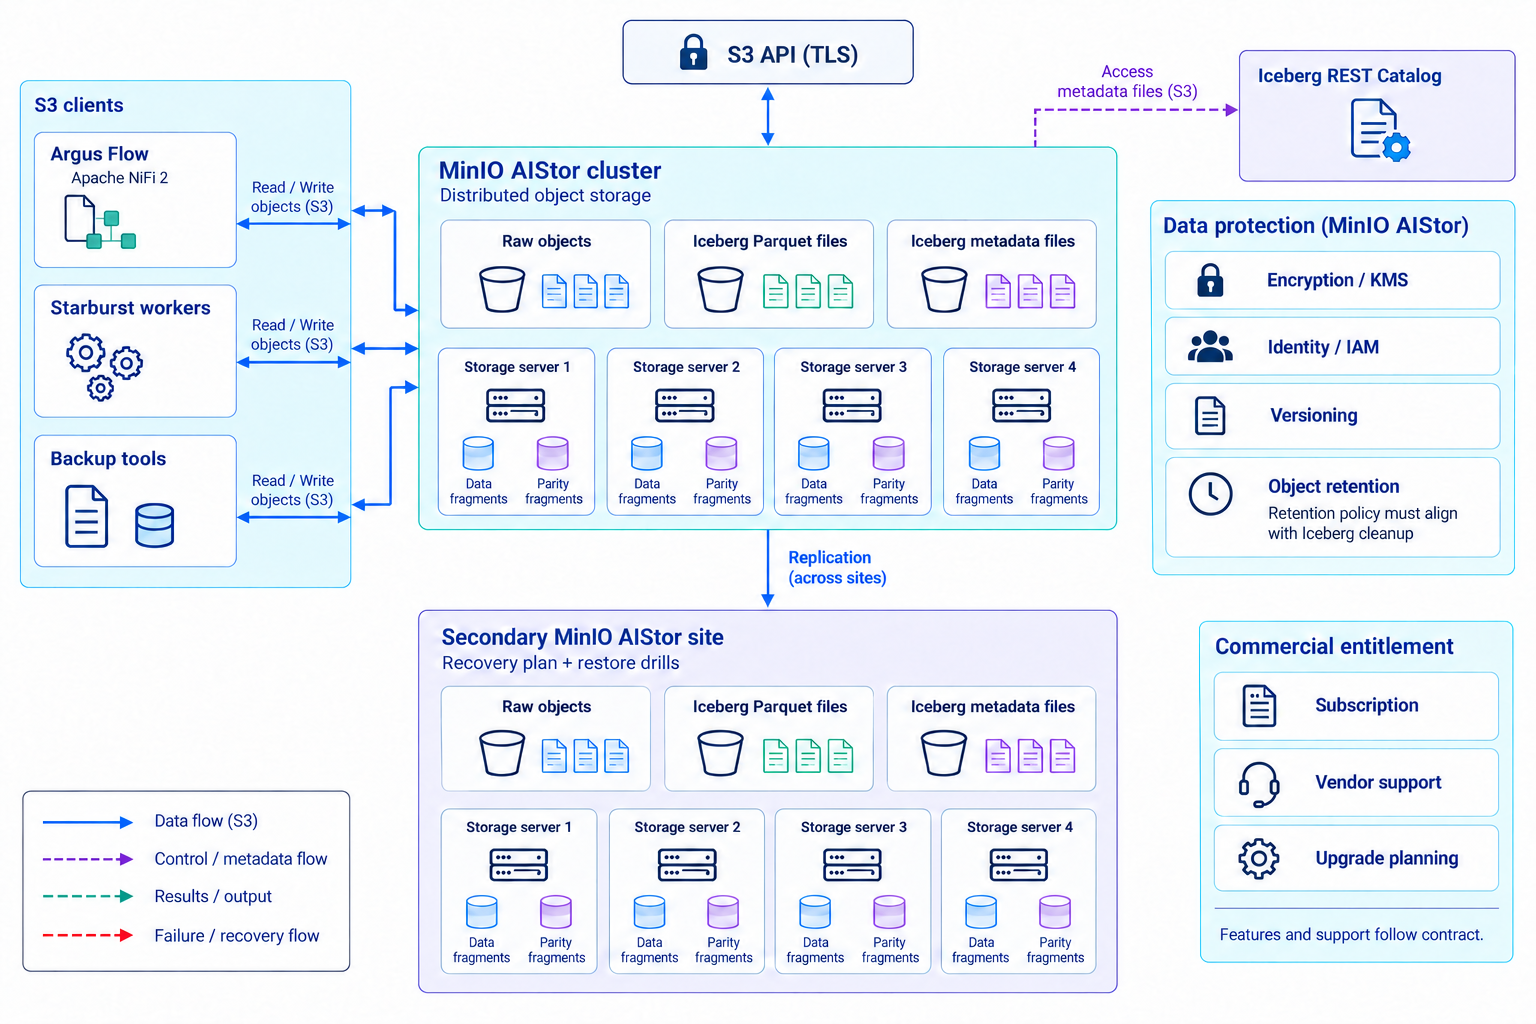
权益以合同产品为准,对象保留与锁定策略需与 Iceberg 文件清理和快照过期协调。
查看官方技术文档区分数据库下推与 Iceberg 扫描优化。
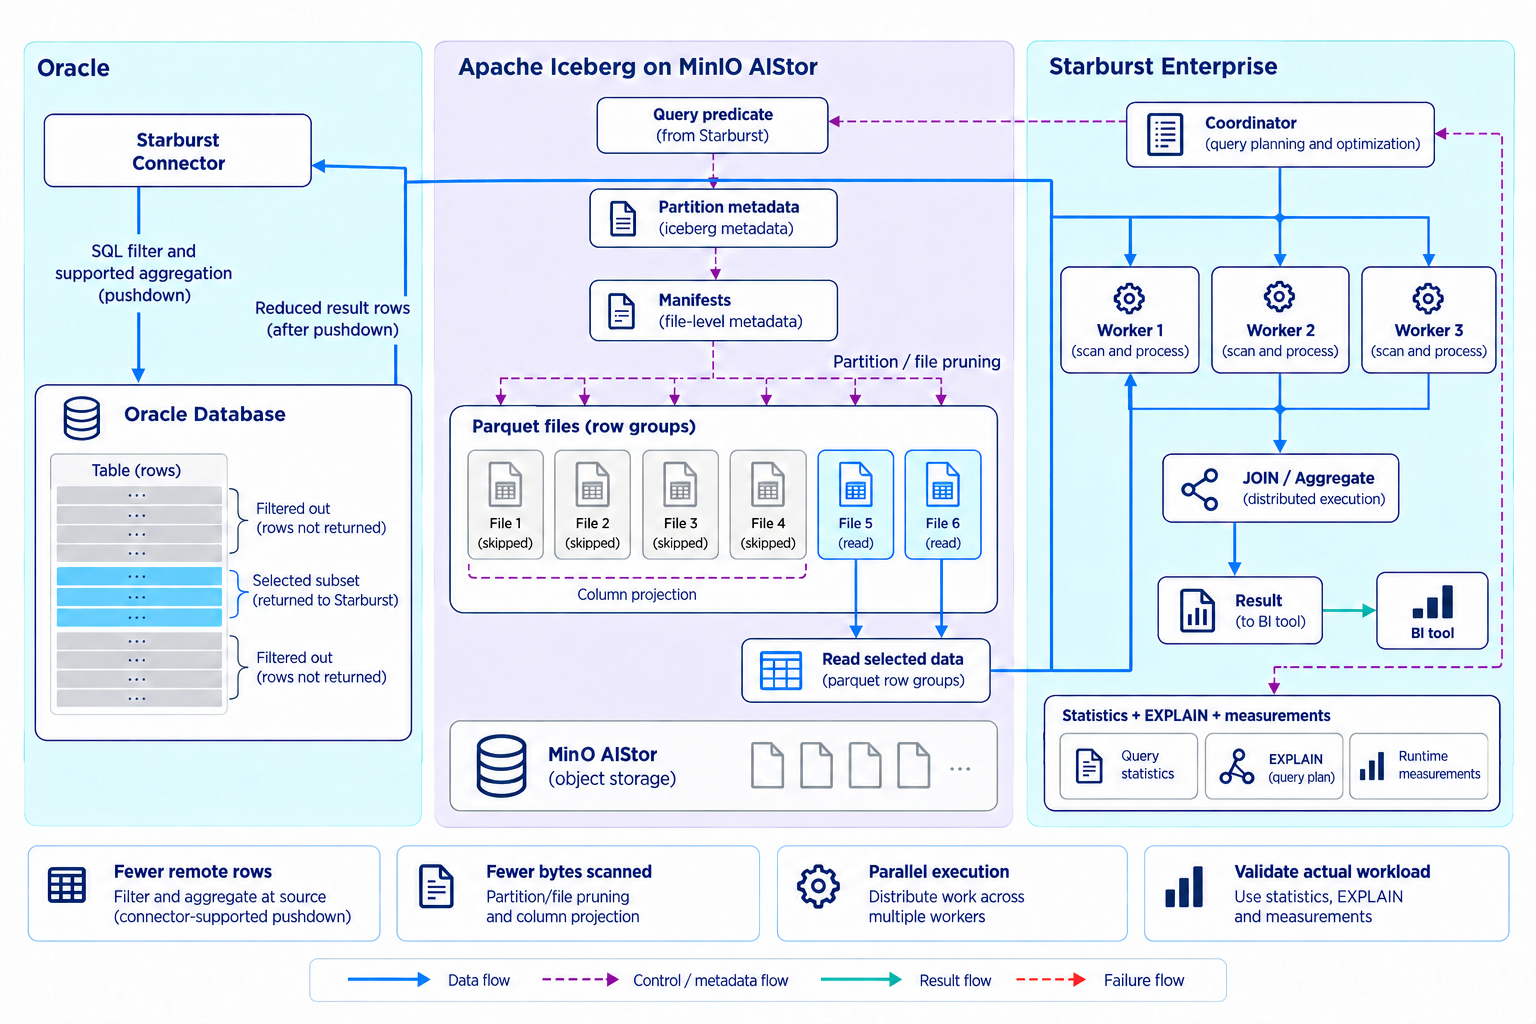
下推能力取决于连接器和查询。MinIO AIStor 不执行 SQL,性能需结合数据分布、统计、网络与并发进行实测。
查看官方技术文档监控流程、查询和存储,使恢复与表维护可重复执行。
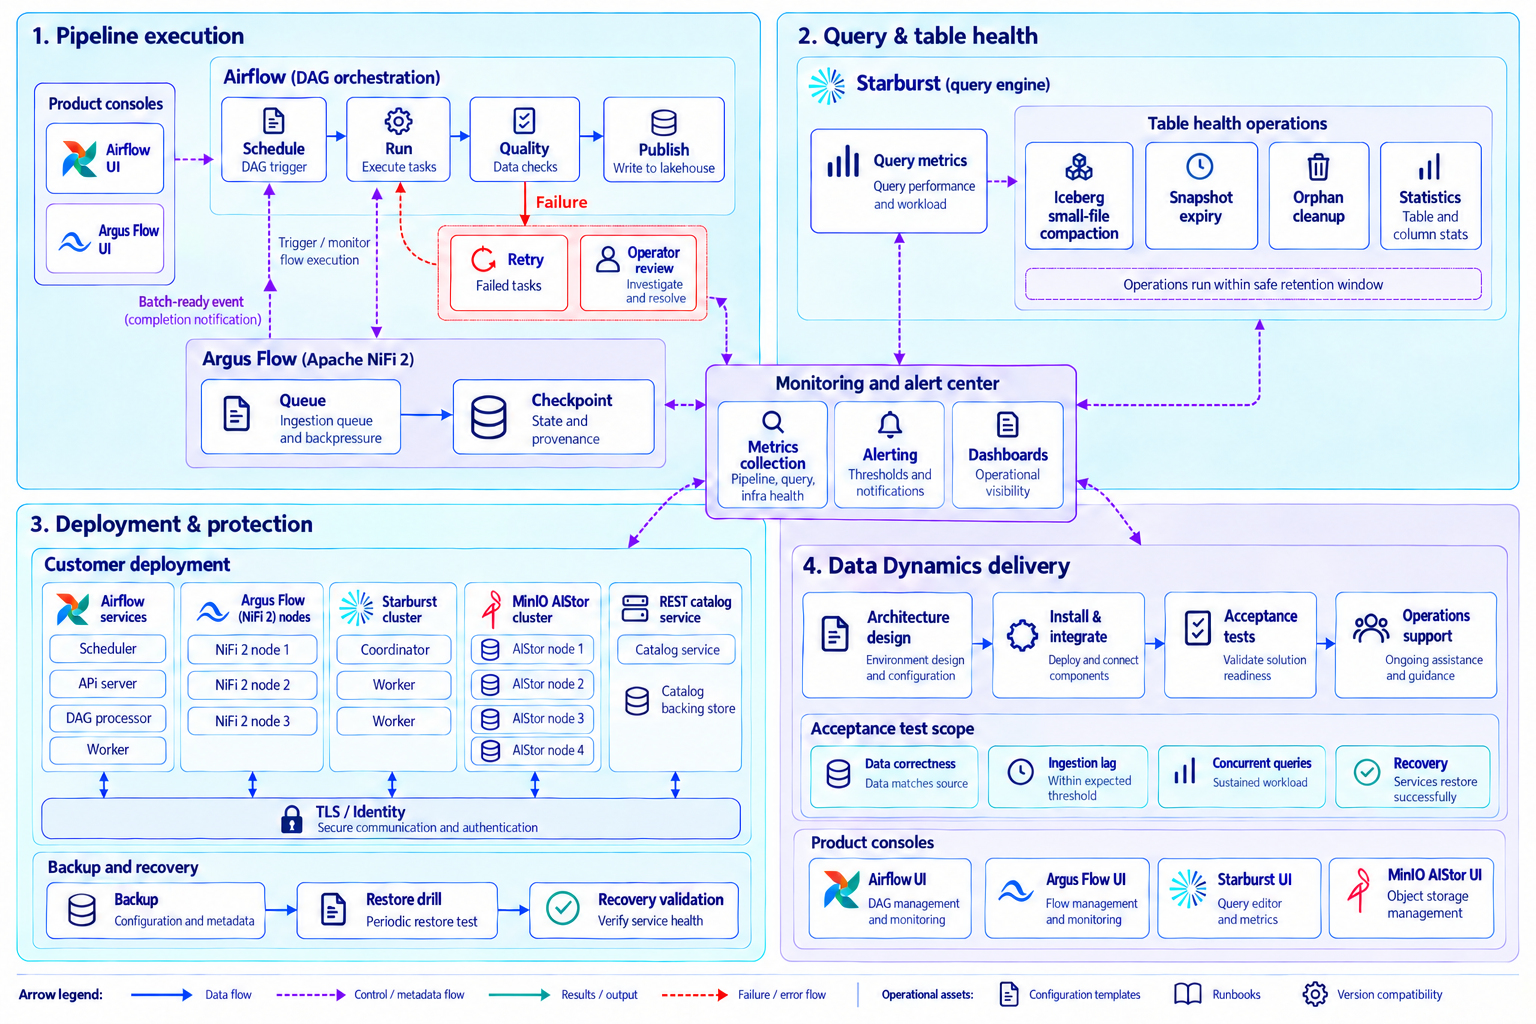
重试应确保幂等性;快照过期和孤立文件清理需考虑运行中的任务及保留窗口。恢复目标通过演练验证。
查看官方技术文档交付数据流程、验收标准和操作手册,并在合同中明确范围与支持条件。
使用代表性数据与查询验证集成,明确容量、并发、安全和恢复要求。
配置版本组合、模板、NiFi 流程、Airflow DAG、目录、认证、监控、告警与操作手册。
提供故障协调、厂商支持对接、升级兼容性评估、性能检查与备份恢复演练。
本方案整合部署与运维,使用各产品的管理控制台。MinIO AIStor 与 Starburst 的产品、许可及支持范围在方案和合同中确认。
了解组件功能和扩展选项。