
NiFi 2 클러스터 모니터링 — Prometheus Exporter·알림 24종·Grafana 대시보드 설계
Cloudera CFM 4.12(Apache NiFi 2.6)를 위한 오픈소스 모니터링 구성 nifi-monitoring을 소개합니다. REST API exporter 설계, recording rule과 알림 24종·억제 7종, 대시보드 6종과 Provenance 클릭 조회, 알림 중계, 검증 체계까지 정리했습니다.
NiFi는 화면이 친절한 편입니다. 캔버스에서 큐가 빨갛게 변하고, 프로세서 옆에 Bulletin이 뜨고, Summary에서 처리량을 볼 수 있습니다. 문제는 누군가 그 화면을 보고 있을 때만 그렇다는 점입니다. 새벽 세 시에 Backpressure가 걸려 상류 프로세서가 멈춰도, 노드 하나가 클러스터에서 빠져도, ERROR Bulletin이 5분 동안 수백 건 쌓였다가 사라져도 NiFi는 아무에게도 알리지 않습니다.
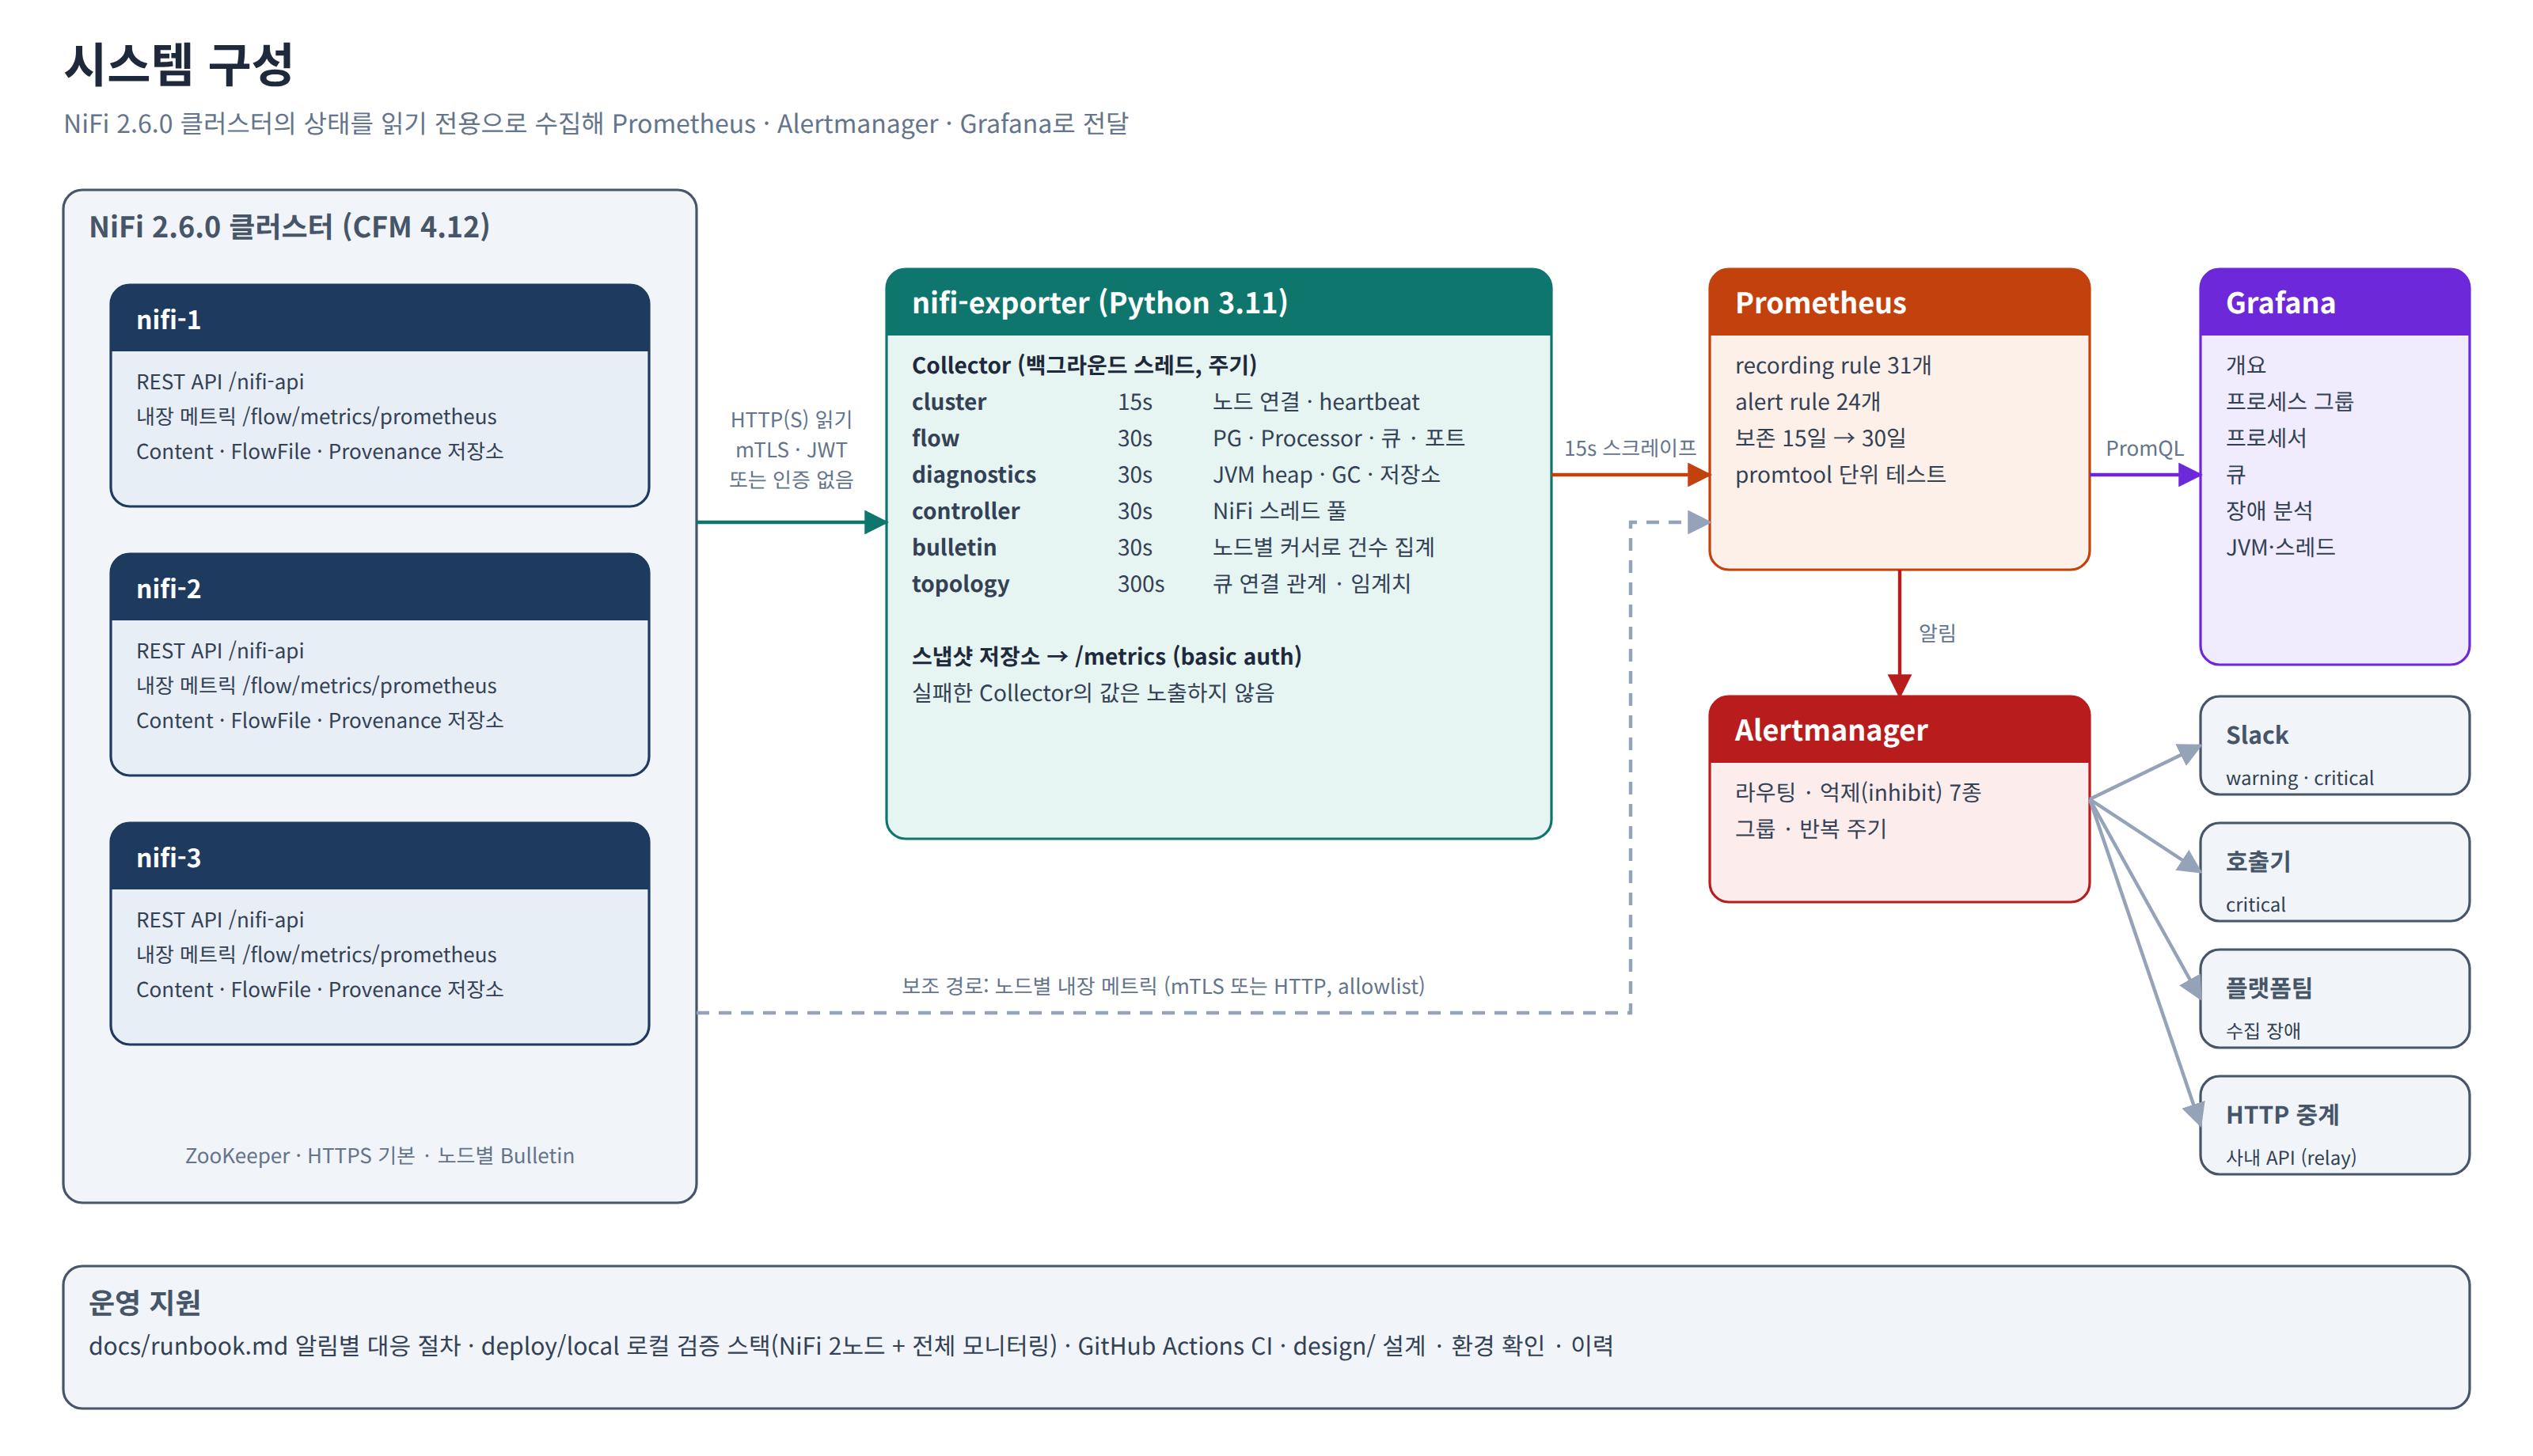
이 글은 그 빈자리를 채우기 위해 만든 모니터링 구성 nifi-monitoring 을 상세하게 설명합니다. 대상은 Cloudera Flow Management(CFM) 4.12에 포함된 Apache NiFi 2.6.0 이며, Sqoop 없이 Oracle→Hive 적재하기 시리즈에서 다룬 것과 같은 고객 현장(온프레미스·폐쇄망)에서 운영하려고 설계했습니다. 저장소는 Apache License 2.0으로 공개되어 있습니다.
한눈에 보기
| 구성 요소 | 역할 |
|---|---|
| nifi-exporter | NiFi REST API를 읽어 Prometheus 메트릭으로 노출 (Python 3.11) |
| nifi-provenance-query | Grafana 링크에서 Processor 하나와 시간 범위로 Provenance 조회 |
| nifi-alert-relay | Alertmanager 알림을 사내 HTTP API 형식으로 다시 전송 |
| Prometheus 규칙 | recording rule 31개, alert rule 24개, promtool 단위 테스트 |
| Alertmanager 설정 | 라우팅, 억제(inhibit) 7종, Slack 템플릿 |
| Grafana 대시보드 | 6종, 생성기 스크립트로 관리 |
| 로컬 검증 스택 | NiFi 2.6.0 2노드 클러스터 + 위 구성 전체 (Docker Compose) |
| Runbook | 알림별 의미·확인 위치·조치 |
세 개의 Python 서비스는 같은 패키지·같은 Docker 이미지의 서로 다른 진입점입니다. 이미지 하나로 exporter, Provenance 조회, 알림 중계를 모두 띄웁니다.
1. 왜 exporter를 따로 만들었나
NiFi 2.x에는 노드마다 Prometheus 형식의 내장 메트릭 엔드포인트(/nifi-api/flow/metrics/prometheus)가 있습니다. 처음에는 이것만으로 충분해 보였지만, 실제 장애 대응에 쓰려고 하자 부족한 점이 드러났습니다.
- 노드별 값만 나옵니다. 클러스터 전체의 큐 적체를 보려면 노드 수만큼 스크레이프하고 합산해야 합니다. 노드가 끊기면 그 노드의 값은 그냥 사라집니다.
- 클러스터 상태가 없습니다. 어떤 노드가 DISCONNECTED/OFFLOADED인지, heartbeat가 얼마나 지났는지는
/controller/cluster에만 있습니다. - Bulletin이 없습니다. NiFi는 Bulletin을 메모리에 컴포넌트당 최대 5건, 약 5분만 보관합니다. 누가 세지 않으면 기록이 남지 않습니다.
- "하류가 Running인데 큐가 정체"를 판정할 연결 정보가 없습니다. 큐가 어떤 프로세서로 이어지는지를 알아야 하는데, 이 관계는 플로우 구조 API에만 있습니다.
그래서 REST API를 읽어 클러스터 단위로 정리된 메트릭을 내는 exporter를 만들고, 내장 엔드포인트는 노드별 분해가 필요할 때만 쓰는 보조 경로로 남겼습니다(Prometheus의 nifi-builtin job, allowlist로 필요한 메트릭만 수집).
2. nifi-exporter 설계
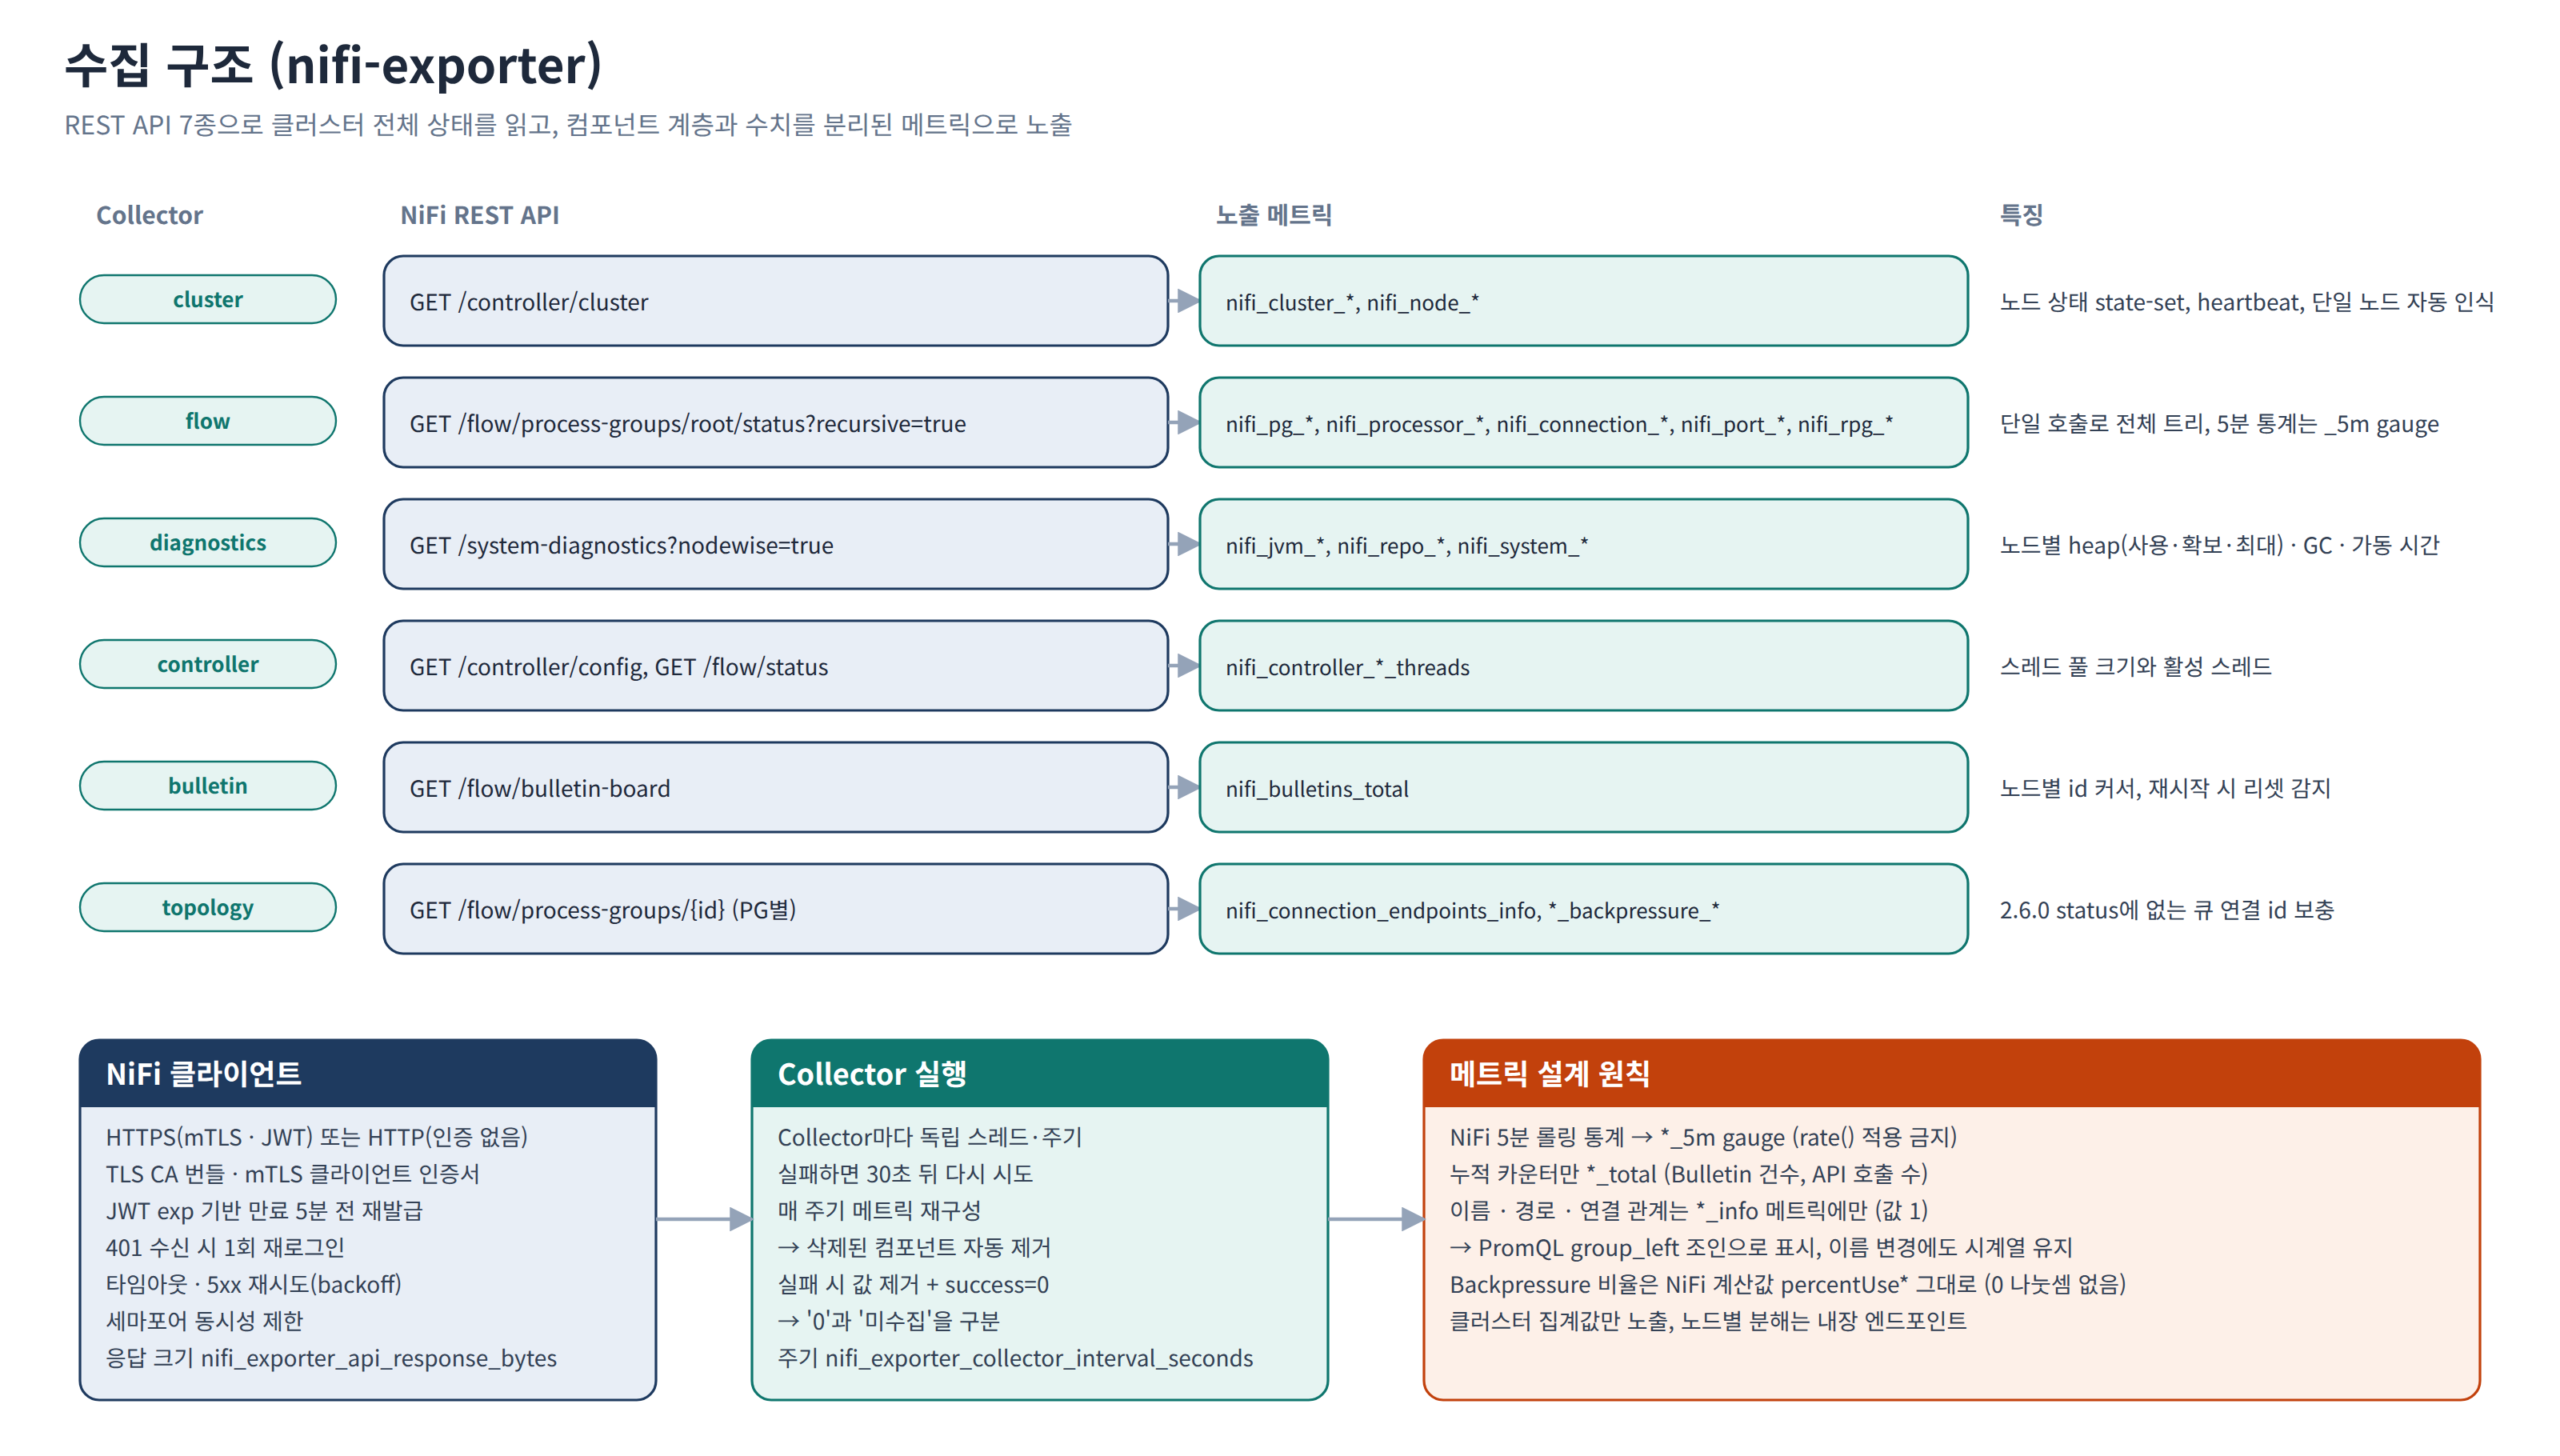
2.1 collector 6종
| collector | NiFi API | 주기 | 주요 메트릭 (접두사 nifi_) |
|---|---|---|---|
cluster | GET /controller/cluster (404면 /flow/cluster/summary) | 15s | cluster_nodes_total, cluster_nodes_connected, node_status, node_heartbeat_age_seconds, node_active_threads, node_queued_* |
flow | GET /flow/process-groups/root/status?recursive=true | 30s | pg_*, processor_*, connection_*, port_*, rpg_* |
diagnostics | GET /system-diagnostics?nodewise=true | 30s | jvm_heap_*, jvm_gc_*_total, jvm_threads, repo_*, system_* |
controller | GET /controller/config, GET /flow/status | 30s | controller_max_timer_driven_threads, controller_active_threads, controller_terminated_threads |
bulletin | GET /flow/bulletin-board | 30s | bulletins_total, bulletins_observed_5m, bulletin_last_timestamp_seconds |
topology | GET /flow/process-groups/{id} (그룹별) | 300s | connection_endpoints_info, connection_backpressure_*_threshold |
flow collector는 recursive=true 한 번의 호출로 Process Group 트리 전체의 상태를 받습니다. 플로우가 커지면 이 응답이 가장 무거워지므로, exporter는 응답 크기를 nifi_exporter_api_response_bytes로 스스로 내보내고 10MB를 30분 넘게 초과하면 경고합니다(NiFiExporterFlowResponseLarge). 그럴 땐 주기를 60초로 늘리거나 exclude_pg_ids로 일부 그룹을 뺍니다.
2.2 스크레이프와 수집을 분리한다
exporter의 가장 중요한 설계 결정은 /metrics 요청이 NiFi를 호출하지 않는다는 것입니다. collector마다 백그라운드 스레드와 주기가 따로 있고, 수집 결과를 스냅샷 저장소에 넣습니다. /metrics는 그 스냅샷을 직렬화할 뿐입니다.
def run_once(self) -> bool:
    name = self.collector.name
    started = time.monotonic()
    try:
        families = self.collector.collect()
    except Exception as e:
        self._store.clear(name)                        # 실패하면 값을 버린다
        self._sm.collector_success.labels(name).set(0)
        ...
        return False
    self._store.set(name, families)
    self._sm.collector_success.labels(name).set(1)
    ...
이렇게 하면 몇 가지가 함께 해결됩니다.
- Prometheus 스크레이프가 느린 NiFi 응답에 묶이지 않습니다. 스크레이프 타임아웃으로
up이 0이 되는 일이 없습니다. - collector마다 주기를 다르게 줄 수 있습니다. 노드 상태는 15초, 무거운 topology는 5분입니다.
- Prometheus를 여러 대 붙여도 NiFi 호출 수가 늘지 않습니다.
2.3 "0"과 "미수집"을 구분한다
collector가 실패하면 exporter는 이전 값을 유지하지도, 0을 내지도 않습니다. 그 collector의 메트릭을 노출에서 아예 빼고 nifi_exporter_collector_success{collector}를 0으로 둡니다.
이전 값을 유지하면 NiFi가 죽었는데도 대시보드가 멀쩡해 보이고, 0을 내면 "큐 적체 0"처럼 거짓 정상이 됩니다. 값이 없어야 대시보드도 알림도 "모른다"는 상태를 정직하게 표현할 수 있습니다. 대신 수집 자체를 감시하는 알림(NiFiCollectorFailing, NiFiCollectorStale)과 대시보드 상단의 collector 상태 패널이 이 공백을 알려 줍니다.
실패한 collector는 주기가 길어도 30초 뒤 다시 시도합니다. 300초 주기의 topology가 NiFi 재시작 직후 한 번 실패한 채로 5분을 기다리면, 그동안 NiFiCollectorFailing이 같은 클러스터의 다른 알림을 모두 억제하기 때문입니다.
2.4 메트릭 규칙: _5m, _total, _info
| 규칙 | 의미 |
|---|---|
*_5m | NiFi가 계산한 5분 롤링 통계를 그대로 낸 gauge 입니다. rate()/increase()를 적용하지 않습니다. |
*_total | exporter가 직접 누적하는 카운터만 해당합니다(Bulletin 건수, API 호출 수). |
*_info | 이름·경로·종류·연결 관계는 값이 1인 info 메트릭에만 둡니다. |
수치 메트릭에는 id만 붙이고, 사람이 읽는 이름은 조인으로 붙입니다.
nifi_pg_queued_flowfiles
  * on (cluster, pg_id) group_left (pg_path) nifi_pg_info
번거로워 보이지만 이유가 있습니다. 프로세서 이름이나 그룹 경로를 바꿀 때마다 수치 시계열이 끊기고 새로 생기면 추이 그래프와 for 조건이 모두 리셋됩니다. 이름을 info로 분리하면 이름을 바꿔도 수치 시계열은 그대로 이어집니다. Backpressure 비율도 NiFi가 계산한 percentUseCount·percentUseBytes를 그대로 내므로 임계치 0으로 나누는 문제가 없습니다.
2.5 NiFi 2.6의 빈틈을 메우는 topology collector
NiFi 2.x의 상태 응답(/flow/process-groups/root/status)은 Connection의 source/destination 이름은 주지만 id 는 주지 않습니다. 이름은 중복될 수 있으니, "이 큐의 하류 프로세서가 Running인가"를 정확히 판정할 수 없습니다.
그래서 topology collector가 Process Group마다 플로우 구조 API를 5분 주기로 읽어 nifi_connection_endpoints_info(source/destination id와 종류)와 Backpressure 임계치를 보충합니다. Prometheus에서는 이를 프로세서의 실행 상태와 조인해 큐마다 "하류가 Running이면 1"인 시계열을 만듭니다.
# nifi:connection_destination_running
nifi_connection_endpoints_info{destination_type="PROCESSOR"}
  * on (cluster, destination_id) group_left ()
  label_replace(nifi_processor_running, "destination_id", "$1", "processor_id", "(.*)")
이 값이 있어야 "하류는 돌고 있는데 소비가 0"인 큐 정체 알림(NiFiQueueStalled)이 동작합니다.
2.6 Bulletin을 한 번씩만 센다
Bulletin은 가장 까다로운 수집 대상이었습니다. NiFi 2.6.0 클러스터에서 확인한 동작은 이렇습니다.
- Bulletin id는 노드마다 별도의 시퀀스이고,
after/limit파라미터도 노드별로 적용됩니다. - 노드가 재시작하면 그 노드의 시퀀스는 0부터 다시 시작합니다.
- 보관은 컴포넌트당 최대 5건, 약 5분입니다.
그래서 exporter는 노드별 커서(마지막으로 본 id)를 둡니다. 매 주기 board 전체를 가져와 커서보다 큰 id만 세고, 어떤 노드의 최신 id가 커서보다 작아지면 재시작으로 보고 그 노드의 커서를 리셋합니다. 노드가 limit만큼 돌려줬다면 더 있을 수 있으니 after=<최신 id>로 다음 페이지를 가져옵니다.
첫 주기에는 커서만 설정하고 세지 않습니다. exporter를 재시작해도 이미 본 Bulletin을 다시 세지 않기 위해서입니다. 다만 이렇게 하면 누적 카운터의 첫 샘플에 "이전의 0"이 없어 Prometheus increase()가 새 source의 첫 수집분을 놓칩니다. 이 문제는 exporter가 최근 5분 동안 새로 관측한 건수를 별도 gauge(nifi_bulletins_observed_5m)로 내고, 알림이 이 값을 쓰는 방식으로 풀었습니다.
메시지 원문은 카디널리티 폭발을 막기 위해 절대 레이블로 쓰지 않습니다. 원문이 필요하면 server.log_bulletin_messages: true로 exporter의 JSON 로그에 남겨 로그 수집기로 보냅니다. NiFi의 보관 한계 때문에 Bulletin 건수는 항상 하한값 이라는 점도 알아 둬야 합니다.
2.7 인증, 단일 노드, 자기 감시
- 인증:
bearer(Single User·LDAP·Kerberos로POST /access/token, JWTexp기준 만료 5분 전 재발급, 401을 받으면 1회 재로그인),mtls(클라이언트 인증서),none(TLS·인증 없는 HTTP NiFi) 중에서 고릅니다.http://주소에는none만 허용합니다. - 권한: 읽기 전용 계정에
/flow,/controller,/system의 view 권한과 루트 Process Group의 view the component 권한, 이 4개만 주면 모든 수집이 동작하는 것을 2.6.0에서 확인했습니다. - 단일 노드: 비클러스터 NiFi는
/controller/cluster에 404를 줍니다. 이때/flow/cluster/summary로 단일 노드인지 확인해 실패로 보고하지 않고nifi_cluster_clustered0을 냅니다. 클러스터인데 404라면 exporter가 붙은 노드가 끊긴 것이므로 실패로 보고합니다. - 보호와 프로브:
/metrics는 basic auth로 보호할 수 있고,/healthz(프로세스 생존)와/readyz(collector가 한 번이라도 성공)는 열어 둡니다. - 자기 감시: collector별 성공 여부·소요 시간·주기·마지막 성공 시각, 엔드포인트별 API 호출 수와 응답 크기, 토큰 만료 시각을 메트릭으로 냅니다.
- 이미지는 비root(uid 65534)로 실행합니다.
3. Prometheus: recording rule과 규모 산정
recording rule 31개는 크게 네 가지 일을 합니다.
| 묶음 | 예 |
|---|---|
| 증가량 | nifi:connection_queued_flowfiles:delta10m — 큐 적체의 5분·10분 증가량 |
| 이름 붙이기 | nifi:connection_percent_used:named — 개수·바이트 Backpressure 비율 중 큰 값에 큐·source·destination 이름을 조인 |
| 파생 지표 | nifi:processor_task_duration_avg_seconds_5m, nifi:jvm_gc_time_ratio:rate5m, nifi:thread_pool_utilization |
| 개요용 집계 | nifi:queues_near_backpressure:count, nifi:processors_invalid:count, 내장 엔드포인트 노드별 값의 클러스터 합산 |
스레드 풀 사용률은 운영에서 특히 유용했습니다. 노드별 활성 스레드를 maxTimerDrivenThreadCount로 나눈 값이라, 프로세서가 스레드를 기다리느라 처리가 밀리는 상황을 바로 보여 줍니다. 단일 노드 NiFi에서는 전체 활성 스레드로 계산해 node_id="standalone"을 붙입니다.
규모는 2.6.0에서 실측한 컴포넌트당 시계열 수(Processor 17, Connection 12, Process Group 15, 노드 39)로 산정합니다.
| 예시: Processor 2,000 · Connection 3,000 · PG 300 · 노드 3 | 값 |
|---|---|
| 시계열 | 약 107k (exporter 75k + recording rule 32k). 내장 엔드포인트를 켜면 +175k |
| 디스크 | 15일 약 19GB, 30일 약 38GB |
| NiFi 호출 | 30초당 약 7회 + 5분마다 Process Group 수만큼 |
내장 엔드포인트를 켜면 시계열이 두 배 이상이 되기 때문에, 노드별 분해가 꼭 필요할 때만 켜는 것을 권합니다.
4. 알림 24종과 억제 7종
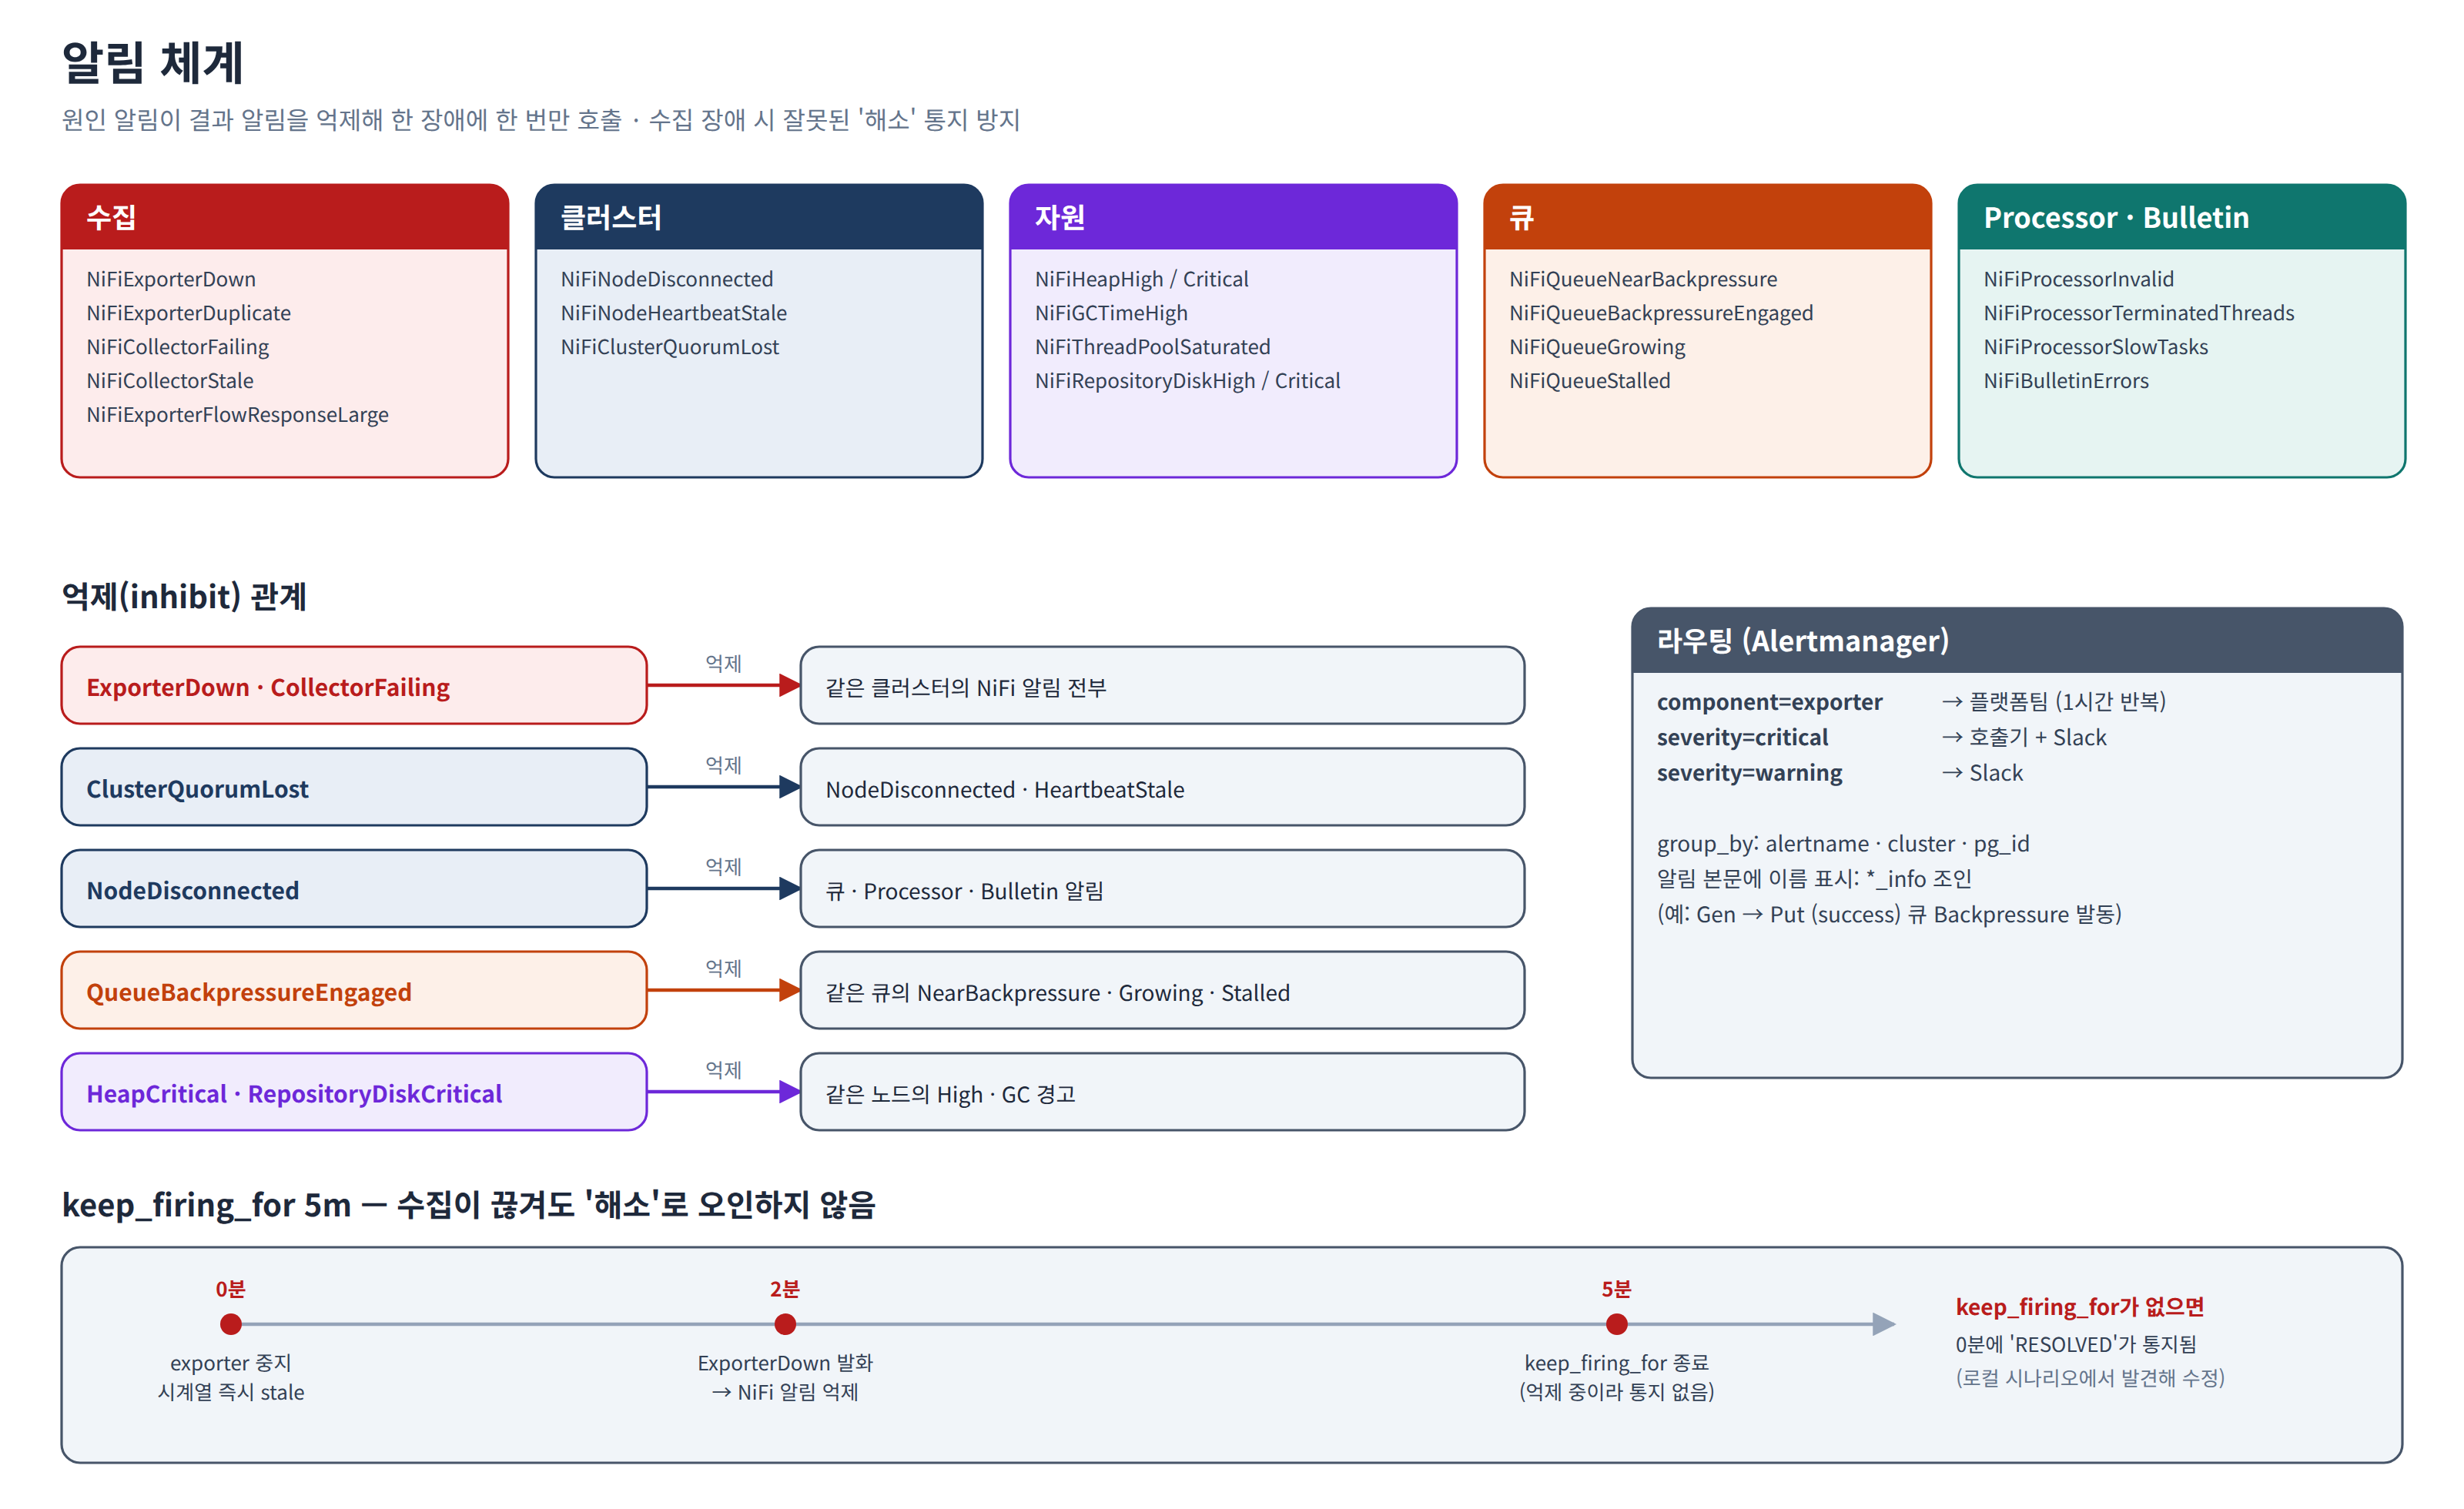
4.1 알림 목록
| 영역 | 알림 | 심각도 | 조건 (초기값) |
|---|---|---|---|
| 수집 | NiFiExporterDown | critical | 스크레이프 실패 2분 |
NiFiExporterDuplicate | critical | 한 클러스터에 exporter 2개 이상 | |
NiFiCollectorFailing | critical | collector 실패 3분 | |
NiFiCollectorStale | warning | 마지막 성공 후 주기의 3배(최소 3분) | |
NiFiExporterFlowResponseLarge | warning | flow 응답 10MB 초과 30분 | |
| 클러스터 | NiFiNodeDisconnected | critical | 노드가 CONNECTED가 아님 2분 |
NiFiNodeHeartbeatStale | warning | heartbeat 60초 초과 | |
NiFiClusterQuorumLost | critical | 연결 노드가 과반 미만 | |
| 자원 | NiFiHeapHigh / NiFiHeapCritical | warning / critical | heap 85% 10분 / 95% 3분 |
NiFiGCTimeHigh | warning | GC 시간 비율 20% 10분 | |
NiFiThreadPoolSaturated | warning | 스레드 풀 사용률 90% 이상 10분 | |
NiFiRepositoryDiskHigh / Critical | warning / critical | 저장소 80% 10분 / 92% 2분 | |
| 큐 | NiFiQueueNearBackpressure | warning | Backpressure 80% 초과 5분 |
NiFiQueueBackpressureEngaged | critical | Backpressure 100% 5분 | |
NiFiQueueGrowing | warning | 10분간 1,000개 이상 증가 | |
NiFiQueueStalled | warning | 하류가 Running인데 소비 0, 10분 | |
| 프로세서 | NiFiProcessorInvalid | warning | Invalid 5분 |
NiFiProcessorTerminatedThreads | warning | 강제 종료 스레드 존재 5분 | |
NiFiProcessorSlowTasks | warning | 평균 task 30초 초과 10분 | |
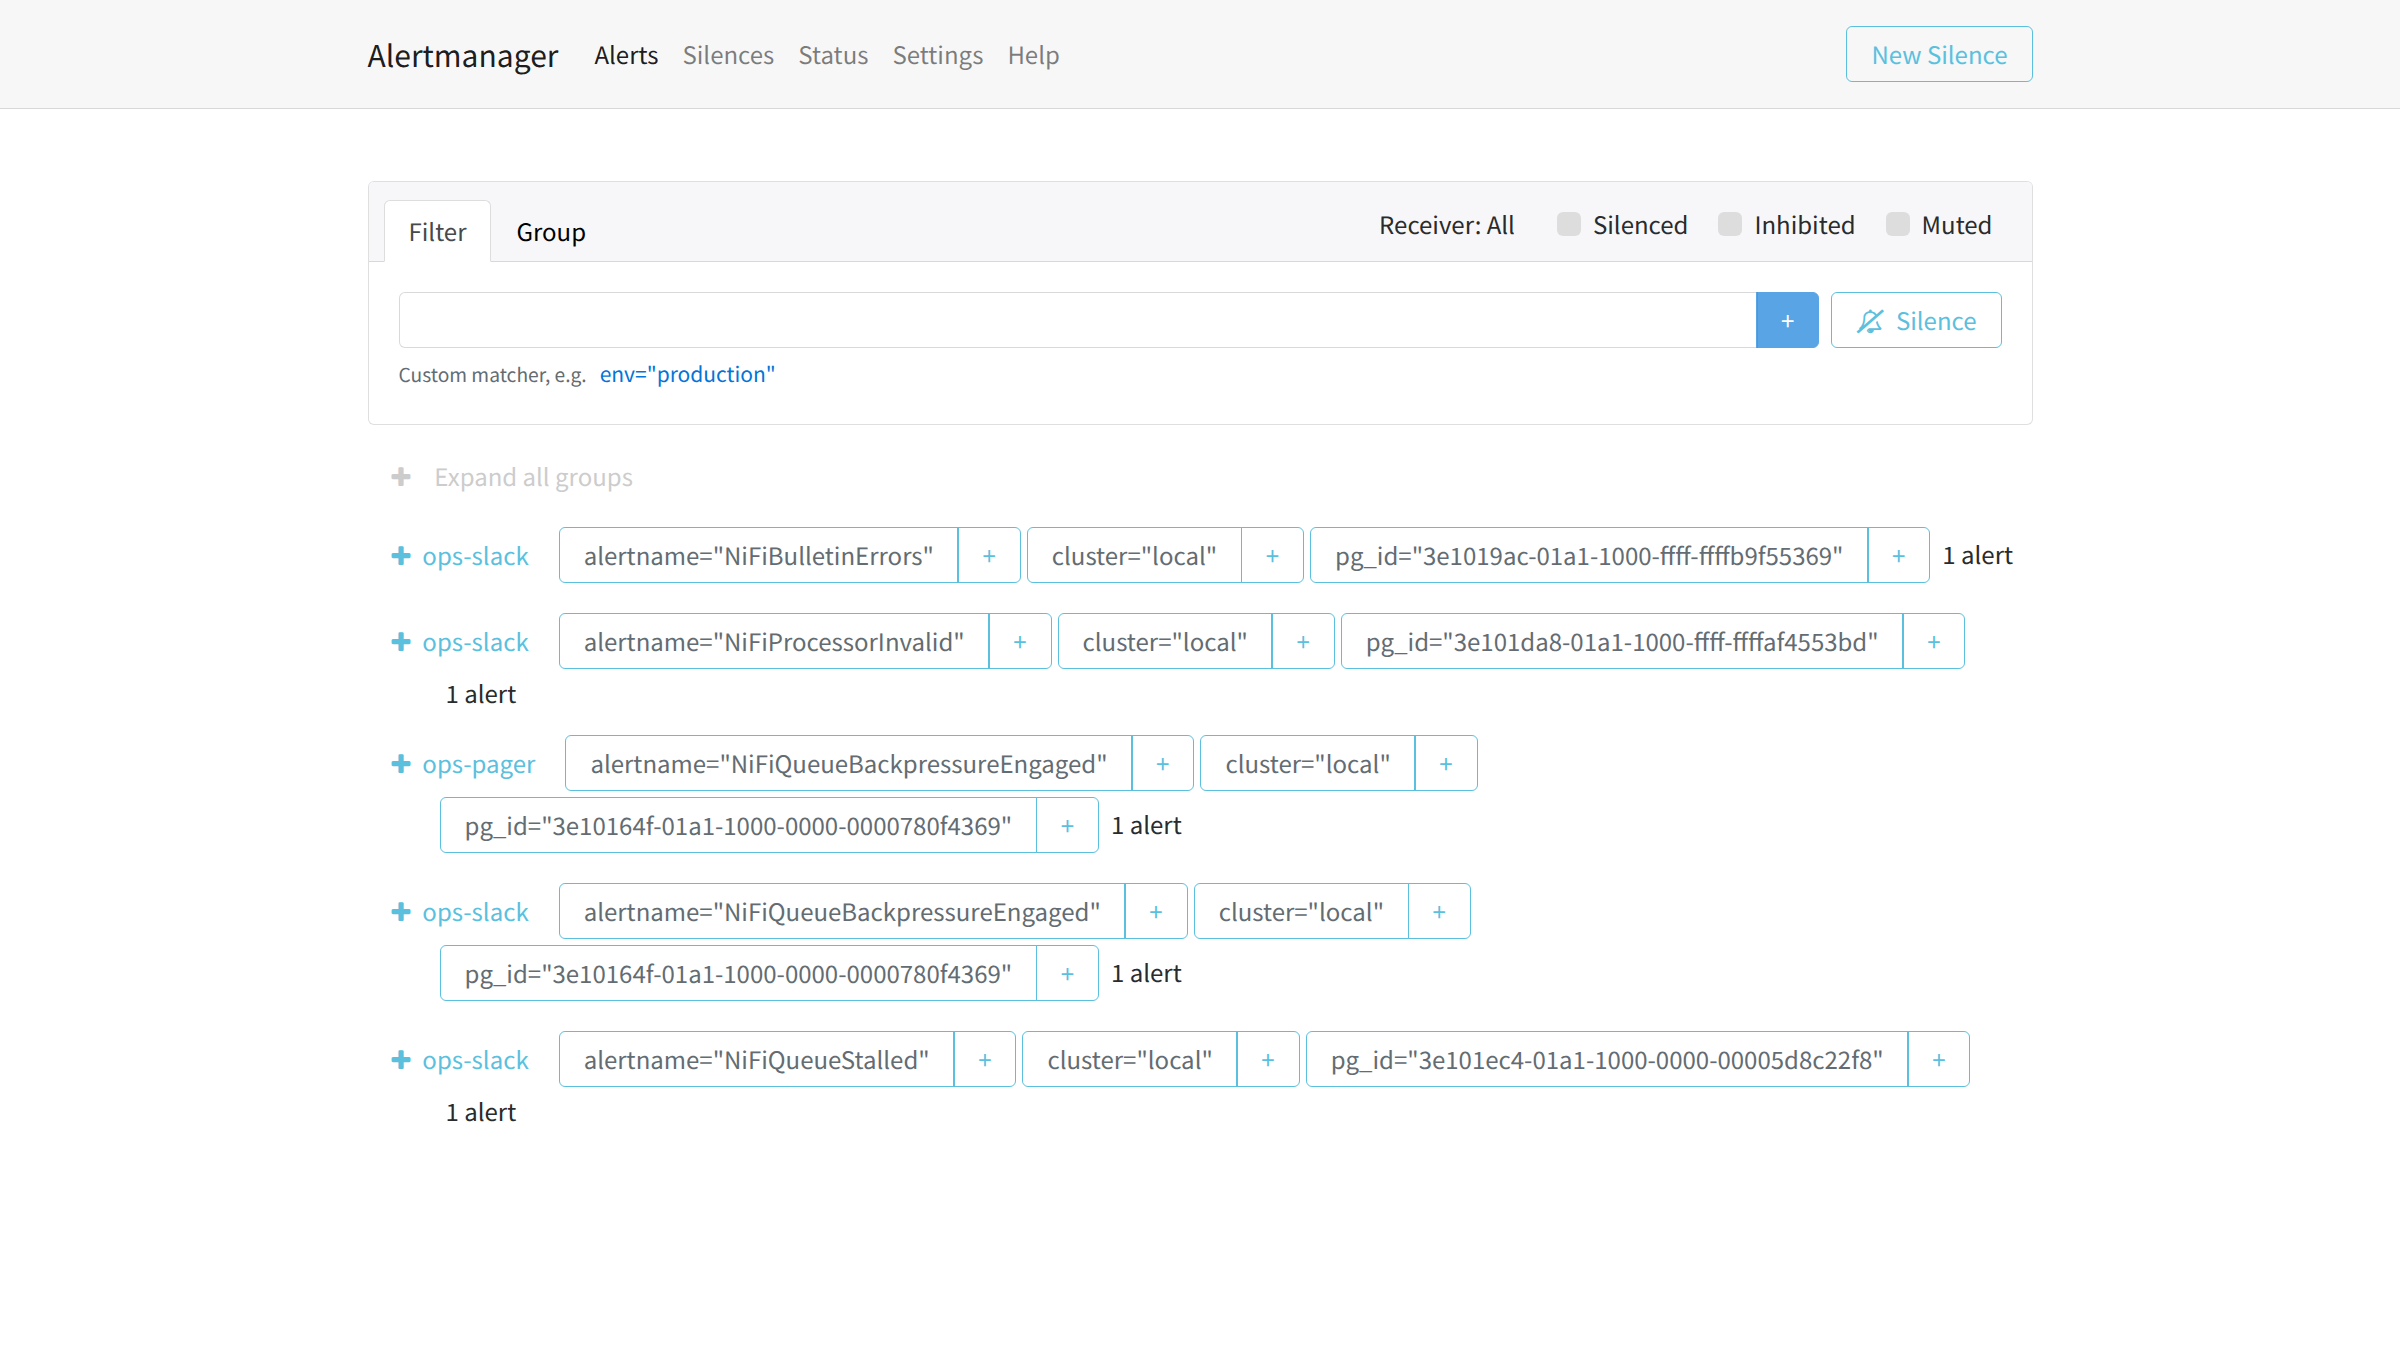
| Bulletin | NiFiBulletinErrors | warning | 한 source에서 5분간 ERROR 10건 초과 |
| 중계 | NiFiAlertRelayDown / Failing | warning | 중계 서비스 다운 5분 / 최근 15분 전송 실패 |
큐 정체 알림은 앞에서 만든 조인을 그대로 씁니다.
- alert: NiFiQueueStalled
  expr: |
    (
      nifi_connection_queued_flowfiles > 0
      and nifi_connection_flowfiles_out_5m == 0
      and on (cluster, connection_id) nifi:connection_destination_running == 1
    )
    * on (cluster, connection_id) group_left (name, source_name, destination_name)
    nifi_connection_info
  for: 10m
  keep_firing_for: 5m
알림 메시지에는 source_name → destination_name (큐 이름)이 들어가므로, 받는 사람이 id를 들고 NiFi 화면을 뒤질 필요가 없습니다.
4.2 원인이 결과를 억제한다
장애 하나가 알림 수십 개로 번지면 정작 원인 알림이 묻힙니다. Alertmanager 억제 규칙 7종으로 원인 알림이 떠 있는 동안 결과 알림을 막습니다.
| 발화 중인 알림 | 억제되는 알림 |
|---|---|
NiFiExporterDown, NiFiCollectorFailing | 같은 클러스터의 exporter 외 모든 알림 |
NiFiNodeDisconnected | 같은 클러스터의 큐·프로세서·Bulletin 알림 |
NiFiClusterQuorumLost | NiFiNodeDisconnected, NiFiNodeHeartbeatStale |
NiFiQueueBackpressureEngaged | 같은 큐의 NearBackpressure, Growing, Stalled |
NiFiHeapCritical | 같은 노드의 NiFiHeapHigh, NiFiGCTimeHigh |
NiFiRepositoryDiskCritical | 같은 저장소의 NiFiRepositoryDiskHigh |
NiFiCollectorFailing | 같은 collector의 NiFiCollectorStale |
첫 번째 규칙이 핵심입니다. 수집이 끊기면 NiFi 상태를 모르는 것이지 정상인 것이 아니므로, 빠지거나 일부만 남은 데이터로 사람을 깨우지 않습니다.
4.3 keep_firing_for로 거짓 "해소"를 막는다
수집이 잠깐 끊기면 알림 조건식의 입력 시계열이 사라지고, Prometheus는 이를 "조건이 풀렸다"로 보고 RESOLVED를 보냅니다. 그 직후 수집이 돌아오면 다시 FIRING이 나갑니다. 당직자 입장에서는 최악의 잡음입니다.
NiFi 상태 알림에는 모두 keep_firing_for: 5m을 걸어 조건이 사라진 뒤에도 5분간 firing을 유지합니다. 대가로 실제 해소 통지가 최대 5분 늦어지지만, 잘못된 해소보다는 낫다고 판단했습니다. 이 기능 때문에 Prometheus 2.42 이상이 필요합니다.
4.4 라우팅
| 순서 | 대상 | 조건 |
|---|---|---|
| 1 | custom-relay (알림 중계) | 모든 알림. 대상별 필터는 중계 설정에서 (continue: true) |
| 2 | 플랫폼팀 메일 | component="exporter" (수집 장애) |
| 3 | 호출기 + Slack | severity="critical" |
| 4 | Slack | severity="warning" |
수집 장애는 NiFi 운영자가 아니라 모니터링을 운영하는 플랫폼팀의 일이므로 따로 보냅니다. 임계치는 모두 초기값 이며, 운영 2주 데이터를 보고 조정한 뒤 Runbook의 "임계치 조정 기록"에 남기도록 했습니다.
5. Grafana 대시보드 6종
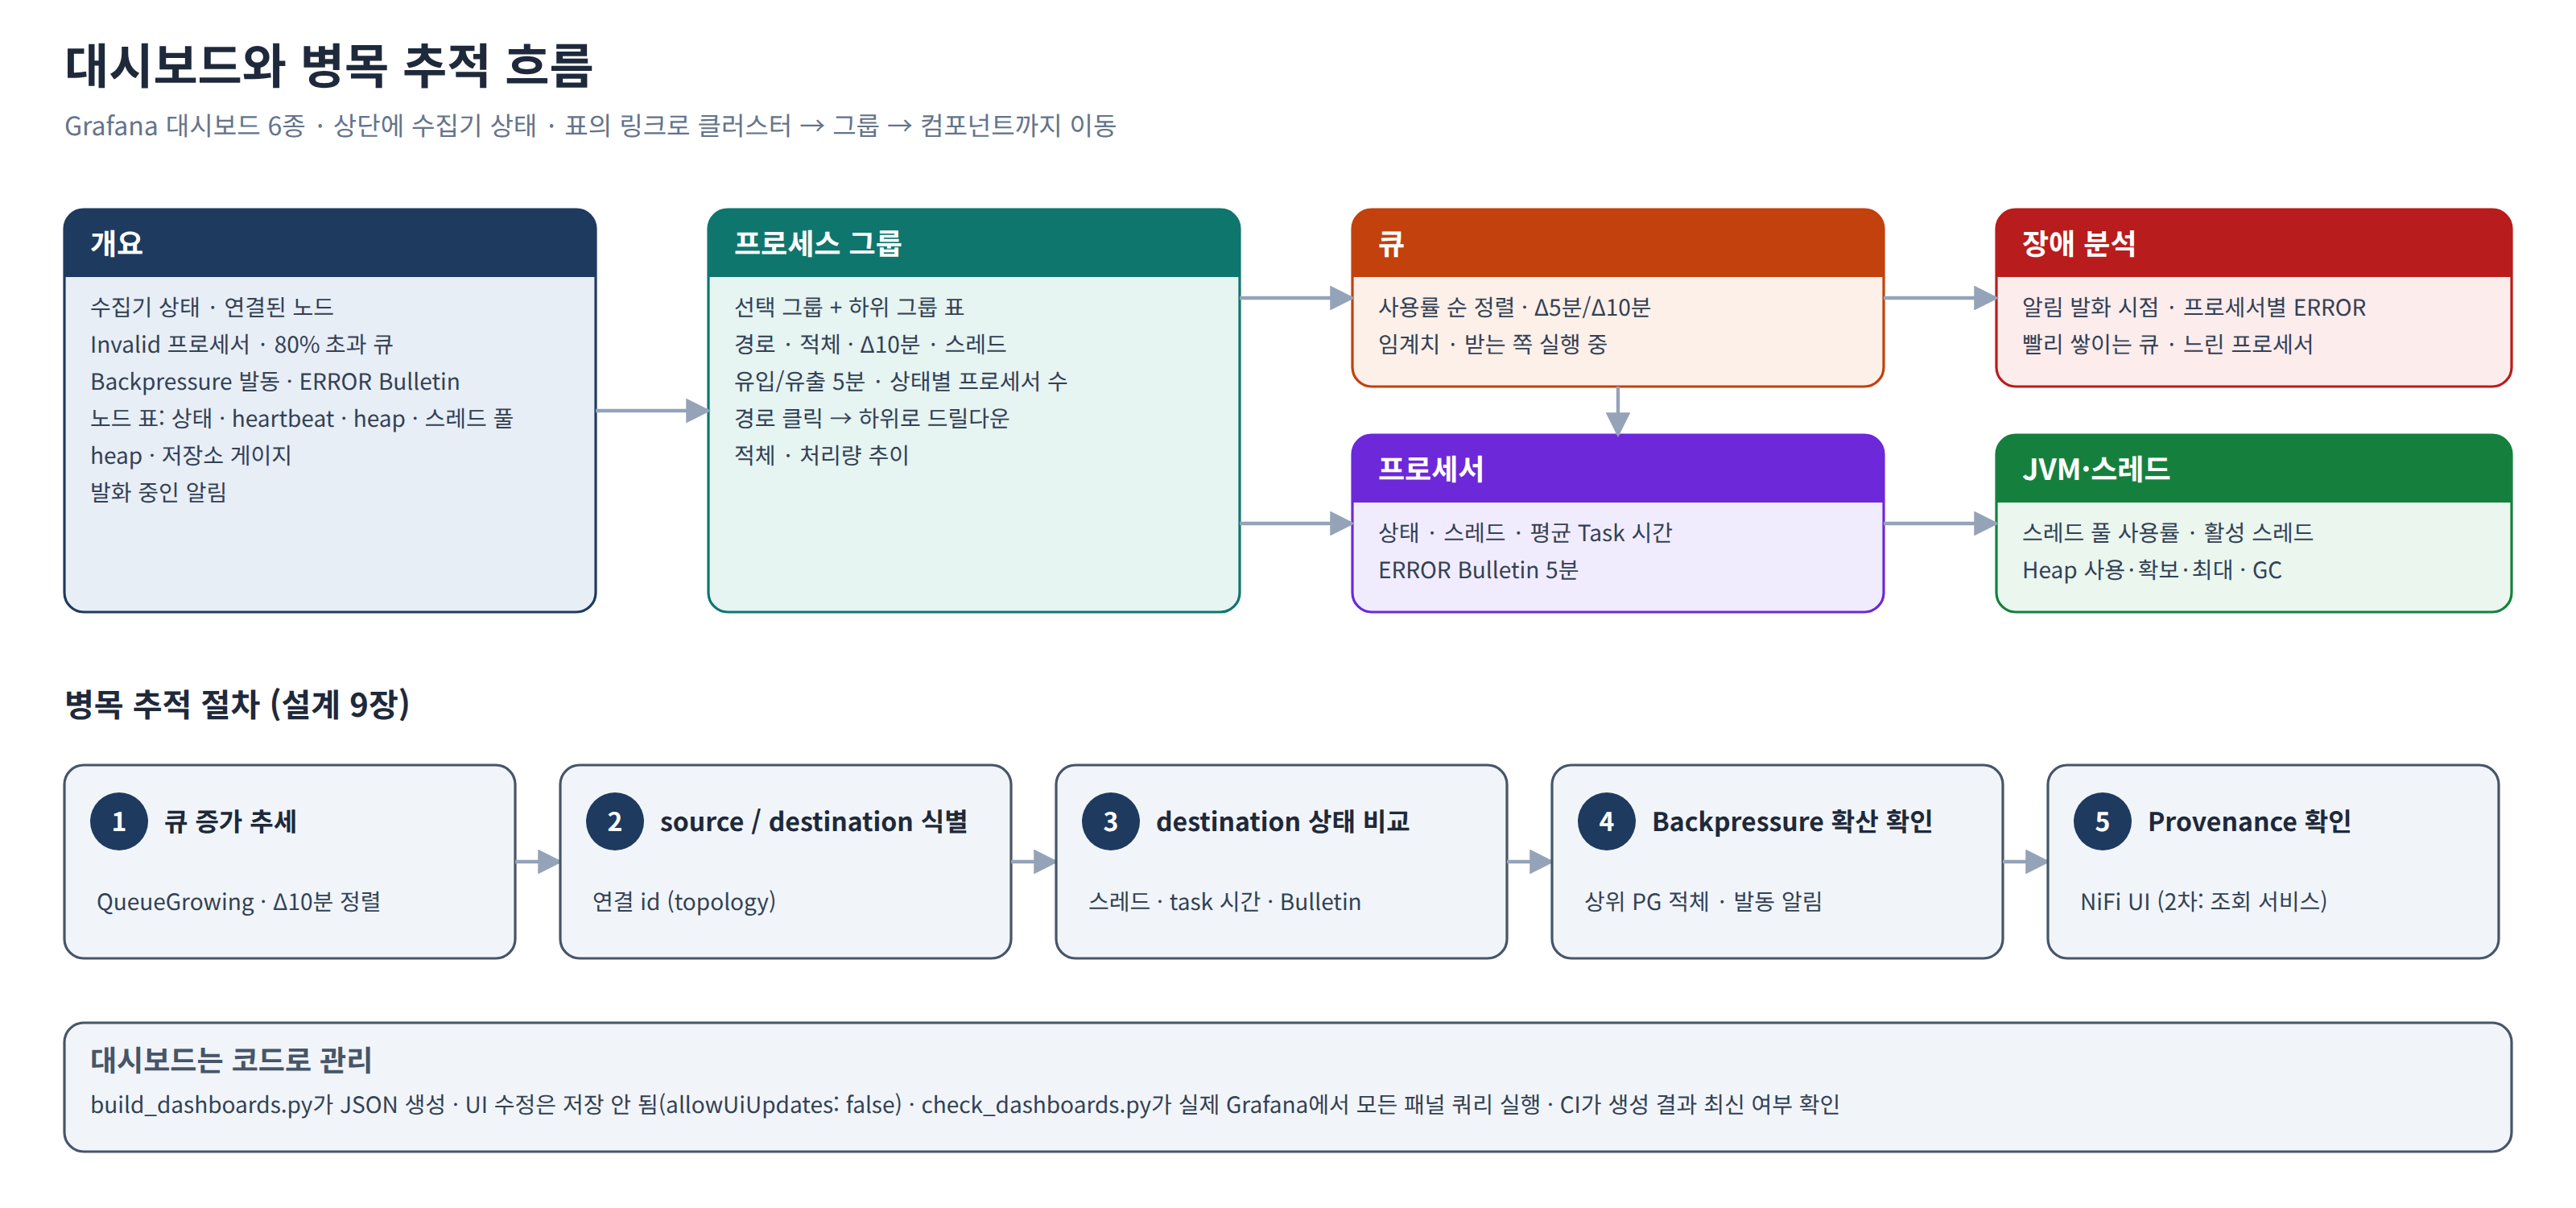
| 대시보드 | 내용 |
|---|---|
| 개요 | 수집 상태, 연결 노드 수, Invalid 프로세서, 80% 초과 큐, Backpressure 발동, ERROR Bulletin, 노드 표(상태·heartbeat·스레드·적체·heap·저장소·스레드 풀·가동 시간), 발화 중인 알림 |
| 프로세스 그룹 | 선택한 그룹과 하위 그룹 표(경로·적체·Δ10m·스레드·입출력·상태별 프로세서 수). 경로를 클릭하면 하위로 이동 |
| 프로세서 | 상태·스레드·평균 task 시간·입출력·ERROR Bulletin 표와 프로세서별 추이 |
| 큐 | Backpressure 사용률 순 큐 표(Δ5m·Δ10m·임계치·하류 Running 여부)와 큐별 추이 |
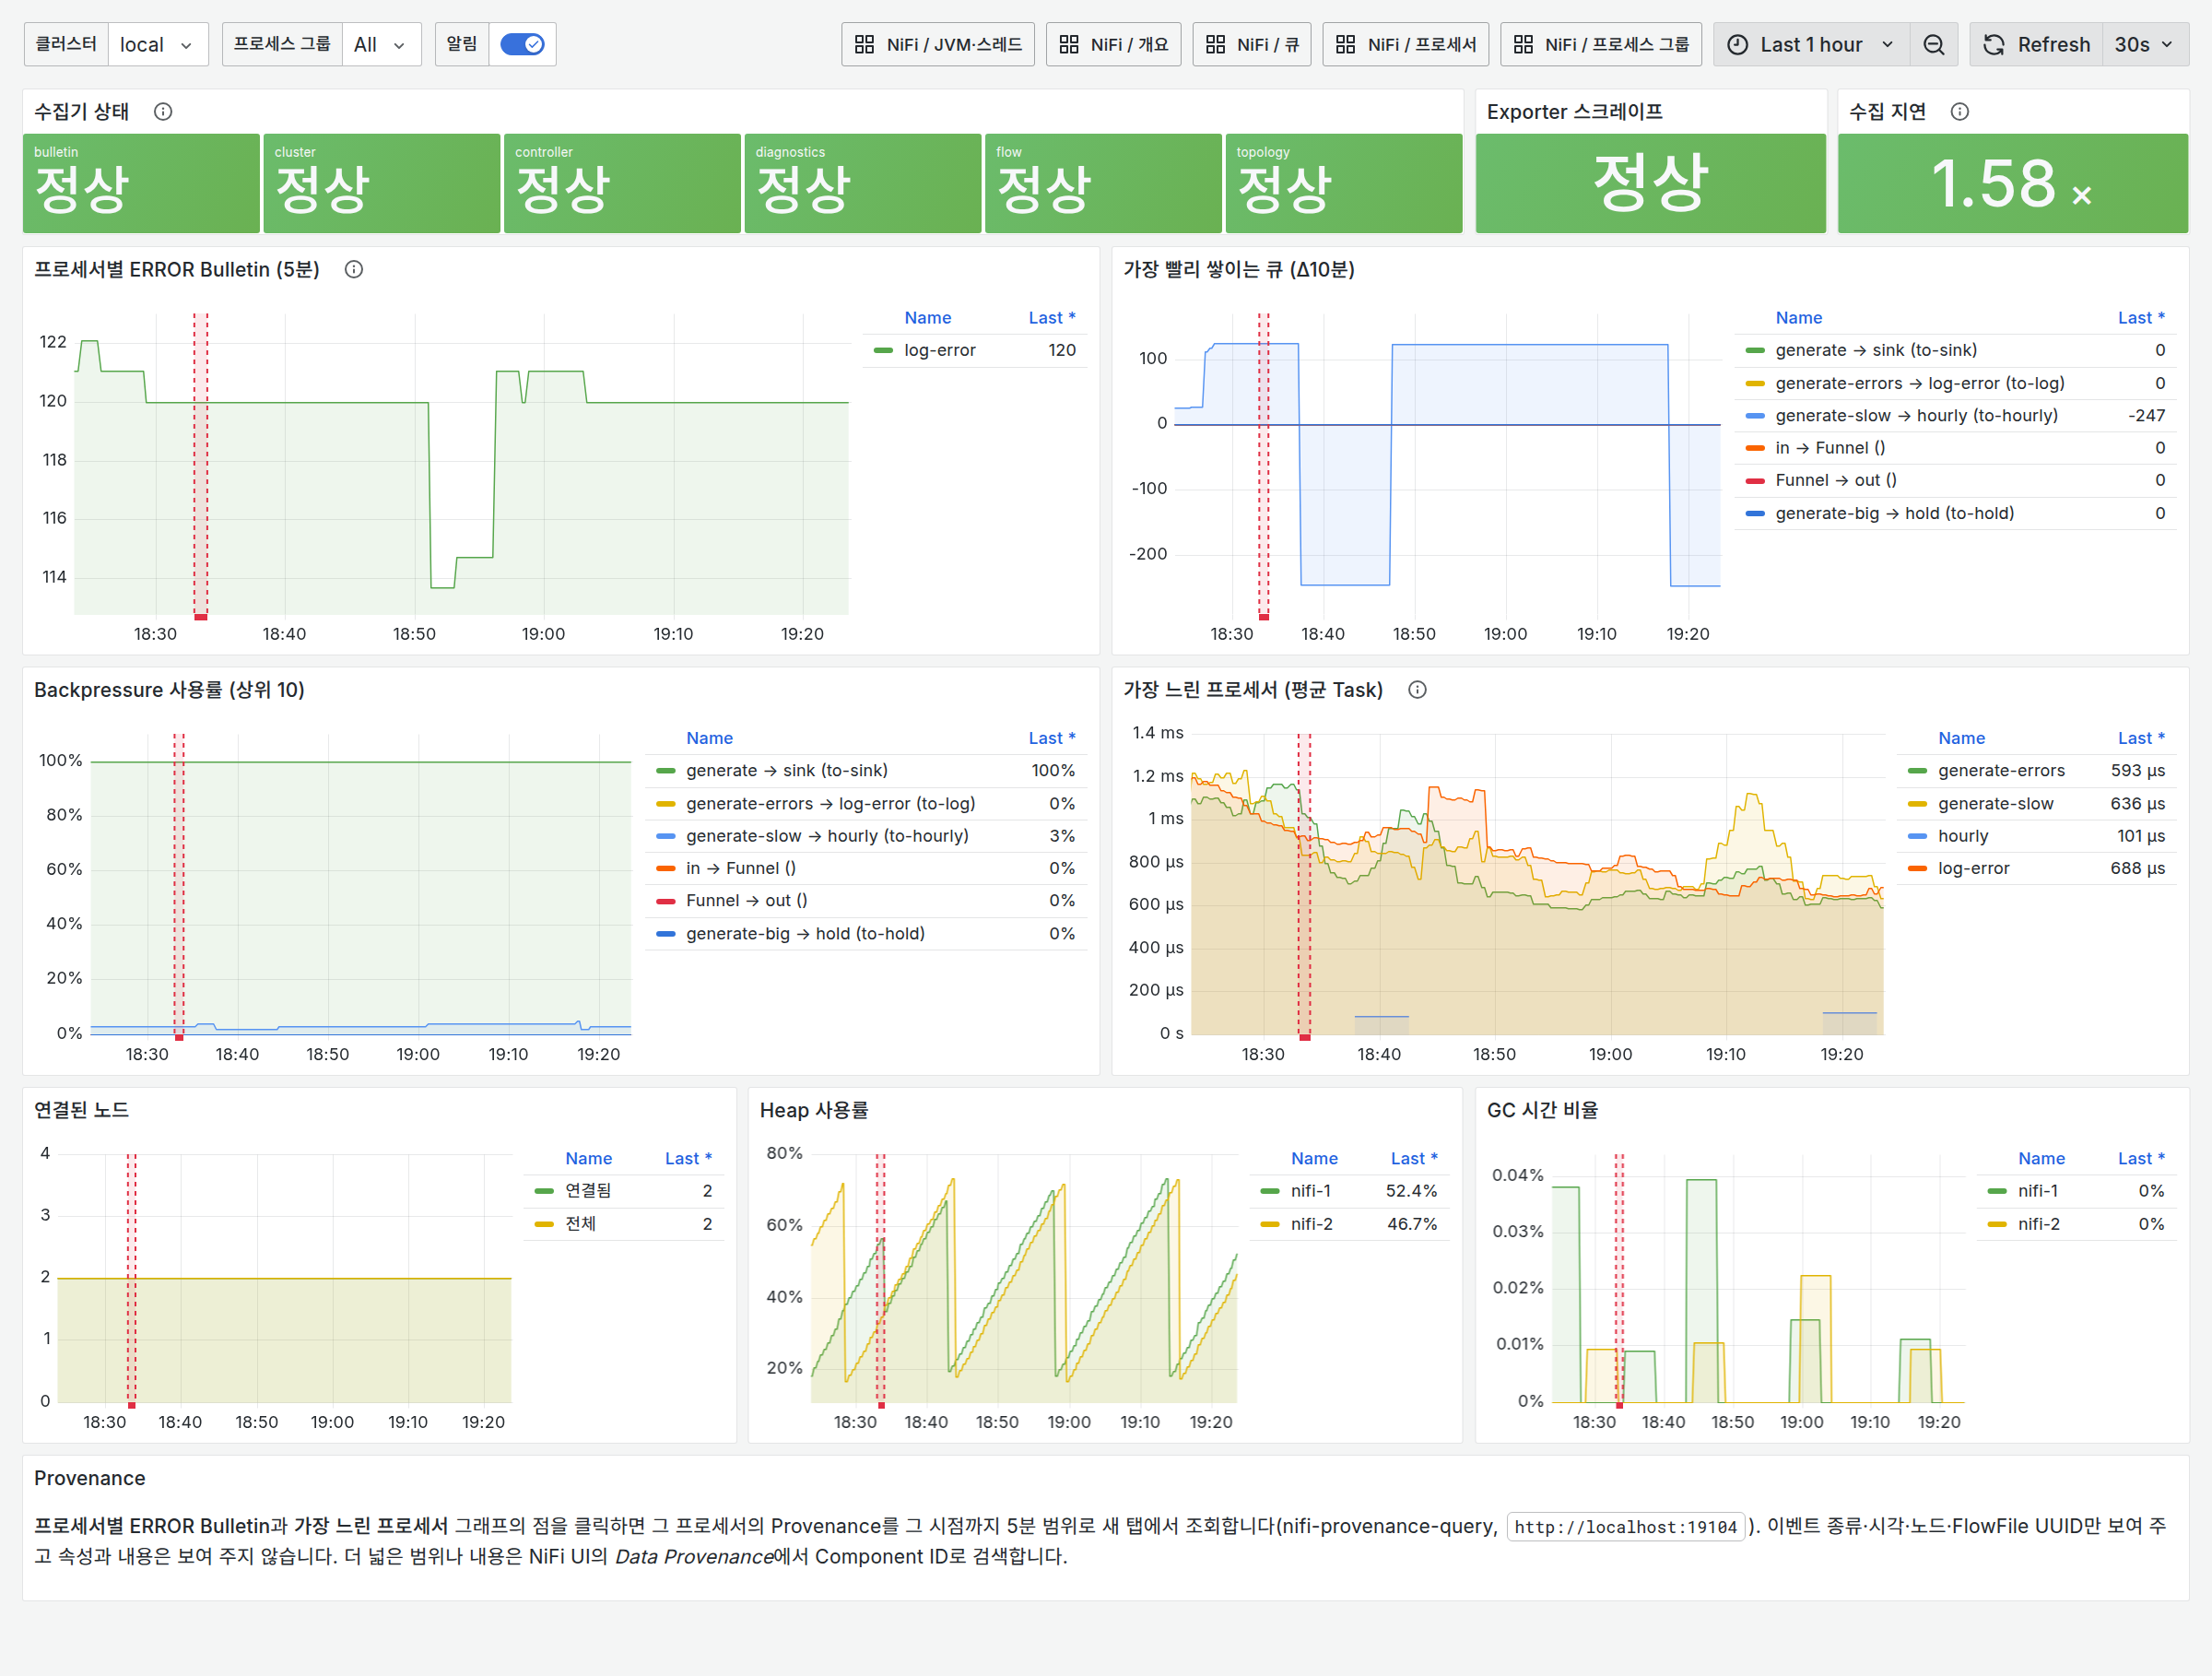
| 장애 분석 | 알림 발화 시점 표시, 프로세서별 ERROR, 빨리 쌓이는 큐, 느린 프로세서, 노드·heap·GC 추이 |
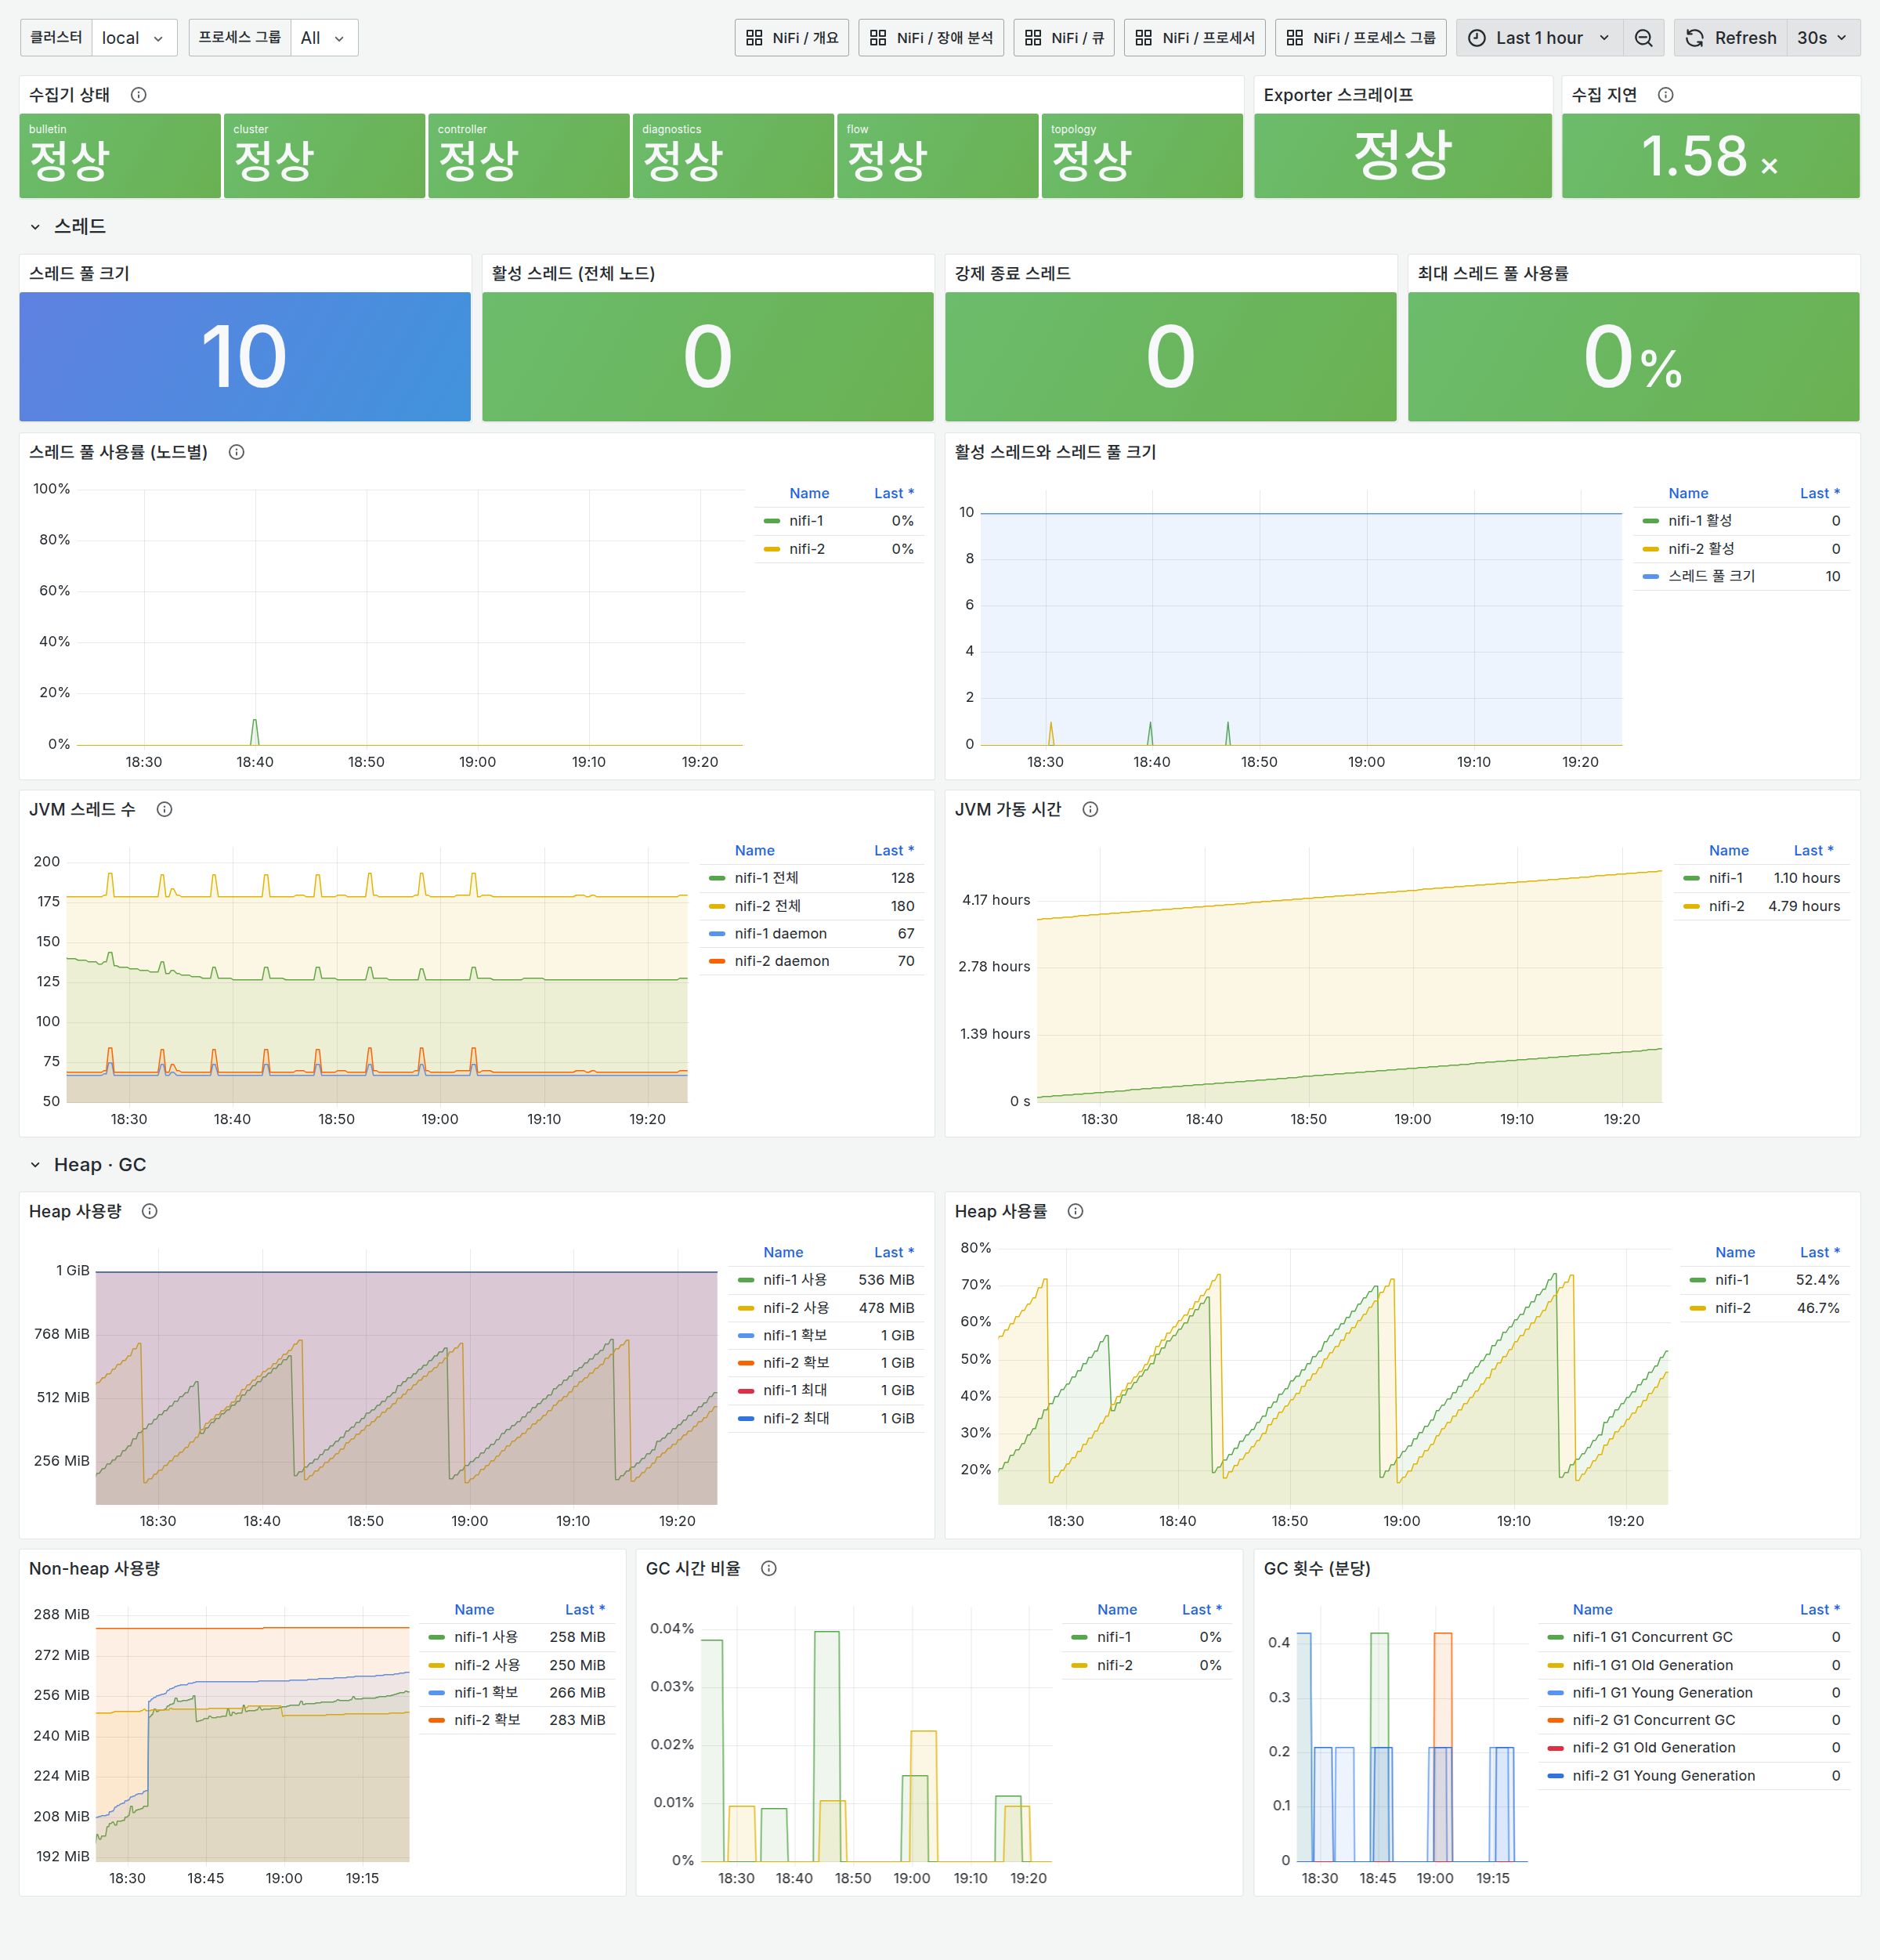
| JVM·스레드 | 스레드 풀 크기·활성·강제 종료, 노드별 스레드 풀 사용률, heap·non-heap, GC 시간 비율 |
설계 원칙은 세 가지입니다.
- 모든 화면 상단에 collector 상태가 있습니다. FAIL이면 그 화면의 값은 미수집이라는 뜻입니다.
- 표의 이름을 클릭하면 아래 단계로 내려갑니다. 클러스터 → Process Group → Processor/Queue 순서로 원인을 좁힙니다.
- 대시보드는 코드로 관리합니다.
build_dashboards.py가 JSON을 생성하고, provisioning은allowUiUpdates: false라 UI에서 고친 내용은 저장되지 않습니다. CI가 생성 결과가 최신인지 확인하고,check_dashboards.py가 실제 Grafana에서 모든 패널 쿼리를 실행해 봅니다.
아래는 로컬 검증 스택에서 테스트 플로우를 돌린 상태의 화면입니다.
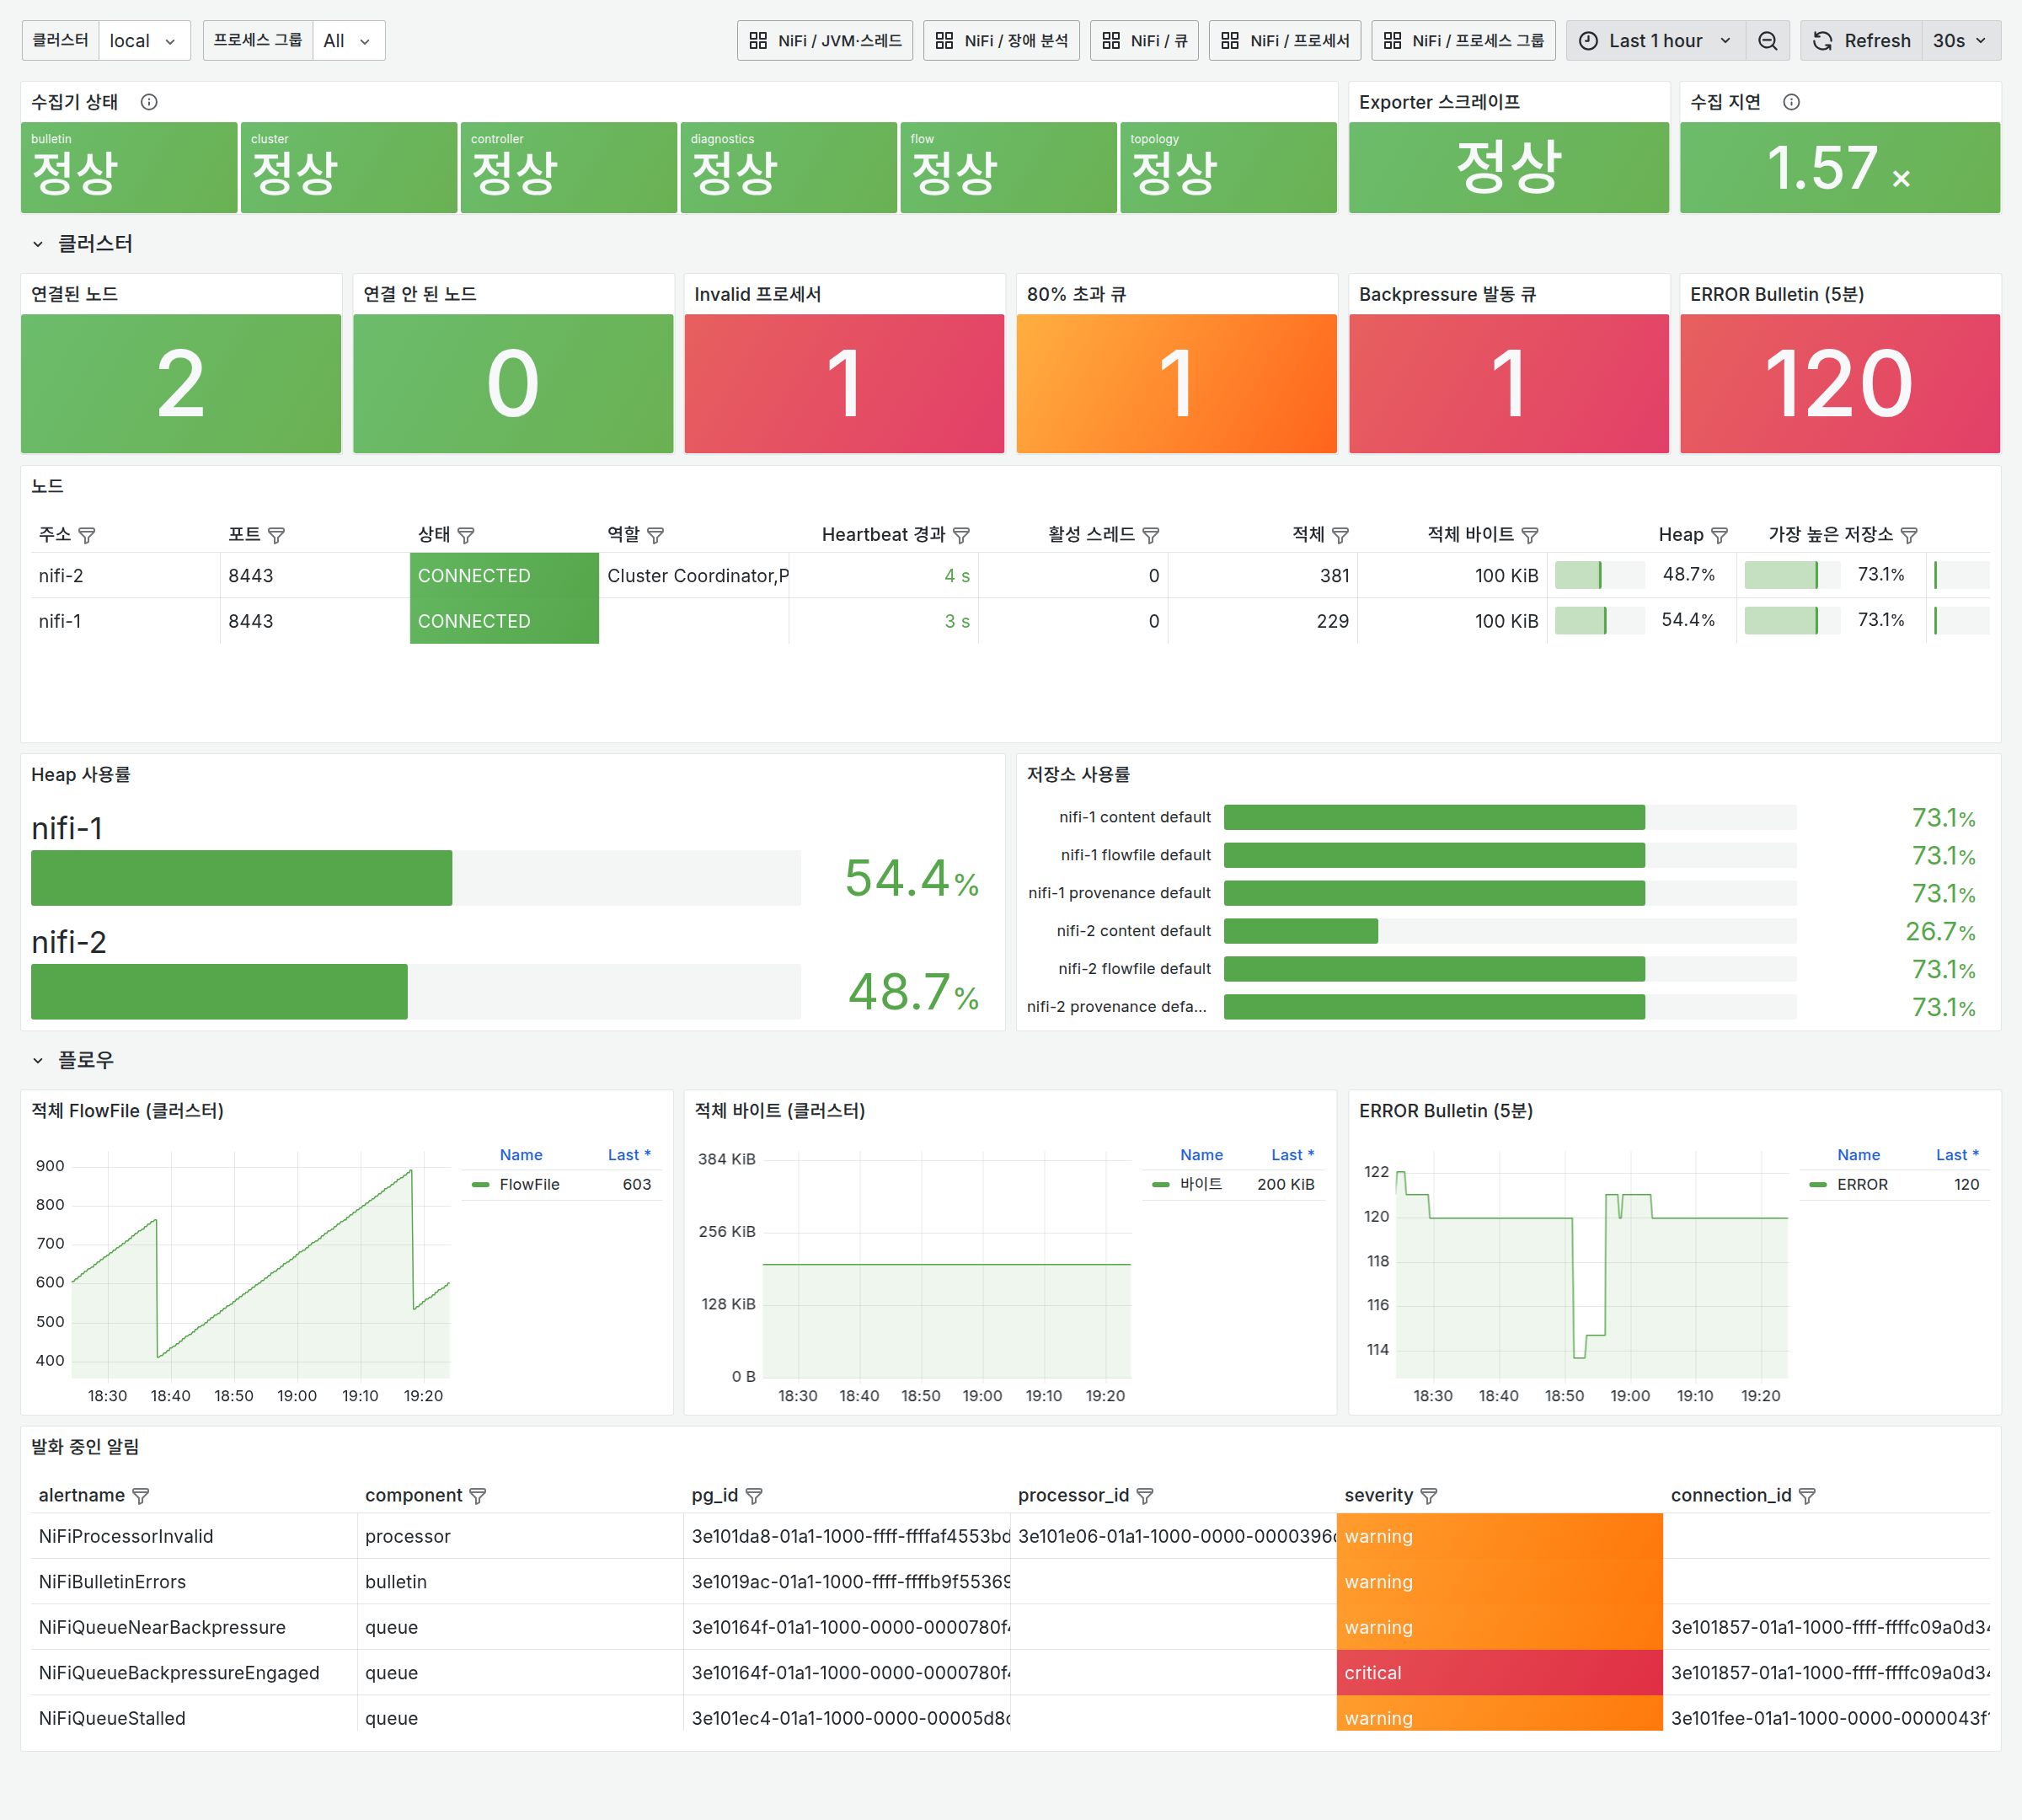
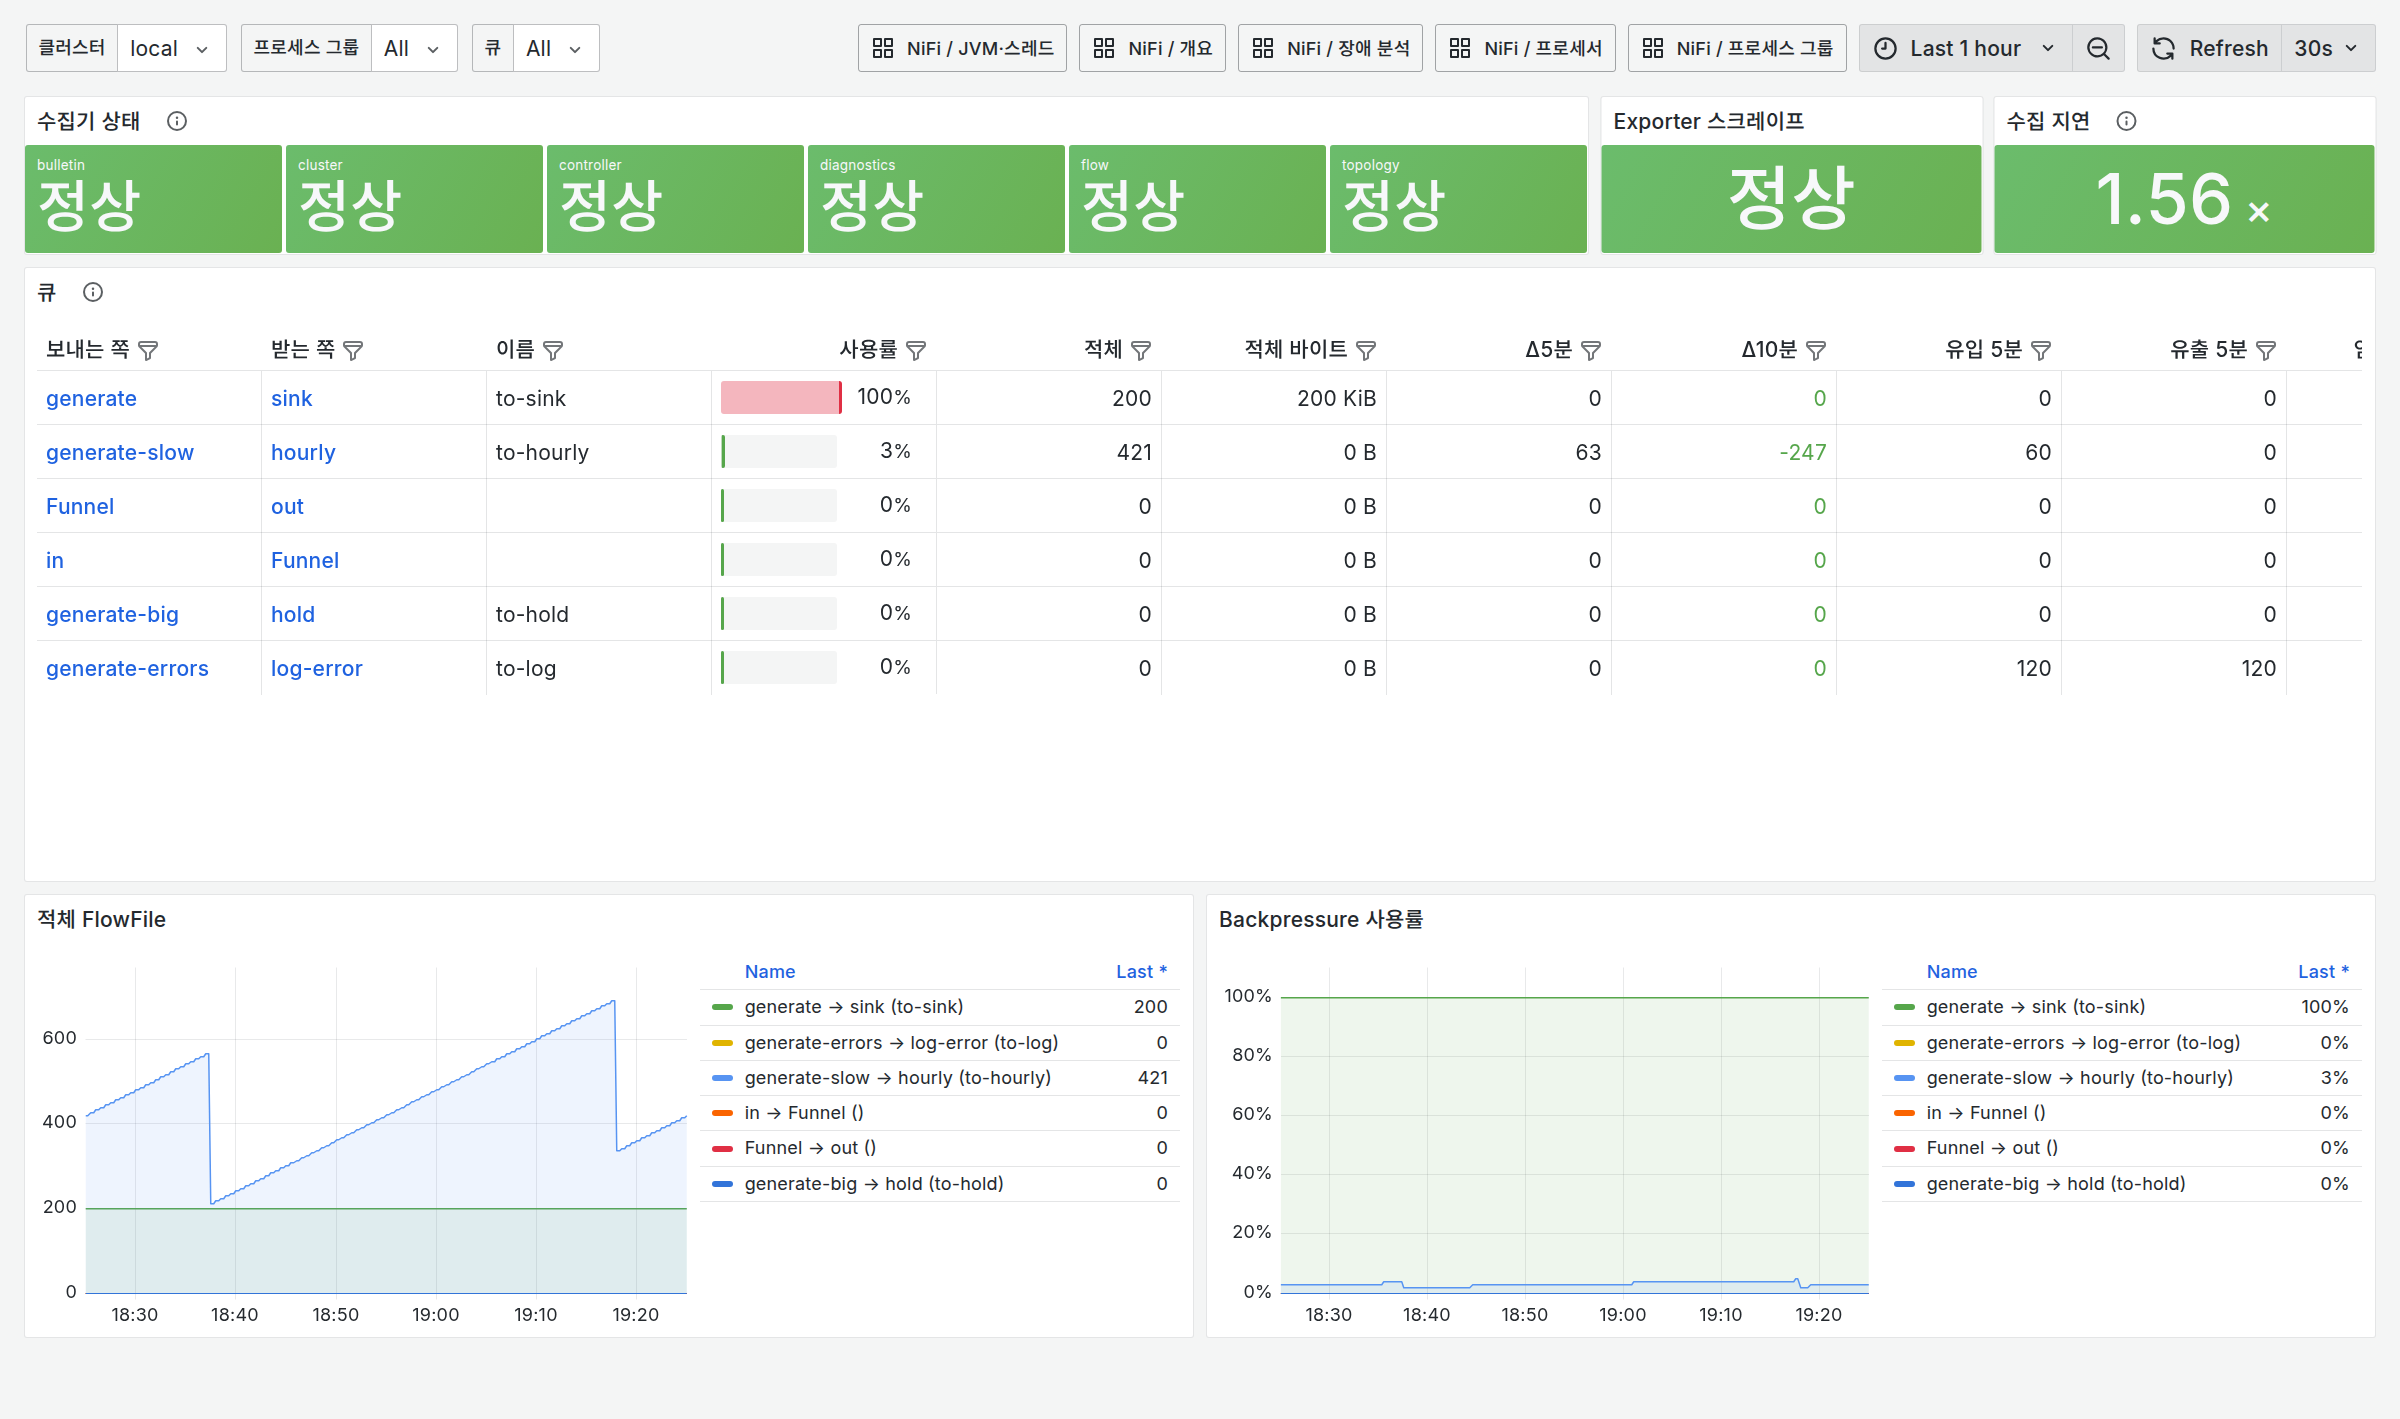
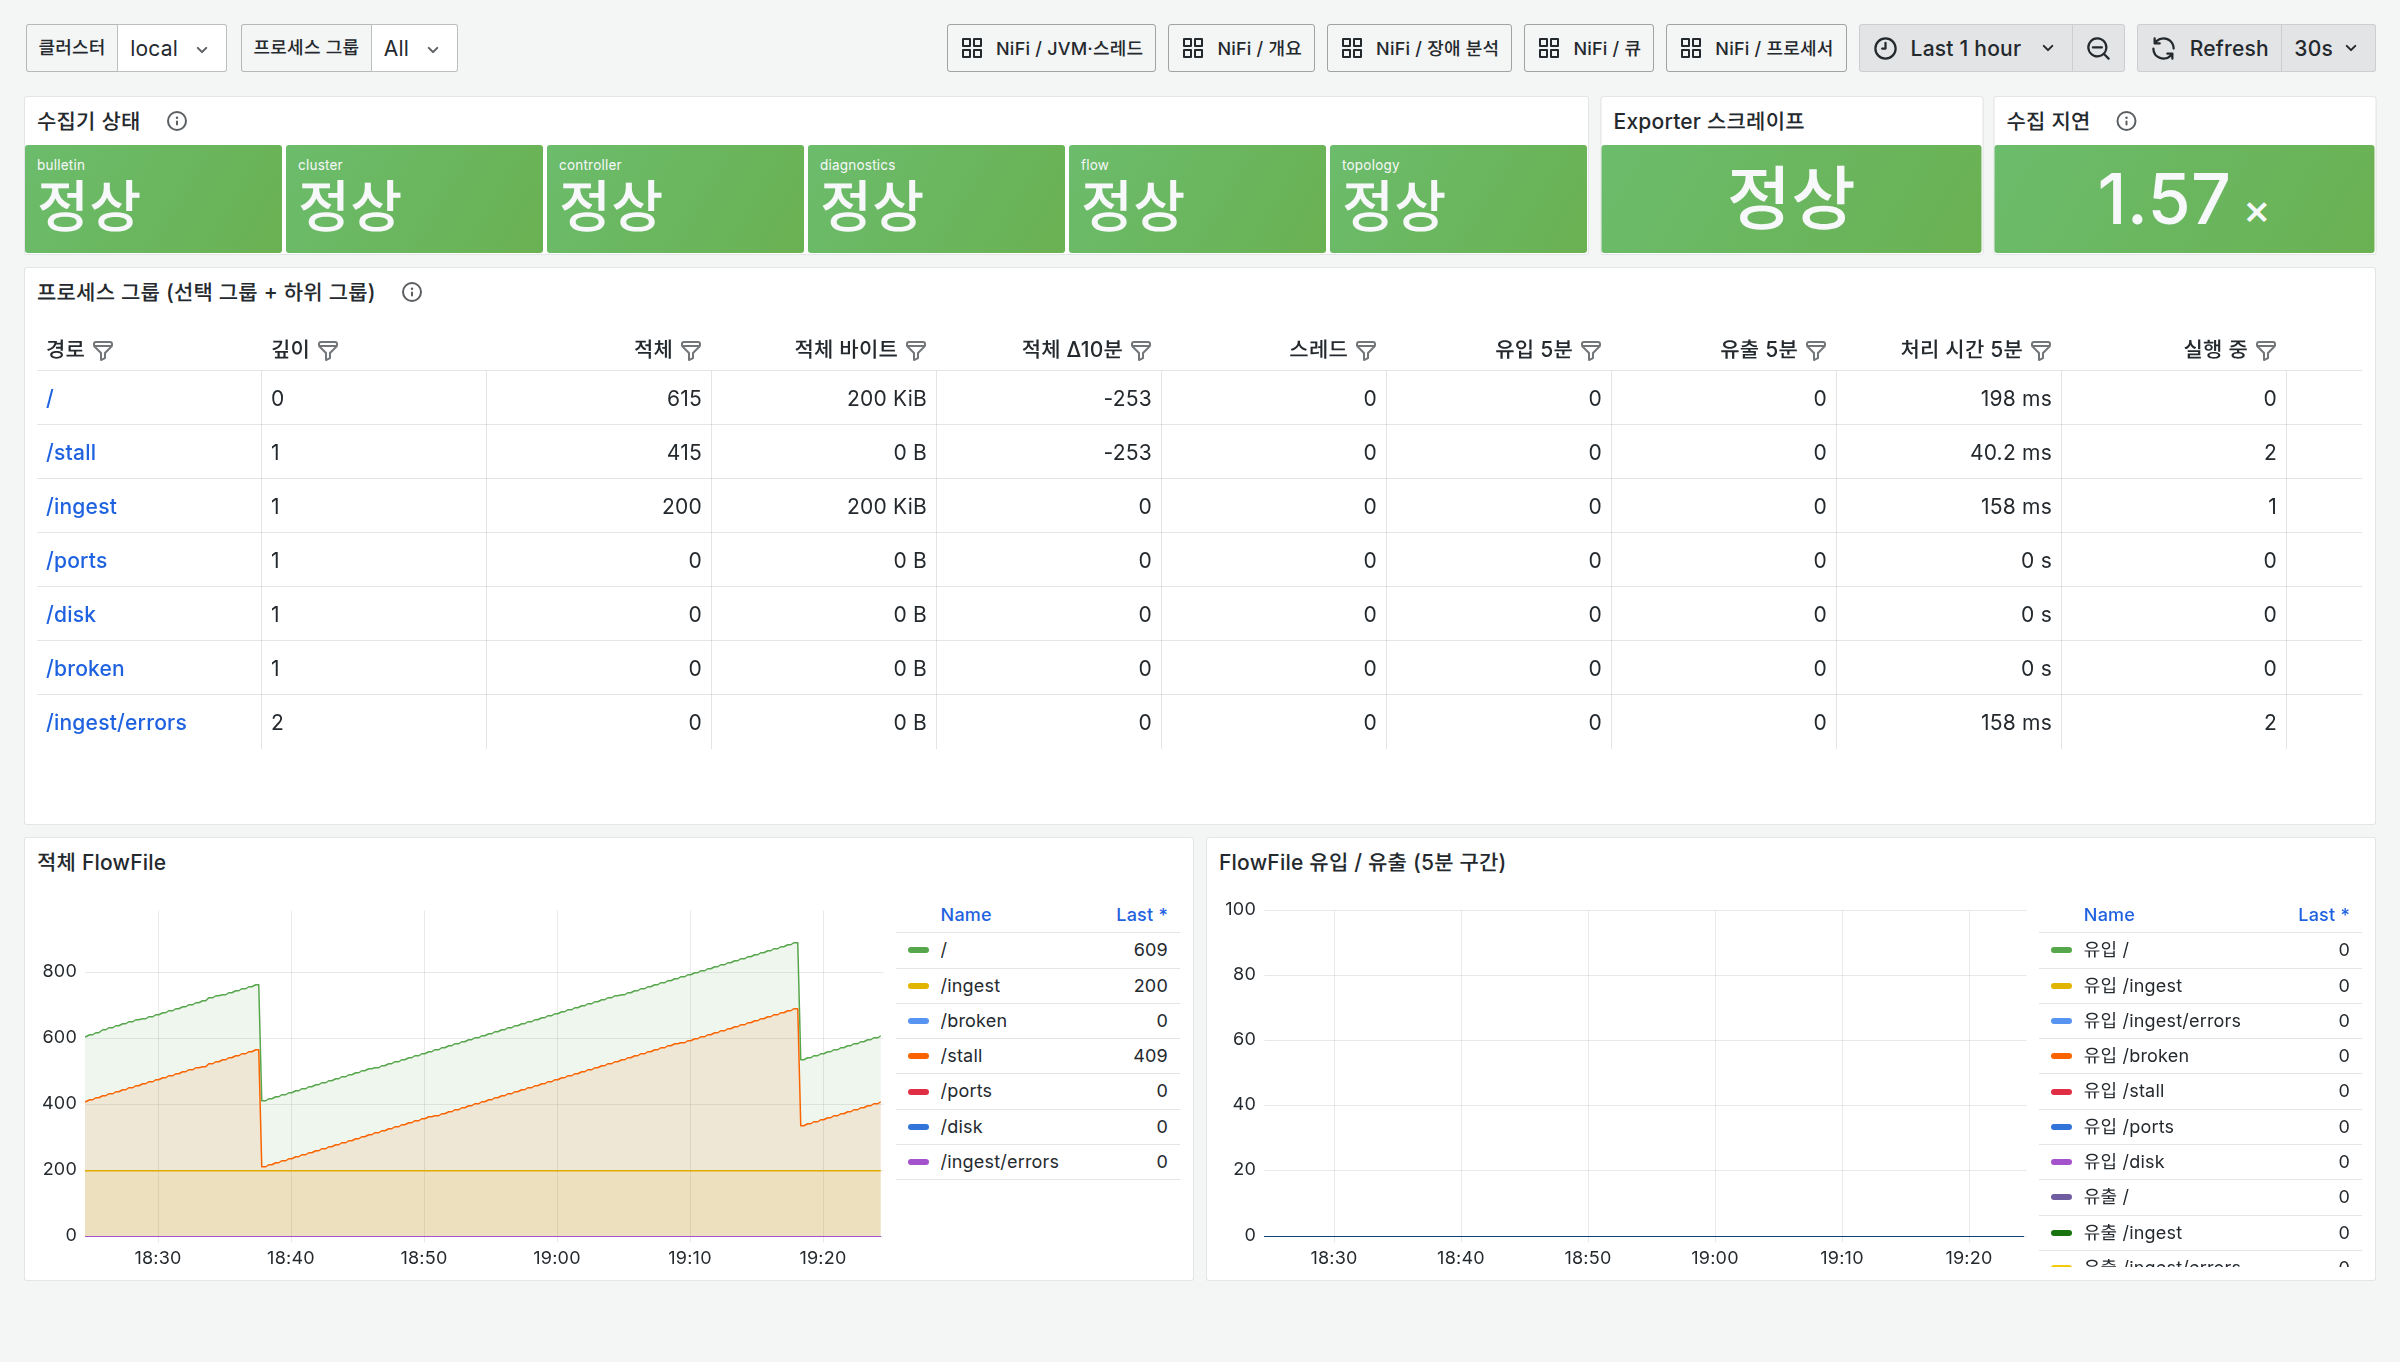
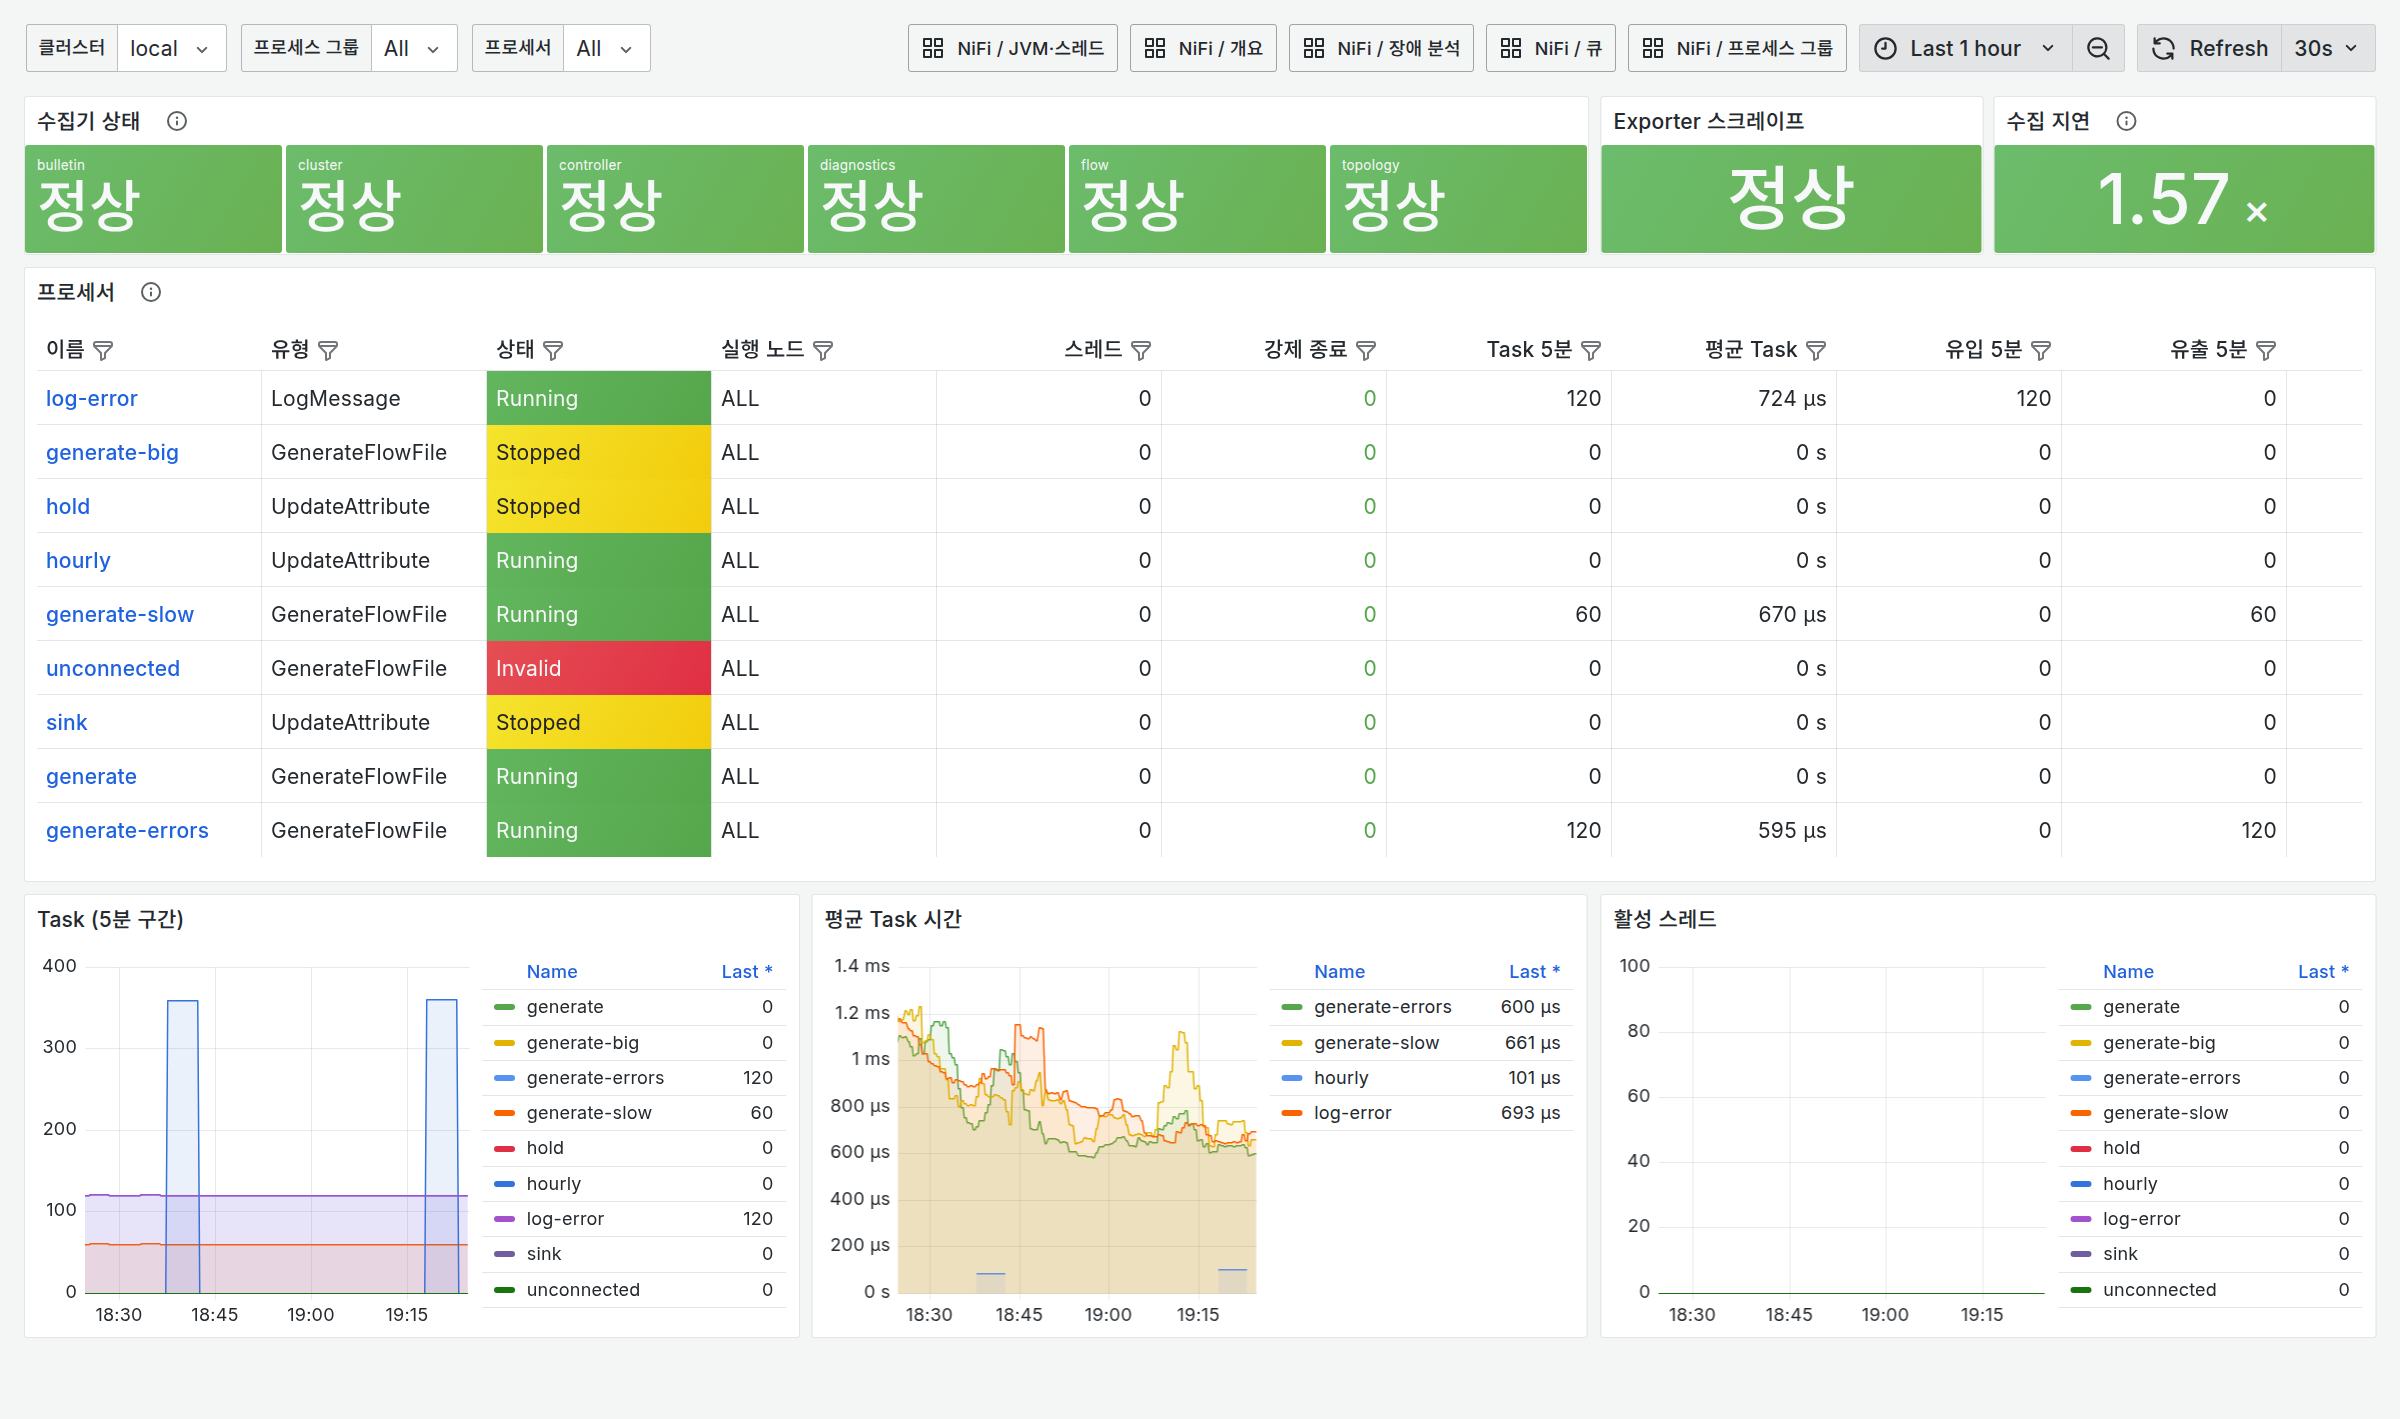
장애 분석 대시보드에는 알림이 발화한 시점이 빨간 점선으로 표시되어, 그 시점 전후로 어떤 큐가 쌓이고 어떤 프로세서가 느려졌는지를 한 화면에서 비교할 수 있습니다.
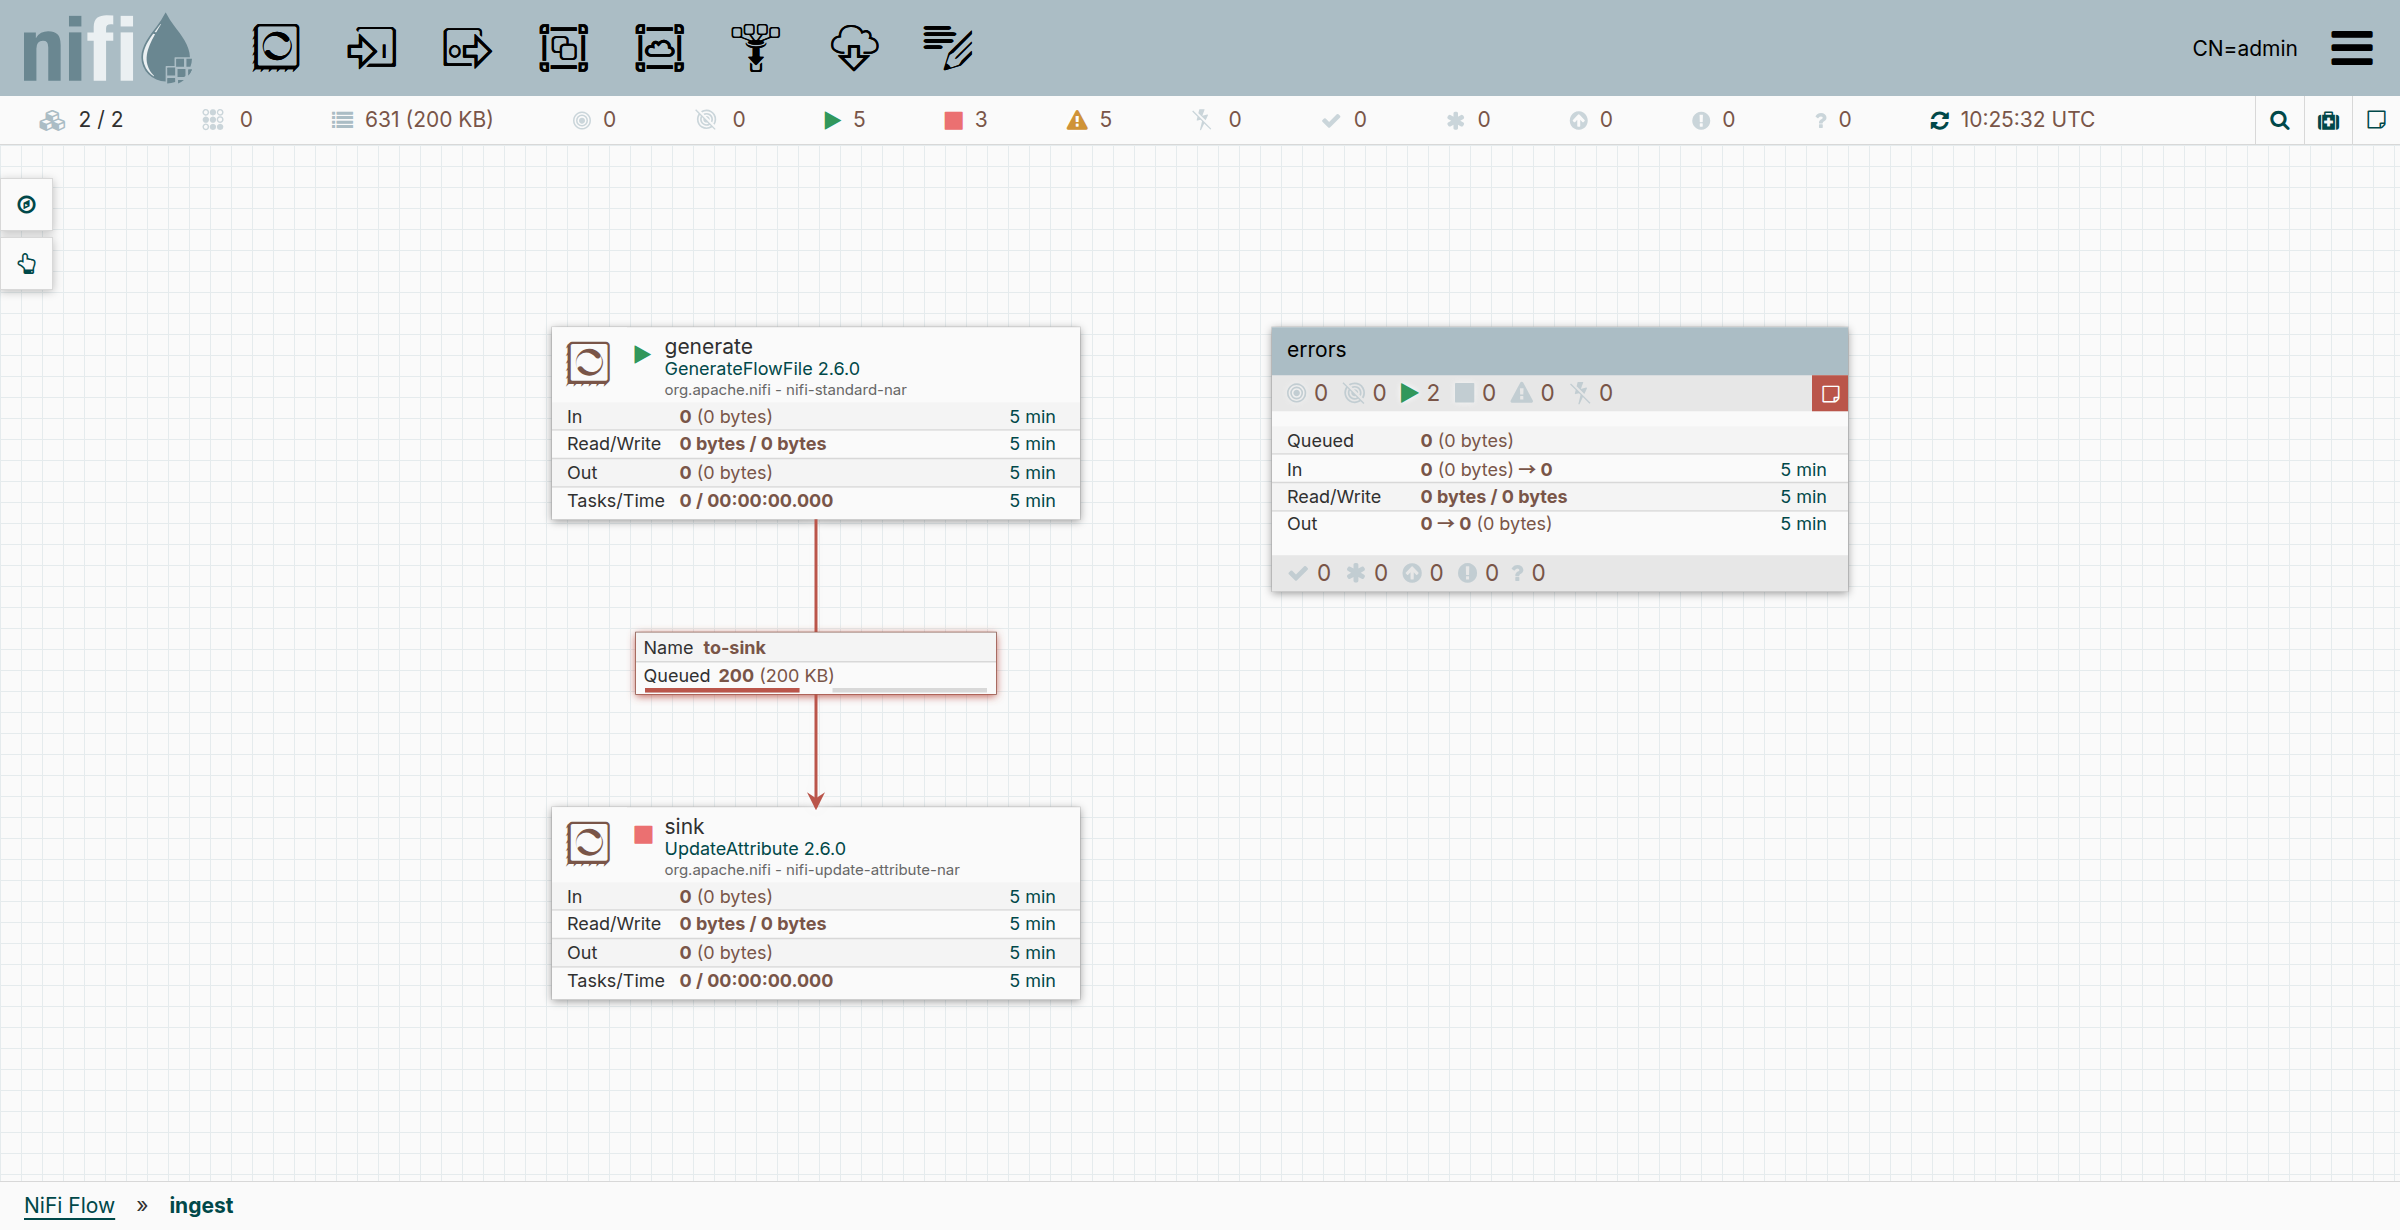
대시보드 값이 NiFi 화면과 어떻게 대응하는지도 같은 시점에 캡처해 확인했습니다. 예를 들어 아래 ingest 그룹에서 to-sink 큐가 Backpressure 임계치에 도달(빨간색)하고 하류 sink가 정지된 상태는, 큐 대시보드의 사용률 100%와 NiFiQueueBackpressureEngaged 알림으로 나타납니다.
6. Provenance 클릭 조회
메트릭은 "어디가 이상한가"까지는 알려 주지만 "어떤 FlowFile에 무슨 일이 있었나"는 알려 주지 못합니다. 이 질문의 답은 NiFi Provenance에 있습니다. 하지만 장애 중에 NiFi UI를 열고, 프로세서를 찾고, 시간 범위를 맞춰 검색하는 것은 번거롭습니다.
nifi-provenance-query는 이 과정을 클릭 한 번으로 줄입니다. 장애 분석 대시보드의 프로세서별 ERROR Bulletin·가장 느린 프로세서 그래프에서 점을 클릭하면, 그 프로세서의 Provenance 이벤트(종류·시각·노드·FlowFile UUID 등)를 그 시점까지 5분 범위로 새 탭에서 보여 줍니다. 프로세서 표의 이름 메뉴에서도 화면 끝 시각 기준으로 조회할 수 있습니다.
GET /provenance?processor_id=<UUID>&at=<epoch ms>[&window=5m][&format=json]
GET /provenance?processor_id=<UUID>&from=<시각>&to=<시각>
서비스 내부는 NiFi의 비동기 질의 API를 감쌉니다: POST /provenance로 질의를 만들고, GET /provenance/{id}를 완료될 때까지 폴링하고, 결과를 HTML 표(또는 JSON)로 돌려준 뒤 DELETE /provenance/{id}로 질의를 지웁니다. DELETE는 실패나 타임아웃 때도 반드시 실행합니다. NiFi에 질의가 쌓이면 그 자체가 부하가 되기 때문입니다.
운영 클러스터에 붙는 서비스인 만큼 제한을 강하게 걸었습니다.
| 장치 | 내용 |
|---|---|
| 필수 조건 | processor_id와 시간 범위가 없으면 400. 클러스터 전체를 긁는 질의를 원천 차단 |
| 범위 제한 | 최대 1시간(max_range). 넘으면 끝 시각 기준으로 줄이고 화면에 알림 |
| 결과 제한 | 기본 1,000건, 최대 10,000건 |
| 동시 조회 | 기본 2개. 넘으면 429 |
| 시간 초과 | 60초 넘으면 504를 돌려주고 질의 삭제 |
| 데이터 최소화 | 속성과 내용(content)은 요청하지도 반환하지도 않음. view the data 권한 불필요 |
| 계정 분리 | exporter 계정과 다른 조회 전용 계정 사용 |
| 감사 | 조회마다 프로세서·범위·건수·요청 주소를 JSON 로그로 기록 |
| 클러스터 확인 | 링크의 cluster가 서비스의 cluster_name과 다르면 400 |
권한이 없으면 502와 함께 어떤 정책이 필요한지 안내합니다. 더 넓은 범위나 FlowFile 내용이 필요하면 그때 NiFi UI의 Data Provenance로 넘어가면 됩니다. 이 서비스는 "장애 시점의 첫 번째 질문"에 빠르게 답하는 데 집중했습니다.
7. 알림 중계 서비스
Slack과 메일은 Alertmanager가 기본으로 지원하지만, 현장에는 사내 당직 시스템·티켓 시스템·문자 발송 API처럼 고유 형식의 HTTP API 가 꼭 있습니다. Alertmanager의 webhook은 정해진 JSON만 보내므로, 그 사이에 변환기가 필요합니다.
nifi-alert-relay는 Alertmanager의 custom-relay 수신처로 모든 알림을 받아, 설정한 대상마다 다시 보냅니다.
dedupe_window: 5m

targets:
  - name: ops-api
    url: https://ops.example.com/api/v1/events
    method: POST
    headers:
      Authorization: "Bearer ${OPS_API_TOKEN}"   # 토큰은 시작할 때 환경변수에서 채움
    mode: alert                                   # 알림 하나에 요청 하나
    match:
      severity: [critical]
    send_resolved: true
    timeout: 10s
    retries: 2
    retry_backoff: 2s
    payload:
      source: nifi
      title: "[{status}] {alertname} ({cluster})"
      message: "{summary}"
      detail: "{description}"
위는 저장소의 exporter/config/nifi-alert-relay.example.yaml에서 대상 하나를 옮긴 것입니다.
mode: alert는 알림 하나에 요청 하나,mode: group은 Alertmanager 통지 하나에 요청 하나를 보냅니다. group 모드에서는 필터링 후 남은 알림으로status와 공통 레이블을 다시 계산합니다.payload를 생략하면 원본을 그대로 보내고, 지정하면 JSON 구조 안의{alertname},{summary},{labels[이름]}같은 자리를 채웁니다.- 재시도는 5xx·429·연결 오류만 합니다. 4xx는 요청이 잘못된 것이므로 바로 실패 처리합니다.
- 대상 하나라도 실패하면 Alertmanager에 502를 돌려줘 통지를 다시 받습니다. 이때 이미 성공한 대상은
dedupe_window(기본 5분) 동안 다시 보내지 않으므로 티켓이 중복 생성되지 않습니다.
중계가 멈추면 어떻게 알까요? 전송 결과가 nifi_alert_relay_deliveries_total{target,result}로 나가고, NiFiAlertRelayDown·NiFiAlertRelayFailing 알림이 이를 감시합니다. 이 알림은 Slack으로도 가므로, 중계가 죽어도 다른 경로로 알 수 있습니다.
8. 검증 체계
모니터링 시스템이 가장 위험한 순간은 틀린 값을 자신 있게 보여 줄 때 입니다. 그래서 이 저장소는 "값이 맞는가"와 "장애 때 실제로 울리는가"를 검증하는 데 많은 노력을 들였습니다.
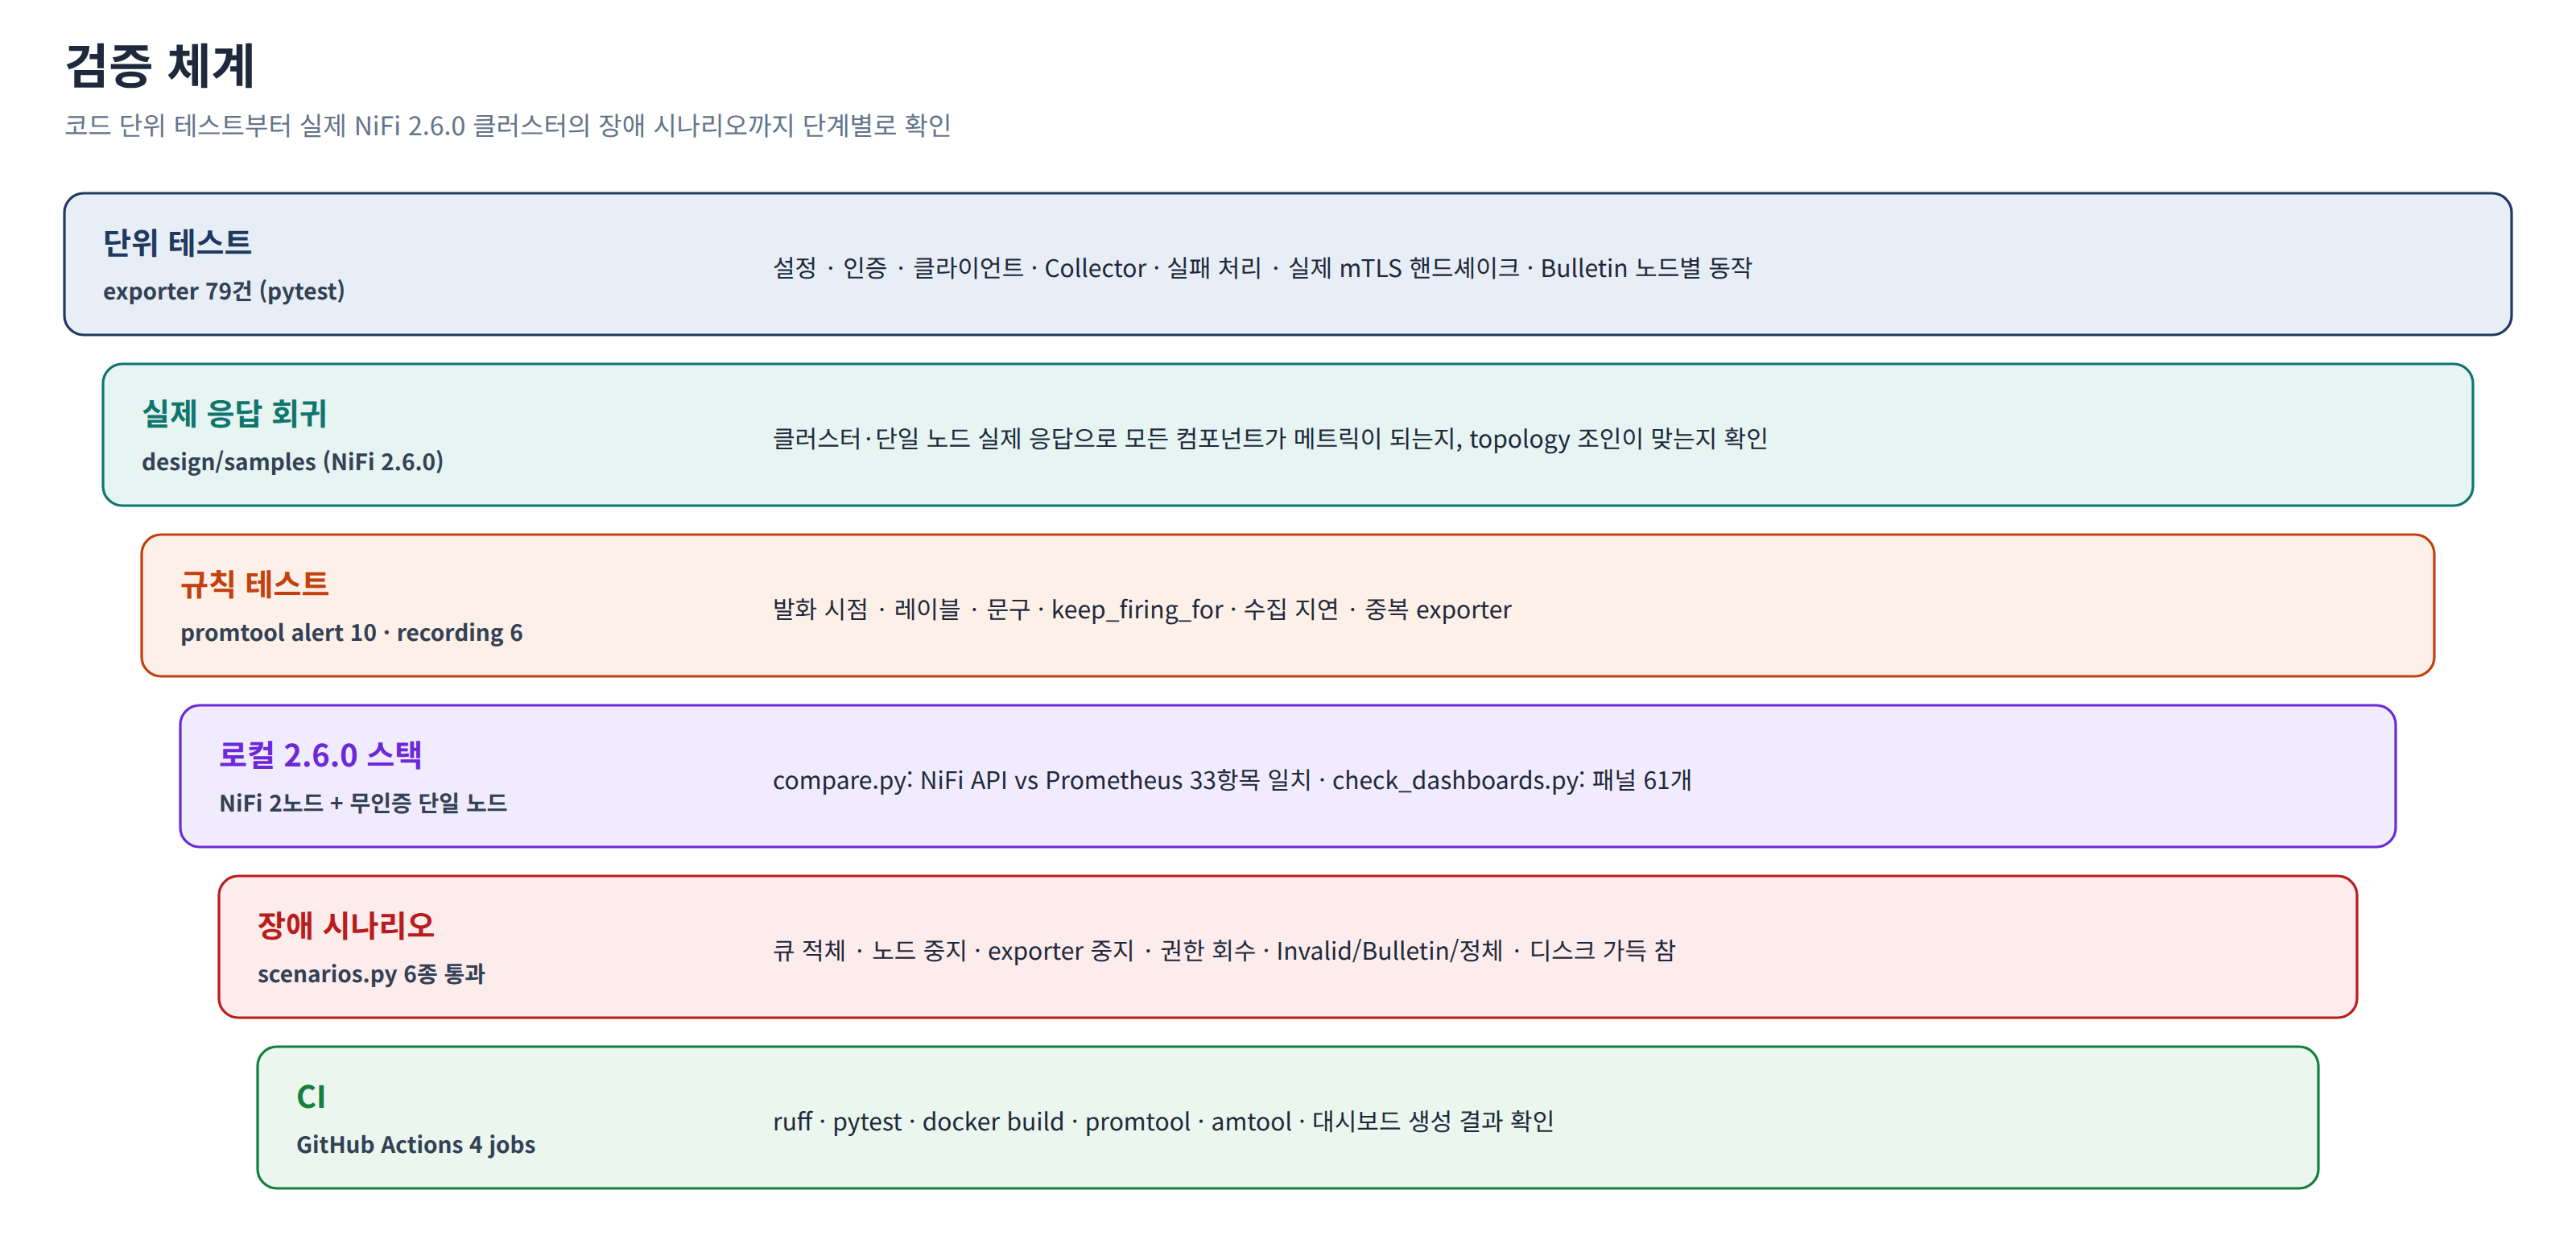
| 검증 | 내용 |
|---|---|
| exporter 단위 테스트 (114건) | 설정·인증·클라이언트·collector·단일 노드 인식·실패와 재시도·실제 mTLS 핸드셰이크·Bulletin 노드별 동작·Provenance 조회·알림 중계 |
| 실제 응답 회귀 | 운영 클러스터에서 수집해 마스킹한 API 응답으로 모든 컴포넌트가 메트릭이 되는지 확인 |
| promtool | alert 규칙 12건, recording 규칙 7건의 단위 테스트 |
수치 대조 (compare.py) | NiFi API 값과 Prometheus 값을 직접 비교. 로컬 33항목, CFM 운영 클러스터 392항목 |
장애 시나리오 (scenarios.py) | 큐 적체, 노드 중지, exporter 중지, 권한 회수, Invalid·Bulletin·정체, 디스크 가득 참 |
링크 클릭 (check_drilldown.py) | headless Chromium으로 표 셀 링크 6개와 Provenance 링크 3개를 실제로 클릭 |
| CI | ruff, pytest, docker build, 실행 묶음 smoke test, promtool, amtool, 대시보드 생성 결과 확인 |
promtool 테스트는 "이 시계열이 이렇게 흐르면 몇 분 뒤 이 알림이 이 레이블로 발화해야 한다"를 코드로 고정합니다. 임계치를 조정하거나 규칙을 고칠 때 의도치 않게 알림이 꺼지는 사고를 막아 줍니다.
장애 시나리오 스크립트는 로컬 2노드 클러스터에 실제로 장애를 일으킵니다. 노드를 멈추면 NiFiNodeDisconnected가 발화하고 그 노드 때문에 생긴 큐 알림은 억제되는지, exporter를 멈추면 NiFiExporterDown만 남고 나머지는 조용한지, 권한을 회수하면 NiFiCollectorFailing이 뜨는지를 확인합니다.
9. 직접 해 보기
로컬 검증 스택
Docker만 있으면 NiFi 2.6.0 2노드 클러스터와 모니터링 전체를 띄울 수 있습니다.
git clone https://github.com/DataDynamics-OSS/nifi-monitoring.git
cd nifi-monitoring/deploy/local
./gen-certs.sh              # 테스트용 CA·인증서·비밀값 생성
docker compose up -d        # NiFi 2노드 연결까지 약 1분
python3 seed.py             # 테스트 플로우, 읽기 전용 계정, Provenance 조회 계정 생성
python3 compare.py # NiFi API 값과 Prometheus 값 대조| 서비스 | 주소 |
|---|---|
| Grafana | http://localhost:13000 (admin / localtest) |
| Prometheus | http://localhost:19090 |
| Alertmanager | http://localhost:19093 |
| nifi-exporter | http://localhost:19103/metrics |
| NiFi | https://localhost:18443/nifi (브라우저에 certs/admin.p12 등록) |
테스트 플로우가 큐 적체, Invalid 프로세서, ERROR Bulletin, 소비 정체를 일부러 만들기 때문에 몇 분 뒤면 알림이 발화하는 것을 볼 수 있습니다. TLS·인증 없는 단일 노드 NiFi는 docker compose --profile plain up -d nifi-plain nifi-exporter-plain으로 확인합니다.
운영 설치
cd exporter
docker build -t nifi-exporter:0.1.0 .
cp config/nifi-exporter.example.yaml /etc/nifi-exporter/config.yaml   # 편집
docker run -d --name nifi-exporter -p 9103:9103 \
  -v /etc/nifi-exporter:/etc/nifi-exporter:ro \
  nifi-exporter:0.1.0
Docker를 쓸 수 없는 서버도 고려했습니다.
- INSTALL.md 는 Python venv와 systemd로 한 단계씩 설치하는 가이드입니다. 단계마다 확인 명령과 문제 해결 방법을 적었고, 폐쇄망 반입 절차도 포함합니다.
make dist는 pip·venv 없이 압축 하나를 풀어bin/start.sh로 실행하는 묶음을 만듭니다. 서버에는 Python 3.11만 있으면 되고,python -S로 실행해 시스템 site-packages와 섞이지 않습니다.
Prometheus·Alertmanager·Grafana 설정은 deploy/ 아래에 있고, promtool check/test, amtool check-config로 배치 전에 검증할 수 있습니다. 요구 버전은 Prometheus 2.42 이상(keep_firing_for), Grafana 11.6 이상(같은 대시보드로 가는 드릴다운 링크가 즉시 반영되는 버전)입니다.
10. 운영하며 배운 것
클러스터당 exporter는 1개만. 가용성을 위해 exporter를 2개 띄우고 싶어지지만, 같은 클러스터를 두 exporter가 스크레이프하면 모든 *_info 시계열이 중복되어 group_left 조인이 실패합니다. 큐·프로세서·Bulletin 알림이 모두 조용히 꺼지는 것입니다. 그래서 가용성은 재시작하는 실행 환경(systemd Restart=always, Kubernetes replicas: 1)으로 확보하고, 실수로 2개가 붙으면 NiFiExporterDuplicate가 울리도록 했습니다.
시간대는 한 곳으로. 모니터링 서버 OS, NiFi 서버·JVM, exporter의 nifi.timezone, Grafana 대시보드를 모두 Asia/Seoul로 통일했습니다. NiFi는 heartbeat 시각을 서버 시간대 문자열로 주는데, exporter가 이를 다른 시간대로 해석하면 heartbeat 경과가 시차만큼 어긋나 NiFiNodeHeartbeatStale이 엉뚱하게 발화합니다.
수집 알림부터, 노드 알림 다음. Runbook의 첫 원칙입니다. 수집 알림이 떠 있으면 대시보드의 빈 값은 "0"이 아니라 "미수집"이고, 노드 단절 중의 큐 적체는 결과일 가능성이 높습니다. 큐 알림은 큐 대시보드 → 하류 프로세서 → Bulletin → Provenance 순서로 원인을 좁힙니다.
NiFi 업그레이드는 응답 비교부터. capture_samples.py로 새 버전의 API 응답을 수집해 이전 응답과 diff하고, 마스킹(mask_samples.py)한 샘플로 회귀 테스트를 돌린 뒤, 로컬 스택의 NiFi 버전을 올려 수치 대조와 장애 시나리오를 다시 실행합니다. REST API 응답 구조가 버전마다 조금씩 바뀌기 때문입니다.
/metrics도 민감 정보다. 큐와 프로세서 이름에는 업무 정보가 담깁니다. server.basic_auth를 켜거나 내부망으로 제한하고, NiFi 내장 엔드포인트용 인증서도 같은 수준으로 관리합니다.
마무리
nifi-monitoring은 "NiFi 화면을 아무도 보지 않을 때도 장애를 알 수 있게"라는 단순한 목표에서 출발했습니다. 그 과정에서 가장 공을 들인 부분은 화려한 대시보드보다 값을 믿을 수 있게 만드는 장치들이었습니다. 미수집과 0의 구분, 원인 알림에 의한 억제, 거짓 해소 방지, 그리고 운영 클러스터 392항목의 수치 대조입니다.
NiFi 2.x를 운영하고 있다면 로컬 스택부터 띄워 보시길 권합니다. 이슈와 풀리퀘스트는 언제든 환영합니다.
- GitHub: github.com/DataDynamics-OSS/nifi-monitoring
- 라이선스: Apache License 2.0
- 알림 대응 절차: docs/runbook.md