
Argus Flow
Apache NiFi 2.10.0을 실제 운영 환경에 올리는 데 필요한 것을 한곳에 모은 오픈소스 데이터 파이프라인 배포판입니다. 커스텀 확장 번들(NAR), 배포 패키지(tar.gz·RPM·컨테이너 이미지), Kubernetes 오퍼레이터, 설정·인증서·사용자 관리 도구까지 — 흩어진 저장소를 모노레포로 통합해 하나의 빌드 파이프라인에서 버전이 맞춰진 채로 산출됩니다.
NiFi 데이터 흐름에 필요한 확장을 연결
CDC와 파일 목록 수집, FlowFile 처리, 대상 저장소 적재, 운영 확인을 하나의 흐름으로 구성합니다.
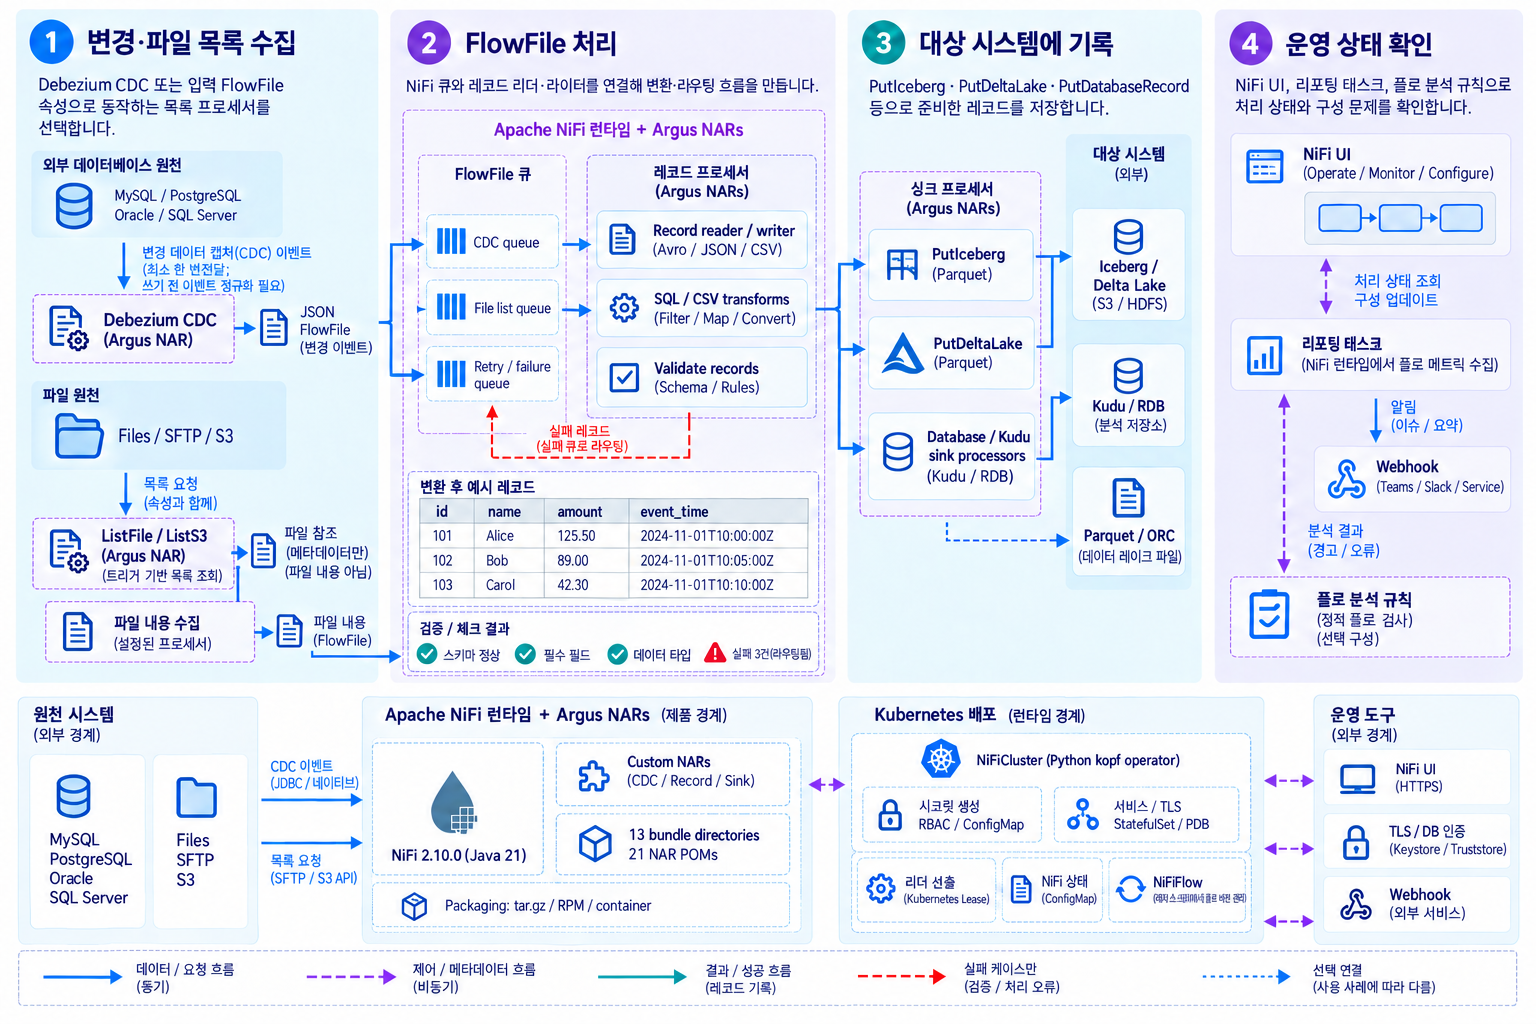
- 1.변경·파일 목록 수집
- Debezium CDC 또는 입력 FlowFile 속성으로 동작하는 목록 프로세서를 선택합니다.
- 2.FlowFile 처리
- NiFi 큐와 레코드 리더·라이터를 연결해 변환·라우팅 흐름을 만듭니다.
- 3.대상 시스템에 기록
- PutIceberg·PutDeltaLake·PutDatabaseRecord 등으로 준비한 레코드를 저장합니다.
- 4.운영 상태 확인
- NiFi UI, 리포팅 태스크, 플로 분석 규칙으로 처리 상태와 구성 문제를 확인합니다.
CDC는 최소 한 번(at-least-once) 전달 방식입니다. 변경 이벤트를 대상 레코드로 변환하는 설정이 필요하며, 파일 목록 조회와 파일 내용 수집은 별도 단계입니다.
GitHub 문서·코드 확인배포본 준비부터 Kubernetes 운영까지
확장을 패키징하고 접속·TLS를 설정한 뒤, 선언한 클러스터와 플로를 오퍼레이터로 관리합니다.
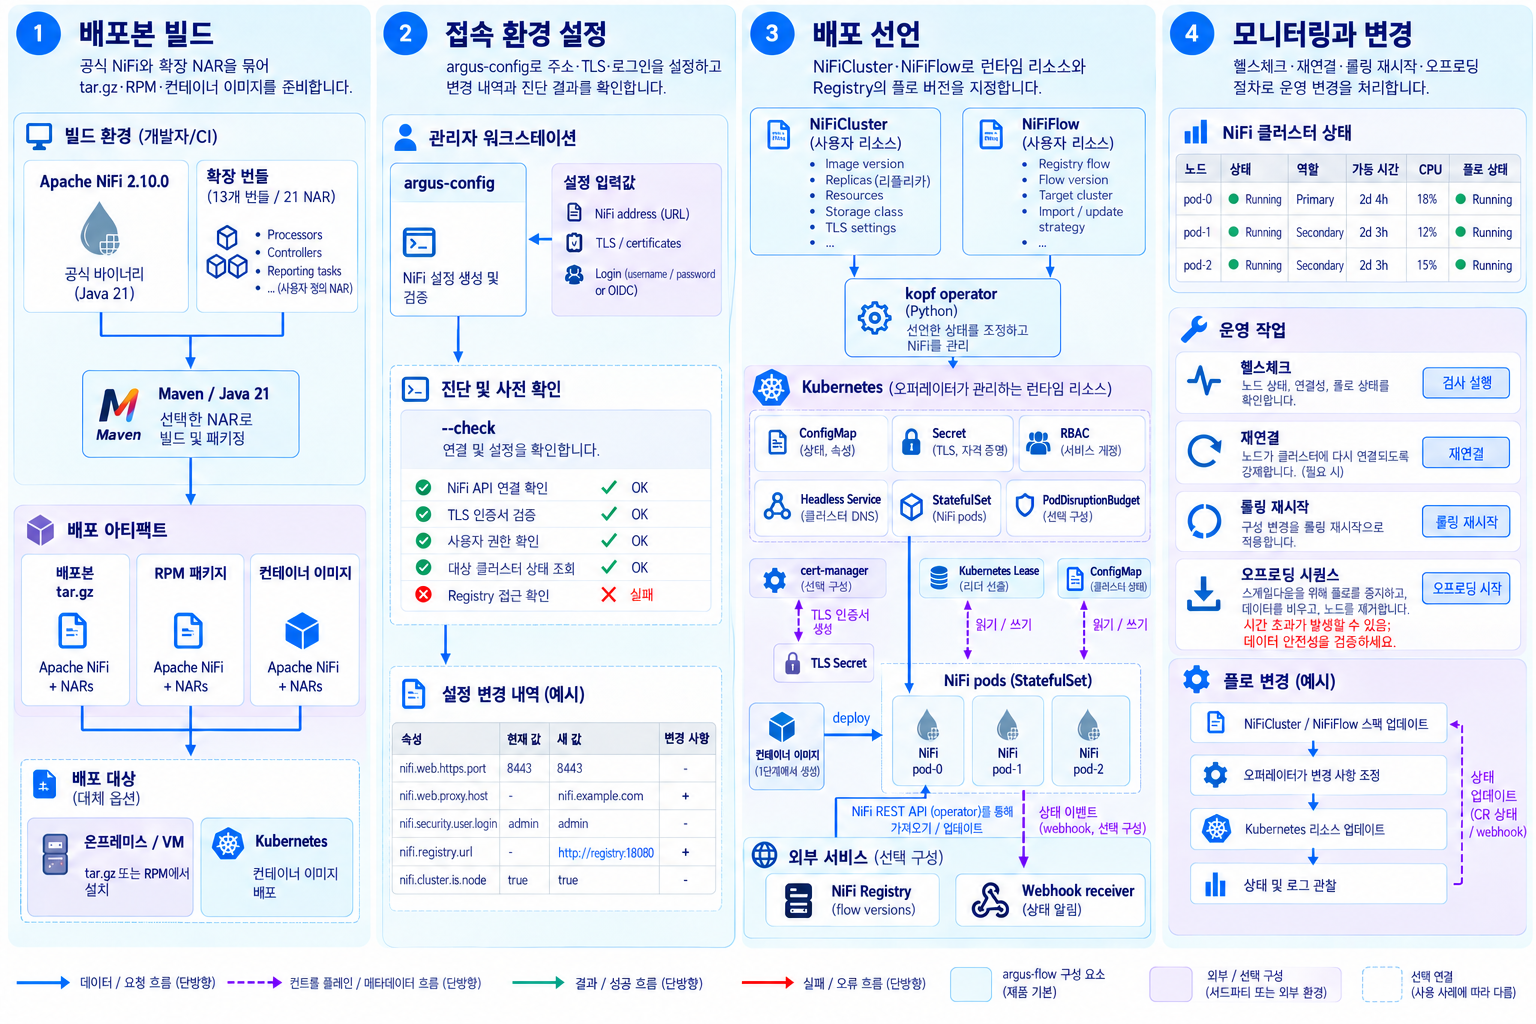
- 1.배포본 빌드
- 공식 NiFi와 확장 NAR을 묶어 tar.gz·RPM·컨테이너 이미지를 준비합니다.
- 2.접속 환경 설정
- argus-config로 주소·TLS·로그인을 설정하고 변경 내역과 진단 결과를 확인합니다.
- 3.배포 선언
- NiFiCluster·NiFiFlow로 런타임 리소스와 Registry의 플로 버전을 지정합니다.
- 4.모니터링과 변경
- 헬스체크·재연결·롤링 재시작·오프로딩 절차로 운영 변경을 처리합니다.
Kubernetes 구성은 Lease 기반 리더 선출과 ConfigMap 상태 관리를 사용합니다. 롤링 재시작이나 노드 축소가 무중단·무손실을 보장하지는 않습니다.
GitHub 문서·코드 확인NiFi 프로세서와 컨트롤러 서비스 상세
수집·조회·변환·저장을 담당하는 프로세서 30종과 연결·직렬화·카탈로그 설정을 공유하는 컨트롤러 서비스 8종입니다.
프로세서30종
프로세서는 FlowFile을 처리하는 단계입니다. CDC는 최소 한 번 전달을 전제로 중복·순서·삭제 처리를 구성하고, List 계열은 별도 Fetch 프로세서와 연결해 실제 파일을 가져옵니다.
| 컴포넌트 | 분류 | 지원 기능 |
|---|---|---|
CaptureChangeMySQL | 변경 데이터 캡처 | MySQL binlog에서 행 변경을 캡처해 JSON FlowFile로 출력합니다. |
CaptureChangePostgreSQL | 변경 데이터 캡처 | PostgreSQL 논리 복제로 행 변경을 캡처합니다. pgoutput·decoderbufs를 지원합니다. |
CaptureChangeOracle | 변경 데이터 캡처 | Oracle LogMiner에서 행 변경을 캡처합니다. CDB/PDB 연결 설정을 지원합니다. |
CaptureChangeSQLServer | 변경 데이터 캡처 | SQL Server CDC 테이블에서 행 변경을 읽어 JSON FlowFile로 출력합니다. |
ExecuteSQL | 데이터베이스 | SELECT 결과를 스트리밍으로 읽어 Avro로 출력합니다. 쿼리 파라미터 바인딩과 스케줄·입력 트리거를 지원합니다. |
ExecuteSQLRecord | 데이터베이스 | SELECT 결과를 Record Writer가 지정한 형식으로 출력합니다. 파라미터 바인딩과 결과 스트리밍을 지원합니다. |
ExecuteFastSQL | 데이터베이스 | SQL 조회 결과를 여러 스레드로 가져와 CSV로 출력합니다. 바이너리는 Base64, CLOB은 문자열로 변환합니다. |
PutDatabaseRecord | 데이터베이스 | Record Reader로 읽은 레코드를 INSERT·UPDATE·DELETE 등의 SQL로 변환합니다. 트랜잭션 처리와 성공·재시도·실패 분기를 제공합니다. |
BulkOracleInsertProcessor | 데이터베이스 | 레코드를 바인딩 파라미터가 있는 Oracle INSERT ALL로 묶어 적재합니다. 배치 행 수와 쿼리 제한 시간을 설정합니다. |
ListS3 | 파일 목록 조회 | 입력 속성으로 버킷·Prefix 등을 지정해 S3 객체 목록을 조회합니다. 객체별 FlowFile을 만들며 실제 다운로드는 FetchS3Object와 연결합니다. |
ListHDFS | 파일 목록 조회 | 입력 속성으로 HDFS 디렉터리·파일 필터를 지정합니다. 파일별 경로 속성을 출력해 FetchHDFS에 전달합니다. |
ListFile | 파일 목록 조회 | 허용된 기본 디렉터리 아래의 로컬·마운트 경로를 조회합니다. 입력을 처리한 노드에서 목록을 만들고 FetchFile과 연결합니다. |
ListSFTP | 파일 목록 조회 | 입력 속성으로 SFTP 접속 대상과 원격 경로를 지정합니다. 파일별 목록을 FlowFile로 출력해 FetchSFTP와 연결합니다. |
ListFTP | 파일 목록 조회 | 입력 속성으로 FTP 접속 대상과 원격 경로를 지정합니다. 파일별 목록을 FlowFile로 출력해 FetchFTP와 연결합니다. |
QueryTrinoRecord | Trino 조회·유지보수 | Trino SELECT 결과를 Record Writer로 스트리밍하고 행 수 기준으로 분할합니다. 쿼리 ID·실행 통계를 기록하며 중지 시 쿼리를 취소합니다. |
ExecuteTrinoStatement | Trino 조회·유지보수 | CTAS·INSERT SELECT·MERGE 등 DDL/DML/ELT 단일 문장을 실행합니다. 동기·백그라운드 실행과 입력 없는 스케줄 실행을 지원합니다. |
MaintainTrinoTable | Trino 조회·유지보수 | Iceberg: OPTIMIZE·스냅샷 만료·미참조 파일 정리, Delta Lake: OPTIMIZE·VACUUM, Hive: 파티션 동기화를 수행합니다. 세 포맷 모두 ANALYZE를 지원합니다. |
PutIceberg | 레이크하우스 적재 | Record Reader와 카탈로그 서비스를 사용해 기존 Iceberg 테이블에 레코드를 추가합니다. 대상 스키마가 필요하며 CDC 수정·삭제 병합은 별도로 구성합니다. |
PutDeltaLake | 레이크하우스 적재 | Delta Kernel로 경로 기반 테이블에 Parquet 파일과 로그를 커밋합니다. 테이블 생성·추가 쓰기를 지원하며 원시 타입과 file/HDFS가 기본 범위입니다. |
PutKudu | 레이크하우스 적재 | 레코드를 Kudu 테이블에 쓰고 작업 유형·배치·Flush 방식을 설정합니다. 컬럼별 타임스탬프 형식과 시간 보정을 지원합니다. |
SelectHive3QL | Hive 연동 | HiveQL SELECT 결과를 Avro 또는 CSV로 스트리밍 출력합니다. 스케줄·입력 트리거와 조회 행 수 속성을 제공합니다. |
PutHive3QL | Hive 연동 | FlowFile의 HiveQL DDL/DML을 실행합니다. 물음표 파라미터와 hiveql.args 속성으로 값을 바인딩합니다. |
PutHive3Streaming | Hive 연동 | Hive 3 Streaming API로 레코드를 적재합니다. 고정 파티션 값 또는 레코드의 파티션 필드를 사용합니다. |
UpdateHive3Table | Hive 연동 | 입력 스키마에 맞춰 없는 Hive 테이블을 생성하거나 컬럼·파티션을 추가합니다. 데이터 적재 전 테이블 구성을 맞추는 데 사용합니다. |
TriggerHiveMetaStoreEvent | Hive 연동 | 입력 경로와 put/delete 속성으로 Hive Metastore 알림 이벤트를 발생시킵니다. 메타스토어 알림 리스너 설정이 필요합니다. |
PutORC | 파일 포맷 | Record Reader로 입력 레코드를 읽어 지정한 파일시스템 경로에 ORC 파일로 기록합니다. |
PutParquet | 파일 포맷 | 입력 레코드를 지정 스키마의 Parquet 파일로 기록합니다. 임시 파일 쓰기가 완료되면 최종 파일명으로 변경합니다. |
MergeParquet | 파일 포맷 | HDFS의 Parquet 파일들을 읽어 하나로 병합하고 결과 경로를 출력합니다. 병합 커밋 후 원본 파일을 유지하거나 삭제하도록 설정합니다. |
MultilineCsvParser | 변환·외부 명령 | 여러 줄 필드가 있는 CSV를 스트리밍 파싱합니다. 구분자·인코딩·따옴표·헤더·컬럼 수를 설정하고 잘못된 입력은 실패로 분기합니다. |
PrePostExecuteStreamCommand | 변환·외부 명령 | FlowFile 내용을 외부 명령의 입력으로 전달합니다. 본 명령 전후에 실행할 명령을 함께 구성합니다. |
컨트롤러 서비스8종
컨트롤러 서비스는 여러 프로세서가 공유하는 연결·읽기·쓰기·카탈로그 설정입니다. 표의 이름은 NiFi에서 선택하는 실제 컴포넌트 이름입니다.
| 컴포넌트 | 분류 | 지원 기능 |
|---|---|---|
CSVReader | 레코드 리더·라이터 | CSV 행을 레코드로 읽고 헤더 기반 스키마 추론 또는 명시적 스키마를 사용합니다. 타임스탬프 형식을 지정할 수 있습니다. |
TimestampFormatAvroRecordSetWriter | 레코드 리더·라이터 | 레코드를 바이너리 Avro로 기록합니다. 스키마 속성의 타임스탬프 형식, 시간 보정과 압축을 설정합니다. |
TimestampFormatParquetRecordSetWriter | 레코드 리더·라이터 | 레코드를 Parquet로 기록합니다. 스키마 속성의 타임스탬프 형식, 시간 보정과 INT96 필드를 지정합니다. |
Hive3ConnectionPool | 데이터베이스 연결 | Hive 3 JDBC 연결을 풀로 관리합니다. Hive 프로세서가 연결을 빌리고 반환하며 Kerberos 설정을 연동합니다. |
VendorHive3ConnectionPool | 데이터베이스 연결 | 외부 벤더 Hive JDBC 드라이버로 연결 풀을 제공합니다. 서비스별 드라이버 위치와 Kerberos를 설정하며 드라이버 JAR은 별도로 준비합니다. |
HiveCatalogService | Iceberg 카탈로그 | Hive Metastore에 연결해 Iceberg 테이블 메타데이터를 관리합니다. PutIceberg의 카탈로그 서비스로 연결합니다. |
HadoopCatalogService | Iceberg 카탈로그 | HDFS 등 원자적 이름 변경을 지원하는 파일시스템 기반 Iceberg 카탈로그를 제공합니다. |
StandardTrinoConnectionService | 데이터베이스 연결 | Trino JDBC 연결을 제공하며 DBCPService와 호환됩니다. NONE·PASSWORD·JWT·Kerberos·OAuth2 인증, 세션 속성과 외부 드라이버 JAR을 지원하고 연결 풀은 사용하지 않습니다. |
PostgreSQL CDC를 실제 NiFi 처리 흐름으로 보기
논리 복제부터 JSON 변경 이벤트, 대상별 변환과 재처리까지 구체적으로 연결합니다.
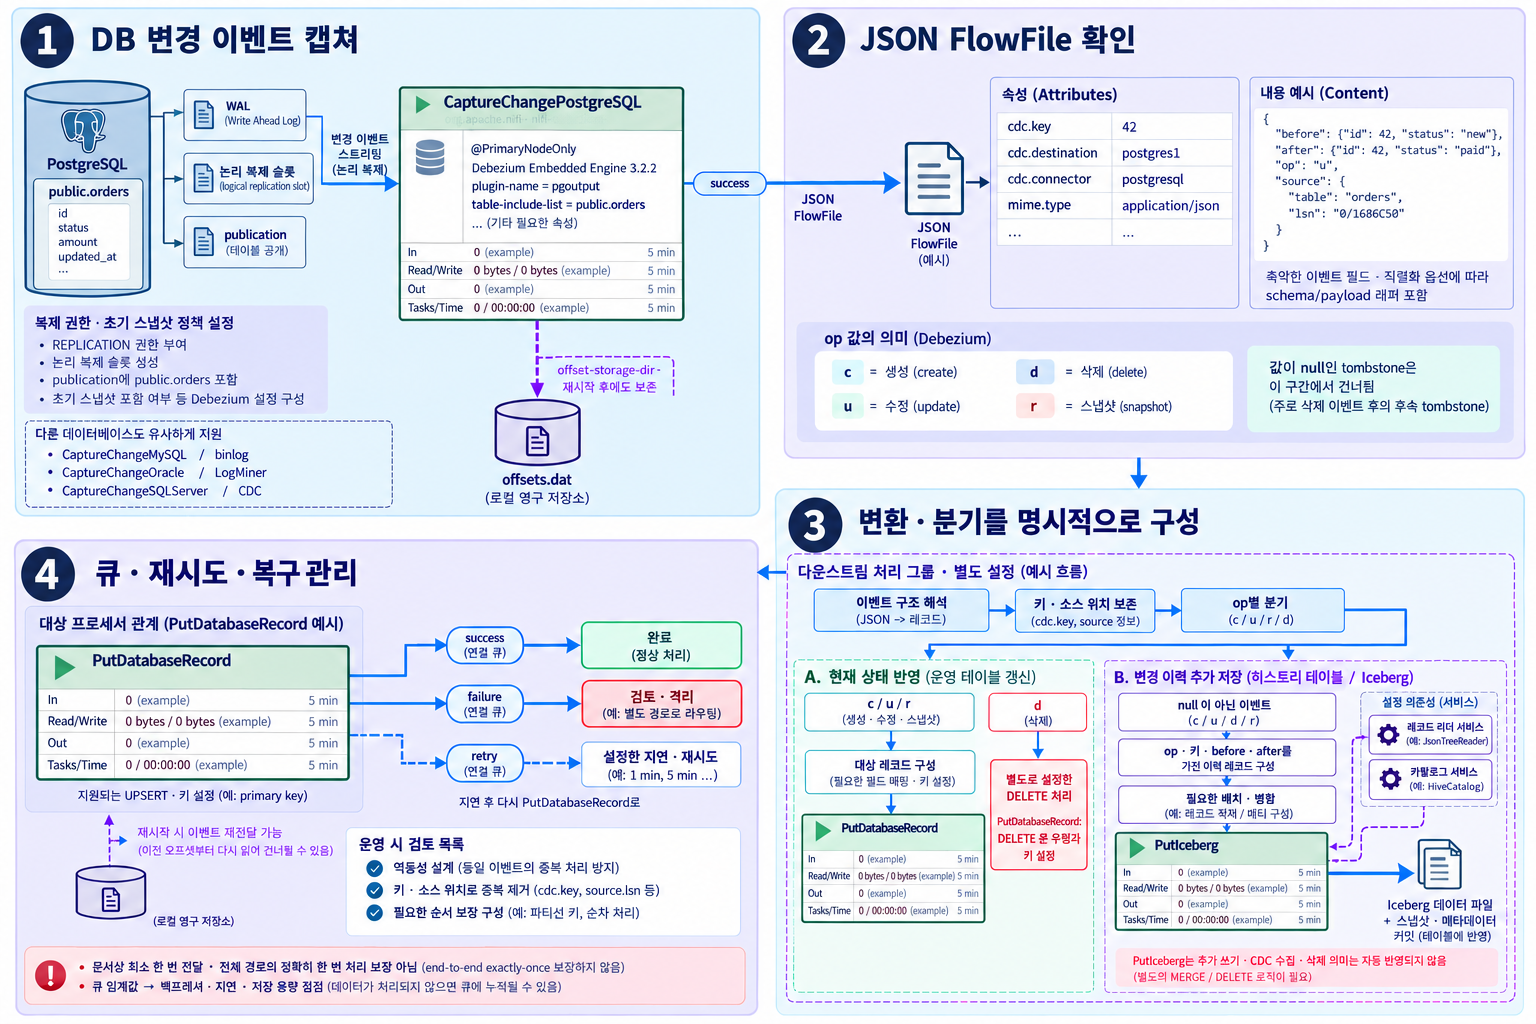
- 1.논리 복제 구성
- 권한·슬롯·publication을 준비하고 CaptureChangePostgreSQL과 로컬 오프셋 저장소를 설정합니다.
- 2.이벤트 확인
- before·after·op와 cdc.key 등 FlowFile 속성을 확인합니다.
- 3.대상별 의미 반영
- 현재 상태용 UPSERT·DELETE 경로와 추가 저장용 변경 이력 경로를 구분합니다.
- 4.재처리 설계
- 대상 프로세서의 오류·재시도 큐와 재전달에 따른 중복 제거를 구성합니다.
CDC 문서는 최소 한 번 전달을 명시합니다. 중복 제거·순서·삭제 처리는 별도 구성해야 하며, PutIceberg의 추가 쓰기가 CDC 병합·수정·삭제를 자동 수행하지는 않습니다.
GitHub 문서·코드 확인배포·보안·운영 점검과 에디션 비교
공개 배포판의 운영 기능과 Enterprise의 기술 지원·서비스 범위를 함께 정리합니다.
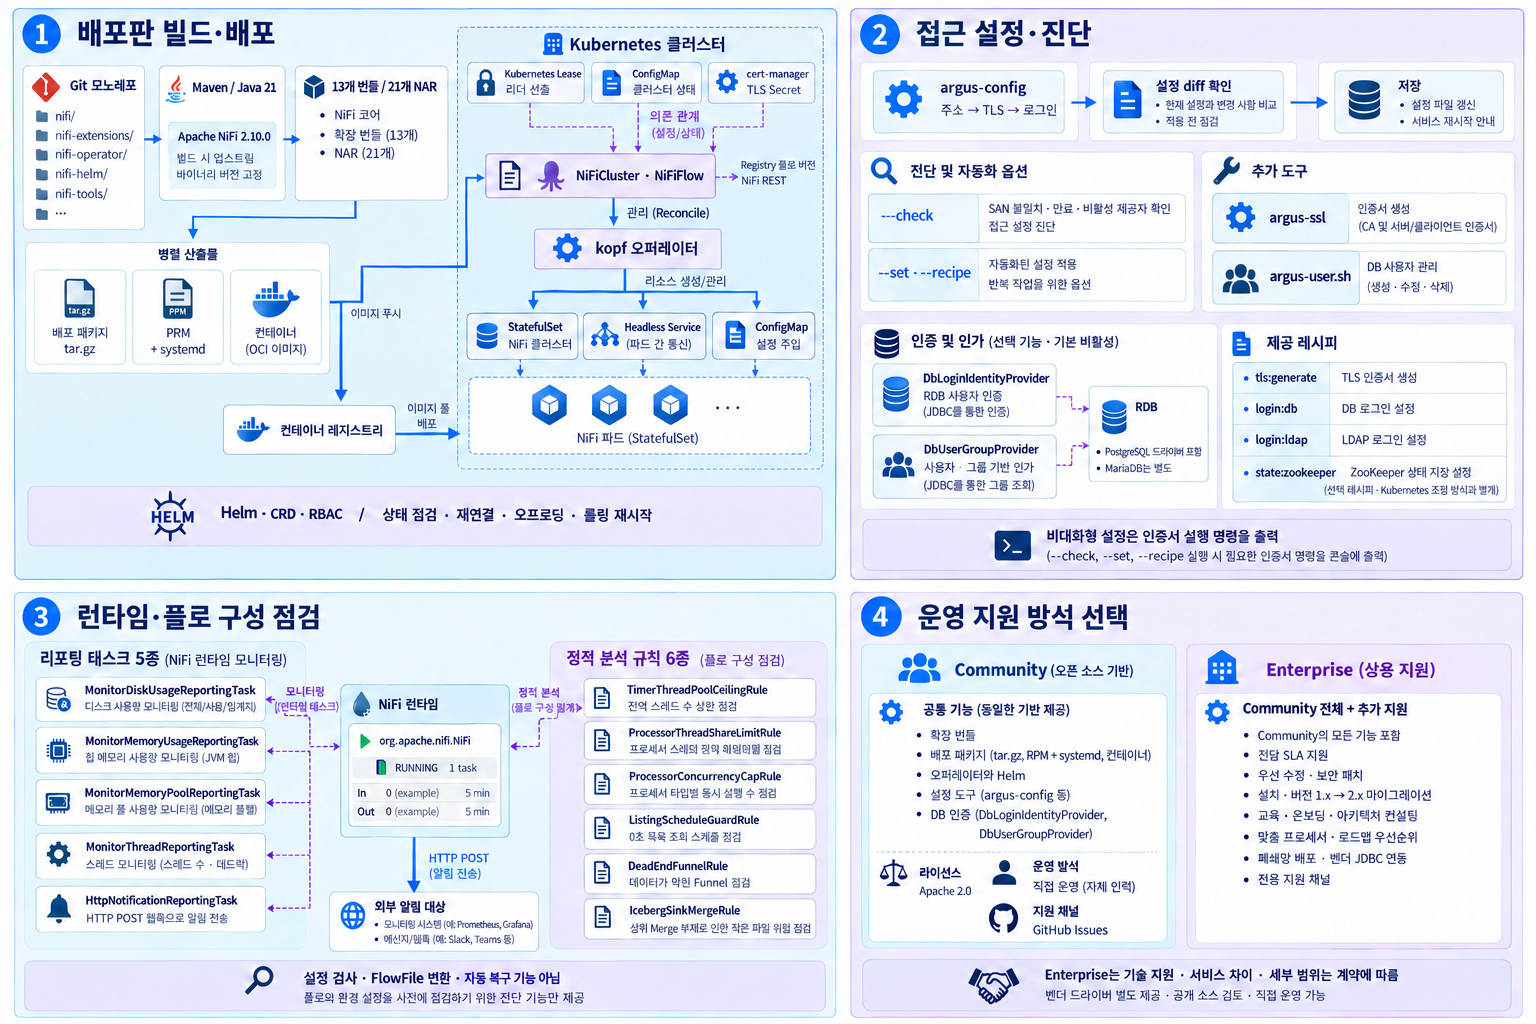
- 1.배포판 구성
- 13개 번들·21개 NAR을 패키징하고 Kubernetes에서는 Lease와 ConfigMap을 사용합니다.
- 2.접근·보안 설정
- 주소·TLS·로그인 설정을 진단하고 필요한 경우 DB 인증·인가를 활성화합니다.
- 3.운영 상태 검사
- 리포팅 태스크 5종과 정적 분석 규칙 6종으로 런타임·플로 구성을 점검합니다.
- 4.지원 방식 선택
- 직접 운영하는 Community 또는 SLA·마이그레이션·맞춤 개발을 제공하는 Enterprise를 선택합니다.
Community에 확장·배포·오퍼레이터·설정 도구가 공개됩니다. Enterprise는 SLA와 전문 서비스를 더하며, 벤더 드라이버는 별도 제공됩니다. 롤링 재시작·축소가 무중단·무손실을 보장하지는 않습니다.
GitHub 문서·코드 확인오픈소스로 공개된 NiFi 운영 배포판
Argus Flow는 Apache License 2.0으로 GitHub에 공개됩니다. 확장 번들 소스부터 배포 패키징, Kubernetes 오퍼레이터, 운영 도구까지 전부 공개해 기업이 코드를 직접 검증하고 자사 환경에 맞게 확장하며 폐쇄망에서도 자체 운영할 수 있습니다.
- 상용 활용 제약 없는 Apache 2.0
- 업스트림 귀속·라이선스 헤더 자동 검증
- 온프레미스·폐쇄망 자체 운영