
Sqoop 없이 Oracle→Hive 적재하기 (2) — Oracle SCN으로 병렬 추출의 일관성 지키기
NiFi가 여러 노드에서 서로 다른 시각에 실행하는 파티션 조회가 모두 같은 시점의 데이터를 읽도록, run 시작 시 Oracle SCN을 하나 고정하고 manifest와 모든 파티션 SELECT에 AS OF SCN을 적용한 방법을 정리했습니다. 파티션 경계 계산, Undo 보존 조건, ORA-01555 처리 원칙까지 다룹니다.
1편에서 Sqoop의 Mapper 병렬 추출을 NiFi PG-20이 대신한다고 설명했습니다. 그런데 NiFi는 파티션을 여러 노드에서 병렬로 조회하므로 각 SELECT의 실제 시작·종료 시각이 모두 다릅니다. 원천 테이블은 추출 중에도 업무 트랜잭션으로 계속 바뀝니다. 이 글은 서로 다른 시각에 실행되는 조회들이 어떻게 하나의 같은 시점을 읽게 만드는지를 다룹니다.
| 편 | 주제 |
|---|---|
| 1편 | 전체 아키텍처: Data Plane과 Control Plane |
| 2편 (이 글) | Oracle SCN으로 병렬 추출의 일관성 지키기 |
| 3편 | Load Control API: 분산 Flow에서 "한 번만"을 보장하는 법 |
| 번외편 | NiFi에서 Oracle timestamp를 문자열로 적재하기 |
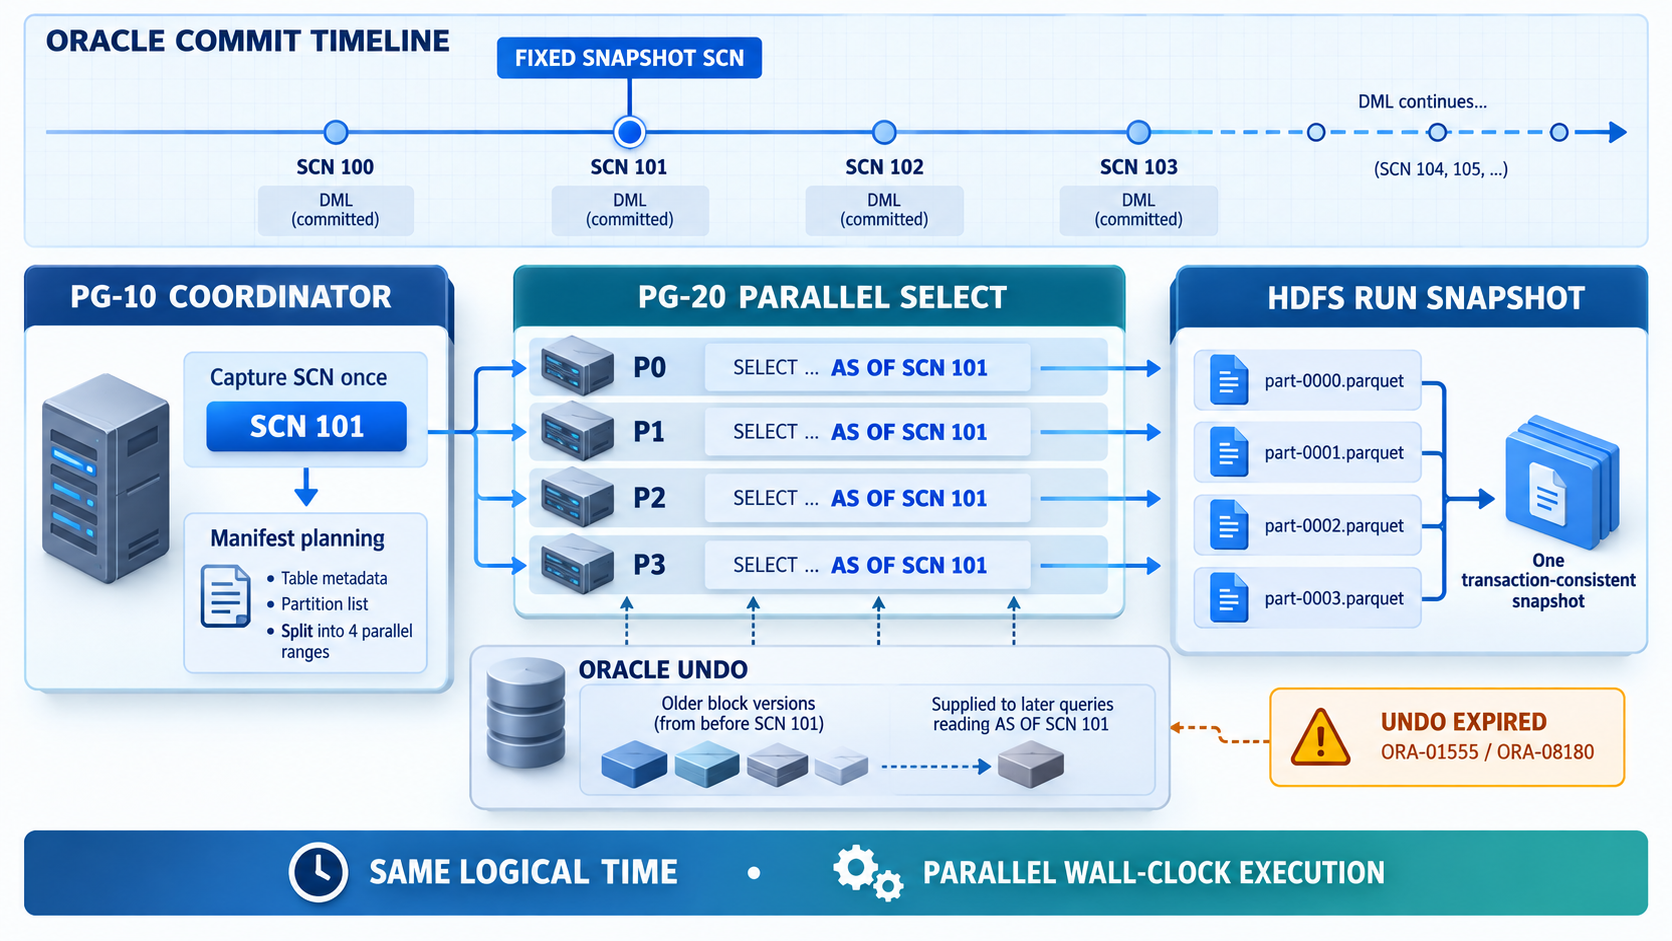
1. 아무 조치 없이 병렬로 읽으면 생기는 일
파티션 P0의 조회가 시작된 뒤, P3의 조회가 시작되기 전에 원천에서 행이 바뀌었다고 해 보겠습니다.
P0은 변경 전 상태를, P3은 변경 후 상태를 읽습니다. 한 번의 적재 결과에 서로 다른 시점의 데이터가 섞입니다. 게다가 이 프로젝트는 추출 전에 원천 건수와 파티션별 예상 건수(manifest)를 먼저 계산하므로 문제가 더 커집니다.
- manifest의 원천 건수와 실제 추출 건수가 어긋납니다.
- split 컬럼의 최솟값·최댓값이나 범위별 예상 건수가 바뀝니다.
- 추출 도중 이동·삭제된 행이 빠지거나, 예상하지 않은 행이 추가됩니다.
- 금액 합계, 시각 최소·최대 같은 품질 지표가 맞지 않습니다.
API의 건수 검증으로 이런 불일치를 실패로 잡을 수는 있습니다. 하지만 실패 후 다시 실행하는 것보다 처음부터 같은 스냅샷을 읽는 것이 설계상 안전합니다.
2. SCN이란
SCN(System Change Number)은 Oracle 데이터베이스 내부 변경 순서를 나타내는 논리적 버전 번호입니다. 트랜잭션 커밋과 데이터베이스 변화를 순서화하며, Flashback Query(AS OF SCN)는 지정한 SCN 시점에 커밋되어 있던 데이터를 돌려줍니다.
| 개념 | 의미 |
|---|---|
| SCN | 데이터베이스 변경 순서를 나타내는 논리적 버전 |
CURRENT_SCN | 조회 시점의 현재 데이터베이스 SCN |
AS OF SCN n | SCN n에 커밋되어 보이던 데이터 읽기 |
| Undo | 현재 block에서 SCN n의 과거 버전을 재구성하는 정보 |
SCN은 날짜·시각이 아니므로 업무일자처럼 쓰지 않습니다. SCN_TO_TIMESTAMP는 운영 추적에 참고할 근사 시각일 뿐이고, 변환 정보의 보존 기간도 제한됩니다. 데이터 일관성의 기준값은 run에 저장된 원래 SCN 하나입니다.
고정 SCN이 101일 때, 그 이후의 업무 DML은 다음처럼 보입니다.
| SCN 101 이후 변경 | AS OF SCN 101 결과 |
|---|---|
| 새 행 INSERT 후 COMMIT | 보이지 않음 |
| 기존 행 UPDATE 후 COMMIT | UPDATE 이전 값이 보임 |
| 기존 행 DELETE 후 COMMIT | 삭제 이전 행이 보임 |
| 아직 COMMIT되지 않은 변경 | 보이지 않음 |
중요한 점은 추출 중에도 업무 DML이 계속될 수 있다는 것입니다. NiFi는 원천을 잠그거나 긴 트랜잭션을 열어 두지 않고, Oracle의 다중 버전 읽기 일관성(multiversion read consistency)과 Undo를 이용합니다.
3. 이 프로젝트의 SCN 적용 순서
run 시작 시 SCN을 한 번만 조회하고, 그 값을 manifest 계산과 모든 파티션 조회에 똑같이 씁니다.
Processor와 원장 필드로 보면 다음과 같습니다.
| 단계 | 구현 | SCN 역할 |
|---|---|---|
| PG-10 14 | 14_Query_Current_SCN | run에서 사용할 현재 SCN을 한 번 조회 |
| PG-10 15 | 15_Extract_SCN | load.snapshot.scn attribute로 저장 |
| PG-10 16 | 16_Query_Source_Manifest | 같은 SCN으로 전체 지표와 범위별 예상 건수 계산 |
| API manifest | POST /runs/{id}/manifest | load_run.snapshot_scn NUMERIC(38,0)에 영구 기록 |
| PG-20 34 | 34_Execute_Partition_Query | 모든 병렬 SELECT가 같은 load.snapshot.scn 사용 |
| 재발행 | API worker payload | 재발행된 파티션에도 원래 run의 SCN을 다시 전달 |
SCN을 조회하는 SQL은 다음 둘 중 하나입니다. V$DATABASE 조회 권한을 줄 수 없으면 두 번째를 씁니다.
SELECT TO_CHAR(CURRENT_SCN) AS SNAPSHOT_SCN FROM V$DATABASE;

SELECT TO_CHAR(DBMS_FLASHBACK.GET_SYSTEM_CHANGE_NUMBER) AS SNAPSHOT_SCN FROM DUAL;
SCN은 문자열로 다룬다
SCN은 Oracle NUMBER(38) 범위의 큰 정수입니다. JSON number로 바꾸는 과정에서 정밀도를 잃지 않도록 TO_CHAR로 꺼내서 API 요청·응답에서는 숫자 문자열로 전달하고, PostgreSQL에는 NUMERIC(38,0)으로 저장합니다. 파티션 경계와 건수도 같은 이유로 문자열로 다룹니다.
SCN과 경계값은 PG-20의 SQL에 따옴표 없이 그대로 들어갑니다. 그래서 SQL에 넣기 전에 NiFi Expression Language로 숫자 형식(^[0-9]+$)인지 확인하고, 숫자가 아니면 조회하지 않습니다.
4. 파티션 경계와 manifest
PG-10의 16_Query_Source_Manifest는 한 SQL 안에서, 같은 SCN으로 다음을 모두 계산합니다.
- 원천 건수(
SOURCE_COUNT) - split 컬럼의 NULL 수, 최솟값, 최댓값
- 금액 합계, 시각 최소·최대 (3편의 검증 지표)
PARTITION.COUNT개의 연속 범위와 범위별 예상 건수
경계는 split 컬럼의 [최솟값, 최댓값]을 N등분한 [lo, hi) 구간입니다. 마지막 파티션만 상한을 포함해서 최댓값이 빠지지 않게 합니다.
WHERE split_column >= lower_bound
  AND split_column <  upper_bound  -- 마지막 파티션만 <=
PG-20의 파티션 조회는 이 경계에 같은 SCN을 붙인 형태입니다.
SELECT INSP_DTL_SEQ, BASE_DT, ITEM_CD, AMOUNT, REG_TS, NOTE
  FROM APP.INSP_DTL AS OF SCN 2388556
 WHERE BASE_DT = DATE '2026-09-28'
   AND INSP_DTL_SEQ >= 1
   AND INSP_DTL_SEQ < 15001;
균등 분할의 특성
경계를 값의 범위로 나누므로, split 컬럼 값이 고르게 분포하지 않으면 파티션마다 건수가 달라집니다. 시험 데이터는 seq 30001~45000 구간을 일부러 비워 두었고, 그 결과 8개 파티션 중 1개가 0건이 되었습니다.
- 예상 건수가 0인 파티션은 API가 manifest 등록 시점에 바로
SUCCESS로 처리하고 PG-20에 보내지 않습니다. - split 컬럼에 NULL이 있으면 범위 조건으로 잡히지 않습니다. 현재 빌더는 NULL 전용 파티션을 만들지 않으므로, 업무 범위 안에 NULL이 있으면 API가 manifest를 거부합니다. split 컬럼은 NOT NULL이거나, 업무 조건 안에서 NULL이 없어야 합니다.
API가 manifest에서 검사하는 것
API는 manifest를 받을 때 다음을 검사합니다.
- 파티션 ID 중복과 계획한 파티션 수
- 예상 건수 합계 = 원천 건수
- 0건 파티션 허용 여부, NULL 건수
- 범위가 끊김 없이 이어지는지, 마지막 파티션만 상한을 포함하는지
위반하면 run을 FAILED_MANIFEST로 커밋한 뒤 422를 반환합니다. 예외로 rollback하지 않는 이유는 실패 원인을 원장에 남기기 위해서입니다.
5. Undo: 과거 시점을 읽는 비용
AS OF SCN이 공짜는 아닙니다. Oracle은 현재 block만으로 과거 SCN의 상태를 만들 수 없을 때 Undo의 이전 정보를 적용해 읽기 일관 block을 재구성합니다. 고정 SCN이 오래될수록, 원천 DML이 많을수록, 파티션 조회가 오래 대기하거나 오래 실행될수록 필요한 Undo가 늘어납니다.
필요한 보존 구간은 가장 긴 SELECT 한 개의 실행 시간이 아닙니다. SCN을 얻은 순간부터 마지막 파티션이 끝날 때까지입니다.
SCN 획득
  → manifest 계산
  → partition queue 대기
  → 마지막 partition SELECT 완료
  + 장애·부하 여유 시간
그래서 운영 기준은 다음 관계를 만족해야 합니다.
실효 Undo 보존 시간 > SCN 획득부터 마지막 파티션 완료까지의 최악 시간 + 안전 여유UNDO_RETENTION은 목표 보존 시간입니다. tablespace 공간이 부족하면 필요한 Undo가 먼저 재사용될 수 있습니다.- Retention Guarantee를 켜면 보존이 강해지지만, Undo 공간이 부족할 때 업무 DML 자체가 실패할 수 있습니다. 그래서 DBA가 업무 부하와 함께 결정할 문제입니다.
DBA와 함께 볼 점검 SQL입니다.
SELECT name, value FROM V$PARAMETER WHERE name = 'undo_retention';

SELECT begin_time, end_time, tuned_undoretention, maxquerylen, ssolderrcnt
  FROM V$UNDOSTAT
 ORDER BY begin_time DESC
 FETCH FIRST 24 ROWS ONLY;

SELECT tablespace_name, retention FROM DBA_TABLESPACES WHERE contents = 'UNDO';| 항목 | 해석 |
|---|---|
undo_retention | 설정된 최소 목표 보존 시간 |
tuned_undoretention | 실제 부하와 공간을 반영해 Oracle이 계산한 보존 시간 |
maxquerylen | 구간 안에서 가장 오래 실행된 query 시간 |
ssolderrcnt | snapshot too old 발생 횟수 |
retention | Undo tablespace의 GUARANTEE/NOGUARANTEE 정책 |
최장 run 시간만 보지 말고, 업무 DML이 몰리는 시간대의 tuned_undoretention, Undo 사용량, ssolderrcnt를 함께 봐야 합니다.
6. ORA-01555: 재시도하지 않고 새 run으로
Undo가 부족하면 스냅샷 오류가 납니다.
| 오류 | 의미 | 처리 |
|---|---|---|
ORA-01555 | 읽기 일관성에 필요한 Undo가 다른 writer에 의해 덮어써짐 | run FAILED_SNAPSHOT_EXPIRED |
ORA-08180 | 지정한 시점·SCN의 스냅샷을 찾을 수 없음 | run FAILED_SNAPSHOT_EXPIRED |
PG-20은 스냅샷 오류가 난 긴 조회를 같은 SCN으로 자동 재시도하지 않습니다. 필요한 Undo가 이미 사라졌다면 같은 SCN으로 다시 해도 성공 가능성이 낮고, 다른 파티션까지 더 오래 붙잡게 됩니다. 실패는 PG-90을 거쳐 API에 바로 보고되고, API는 오류 코드가 ORA-01555/ORA-08180이면 run을 FAILED_SNAPSHOT_EXPIRED로 만듭니다.
복구 절차는 다음과 같습니다.
- 해당 run의 게시가 시작되지 않았음을 확인합니다.
- Oracle Undo 사용량,
tuned_undoretention, 장기 query와 DML 급증을 확인합니다. - Undo 크기·보존 정책, 또는 NiFi 병렬도·파티션 크기를 조정합니다.
- 새 run을 시작합니다. 새 run은 새 SCN, 새 HDFS 경로, 새 staging 테이블을 씁니다.
실패한 파티션만 새 SCN으로 다시 읽어 기존 파일에 붙이는 것은 금지합니다. 그러면 하나의 HDFS run 안에 서로 다른 스냅샷이 섞여, SCN을 고정한 의미가 사라집니다.
시험 환경에서 ORA-01555를 일으켜 확인한 결과, 파티션 조회는 재시도 없이 실패했고 run은 FAILED_SNAPSHOT_EXPIRED가 되었습니다. 검증 단계는 호출되지 않았고, 이어서 실행한 새 run은 새 SCN으로 성공했습니다.
7. 함께 챙겨야 할 함정: 정밀도 없는 NUMBER
SCN과 직접 관련은 없지만, Oracle 추출에서 시험 중 실제로 확인한 함정이 하나 있습니다. PG-20의 ExecuteSQLRecord는 Use Avro Logical Types를 켜서 decimal 타입을 유지한 채 Parquet로 씁니다. 이때 정밀도 없이 선언된 NUMBER 컬럼은 Processor의 Default Decimal Precision/Scale로 기록됩니다.
| 설정 | 결과 |
|---|---|
| 이 프로젝트의 기본값 (38, 10) | 정상 |
| scale 0 | 오류 없이 반올림. 건수는 맞고 금액 합계만 다름 (71,853,600 vs 원본 71,853,075) |
| 정수부 초과 (precision 41) | 파티션 SQL_ERROR → run FAILED_EXTRACT |
가장 위험한 것은 두 번째 행입니다. 오류 없이 값이 바뀌고, 건수 검증으로는 잡히지 않습니다. 금액 합계 같은 품질 지표를 단계마다 비교하는 이유가 여기에 있습니다(3편). 가능하면 추출 컬럼에서 CAST(AMOUNT AS NUMBER(18,2))처럼 정밀도를 명시하는 것이 가장 확실합니다.
8. 보장하는 것과 보장하지 않는 것
| 구분 | 보장 여부 |
|---|---|
| 한 run 안 모든 manifest·파티션이 같은 Oracle 스냅샷 | 보장 |
| 추출 중 원천 DML 차단 | 차단하지 않음 |
| HDFS run 경로가 한 SCN 기준으로 구성됨 | 모든 파티션 성공 시 보장 |
| Undo가 부족한 상태에서 과거 스냅샷 재구성 | 보장하지 않음. run 실패 |
| 실패 파티션만 새 SCN으로 교체 | 허용하지 않음 |
| SCN을 이용한 증분 CDC | 제공하지 않음 |
| 서로 다른 Job(테이블)끼리 같은 SCN | 현재 보장하지 않음 |
여러 테이블의 SCN 경계
원천 테이블마다 Job PG가 따로 있고, 각 PG-10이 자체적으로 SCN을 조회합니다. 따라서 테이블 하나 안의 파티션들은 일관되지만, 테이블끼리는 SCN이 조금씩 다를 수 있습니다.
업무 요구사항이 "각 테이블의 일관된 스냅샷"이면 현재 구조로 충분합니다. 하지만 PK/FK 관계나 회계 마감처럼 "여러 테이블 전체가 정확히 같은 시점"이어야 한다면 확장이 필요합니다. 상위 coordinator가 공통 SCN을 한 번 조회해 모든 Job run에 넘기고, 전체 성공을 묶는 batch 단위 상태와 실패 정책을 추가하는 방식입니다. 이때 공통 SCN의 Undo 보존 시간은 가장 늦게 끝나는 테이블까지 계산해야 합니다. 이 기능은 현재 구현 범위가 아니므로, 도입 전에 업무 요구사항으로 명시해야 합니다.
9. 운영 전 체크리스트
- 조회 계정 권한: 대상 테이블
SELECT·FLASHBACK,SYS.V_$DATABASESELECT UNDO_RETENTION과 Undo 크기가 run 최대 소요 시간보다 넉넉한지 DBA와 확인- 대상 테이블마다
(업무 조건 컬럼, split 컬럼)인덱스와 manifest SQL 실행 계획 확인 - 승인된 동시 세션 수에 맞춰 Oracle 연결 풀 크기와 PG-20 Concurrent Tasks 결정
- split 컬럼에 NULL이 있는 테이블 확인
- 정밀도 없는
NUMBER컬럼은CAST로 정밀도 명시
마치며
병렬 추출의 일관성은 "빨리 읽어서 차이를 줄이는" 방식으로는 보장할 수 없습니다. 이 프로젝트는 논리적 시점(SCN) 하나와 여러 개의 실제 병렬 실행 시각을 분리했습니다. 각 파티션이 어느 노드에서 언제 실행되든 같은 커밋 상태를 읽고, 그 대가로 필요한 Undo 보존을 운영 조건으로 명시했습니다. Undo가 모자라면 억지로 이어 붙이지 않고 새 run으로 다시 시작합니다.
다음 3편에서는 이렇게 병렬로 끝난 파티션들의 완료를 누가, 어떻게 딱 한 번 판정하고 다음 단계로 넘기는지 Load Control API의 설계를 다룹니다.