
Airflow 3.3 Celery 워커가 조용히 멈추는 이유 — Redis Sentinel 타임아웃 누락
Airflow 3.3.0 CeleryExecutor + Redis Sentinel 환경에서 브로커 연결이 끊긴 뒤 워커가 active 상태로 영구 행에 빠지고 태스크가 5분 뒤 failed/skipped 되는 장애의 원인을 로그와 소켓 상태로 추적하고, sentinel_kwargs 타임아웃과 operation_timeout으로 자가 복구하게 만든 과정을 정리했습니다.
Airflow DAG을 실행했는데 태스크가 queued에서 움직이지 않다가 약 5분 뒤 failed나 skipped로 끝납니다. airflow-worker 서비스는 active이고, 워커 로그에는 Connection closed by server 한 줄 뒤로 아무것도 남지 않습니다. 워커를 재기동하면 바로 정상으로 돌아옵니다.
이 글은 Airflow 3.3.0 CeleryExecutor + Redis Sentinel 환경에서 실제로 겪은 이 장애를 다룹니다. 원인은 Airflow나 Redis의 버그가 아니라 Sentinel 질의에 타임아웃이 설정되지 않은 것이었습니다. 로그와 소켓 상태로 원인을 좁혀 간 과정과, 설정 두 파일을 고쳐 워커 재기동 없이 스스로 복구하게 만든 방법을 정리합니다.
환경은 Airflow 3.3.0(CeleryExecutor), Redis Sentinel 3노드(master_name=redis-ha), systemd로 운영하는 Airflow 노드 3대입니다. 테스트 클러스터(10.0.1.112~114)에서 같은 장애를 재현하고, 수정 후 같은 장애를 다시 주입해 자가 복구를 확인했습니다.
1. 증상: 서비스는 active인데 일을 하지 않는다
- DAG을 실행하면 태스크가
queued상태로 오래 머물다가 약 5분 뒤failed/skipped처리되는 일이 반복됩니다. systemctl status airflow-worker는 active입니다. 겉보기에는 정상입니다.- 워커 로그에
Connection closed by server가 찍힌 뒤로 아무 로그도 없습니다. 재연결을 시도한 흔적도 없습니다. - 워커를 재기동하면 즉시 정상화됩니다.
마지막 항목 때문에 "가끔 워커를 재시작하면 되는 문제"로 넘기기 쉽습니다. 하지만 재기동으로 풀린다는 것 자체가 원인을 가리키는 단서입니다.
2. 증거: 로그와 소켓이 말해 주는 것
워커 — 연결이 끊긴 뒤 영구 침묵
Oct 13 20:48:45 test2.lab.data-dynamics.local airflow[19583]: redis.exceptions.ConnectionError: Connection closed by server.7분이 지나도 이 줄이 마지막입니다. 정상이라면 수 초 안에 Connected to sentinel://... 재연결 로그가 찍혀야 합니다.
워커 소켓 — 응답 없는 Sentinel을 기다리는 중
$ ss -tnp | grep celery
ESTAB      0  0  10.0.1.112:39334  10.0.1.112:26379  (celeryd)
CLOSE-WAIT 1 0 10.0.1.112:35478 10.0.1.112:6379 (celeryd)26379(Sentinel)로 맺은 연결은 ESTABLISHED입니다. TCP는 연결돼 있지만 응답이 오지 않아, 워커가 응답을 계속 기다리고 있습니다.6379(Redis master)로 맺은 연결은 CLOSE-WAIT입니다. 서버가 끊은 연결을 워커가 정리하지 못하고 남겨 두었습니다.- 정상인 다른 Sentinel(113·114)로는 연결을 시도조차 하지 않았습니다. 워커는 broker URL 목록의 첫 번째 Sentinel에 묶여 있었습니다.
스케줄러 — publish 타임아웃, 그리고 5분 뒤 재시도
[error] Process timed out  [task] loc=timeout.py:38
[info ] [Try 3 of 3] Celery Task Timeout Error for Workload: (('ha_failover_test', 'probe_17', ...))
[info ] Marking task as UP_FOR_RETRY ...
스케줄러는 태스크를 브로커에 넣는(publish) 단계에서 타임아웃이 나고 있었습니다. 3번 시도해도 실패하면 태스크를 up_for_retry로 돌립니다.
3. 원인 분석
근본 원인 — Sentinel 질의에 타임아웃이 없다
장애는 다음 순서로 진행됩니다.
- Redis failover나 짧은 네트워크 장애로 브로커 연결이 끊깁니다(
Connection closed by server). - 워커(kombu/redis-py)는 다시 연결하기 위해 broker URL 목록의 첫 번째 Sentinel에
SENTINEL get-master-addr-by-name을 보냅니다. - 그런데 기존 설정의
sentinel_kwargs에는{"password": ...}만 있고socket_timeout이 없습니다. - 첫 번째 Sentinel이 하필 "TCP는 연결되지만 응답하지 않는" 상태(전환 중인 노드, half-open 연결, 멈춘 프로세스)라면, 워커는 이를 실패로 판정할 방법이 없어 blocking read에서 영원히 기다립니다. 다음 Sentinel로 넘어가는 로직은 오류가 났을 때만 동작하는데, 응답이 없는 것은 오류가 아니기 때문입니다.
- 이 대기는 Celery consumer의 메인 루프에서 일어납니다. 그래서 프로세스는 살아 있지만(active) 작업 수신과 하트비트가 모두 멈추고, 예외가 없으니 로그도 남지 않습니다.
- 인프라가 몇 초~몇 분 만에 복구돼도 이미 갇힌 연결은 풀리지 않습니다. 클라이언트 쪽 keepalive도 없기 때문입니다. 워커를 재기동하면 새 연결이 그 시점에 정상인 Sentinel에 붙으므로 즉시 복구됩니다. "재기동하면 정상화"되는 이유가 바로 이것입니다.
2차 원인 — publish 타임아웃 1초 ("5분 뒤 skipped"의 정체)
- 스케줄러의 CeleryExecutor는 태스크 하나를 publish하는 작업을
[celery] operation_timeout안에 끝내야 합니다. 기본값은 1.0초입니다. - 장애 중에는 publish할 때마다 Sentinel에서 master를 찾는 과정을 거칩니다. 무응답 Sentinel이 끼어 있으면 1초를 넘기고,
[Try N of 3] Celery Task Timeout Error가 3번 나면 태스크는up_for_retry가 됩니다. - 이 DAG은 재시도가 설정돼 있었고, Airflow의 기본 재시도 간격(
retry_delay)은 300초(5분) 입니다. 5분 뒤 다시 시도해도 실패하면 태스크는 최종failed가 되고, 트리거 룰에 따라 하위 태스크는skipped가 됩니다.
장애 흐름 정리
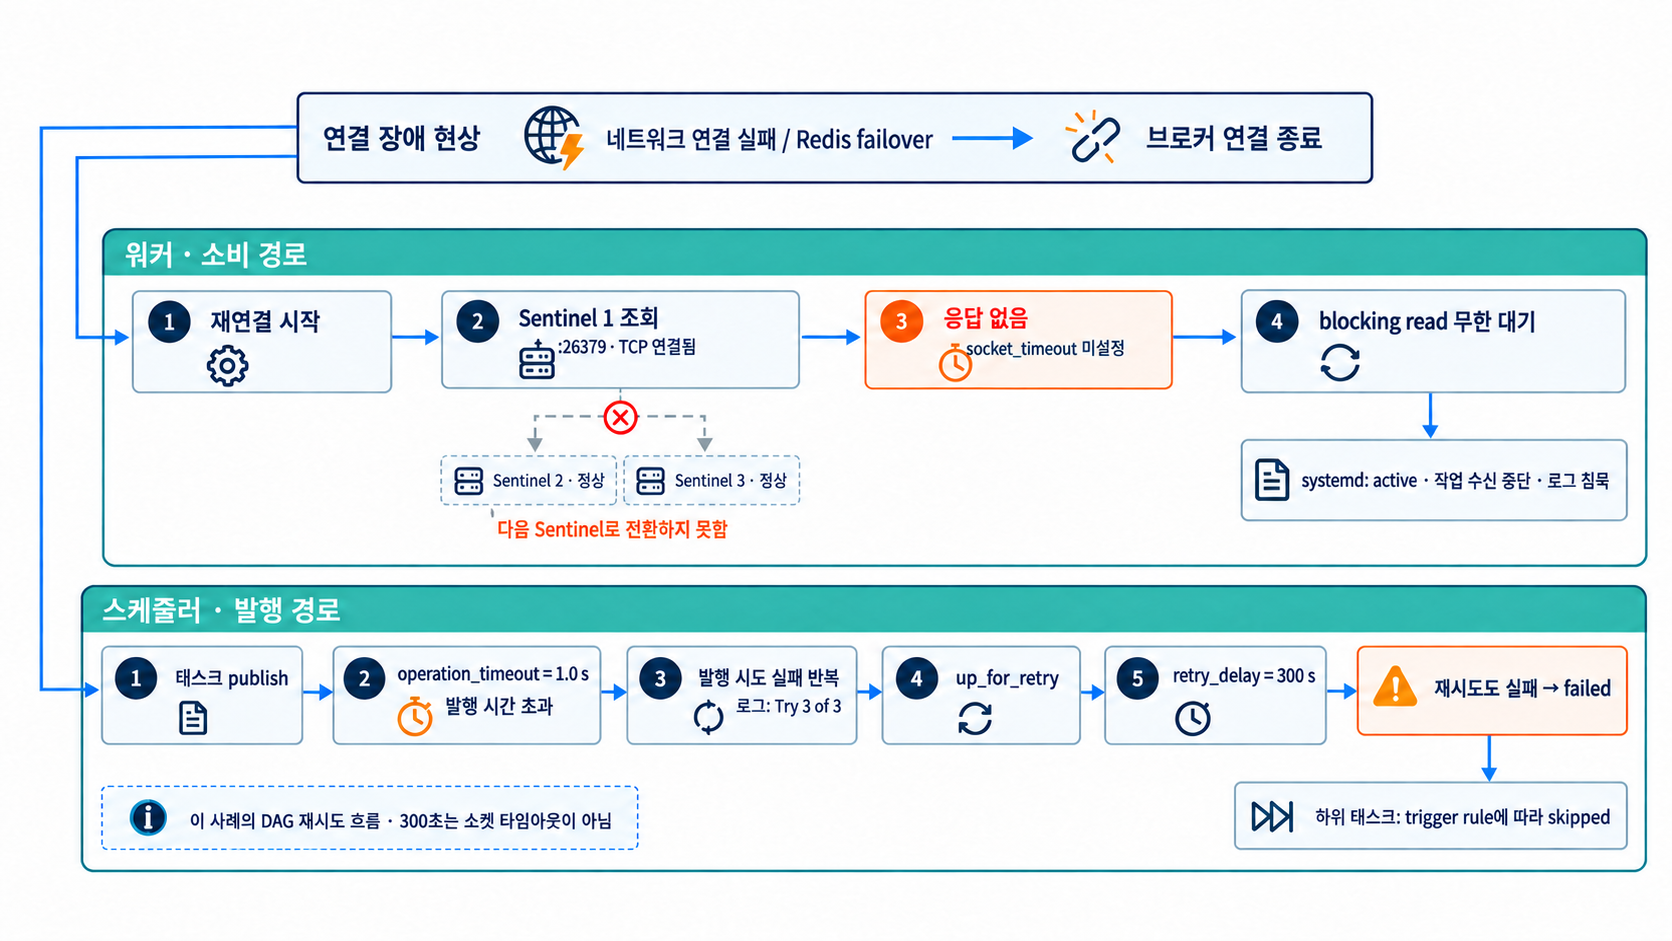
그림 1. 같은 장애 상황에서 나타나는 워커의 소비 중단과 스케줄러의 발행 실패를 나누어 본 흐름입니다. 워커는 다음 Sentinel로 넘어가지 못하고, 스케줄러는 별도의 publish 제한에 걸립니다. 이 사례의 5분 대기는 소켓 타임아웃이 아니라 DAG의 재시도 간격입니다.
네트워크 연결 실패 / Redis failover
  → Redis가 클라이언트 연결을 종료 ("Connection closed by server")
  → 워커가 재연결 시도: 첫 번째 Sentinel이 하필 무응답 (전환 중 / half-open)
  → 타임아웃이 없어 영구 대기 (서비스는 active, 로그는 침묵)
  → 태스크는 queued로 방치 + publish 타임아웃 → 5분 뒤 failed/skipped 반복
  → 워커를 재기동해야만 복구
4. 해결: 설정 파일 두 개 수정 + 순차 재시작
수정할 파일은 노드마다 2개이며, 모든 Airflow 노드(워커·스케줄러가 함께 있는 노드 전부)에 똑같이 적용합니다. 경로는 이 환경 기준입니다.
| 파일 | 수정 내용 |
|---|---|
/opt/airflow/airflow-secrets.env | SENTINEL_KWARGS에 소켓 타임아웃 추가 (핵심) |
/opt/airflow/airflow.cfg | [celery] operation_timeout, [celery_broker_transport_options] 타임아웃·keepalive 추가 |
4.1 Sentinel 질의에 타임아웃 넣기 (핵심 수정)
airflow-secrets.env에서 AIRFLOW__CELERY_BROKER_TRANSPORT_OPTIONS__SENTINEL_KWARGS 줄을 찾아 JSON에 타임아웃 두 개를 추가합니다. 파일 권한(600)과, 값 전체를 작은따옴표로 감싼 형태는 그대로 둡니다.
# 변경 전
AIRFLOW__CELERY_BROKER_TRANSPORT_OPTIONS__SENTINEL_KWARGS='{"password": "<sentinel 비밀번호>"}'

# 변경 후
AIRFLOW__CELERY_BROKER_TRANSPORT_OPTIONS__SENTINEL_KWARGS='{"socket_timeout": 2, "socket_connect_timeout": 2, "password": "<sentinel 비밀번호>"}'
socket_timeout: 2— 응답 없는 Sentinel을 2초 만에 포기하고 다음 Sentinel로 넘어갑니다. 영구 행을 직접 막는 설정입니다.socket_connect_timeout: 2— Sentinel에 TCP 연결을 맺는 단계에서 오래 묶이는 것을 막습니다.- Sentinel 인증을 쓰지 않으면
password없이 타임아웃 두 개만 넣습니다. 이 줄이 아예 없는 환경이라도 반드시 추가해야 합니다.
환경변수는 airflow.cfg보다 우선합니다. 같은 키를 양쪽에 두면 환경변수의 JSON이 통째로 쓰이고 두 값이 합쳐지지 않으므로, 인증 정보와 타임아웃을 한 곳에 함께 적어야 합니다.
4.2 publish 타임아웃과 브로커 연결 옵션
airflow.cfg의 [celery] 섹션에 다음을 추가하거나 값을 바꿉니다.
[celery]
# 기본 1.0초. Sentinel 1대가 무응답이어도 publish가 성공하도록
# Sentinel 타임아웃 합(2초 × N)보다 크게 잡는다.
# 태스크 실행시간 제한이 아니다.
operation_timeout = 10.0
[celery_broker_transport_options] 섹션에는 다음을 추가합니다. master_name 등 기존 값은 그대로 둡니다.
[celery_broker_transport_options]
# Sentinel의 monitor 설정 이름과 정확히 같아야 한다.
master_name = redis-ha

# Redis 데이터 연결의 소켓 읽기·쓰기 대기 제한.
socket_timeout = 3

# Redis 데이터 서버에 TCP 연결을 맺을 때의 대기 제한.
socket_connect_timeout = 2

# 끊어진 연결 감지를 보조한다. 실제 감지 시간은 OS keepalive 설정을 따른다.
socket_keepalive = True

# 명령 타임아웃 시 재시도. 응답만 유실된 경우 중복 발행될 수 있으므로
# 태스크가 멱등해야 한다.
retry_on_timeout = True

# 한동안 쓰지 않은 연결을 다시 쓸 때 PING으로 확인한다.
# 25초마다 모든 연결을 백그라운드로 점검하는 설정은 아니다.
health_check_interval = 25

# Sentinel 조회 연결용 옵션. 4.1의 환경변수가 있으면 그 값이 우선한다.
sentinel_kwargs = {"socket_timeout": 2, "socket_connect_timeout": 2}

# 워커가 받았지만 ACK하지 않은 메시지를 다시 전달하는 기준.
# 평균이 아니라 "최장 태스크 실행시간 + 대기 여유"보다 길게 잡는다.
# 최장 태스크가 1시간 이내라는 가정의 값이다.
visibility_timeout = 7200
각 값의 의미는 다음과 같습니다.
operation_timeout = 10.0: 무응답 Sentinel 하나를 2초 만에 건너뛰고 다음 Sentinel에서 master를 찾는 데 충분한 시간입니다. 1초로는 Sentinel 하나만 멈춰도 publish가 실패합니다.socket_timeout = 3: 동기 명령의 응답 대기만 제한합니다. kombu의 소비 루프는 epoll 기반이라, 태스크가 없는 유휴 대기나 긴 태스크 실행에는 영향을 주지 않습니다.visibility_timeout: 너무 짧으면 실행 중인 태스크가 다시 전달돼 중복 실행되고, 너무 길면 워커가 강제 종료됐을 때 메시지 복구가 늦어집니다. 최장 태스크 실행시간을 기준으로 정합니다(예: 최장 1020분이면 3600초, 3060분이면 7200초, 2~3시간이면 14400초).
Airflow Celery provider는 이 섹션의 값을 int·bool로, SENTINEL_KWARGS를 JSON으로 자동 변환하므로 타입 문제는 없었습니다.
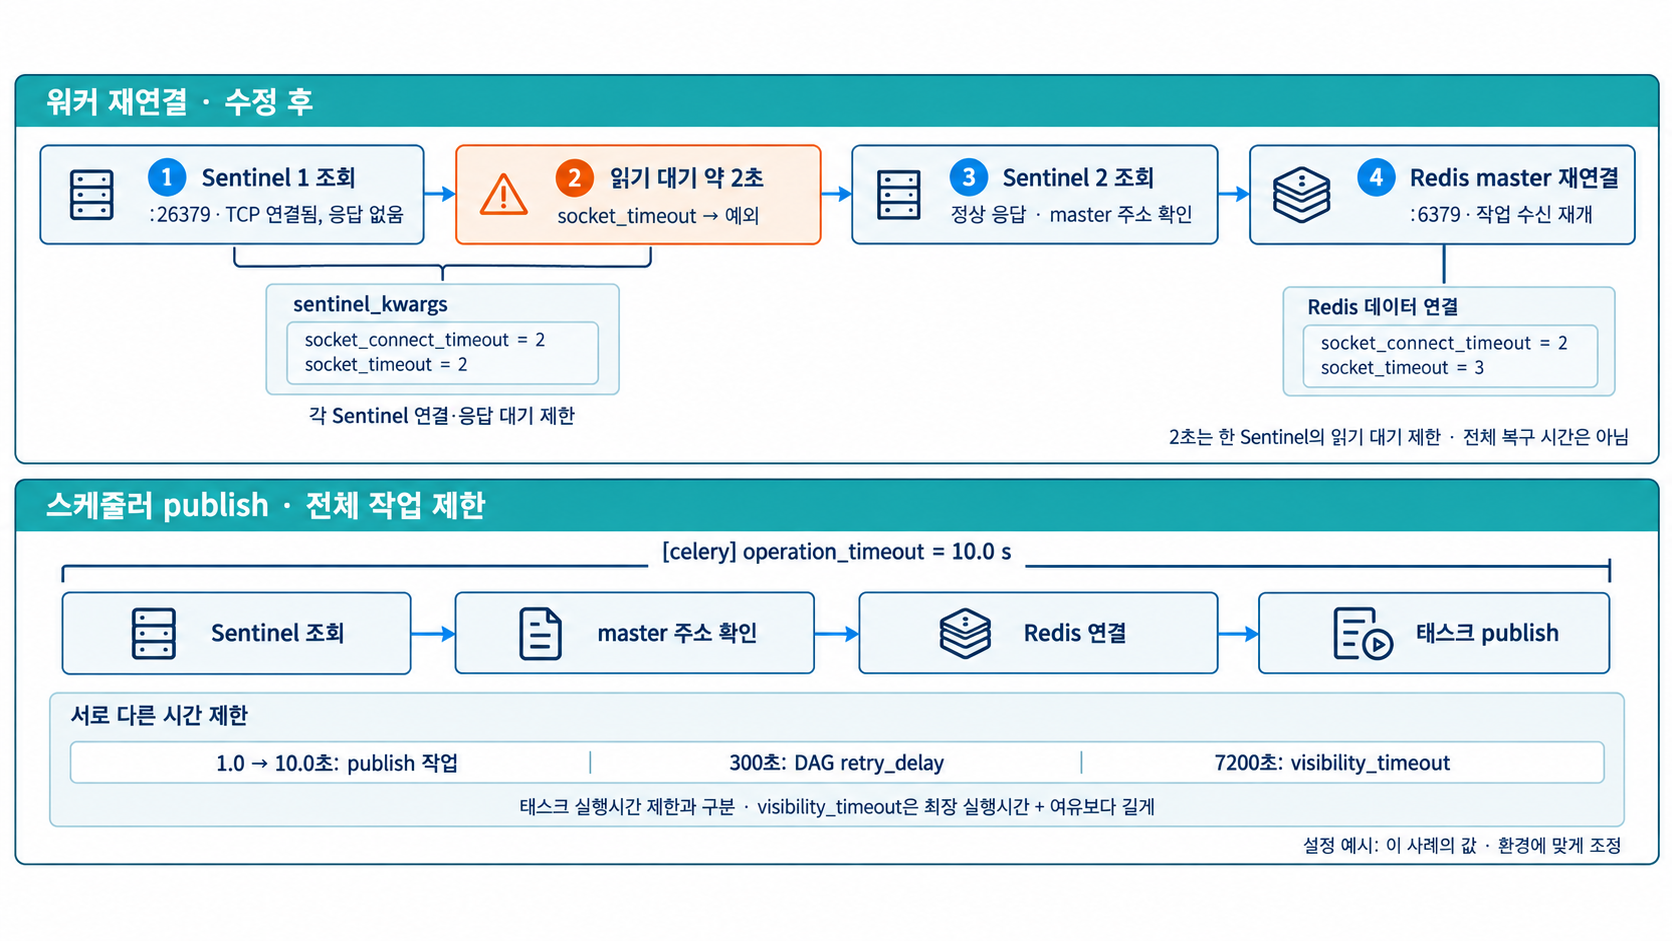
그림 2. 위쪽은 워커의 재연결 순서, 아래쪽은 스케줄러의 publish 작업 범위입니다. sentinel_kwargs는 Sentinel 조회 연결에, 바깥쪽 소켓 옵션은 Redis 데이터 연결에 적용합니다. operation_timeout은 publish 작업 전체를 제한합니다. 그림의 2초는 한 Sentinel의 읽기 대기 제한이며 전체 복구 시간을 보장하는 값은 아닙니다.
4.3 노드별 순차 재시작
설정 파일은 서비스가 시작될 때만 읽히므로 재시작이 필요합니다. 서비스를 멈추지 않으려면 노드를 한 대씩 적용합니다.
# 각 노드에서 한 대씩 순서대로
# 1) 4.1, 4.2의 설정 파일 두 개 수정
vi /opt/airflow/airflow-secrets.env
vi /opt/airflow/airflow.cfg

# 2) 브로커를 쓰는 서비스 재시작 (unit 파일 변경이 아니므로 daemon-reload 불필요)
systemctl restart airflow-worker airflow-scheduler

# 3) 상태를 확인한 뒤 다음 노드로 진행
systemctl is-active airflow-worker airflow-scheduler
journalctl -u airflow-worker --since "2 min ago" | grep -E "ready|Connected to sentinel"
# → "celery@<host> ready." 와 "Connected to sentinel://..." 확인- 재시작 대상은 브로커에 접속하는 worker(소비)와 scheduler(publish) 두 개입니다. api-server, dag-processor, triggerer는 브로커를 쓰지 않으므로 재시작하지 않아도 됩니다.
- 워커를 재시작하면 실행 중인 태스크는 Celery warm shutdown으로 끝까지 실행된 뒤 종료됩니다. 노드별로 순차 적용하면 서비스 영향이 없습니다.
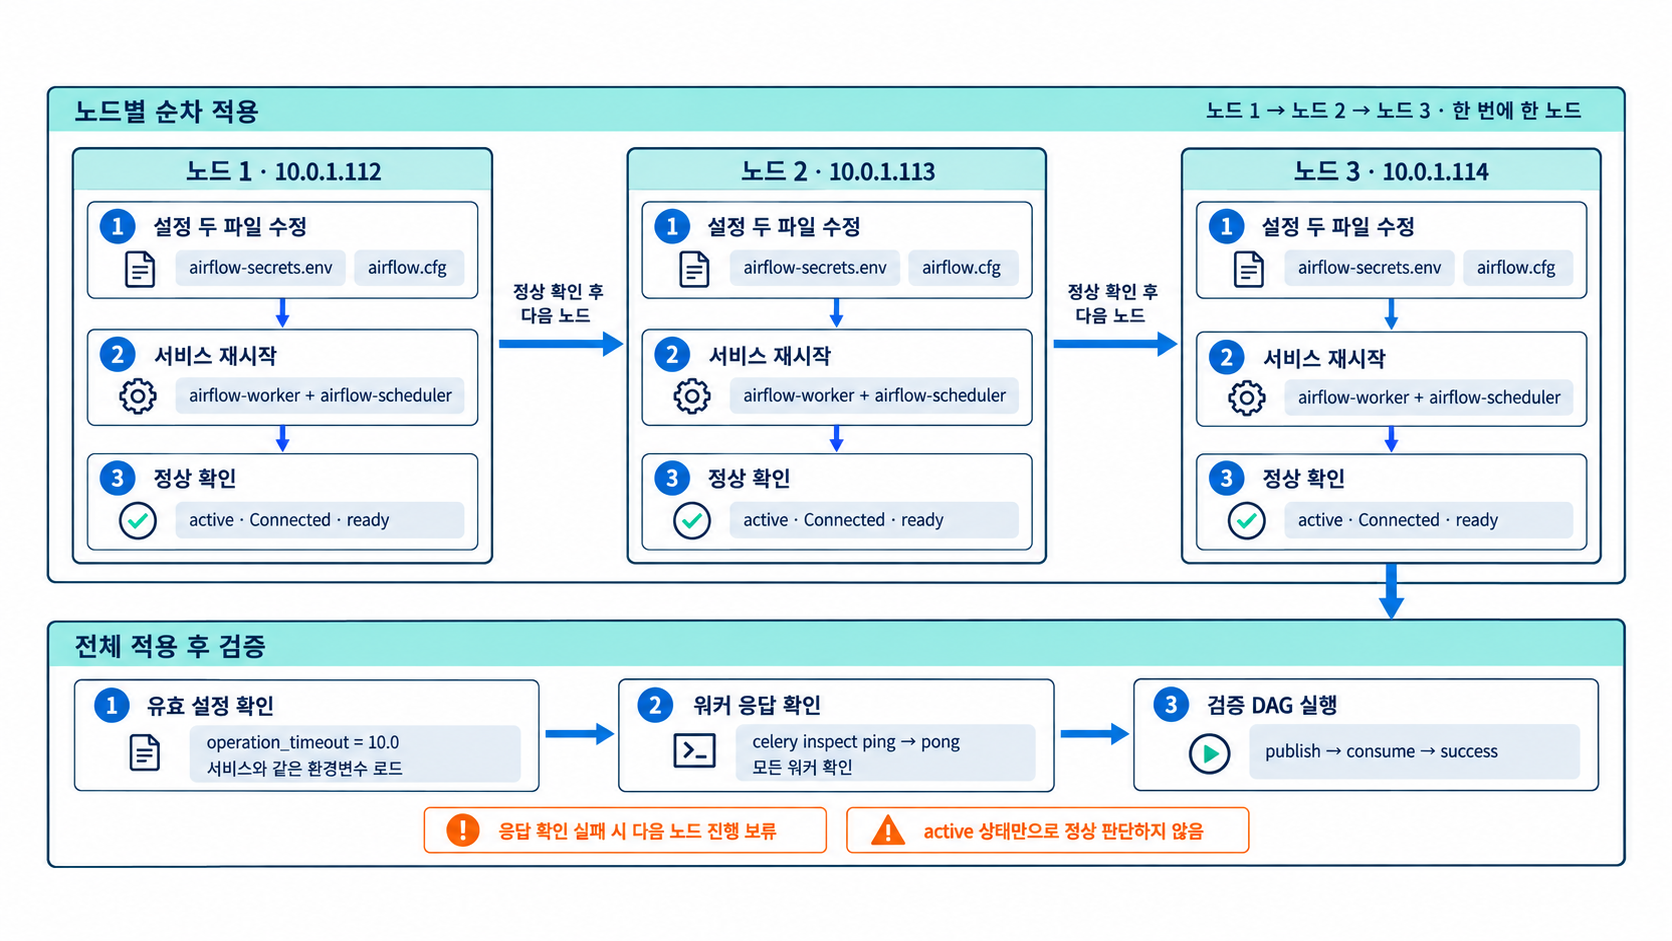
그림 3. 각 노드 안에서 1→2→3을 완료한 뒤 다음 노드로 진행합니다. active 상태와 재연결·준비 로그를 확인하고, 이상이 있으면 다음 노드 적용을 보류합니다. 전체 적용 후에는 아래 4.4의 명령으로 유효 설정, 모든 워커의 pong, 검증 DAG의 성공까지 확인합니다.
4.4 적용 확인
# 설정이 실제로 반영됐는지
airflow config get-value celery operation_timeout
# → 10.0

# 워커가 실제로 응답하는지 (systemd active만으로는 알 수 없다)
celery -A airflow.providers.celery.executors.celery_executor inspect ping
# → 각 celery@<host>: pong

# 검증용 DAG으로 end-to-end 확인
airflow dags trigger <검증용 DAG>
airflow config get-value는 서비스와 같은 환경변수 파일을 읽어 들인 셸에서 실행해야 실제 값을 볼 수 있습니다.
5. 수정 후 검증
테스트 클러스터에서 장애를 일부러 일으켜 수정 전후를 비교했습니다.
| # | 시나리오 | 수정 후 결과 |
|---|---|---|
| 1 | Sentinel 1대를 무응답 상태로 둔 채 전체 연결을 CLIENT KILL | 워커 전원이 스스로 재연결 (무응답 Sentinel을 2초 만에 포기하고 다음 Sentinel로 전환) |
| 2 | 위 조건에서 DAG 트리거 | 24/24 success, 3노드 분산 — publish와 소비 모두 정상 |
| 3 | 정상 상태에서 장애 이벤트 재연 (CLIENT KILL TYPE normal) | 수 초 안에 재연결, 24/24 success, 3노드 균등 분산 — 워커 재기동 불필요 |
수정 전에는 세 시나리오 모두 워커가 영구 행에 빠졌습니다. 수정 후에는 모든 시나리오에서 스스로 복구했습니다. 같은 장애를 주입했을 때 로그도 달라졌습니다.
Oct 13 21:13:02 redis.exceptions.ConnectionError: Connection closed by server.
Oct 13 21:14:33 [info] Connected to sentinel://:**@10.0.1.112:26379//
연결이 끊긴 뒤 침묵하던 워커가 이제는 스스로 Sentinel에 다시 붙습니다.
6. 추가 권고
- 워커 응답성을 모니터링합니다. 이런 장애는 systemd의
active상태로는 잡히지 않습니다. Flower(:5555)나 주기적인celery inspect ping -d celery@<host>결과를 알람에 연결하는 것을 권장합니다. 모니터링 구성은 Airflow 3 모니터링 & 운영에서 다뤘습니다. - (선택) 커널 TCP keepalive를 낮춥니다. half-open 연결을 더 빨리 감지하려면
net.ipv4.tcp_keepalive_time(기본 7200초)을 300~600초로 줄입니다.socket_keepalive = True와 함께 써야 효과가 있습니다.
마치며
이 장애의 핵심은 "응답이 없는 것"이 "오류"로 취급되지 않는다는 점입니다. 클라이언트는 오류가 나야 다음 Sentinel로 넘어가는데, 타임아웃이 없으면 무응답은 영원히 오류가 되지 않습니다. 그 결과 프로세스는 살아 있고, 로그는 조용하고, 일은 하지 않는 상태가 됩니다.
고가용성 구성에서는 연결을 맺는 모든 경로에 타임아웃이 있어야 장애 조치가 실제로 동작합니다. Redis Sentinel을 쓴다면 데이터 연결뿐 아니라 Sentinel 질의(sentinel_kwargs)에도 socket_timeout이 들어가 있는지 확인해 보시기 바랍니다.