
Sqoop 없이 Oracle→Hive 적재하기 (3) — Load Control API로 분산 Flow에서 "한 번만" 보장하기
여러 NiFi 노드에서 병렬로 끝나는 파티션의 완료를 판정하고, 검증과 게시를 run당 딱 한 번만 실행하기 위해 만든 Load Control API의 설계를 정리했습니다. 상태 모델, claim token과 CAS, transactional outbox와 ACK, sweeper, 그리고 게시 결과가 불명확할 때 자동으로 다시 게시하지 않는 PUBLISH_UNKNOWN까지 다룹니다.
2편까지 오면 각 파티션은 같은 SCN으로 데이터를 읽어 HDFS에 Parquet로 씁니다. 남은 문제는 분산 시스템의 고전적인 질문들입니다.
- 여러 노드에서 병렬로 돈 파티션이 모두 끝났는지 누가 판정하는가?
- 마지막 파티션 두 개가 동시에 끝나면, 다음 단계(검증)가 두 번 시작되지는 않는가?
- 게시(
INSERT OVERWRITE)를 보냈는데 응답이 끊기면, 성공한 것인가 실패한 것인가?
이 글은 이 질문들에 답하기 위해 만든 Load Control API(Python FastAPI + PostgreSQL)의 설계를 다룹니다.
| 편 | 주제 |
|---|---|
| 1편 | 전체 아키텍처: Data Plane과 Control Plane |
| 2편 | Oracle SCN으로 병렬 추출의 일관성 지키기 |
| 3편 (이 글) | Load Control API: 분산 Flow에서 "한 번만"을 보장하는 법 |
| 번외편 | NiFi에서 Oracle timestamp를 문자열로 적재하기 |
1. API는 데이터를 옮기지 않는다
Load Control API는 데이터를 한 건도 직접 옮기지 않습니다. PostgreSQL nifi_ops 스키마의 원장에 상태를 기록하고 판정할 뿐입니다.
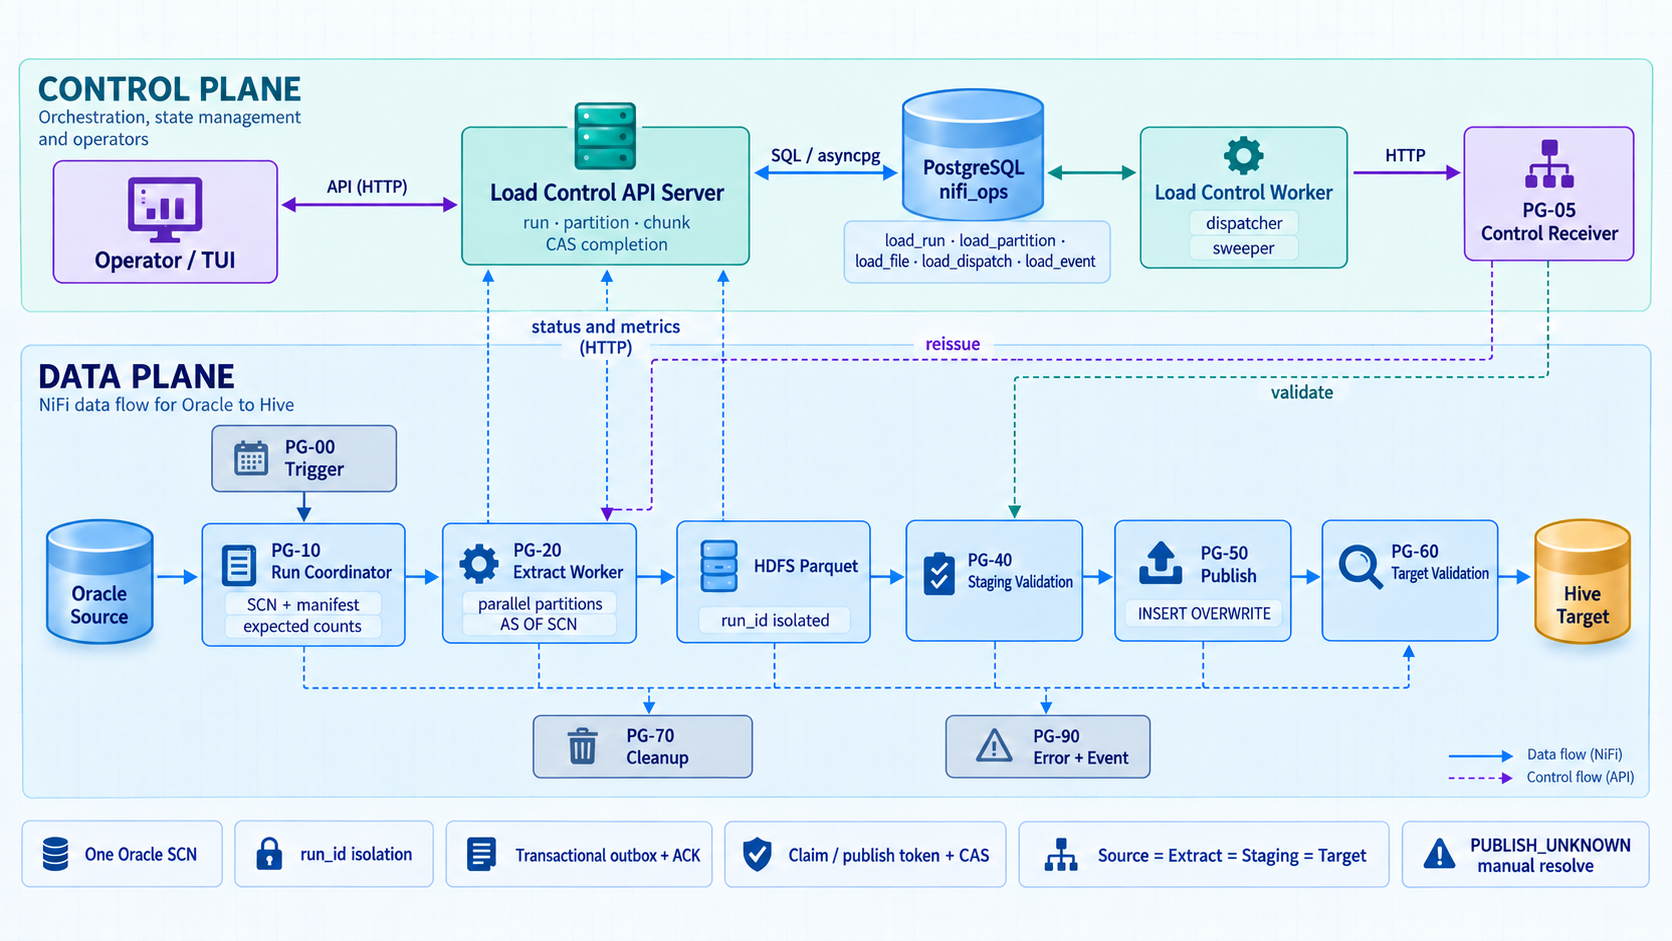
| 구성 | 책임 |
|---|---|
| API server | HTTP 요청, 인증, 입력 검증, 트랜잭션, 상태 판정 |
| API worker (dispatcher) | NiFi 후속 호출(outbox)을 PG-05에 최소 1회 전달 |
| API worker (sweeper) | 정체와 timeout을 주기적으로 찾아 복구 |
| PostgreSQL | 영속 원장, CAS, lock, outbox, 이벤트 |
원장 테이블은 여섯 개입니다.
| 테이블 | 내용 |
|---|---|
load_run | run 상태, SCN, 건수, 경로, 게시, 정리 |
load_partition | 경계, 예상·실제 건수, claim, 시도 횟수 |
load_file | chunk 파일 원장 |
load_validation | SOURCE/STAGING/TARGET 지표 |
load_dispatch | NiFi 호출 outbox |
load_event | 상태 이벤트와 PG-90 오류 이벤트 |
server와 worker를 여러 개 띄워도 DB의 lock, lease, advisory lock으로 경합을 제어합니다. 이 글에 나오는 장치는 대부분 "상태가 X일 때만 Y로 바꾼다"는 조건부 UPDATE(CAS) 의 변형입니다.
2. run 상태 모델
run은 다음 상태를 거칩니다.
첫 번째 장치는 run 생성 단계에 있습니다. 같은 job_key + business_key에는 활성 run이 하나만 존재할 수 있습니다. PostgreSQL의 partial unique index로 강제하므로, 같은 업무일자로 Trigger가 두 번 실행되어도 두 번째 요청은 409 DUPLICATE_ACTIVE_RUN을 받고 기존 run에는 영향이 없습니다. PUBLISH_UNKNOWN도 운영자가 확정하기 전까지는 활성 run으로 취급되어 새 run을 막습니다.
3. 파티션 소유권: claim token
PG-10이 등록한 파티션은 Round Robin으로 NiFi 노드들에 흩어집니다. 재전송이나 재발행 때문에 같은 파티션 FlowFile이 두 노드에 동시에 도착할 수도 있습니다. 그래서 PG-20은 Oracle을 조회하기 전에 소유권부터 얻습니다.
{ "claimToken": "a-worker-generated-uuid", "workerNode": "nifi-01" }{ "claimed": true, "runStatus": "EXTRACTING", "partitionStatus": "RUNNING", "attempt": 1 }- claim은
PENDING/RETRY → RUNNINGCAS입니다. 한 요청만 성공합니다. - 같은 token으로 다시 요청하면 응답 유실 후 재시도로 보고 다시 성공을 돌려줍니다(멱등).
- 다른 worker가 이미 처리 중이거나 run이 끝났으면
claimed=false입니다. 이것은 오류가 아니라 정상 경합이므로, NiFi는 Oracle을 조회하지 않고 FlowFile을 조용히 종료합니다.
이후 chunk 보고와 실패 보고에는 모두 이 token을 함께 보냅니다. 소유자가 아닌 쪽의 보고는 받지 않습니다.
4. chunk 보고와 완료 판정
PG-20은 Parquet chunk 하나를 HDFS에 쓸 때마다 API에 보고합니다.
{
  "claimToken": "a-worker-generated-uuid",
  "chunkIndex": 2,
  "chunkCount": 3,
  "hdfsPath": "/data/nifi/stage/JOB/run_id=.../part-0000-000002.parquet",
  "recordCount": 5000,
  "byteCount": 183552
}
{
"recorded": true,
"partitionStatus": "SUCCESS",
"runStatus": "EXTRACTED_VALIDATED",
"receivedChunks": 3,
"chunkCount": 3,
"validationScheduled": true
}API는 보고를 받을 때마다 다음을 검사합니다.
- claim token이 현재 소유자와 같은가
chunkIndex < chunkCount인가- HDFS 경로가 run 경로 바로 아래이고
..가 없는가 - 이미 성공한 파티션에 다른 내용이 다시 오지 않았는가
- 모든 chunk index가
0..n-1로 빠짐없이 있고 같은chunkCount를 보고했는가 - 건수 합계가 파티션 예상 건수와 같은가
- 모든 파티션 합계가 원천 건수와 같은가
모든 조건을 만족한 마지막 보고 하나가 run을 EXTRACTED_VALIDATED로 바꿉니다. 마지막 파티션 두 개가 동시에 끝나는 경우를 막기 위해 run 행을 FOR UPDATE로 잠그고 완료 CAS를 수행하므로, 두 보고 중 하나만 run을 전이시킵니다.
그리고 이 마지막 판정과 "검증을 시작하라"는 NiFi 호출 예약(dispatch INSERT)이 같은 트랜잭션입니다. 판정은 됐는데 호출 예약이 유실되거나, 호출만 예약되고 판정이 rollback되는 일이 없습니다. 이것이 다음 절의 transactional outbox입니다.
5. outbox와 ACK: 호출은 최소 1회, 실행은 정확히 1회
API server는 NiFi를 직접 호출하지 않습니다. 호출할 내용을 load_dispatch 테이블에 쓰고, worker의 dispatcher가 이를 꺼내 NiFi root의 PG-05 Control Receiver로 보냅니다.
| dispatch 상태 | 의미 |
|---|---|
PENDING | 전송 대기 또는 backoff 중 |
SENT | PG-05가 2xx로 받았지만, 실제 처리 시작은 아직 확인 안 됨 |
ACKED | 검증 시작(validation/start) 또는 재발행 claim이 도착함 |
DEAD | 영구 오류 또는 최대 시도 초과. 운영자 조치 필요 |
여기서 중요한 구분이 있습니다.
- 202는 수신 확인일 뿐 처리 ACK가 아닙니다. PG-05는 요청 형식만 검사하고 즉시 202를 돌려줍니다. 진짜 ACK는 PG-40이
/validation/start를 호출할 때입니다. 202 직후 NiFi 노드가 죽으면 sweeper가ack_timeout(기본 10분) 뒤 dispatch를 다시 보냅니다. - dispatcher는
FOR UPDATE SKIP LOCKED로 짧게 lease를 잡고, 트랜잭션을 닫은 뒤 HTTP를 호출합니다. 전송 중 worker가 죽으면 lease가 만료된 뒤 다른 worker가 다시 가져갑니다. - 그래서 전달 보장은 최소 1회(at-least-once) 입니다. 같은 검증 호출이 두 번 도착할 수 있고, 중복은 수신 측의 CAS가 제거합니다.
6. 검증 시작도 CAS로
PG-40은 검증을 시작하기 전에 API에 시작을 알립니다. 첫 호출만 started=true 를 받고, 같은 dispatch가 다시 와도 두 번째부터는 PG-40 안에서 조용히 종료됩니다.
{
  "started": true,
  "runStatus": "STAGE_VALIDATING",
  "snapshotScn": "2388556",
  "hdfsRunPath": "...",
  "stageTable": "...",
  "sourceCount": 105000,
  "extractedCount": 105000,
  "sourceMetrics": { "AMOUNT_SUM": "71853075", "MIN_TS": "...", "MAX_TS": "..." }
}
응답에 HDFS 경로, staging 테이블, 원천 기대값이 모두 들어 있는 이유가 있습니다. 검증 FlowFile은 API worker가 새로 만든 요청에서 출발하므로 PG-10의 attribute를 하나도 갖고 있지 않습니다. 필요한 값은 모두 원장에서 다시 받아옵니다.
PG-40은 run 경로를 LOCATION으로 하는 Hive external table을 만들고, 다음 지표를 계산해 보고합니다.
| 지표 | 통과 조건 |
|---|---|
STAGE_COUNT | staging = source = extracted |
NULL_SPLIT_COUNT | 0 |
DUP_PK_COUNT | 0 |
AMOUNT_SUM | 원천 합계와 같음 |
MIN_TS, MAX_TS | 원천 범위와 같음 |
PASS/FAIL은 NiFi가 계산하지만, API는 그 판정을 그대로 믿지 않습니다. stage-validated 요청을 받으면 저장된 지표를 다시 읽어 FAIL이 하나도 없고 지표가 비어 있지 않을 때만 STAGING_VALIDATED로 전이합니다. PG-60의 target 검증과 최종 SUCCESS도 같은 방식입니다.
7. 게시: publish token과 PUBLISH_UNKNOWN
게시(PG-50)는 되돌리기 어려운 단계입니다. target 파티션을 INSERT OVERWRITE로 교체하기 때문입니다.
- PG-50이 UUID publish token을 만들어
/publish/claim을 호출합니다.STAGING_VALIDATED → PUBLISHINGCAS에 성공한 token 하나만 게시 SQL을 실행합니다. INSERT OVERWRITE는 자동 재시도하지 않습니다.- 결과를
/publish/result로 보고합니다. 결과는PUBLISHED,FAILED_PUBLISH,PUBLISH_UNKNOWN중 하나입니다.
왜 실패를 "불명"으로 보고하는가
Hive 게시에 쓰는 PutClouderaHiveQL은 실패 relationship만으로는 SQL이 제출되지도 않았는지, 실행 중에 끊겼는지 구분할 수 없습니다. 실패해도 오류 attribute를 남기지 않는다는 점도 시험에서 확인했습니다. 실행 중에 끊겼다면 target이 이미 바뀌었을 수 있습니다. 이 상태에서 자동으로 다시 게시하면 무엇이 정답인지 더 모르게 됩니다.
그래서 이 프로젝트는 성공이 확인된 경우 외에는 모두 PUBLISH_UNKNOWN으로 보고합니다. PUBLISHING에 너무 오래 머문 run도 sweeper가 publish_stale(기본 2시간) 뒤 PUBLISH_UNKNOWN으로 바꿉니다. PUBLISH_UNKNOWN은 종료 상태가 아니고, 운영자가 확정하기 전까지 같은 업무일자의 새 run도 막습니다.
운영자의 확정 절차는 다음과 같습니다.
- 해당 Job의 Trigger와 수동 재실행을 멈춥니다.
- run ID, 게시 시작 시각, Hive query ID를 확보합니다.
- Hive query history에서 compile/submit/execute/commit 여부를 확인합니다.
- target 파티션의 건수와 모든 품질 지표를 source/staging과 비교합니다.
- 게시가 확실히 완료됐으면
PUBLISHED, 변경되지 않았거나 확실히 실패했으면FAILED_PUBLISH로 확정합니다.
curl -X POST \
  -H 'Authorization: Bearer <operator-token>' \
  -H 'Content-Type: application/json' \
  -d '{"resolution":"FAILED_PUBLISH","reason":"컴파일 단계 실패, target 변경 없음 확인"}' \
  <API>/v1/runs/<run_id>/publish-unknown/resolve
판단 근거는 resolution reason에 남깁니다. 모호하면 임의로 성공 처리하지 않고 target 복구나 업무 승인 절차로 넘깁니다. PUBLISHED로 확정한 경우 PG-60이 자동으로 재개되지 않으므로, target 검증과 후속 처리를 운영 절차에 따라 진행합니다.
참고로 HiveServer2에 연결 자체가 안 되는 경우는 다릅니다. 이때는 Processor가 FlowFile을 입력 큐로 되돌려 계속 재시도하는데, SQL이 제출되기 전이므로 Hive가 복구되면 이어서 처리됩니다. 시험에서도 HiveServer2를 멈춘 동안 DDL 단계에서 대기하다가, 재기동 후 SUCCESS까지 진행했습니다.
8. 실패 보고와 HTTP 응답 규칙
모든 PG의 실패는 PG-90으로 모여 같은 형식으로 정규화됩니다. 단계(load.stage)에 따라 보고 방식이 다릅니다.
| 단계 | 보고 | 결과 |
|---|---|---|
MANIFEST | run 실패 | FAILED_MANIFEST |
EXTRACT, CHUNK_WRITE | claim 성공 시 파티션 실패 | FAILED_EXTRACT 또는 FAILED_SNAPSHOT_EXPIRED |
VALIDATION_START | 이벤트만 | dispatch가 재전송할 수 있음 |
STAGE_VALIDATION | run 실패 | FAILED_STAGE_VALIDATION |
PUBLISH | 이벤트만 | PG-50이 결과를 직접 보고 |
TARGET_VALIDATION | run 실패 | FAILED_TARGET_VALIDATION |
CLEANUP | 이벤트만 | 다음 정리 주기에 재시도 |
run 실패 보고는 expectedStatus와 failStatus를 함께 보내고, 허용된 조합만 받습니다. 예를 들어 STAGE_VALIDATING이 아닌 run을 FAILED_STAGE_VALIDATION으로 만들려고 하면 422 FAIL_TRANSITION_NOT_ALLOWED입니다.
NiFi와 worker는 HTTP 상태별로 다르게 행동합니다.
| HTTP | 예 | 호출자 동작 |
|---|---|---|
| 200 | 처리, 멱등 재요청 | 응답의 boolean·상태로 분기 |
| 202 | PG-05 수신 | worker가 SENT 기록, ACK 대기 |
| 401/403 | token 없음, role 불일치 | 설정 수정. 자동 성공 처리 금지 |
| 404 | run·파티션·route 없음 | 재시도하지 않음 |
| 409 | 중복 활성 run, token·상태 경합 | 재시도하지 않음. 대개 WARN |
| 422 | 입력·manifest·전이 위반 | 설정 또는 Flow 수정 |
| 5xx | DB·API 일시 장애 | backoff 재시도 |
409가 모두 무해한 것은 아닙니다. DUPLICATE_ACTIVE_RUN이나 재발행 직후의 CLAIM_MISMATCH는 정상 경합이지만, CHUNK_CONFLICT는 이미 성공한 파일의 보고 내용이 달라졌다는 뜻이므로 조사해야 합니다.
9. sweeper: 아무도 요청하지 않을 때 일하는 쪽
API server는 요청이 와야 움직입니다. 그런데 NiFi 노드가 죽거나 FlowFile이 사라지면 요청 자체가 오지 않습니다. 이런 정체를 찾는 것이 worker의 sweeper입니다.
| 대상 | 조건 (기본값) | 자동 조치 |
|---|---|---|
| RUNNING 파티션 | heartbeat 정체 > stale (90분) | FAIL이면 run 실패, REISSUE면 재발행 |
| CREATED/EXTRACTING run | 시작 후 > run_timeout (6시간) | run과 미완료 파티션 TIMED_OUT |
| SENT dispatch | ACK 없음 > ack_timeout (10분) | PENDING으로 재전송 또는 DEAD |
| STAGE_VALIDATING/PUBLISHED | 변화 없음 > validation_stale (2시간) | 오류 이벤트만. 상태 유지 |
| PUBLISHING | 게시 > publish_stale (2시간) | PUBLISH_UNKNOWN |
stale은 PG-20의 조회 timeout보다 반드시 커야 합니다. 그렇지 않으면 정상적으로 오래 걸리는 조회를 멈춘 것으로 오판합니다.
REISSUE: 같은 SCN으로 파티션 다시 보내기
기본 복구 모드는 FAIL(멈춘 파티션이 있으면 run 실패 → 새 run)입니다. recovery.mode=REISSUE로 바꾸면, 멈춘 파티션만 같은 run, 같은 SCN으로 다시 보냅니다.
재발행된 파티션은 새 claim token으로 소유권을 다시 얻습니다. 원래 시도가 뒤늦게 살아나서 보고를 보내도, token이 다르므로 409 CLAIM_MISMATCH로 거부됩니다. 파티션별 최대 claim 횟수는 max_attempts(기본 3)입니다. 2편에서 "실패한 파티션만 새 SCN으로 다시 읽는 것은 금지"라고 했는데, REISSUE는 원래 SCN을 그대로 쓰므로 이 원칙과 충돌하지 않습니다.
10. 시험으로 확인한 장애 시나리오
1편의 시험 환경(CFM 4.12 / NiFi 2.6.0 2노드, Oracle 23ai, Hive 4.0.1, PostgreSQL 16)에서 확인한 결과 중 이 글의 장치와 관련된 것입니다.
| 시나리오 | 결과 | 동작한 장치 |
|---|---|---|
| 같은 업무일자 중복 실행 | 409 DUPLICATE_ACTIVE_RUN. 기존 run 영향 없음 | 활성 run partial unique index |
| 파티션 하나의 HDFS 쓰기 실패 | 파티션 FAILED, run FAILED_EXTRACT. 검증 호출과 _SUCCESS 없음 | 전체 건수 일치 전에는 dispatch 없음 |
| chunk 보고 실패 | 2초 안에 파티션 FAILED, run FAILED_EXTRACT (오류 코드 그대로) | PG-90 파티션 실패 보고 |
| API 중단 중 실행 | NiFi가 재시도로 기다렸다가 API 재기동 후 이어서 진행 | 5xx·연결 실패 backoff |
| staging 지표 FAIL (PK 중복) | FAILED_STAGE_VALIDATION. 게시 없음 | API의 지표 재확인 |
| 게시 실패 (없는 컬럼) | PUBLISH_UNKNOWN → 운영자 확정으로 FAILED_PUBLISH | publish token, 자동 재게시 금지 |
| target 지표 FAIL | FAILED_TARGET_VALIDATION. 재게시 없음 | target 재검증 |
파티션 재발행 (REISSUE) | 멈춘 파티션이 22초 뒤 같은 SCN으로 재발행, 2번째 시도에서 성공, run SUCCESS. 늦게 도착한 첫 시도의 보고는 409 CLAIM_MISMATCH. 파일 중복 없음 | sweeper, 새 claim token |
| Job 2개 동시 실행 (PG-05 공유) | 각각 SUCCESS. 한 Job을 지우면 그 경로만 404 | PG-05 Job별 route |
chunk 보고 실패 시나리오는 시험으로 버그를 찾아 고친 사례입니다. PG-90은 "claim에 성공한 Worker의 실패"만 파티션 실패로 보고합니다(8절 표). 그런데 chunk 보고(38_Report_Chunk)가 실패하면 그 오류 응답 본문이 claim 응답을 담고 있던 attribute를 덮어써서, PG-90이 이 Worker가 소유자였는지 알 수 없었습니다. 그래서 실패가 이벤트로만 남고, 파티션은 sweeper의 stale 기준(90분)까지 EXTRACTING에 머물렀습니다. claim 결과를 별도 attribute(partition.claimed)에 남기도록 고친 뒤에는, 보고 실패도 파티션 실패로 보고되어 2초 안에 run이 실패로 끝납니다.
Load Control API 자체 테스트는 140개 중 139개가 통과했습니다. 동시 완료, 중복 보고, 동시 claim, dispatcher 경합, deadlock 재시도, TUI 화면과 운영 작업이 포함됩니다. 나머지 1개는 서버 전체의 LISTEN 연결 수를 세는 테스트라, 같은 DB 서버에서 다른 worker가 돌던 시험 환경에서는 제외했습니다.
11. 운영: 무엇을 보고, 무엇을 하지 않는가
API 호스트에서 bin/monitor.sh로 터미널 대시보드(TUI)를 띄워 활성 run, 파티션 진행률, 검증 지표, dispatch backlog, 경보를 봅니다. 권장 경보는 다음과 같습니다.
| 경보 | 우선도 | 조치 시작점 |
|---|---|---|
PUBLISH_UNKNOWN | 긴급 | 자동 재실행 중지, Hive 이력·target 확인 |
DISPATCH_DEAD | 높음 | PG-05 포트·route·Job PG 확인 |
FAILED_*, TIMED_OUT | 높음 | run 이벤트와 단계별 원인 확인 |
RUN_STALE | 높음 | NiFi 큐·bulletin·Hive query 확인 |
| API 5xx 증가 | 높음 | PostgreSQL, 연결 풀, server 로그 |
재처리 원칙은 짧게 정리할 수 있습니다.
- manifest·추출·staging 검증 실패는 원인을 고친 뒤 새 run으로 전체 재실행합니다.
- 일부 파티션만 새 SCN으로 다시 실행하지 않습니다. 같은 SCN으로 다시 보내는 것은 REISSUE뿐입니다.
- 게시와 target 검증 실패는 자동으로 다시 게시하지 않습니다.
PUBLISH_UNKNOWN은 먼저 확정해야 새 run을 만들 수 있습니다.DEADdispatch는 원인(PG-05 포트, route, Job PG 상태)을 고친 뒤에만 resend합니다. 원인을 고치지 않고 resend만 반복하지 않습니다.- 실패 run의 HDFS 파일과 staging 테이블은 보존 기간(기본: 성공 3일, 실패 14일) 동안 조사 증적으로 남깁니다.
마치며
이 시리즈의 결론은 하나로 모입니다. 분산 Flow에서 "정확히 한 번"은 메시지를 한 번만 보내서 얻는 것이 아니라, 최소 1회 전달과 수신 측의 조건부 상태 전이를 조합해서 얻는다는 것입니다. 파티션 claim, 마지막 완료 판정, 검증 시작, 게시 claim이 모두 같은 패턴입니다. 그리고 결과를 확신할 수 없는 단 하나의 지점(게시)에서는, 자동화보다 멈추고 사람에게 묻는 것을 택했습니다.
NiFi Flow는 데이터를 옮기고 API를 호출하는 일만 하며, 판정은 PostgreSQL 원장 위의 작은 API가 맡습니다. Sqoop 한 번의 실행 안에 숨어 있던 완료 판정을 밖으로 꺼내 명시적으로 만든 것이 이 프로젝트의 핵심입니다. 전체 코드와 매뉴얼은 nifi-sqoop-removal 저장소에 있습니다.