
Sqoop 없이 Oracle→Hive 적재하기 (1) — NiFi와 Load Control API 아키텍처
Kylo ImportSqoop으로 하던 Oracle→Hive 적재를 Cloudera CFM(NiFi 2.6) 표준 Processor와 작은 Python 서비스(Load Control API)로 바꾼 설계를 정리했습니다. 데이터는 NiFi가, 상태와 완료 판정은 API가 맡는 Data Plane / Control Plane 분리와 PG-00~90 구성, 시험 결과를 다룹니다.
Oracle 데이터를 Hive로 적재할 때 쓰던 Sqoop(Kylo ImportSqoop)을 걷어내고, Cloudera CFM 4.12(NiFi 2.6)의 표준 Processor와 작은 Python 서비스로 대체했습니다. 이 시리즈는 그 설계와 구현을 세 편에 나눠 정리합니다. 코드와 전체 매뉴얼은 DataDynamics/nifi-sqoop-removal 저장소에 있습니다.
| 편 | 주제 |
|---|---|
| 1편 (이 글) | 전체 아키텍처: 무엇을 무엇으로 바꿨고, 왜 Data Plane과 Control Plane을 나눴는가 |
| 2편 | Oracle SCN으로 병렬 추출의 일관성 지키기 |
| 3편 | Load Control API: 분산 Flow에서 "한 번만"을 보장하는 법 |
| 번외편 | NiFi에서 Oracle timestamp를 문자열로 적재하기 (logon trigger로 세션 NLS 맞추기) |
1. AS-IS: Kylo + Sqoop
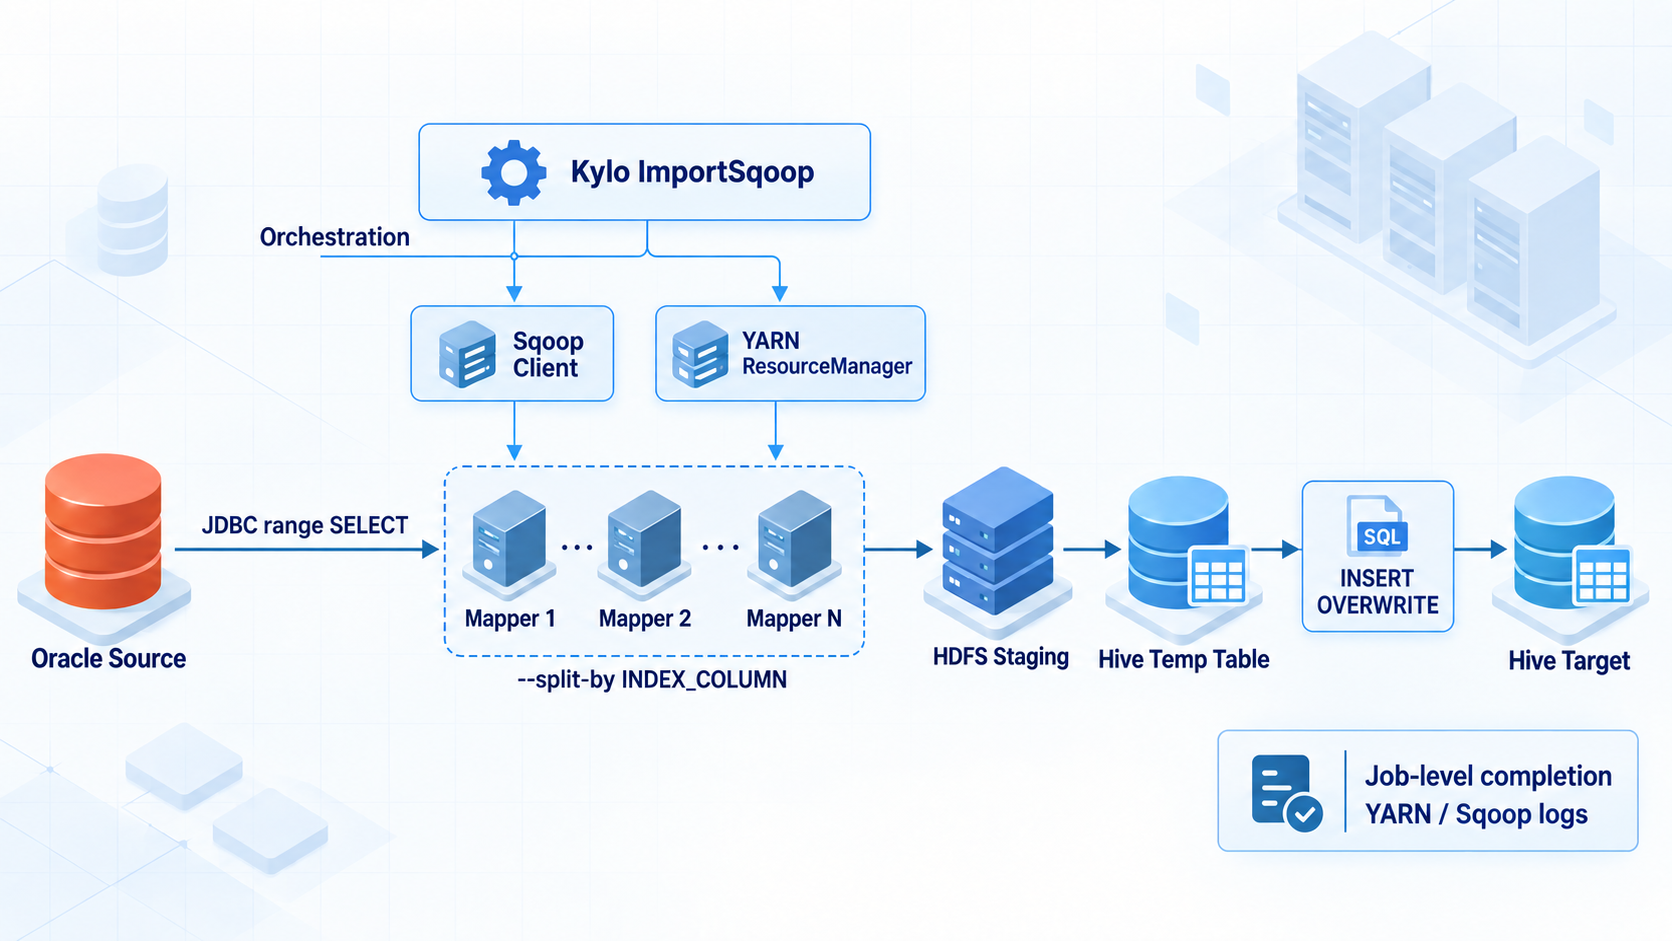
기존 구조는 이렇게 동작했습니다.
- Kylo
ImportSqoop이 Sqoop Client와 YARN Job을 기동합니다. --split-by INDEX_COLUMN으로 나눈 범위를 Mapper 1~N이 Oracle에서 JDBC로 병렬 조회합니다.- Mapper 결과를 HDFS staging에 저장하고, Hive 임시 테이블을 거쳐 target에
INSERT OVERWRITE합니다. - 완료·장애 판정은 Sqoop/YARN Job 상태와 로그에 의존합니다.
Sqoop 한 번의 실행 안에 범위 분할, 병렬 추출, 완료 판정이 모두 묶여 있습니다. 이 구조를 NiFi로 옮기면 첫 번째 질문이 생깁니다. "Mapper 전체가 끝났다"는 판정은 누가 하는가?
2. 무엇을 무엇으로 바꾸는가
Sqoop이 하던 일을 역할별로 쪼개서 각각 다른 구성 요소에 맡겼습니다.
| 기존 역할 | 대체 구성 |
|---|---|
| split 범위 계산 | PG-10이 같은 SCN에서 경계와 예상 건수를 계산 |
| Mapper 병렬 실행 | PG-20이 NiFi 클러스터 노드에 Round Robin으로 분산 |
| Job 전체 완료 판정 | API가 모든 파티션 상태와 chunk 건수를 집계 |
| Mapper 실패 집계 | PG-90이 API에 실패 보고, API가 run을 실패 상태로 전이 |
| HDFS 파일 생성 | PG-20이 Parquet chunk를 run 전용 경로에 기록 |
| 후속 Hive 처리 | PG-40·50·60이 검증·게시·재검증 |
| 임시 산출물 정리 | PG-70이 API가 선정한 대상만 삭제 |
데이터를 옮기는 일은 NiFi로 충분합니다. 문제는 표의 세 번째와 네 번째 행입니다. NiFi Processor는 FlowFile 단위로 독립적으로 실행되기 때문에, 여러 노드에서 병렬로 돈 파티션이 모두 성공했는지, 그리고 그다음 단계를 딱 한 번만 시작하는지를 Flow만으로 원자적으로 판정하기 어렵습니다. 그래서 이 판정을 PostgreSQL 트랜잭션과 CAS(조건부 UPDATE)를 쓰는 별도 API로 분리했습니다.
3. TO-BE: Data Plane과 Control Plane
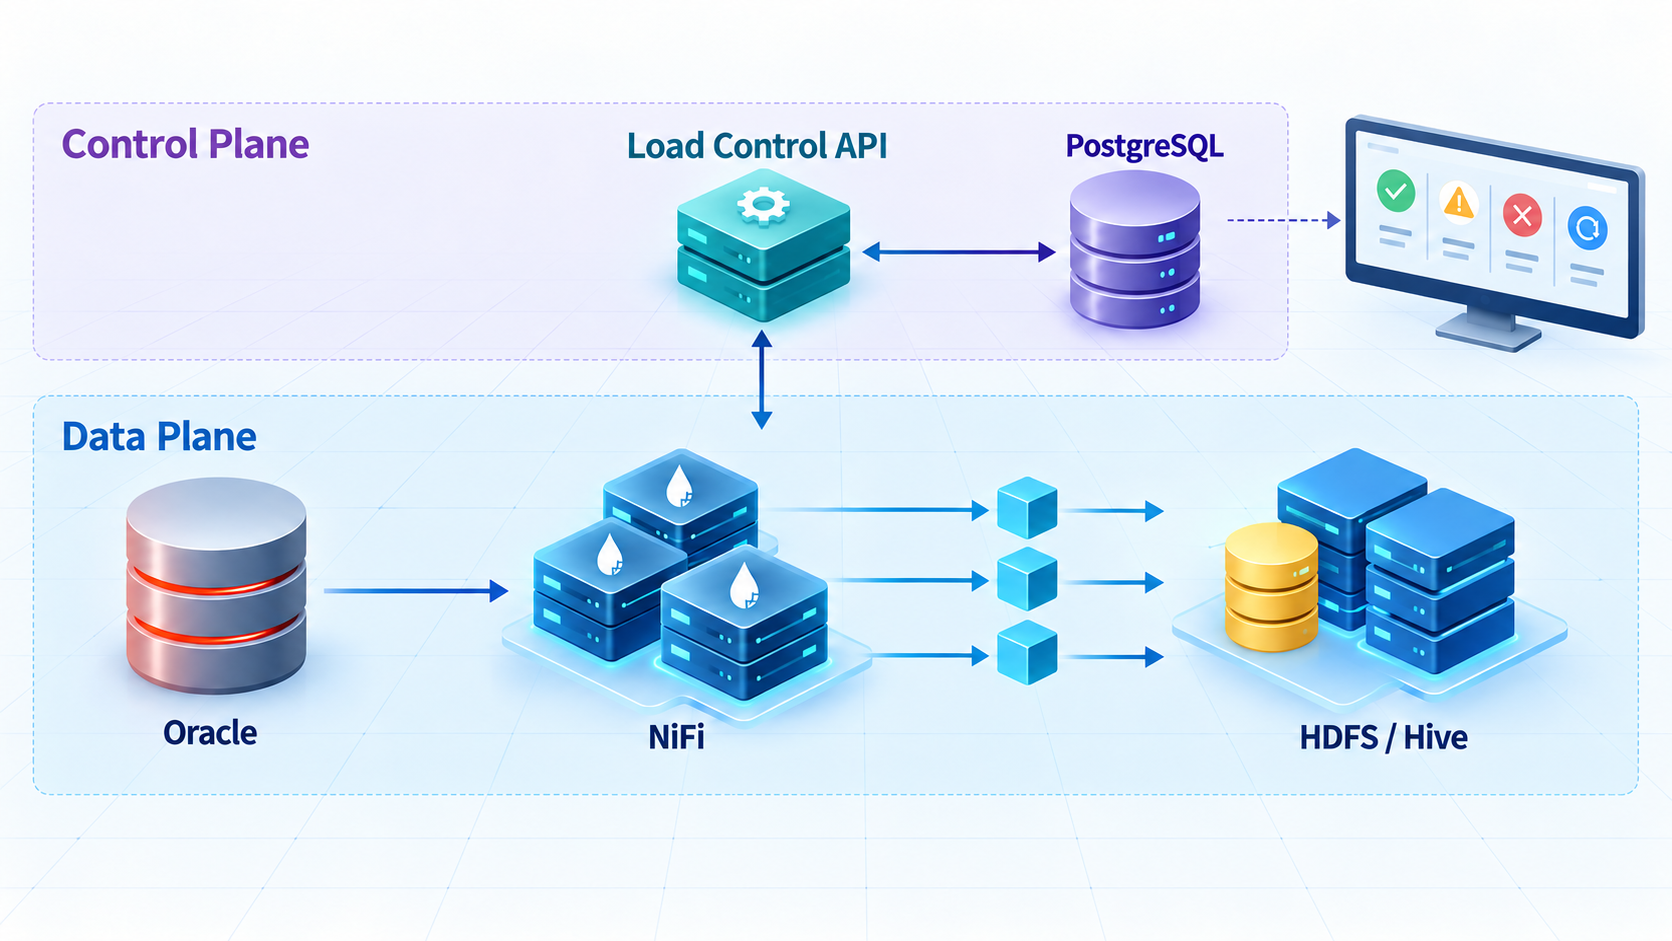
TO-BE는 실제 데이터를 다루는 Data Plane과 상태·완료를 판정하는 Control Plane을 분리합니다.
- NiFi는 데이터만 다룹니다. Oracle 조회, Parquet 변환, HDFS 기록, Hive SQL 실행.
- Load Control API는 상태만 다룹니다. 모든 파티션이 끝났는지 판정하고, 다음 단계를 한 번만 시작시키고, 실패를 기록합니다. API는 데이터를 직접 옮기지 않습니다.
- PostgreSQL(
nifi_ops스키마)이 실행 상태의 원장입니다. 원장에 쓰는 것은 API 하나입니다.
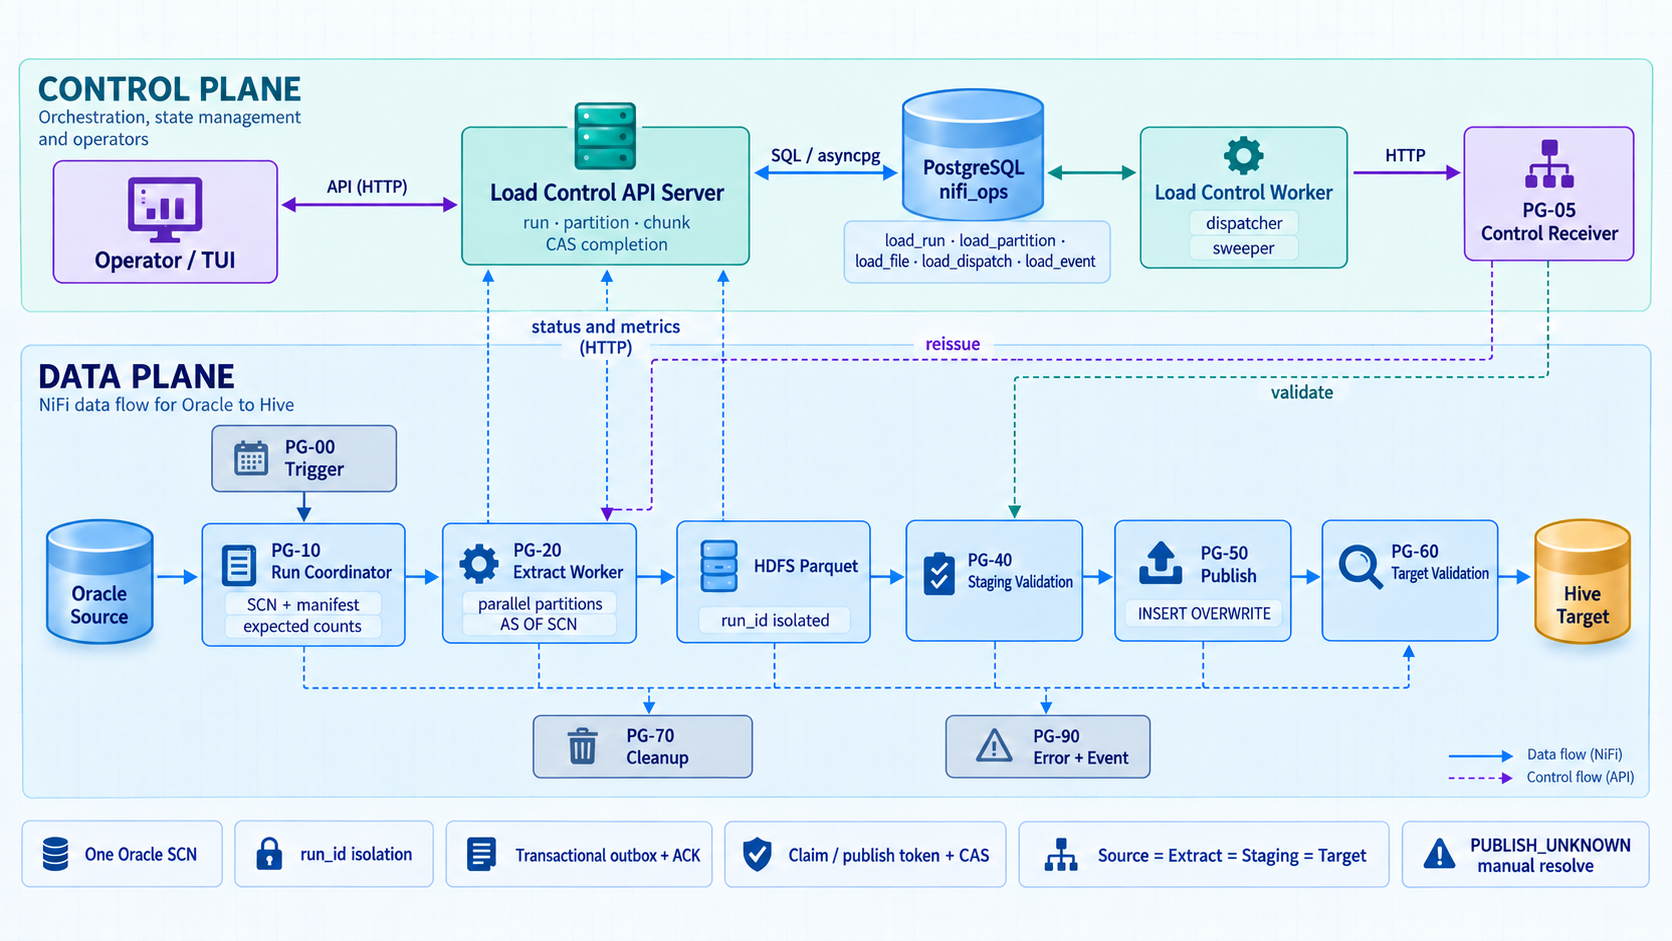
Load Control API는 두 프로세스로 나뉩니다.
| 프로세스 | 역할 |
|---|---|
| API server | NiFi의 HTTP 요청을 받아 트랜잭션 안에서 판정합니다 |
| API worker | 요청 없이 계속 실행됩니다. dispatcher는 outbox에 쌓인 NiFi 호출을 PG-05로 전달하고, sweeper는 멈춘 파티션, run timeout, ACK timeout, 검증 정체, 게시 결과 불명을 찾습니다 |
server와 worker는 직접 통신하지 않고 PostgreSQL만 공유합니다. 그래서 둘 다 여러 개 띄워도 DB의 lock으로 경합을 제어할 수 있습니다.
4. 처리 순서: PG-00부터 PG-90까지
NiFi Canvas는 다음처럼 구성됩니다.
NiFi root
├── PG-05 Control Receiver        # 모든 Job 공통
└── JOB_<JOB.KEY>                 # 원천 테이블마다 하나
    ├── PG-00 Trigger
    ├── PG-10 Run Coordinator
    ├── PG-20 Extract Worker
    ├── PG-40 Staging Validation
    ├── PG-50 Publish
    ├── PG-60 Target Validation
    ├── PG-70 Cleanup
└── PG-90 Error and Event| 단계 | 하는 일 |
|---|---|
| PG-00 Trigger | 업무일자로 실행을 시작합니다 |
| PG-10 Run Coordinator | API에 run을 만들고, Oracle SCN을 고정하고, 원천 건수와 파티션 범위를 계산해 등록합니다 |
| PG-20 Extract Worker | 파티션마다 병렬로 조회해 Parquet로 HDFS에 쓰고, chunk마다 API에 보고합니다 |
| API | 마지막 보고에서 모든 파티션이 맞으면 검증 단계를 호출합니다 (run당 1회) |
| PG-05 Control Receiver | API worker의 호출을 받아 해당 Job의 PG로 전달합니다 |
| PG-40 Staging Validation | run 경로를 가리키는 Hive 임시 테이블을 만들고 원천 지표와 비교합니다 |
| PG-50 Publish | target 파티션을 INSERT OVERWRITE로 교체합니다 |
| PG-60 Target Validation | target을 다시 원천 지표와 비교하고 SUCCESS로 끝냅니다 |
| PG-70 Cleanup | 보존 기간이 지난 임시 테이블과 HDFS 경로를 지웁니다 |
| PG-90 Error and Event | 모든 단계의 실패를 모아 API에 보고하고 이벤트를 남깁니다 |
PG 사이의 연결을 그리면 다음과 같습니다. PG-40으로 가는 길이 PG-20에서 바로 이어지지 않고 API worker → PG-05를 거친다는 점이 핵심입니다. 추출이 끝났는지는 NiFi가 아니라 API가 판정하기 때문입니다.
실행 노드와 병렬도
- Trigger(PG-00)와 Cleanup(PG-70)만 Primary Node에서 실행하고, 나머지 Processor는 All Nodes입니다. 클러스터에서 Run Once는 모든 노드에서 실행되므로, Trigger를 Primary Node로 두지 않으면 run이 노드 수만큼 생깁니다.
- PG-20의 실질 최대 병렬도는
NiFi 노드 수 × 34_Execute_Partition_Query Concurrent Tasks입니다. 이 값은 Oracle 연결 풀과 승인된 세션 수보다 크면 안 됩니다.
테이블마다 Job PG 한 벌
Flow는 NiFi Registry 없이 저장소의 빌더 스크립트(nifi-flow/deploy_job_flow.py)가 NiFi REST API로 만듭니다. 설정 JSON 하나를 실행할 때마다 JOB_<JOB.KEY> 아래에 PG-00~90 전체를 새로 만듭니다. 원천 테이블이 6개면 서로 다른 JOB.KEY를 가진 Job PG 6개가 생기고, PG-05만 공유합니다.
python3 nifi-flow/deploy_job_flow.py \
  http://<nifi-host>:<port>/nifi-api \
  /secure/path/job-insp-dtl.json
설정 JSON에는 Job별 값을 넣습니다. 원천 테이블, 추출 컬럼, split 컬럼, 업무 조건, 파티션 수, Hive staging·target 정의 등입니다.
"job_params": {
  "JOB.KEY": "ORACLE_INSP_DTL_DAILY",
  "SRC.OWNER": "APP",
  "SRC.TABLE": "INSP_DTL",
  "SRC.COLUMNS": "INSP_DTL_SEQ, BASE_DT, ITEM_CD, CAST(AMOUNT AS NUMBER(18,2)) AS AMOUNT, REG_TS, NOTE",
  "SRC.SPLIT.COLUMN": "INSP_DTL_SEQ",
  "SRC.BASE.WHERE": "BASE_DT = TO_DATE('${load.business.key}', 'YYYY-MM-DD')",
  "PARTITION.COUNT": "8",
  "HIVE.TARGET.DB": "dw",
  "HIVE.TARGET.TABLE": "insp_dtl",
  "TARGET.PARTITION.CLAUSE": "PARTITION (base_dt='${load.business.key}')"
}
빌더가 반복 생성을 자동화하므로 NiFi UI에서 Processor를 복사할 필요는 없습니다. 다만 한 Processor 세트를 여러 테이블이 공유하는 구조는 아닙니다. 동시에 실행하는 Job이 많으면 Oracle 최대 부하를 동시 실행 Job 수 × NiFi 노드 수 × Job별 PG-20 Concurrent Tasks로 계산해야 합니다.
5. 실행끼리 섞이지 않게: run 단위 격리
실행할 때마다 API가 run_id(UUID)를 발급하고, 모든 산출물을 run 단위로 나눕니다.
| 식별자 | 의미 | 예 |
|---|---|---|
job_key | 적재 정의의 고정 식별자 | ORACLE_INSP_DTL_DAILY |
business_key | 한 run이 처리하는 업무 범위 | 2026-09-28 |
run_id | API가 발급하는 실행 UUID | ca803dd4-... |
snapshot_scn | run 전체가 읽는 Oracle 시점 | 2388556 |
partition_id | run 안의 범위 파티션 | 0000 |
<HDFS.STAGE.ROOT>/<JOB.KEY>/run_id=<run_id>/part-<partition_id>-<chunk 6자리>.parquet
<HDFS.STAGE.ROOT>/<JOB.KEY>/run_id=<run_id>/_SUCCESS
<HIVE.STAGE.DB>.<HIVE.STAGE.TABLE.PREFIX><run_id에서 하이픈 제거>
HDFS 경로와 staging 테이블이 run마다 다르므로, 실패한 run의 파일이 다음 run에 섞이지 않습니다. 재실행은 실패한 run을 고치지 않고, 새 run_id와 새 SCN으로 전체를 다시 실행합니다. 실패한 run의 산출물은 보존 기간 동안 조사 증적으로 남았다가 PG-70이 정리합니다.
6. 핵심 보장
이 설계가 보장하는 것을 한 표로 정리하면 다음과 같습니다. 2편과 3편은 이 표의 각 행을 어떻게 구현했는지 설명합니다.
| 보장 | 방법 | 다루는 편 |
|---|---|---|
| 모든 파티션이 같은 시점의 데이터를 읽는다 | 시작할 때 Oracle SCN을 하나 고정하고 모든 조회에 AS OF SCN을 씁니다 | 2편 |
| 실행끼리 섞이지 않는다 | run마다 run_id를 발급하고 HDFS 경로·staging 테이블을 run별로 나눕니다 | 1편 |
| 일부만 성공하면 게시하지 않는다 | API가 파티션 건수 합계 = 원천 건수일 때만 다음 단계를 시작합니다 | 3편 |
| 검증·게시는 run당 한 번만 실행된다 | API가 조건부 UPDATE(CAS)로 한 요청에만 허락합니다 | 3편 |
| 게시 결과가 불명확하면 자동으로 다시 게시하지 않는다 | PUBLISH_UNKNOWN으로 남기고 운영자가 확정합니다 | 3편 |
| 원천 = 추출 = staging = target | 건수, 금액 합계, 시각 최소·최대, PK 중복, NULL을 단계마다 비교합니다 | 3편 |
7. 시험 결과
Cloudera CFM 4.12(NiFi 2.6.0) 2노드 클러스터, Oracle Database 23ai Free, Apache Hadoop 3.4.1, Apache Hive 4.0.1, PostgreSQL 16 환경에서 정상 실행과 주요 장애 시나리오를 확인했습니다. 데이터는 APP.INSP_DTL의 업무일자 2026-09-28 105,000건이고, 파티션 8개로 나눴습니다(그중 1개는 의도적으로 0건).
| 시나리오 | 결과 |
|---|---|
| 정상 실행 | SUCCESS. 원천 = 추출 = staging = target = 105,000건. STAGING·TARGET 지표 12개(건수, NULL, PK 중복, 금액 합계 71,853,075, 시각 최소·최대) 모두 PASS |
| 클러스터 분산 | 파티션 7개가 두 노드에 나뉘어 추출됨. 0건 파티션은 Worker로 가지 않고 바로 성공. Trigger는 Primary Node에서만 실행되어 run 1개 |
| 같은 업무일자 중복 실행 | 409 DUPLICATE_ACTIVE_RUN. 기존 run 영향 없음 |
| 파티션 하나의 HDFS 쓰기 실패 | 파티션 FAILED, run FAILED_EXTRACT. 검증 호출 없음 |
ORA-01555 (undo 소진) | 재시도 없이 run FAILED_SNAPSHOT_EXPIRED. 새 run은 새 SCN으로 성공 |
| API 중단 중 실행 | NiFi가 재시도로 기다렸다가 API 재기동 후 이어서 진행 |
| HiveServer2 중단 중 실행 | DDL 단계에서 대기, Hive 재기동 후 이어서 SUCCESS |
| 게시 실패 | PUBLISH_UNKNOWN. 운영자 확정으로 FAILED_PUBLISH |
| Job 2개 동시 실행 (PG-05 공유) | 각각 SUCCESS |
| Load Control API 테스트 | 140개 중 139개 통과. 나머지 1개는 같은 DB 서버의 다른 worker 때문에 시험 환경에서 제외 |
각 시나리오가 왜 그렇게 동작하는지는 2편(SCN, ORA-01555)과 3편(중복 실행, 부분 실패, PUBLISH_UNKNOWN)에서 다룹니다.
아직 확인하지 않은 것
시험 환경 결과이므로, 운영 적용 전에 다음을 다시 확인해야 합니다.
- CDP HiveServer2(Hive 3)와 ACID managed target 테이블. 시험은 Apache Hive 4.0.1이었습니다.
- 운영 규모 데이터의 처리 시간과 Oracle·API·관리 DB 부하, 파티션 처리 중 NiFi 노드 장애
- 운영 Oracle의 undo 보존 시간, 인덱스, 세션 한도
- AS-IS Sqoop과 병행 실행해 건수·합계·샘플 행을 비교하는 전환 검증
마치며
Sqoop을 NiFi로 바꾸는 일의 핵심은 Processor를 고르는 것이 아니라, Sqoop 한 번의 실행에 묶여 있던 "전체 완료 판정"을 어디에 둘 것인가였습니다. 이 프로젝트는 그 판정을 NiFi 밖의 작은 API와 PostgreSQL 원장으로 옮겼고, 덕분에 NiFi Flow는 데이터 처리와 API 호출만 하는 단순한 구조로 남았습니다.
다음 2편에서는 여러 노드에서 서로 다른 시각에 실행되는 파티션 조회가 어떻게 같은 시점의 데이터를 읽는지, Oracle SCN과 Undo를 중심으로 설명합니다.