
Argus RAG Studio
RAGパイプラインの構築(Build)・検索/生成(Retrieve & Generate)・評価(Evaluate)・運用/デプロイ(Operate & Deploy)を一か所で扱うオープンソースのセルフホスト型RAGプラットフォームです。「一度動くRAGデモ」ではなく、品質を数値で測る評価ハーネス、最適設定を自動探索するスイープ、フィードバック還流、エージェントベースの遠隔デプロイまで備え、オンプレミス・エアギャップ(閉域網)で運用できます。
01 · RAG の概念と全体像
まず文書を根拠に回答する RAG の仕組みを理解し、準備から運用までの流れを確認します。
RAG とは
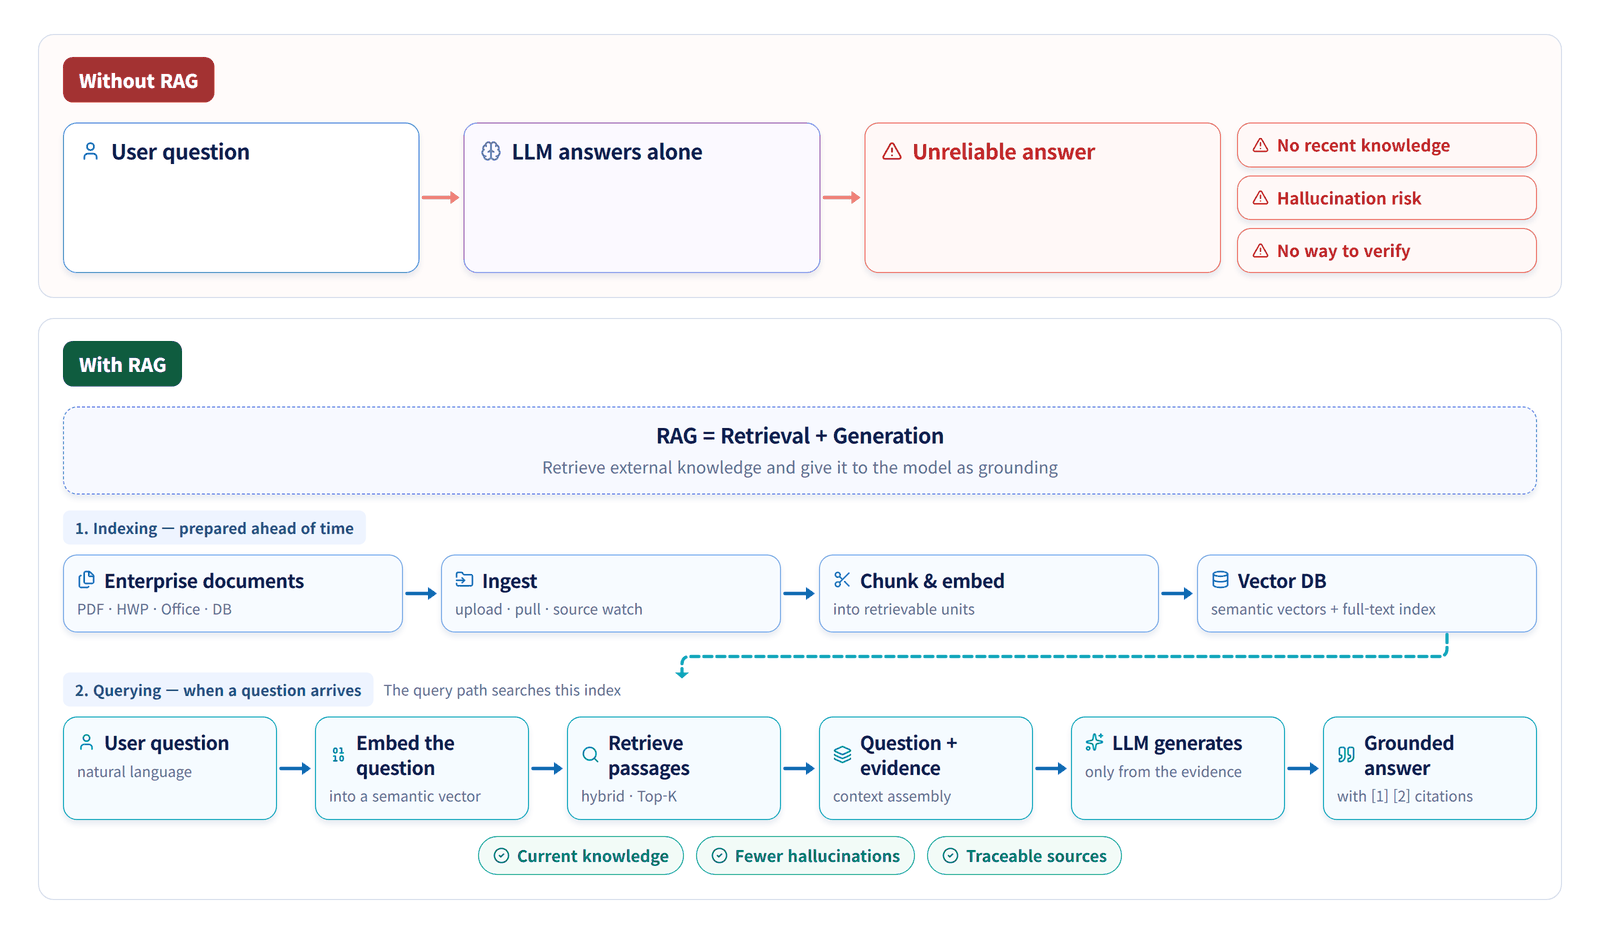
RAGは質問に関連する文書を検索し、大規模言語モデルにコンテキストとして渡します。回答に添えられた引用を使って、利用者が根拠を確認できます。
RAGの全工程
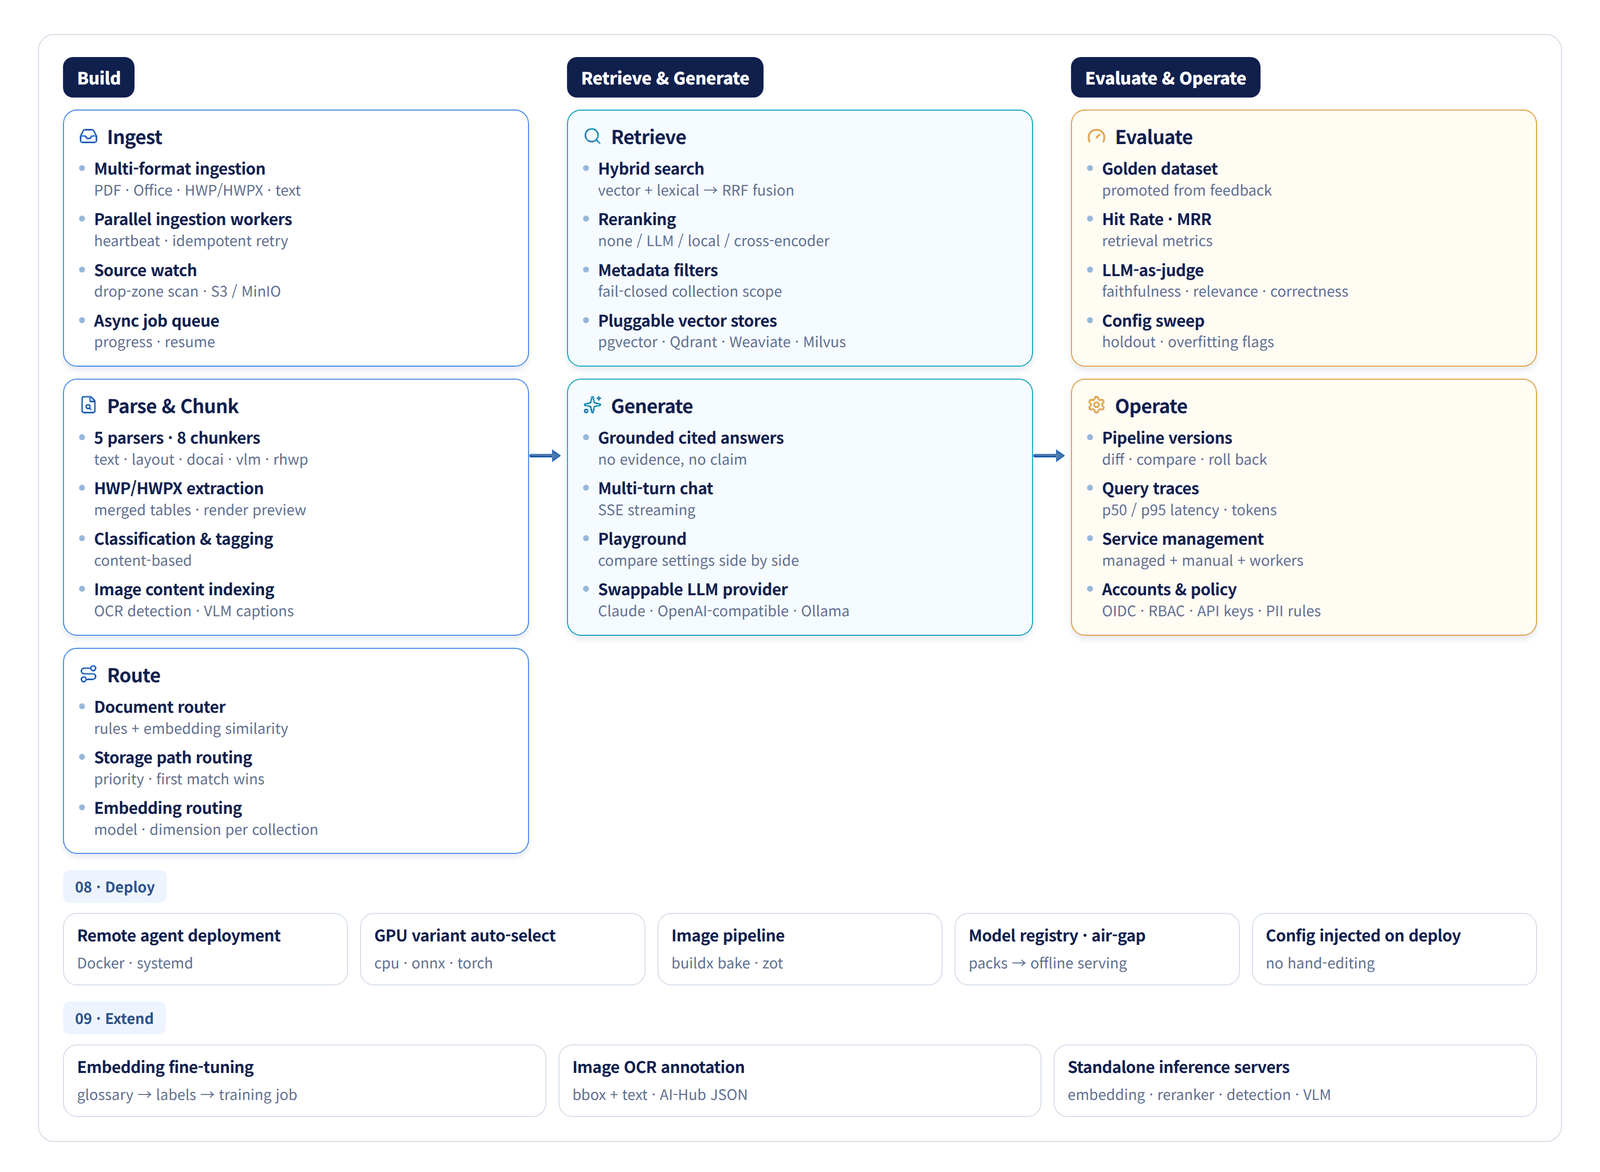
文書を検索可能な知識に整え、質問に必要な根拠を検索して回答を生成します。評価結果で設定を改善し、実行設定のバージョン・サービス状態・配備を管理します。
02 · 検索する文書を準備
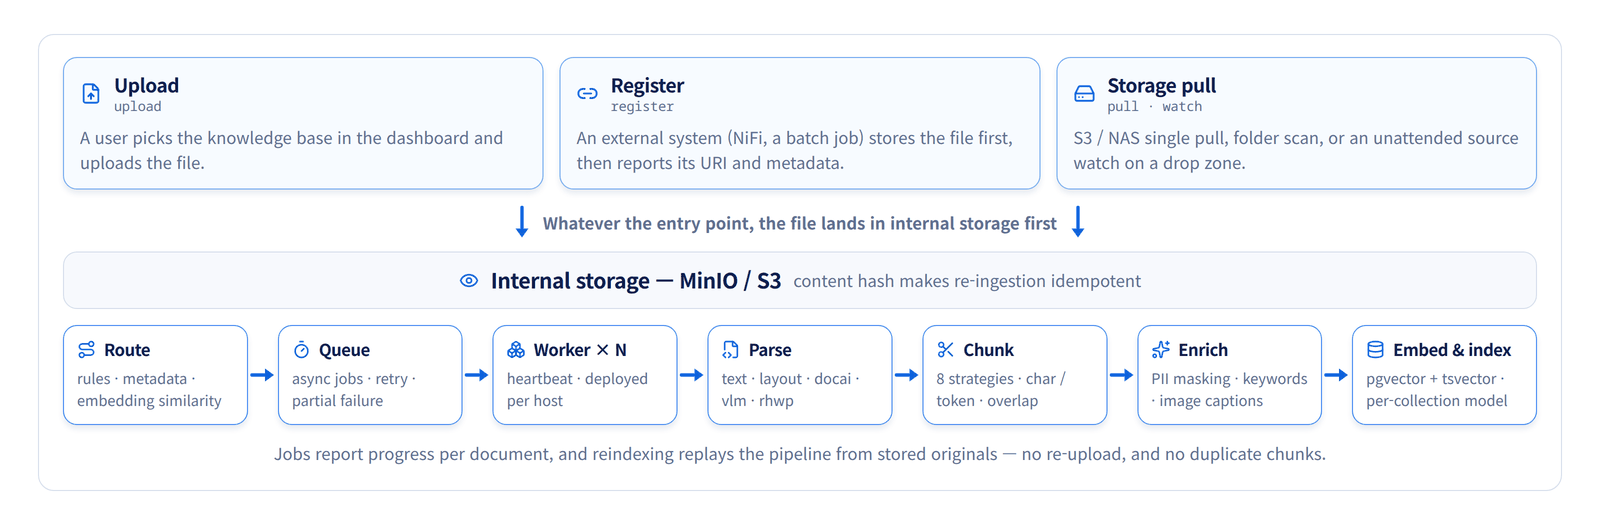
文書を読み取り、機密情報を処理し、検索できる小さな単位とベクトルに変換する流れです。
構築
文書を取り込み、ナレッジベースを選び、解析・分割・インデックス作成を行う段階
文書ルーティング
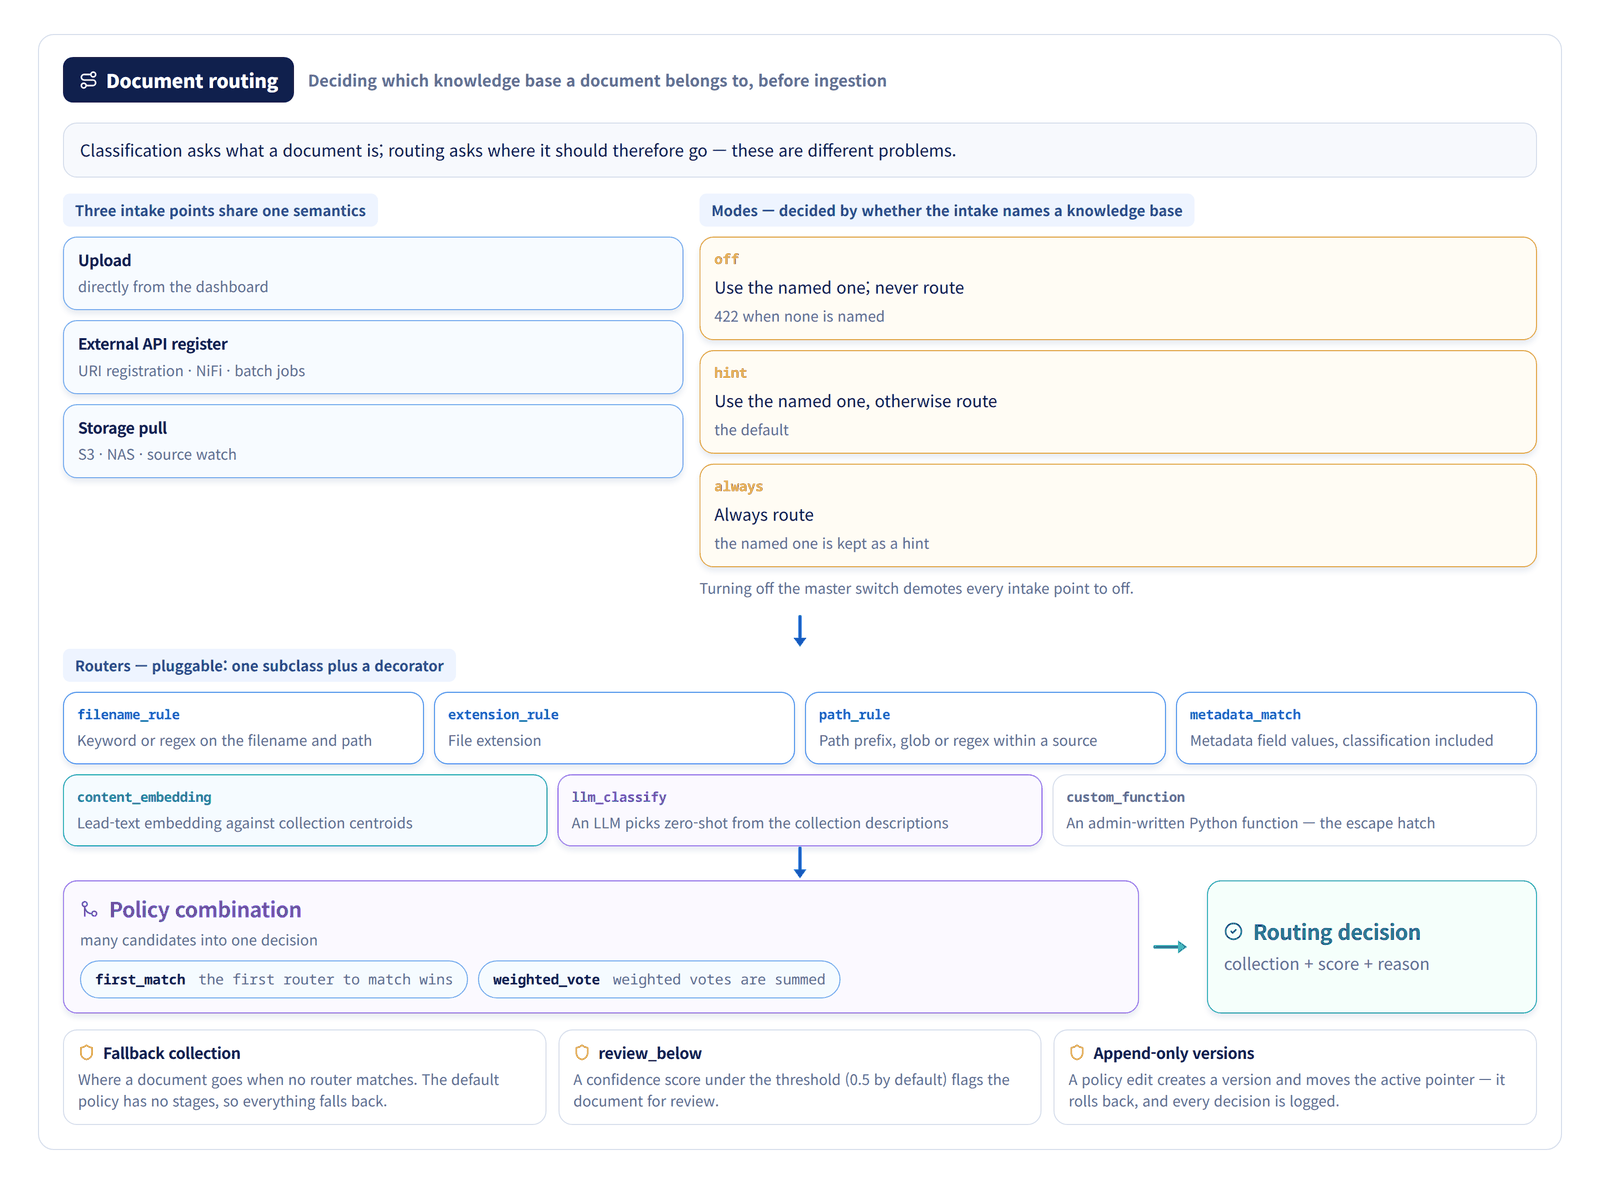
文書ルーティングは、取り込み前に文書の保存先となるナレッジベースを決める処理です。ファイル名・パス・メタデータ・埋め込み類似度・LLMの判断などをポリシーに組み合わせ、宛先と判断理由を記録します。
文書解析
文書解析は、ファイルから検索に使うテキストと構造を抽出する処理です。形式やレイアウトに合うパーサーを選び、抽出したMarkdownの表・見出し・読み順を原本と比較して確認します。
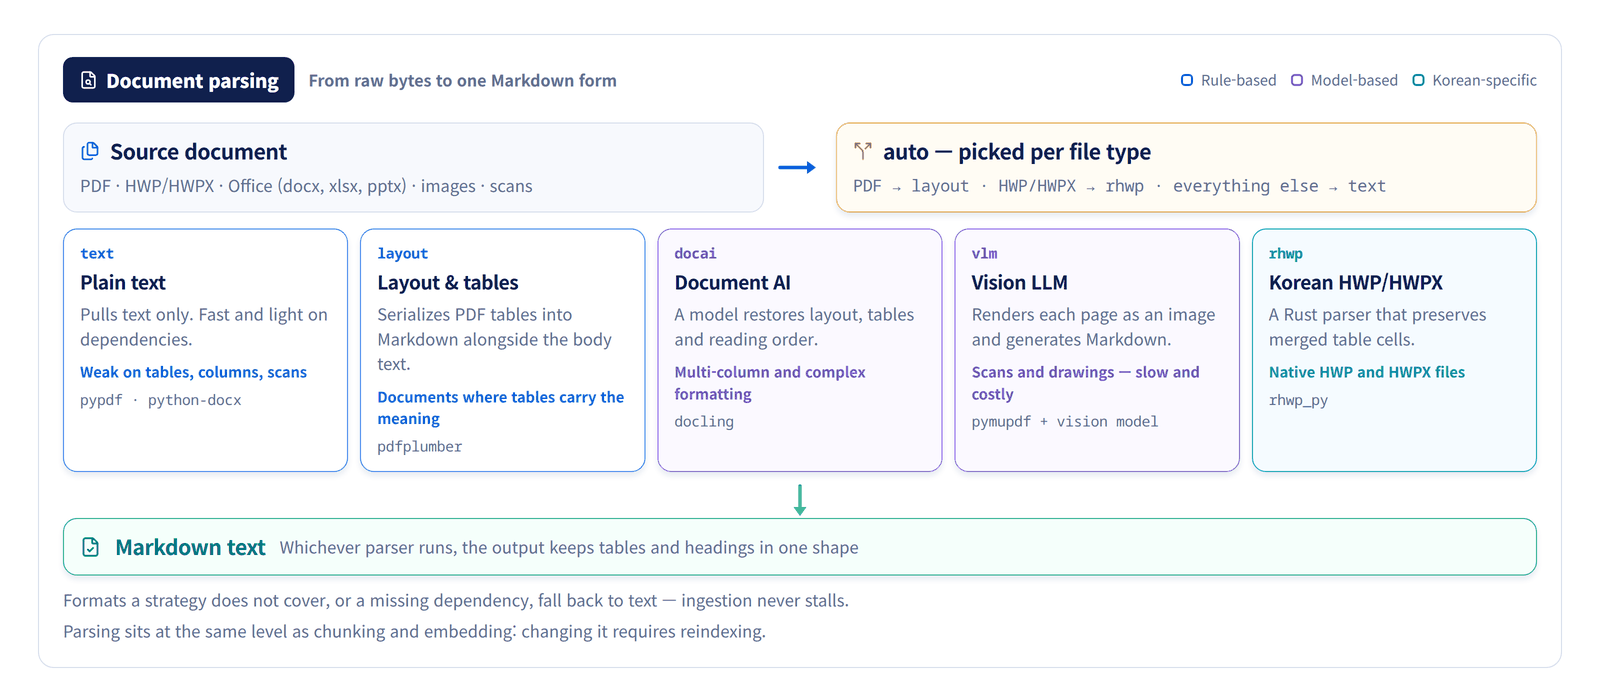
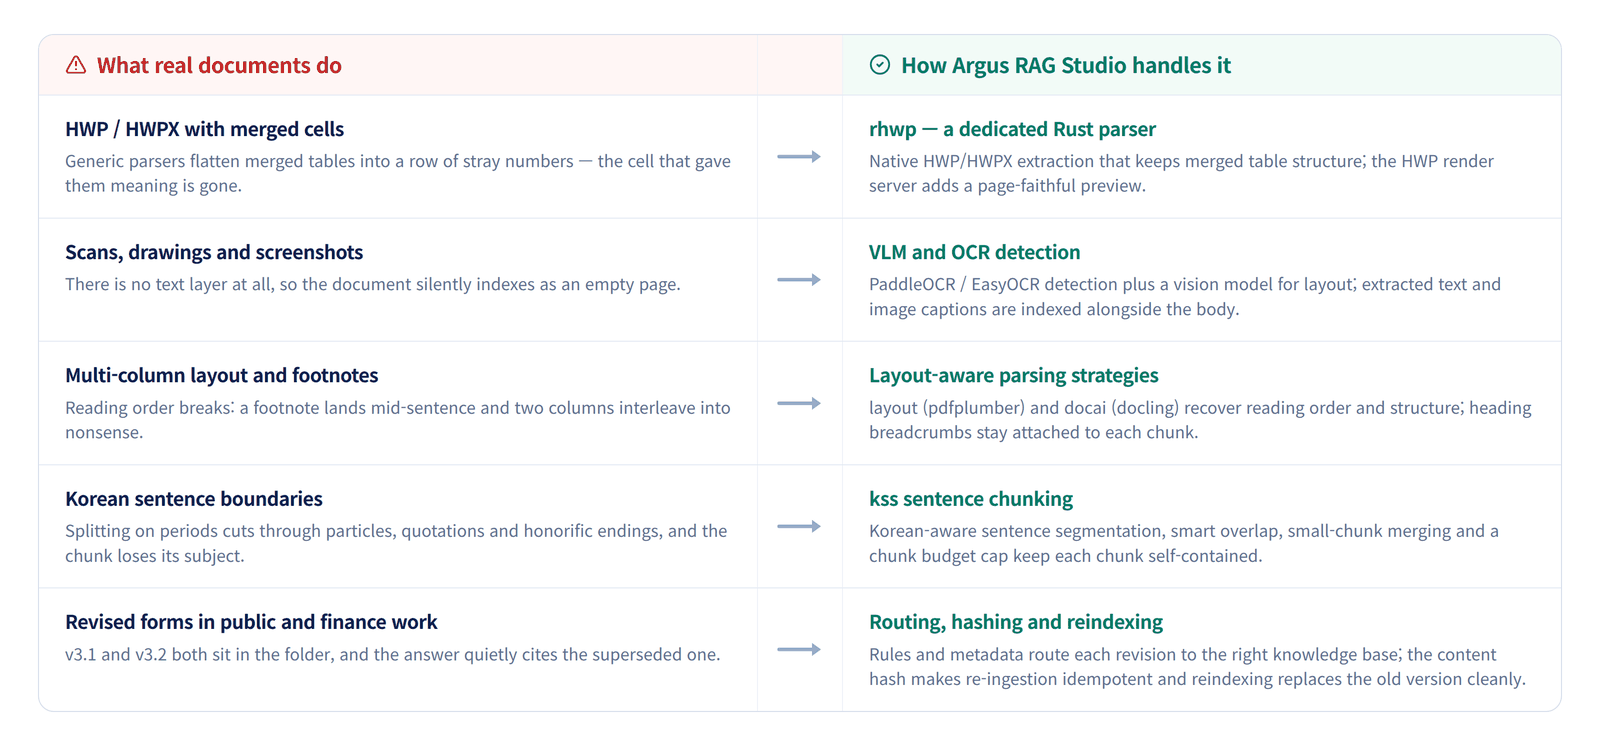
韓国語文書のためのパイプライン
HWP/HWPXの表、スキャンPDF、段組み、韓国語の文境界に応じて処理経路を選びます。抽出結果を原本と比較し、文書の改訂版や画像ラベルを確認して検索に反映します。
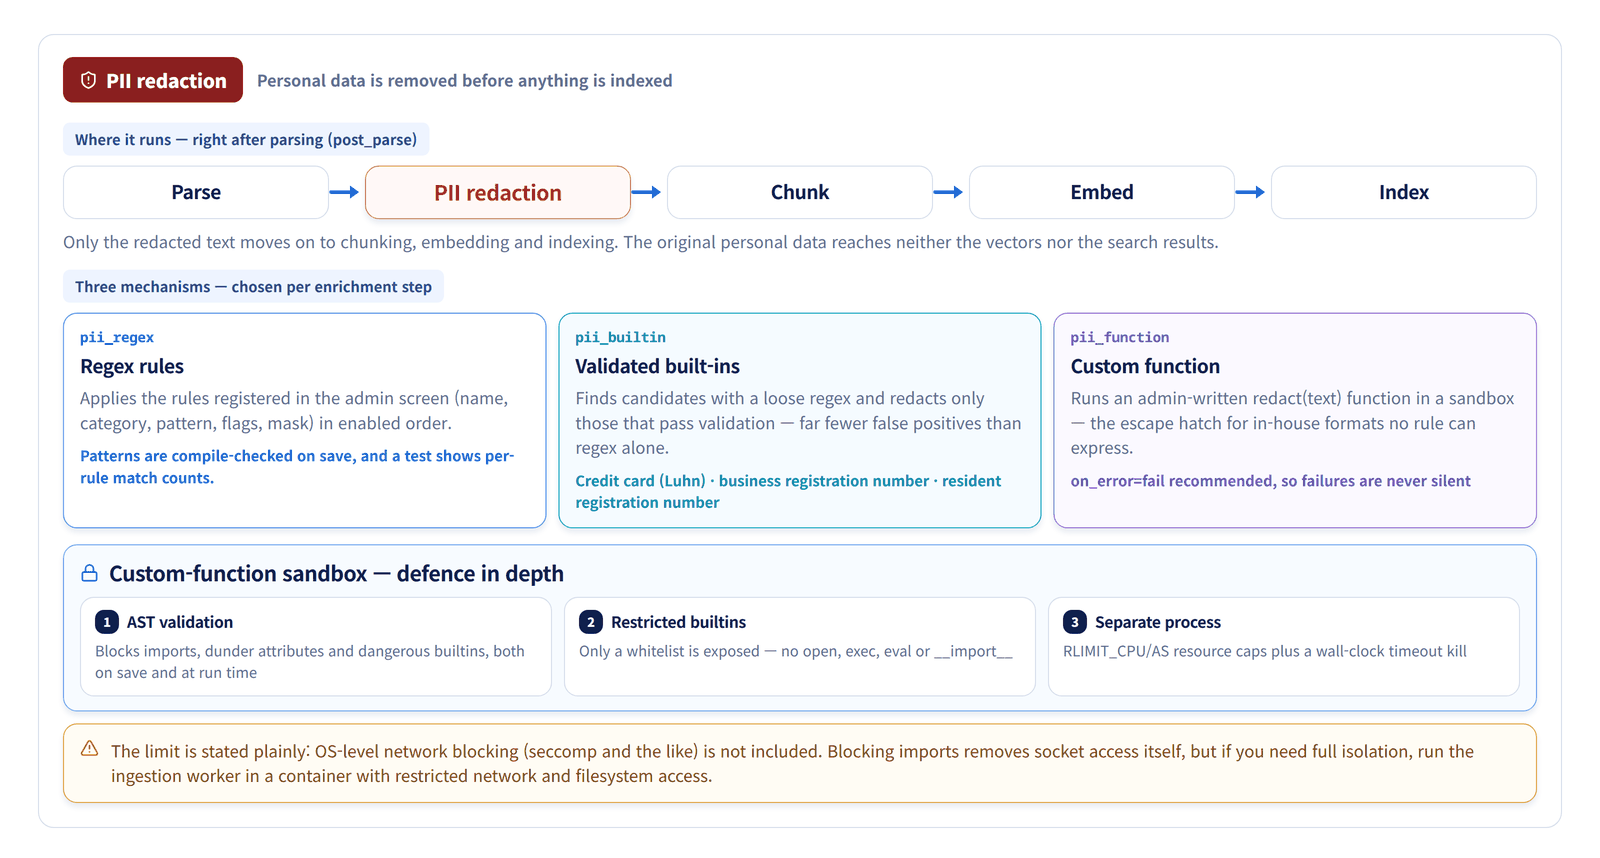
PIIのマスキング
PIIは個人を識別できる情報です。変換を有効にすると、解析後の本文で設定した規則に一致する内容を、チャンク化・埋め込みの前にマスキングします。検出漏れを確認し、原本の保存とアクセスは別途管理します。
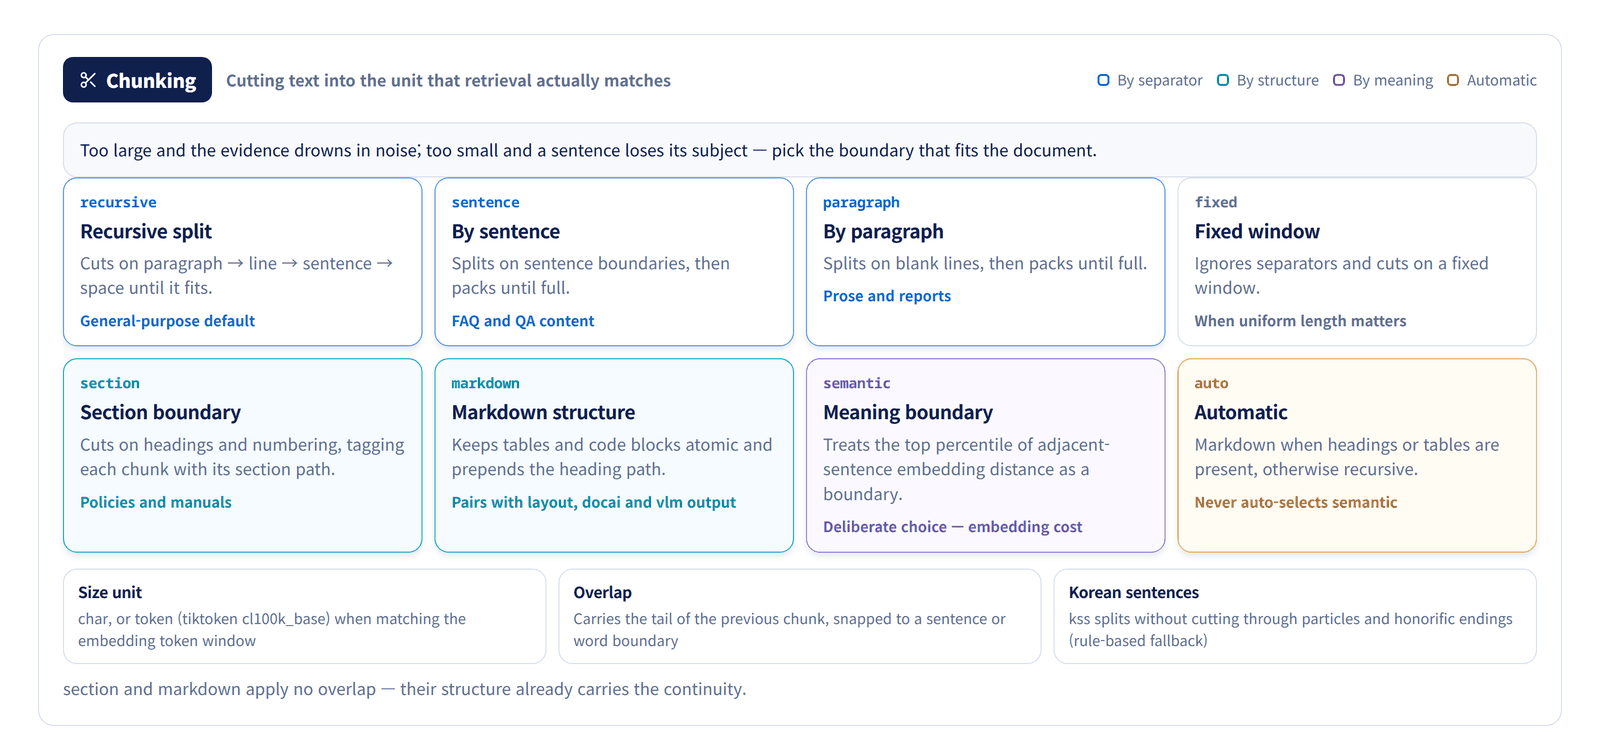
チャンキング
チャンキングは、文書を検索可能な文章のまとまりに分ける処理です。大きすぎると無関係な内容が混ざり、小さすぎると必要な文脈が途切れる場合があります。文書に合う境界・サイズ・重複範囲を選び、検索結果で確認します。
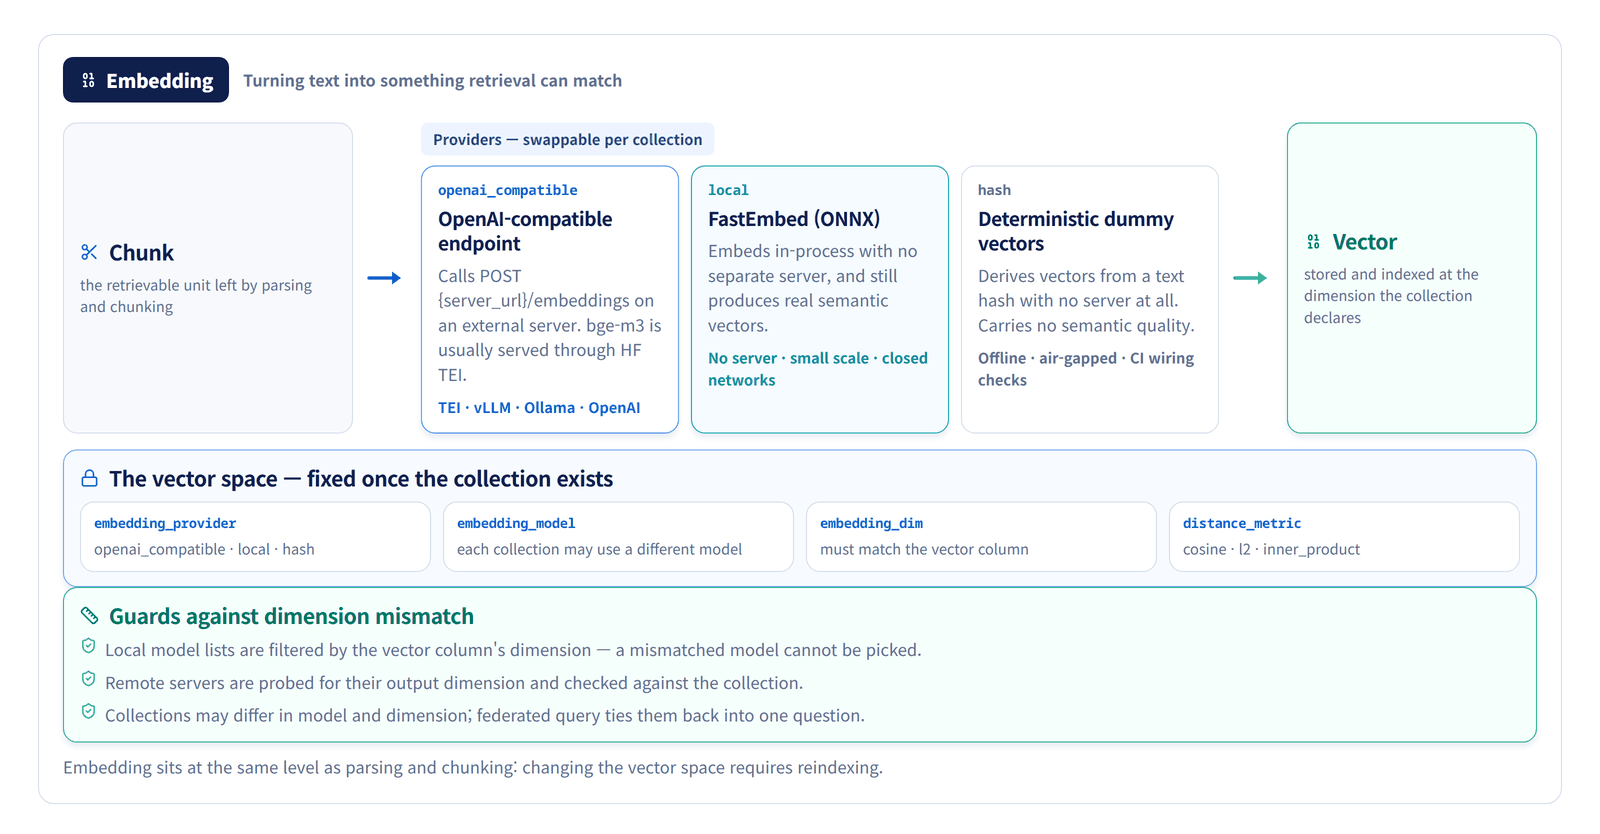
埋め込み — 検索できるベクトルへ
埋め込み設定がコレクションのベクトル空間を決めます。プロバイダー・モデル・次元・距離指標はコレクション作成時に確定し、後から変更するには再インデックスが必要です。閉域網や CI では、埋め込みサーバーなしでも配線を検証できます。
03 · 根拠の検索と回答の生成
準備した文書から質問に合う根拠を探し、優先順位を付けて引用付きの回答につなげます。
検索・生成
質問に合う根拠を探し、引用付きの回答を生成する段階
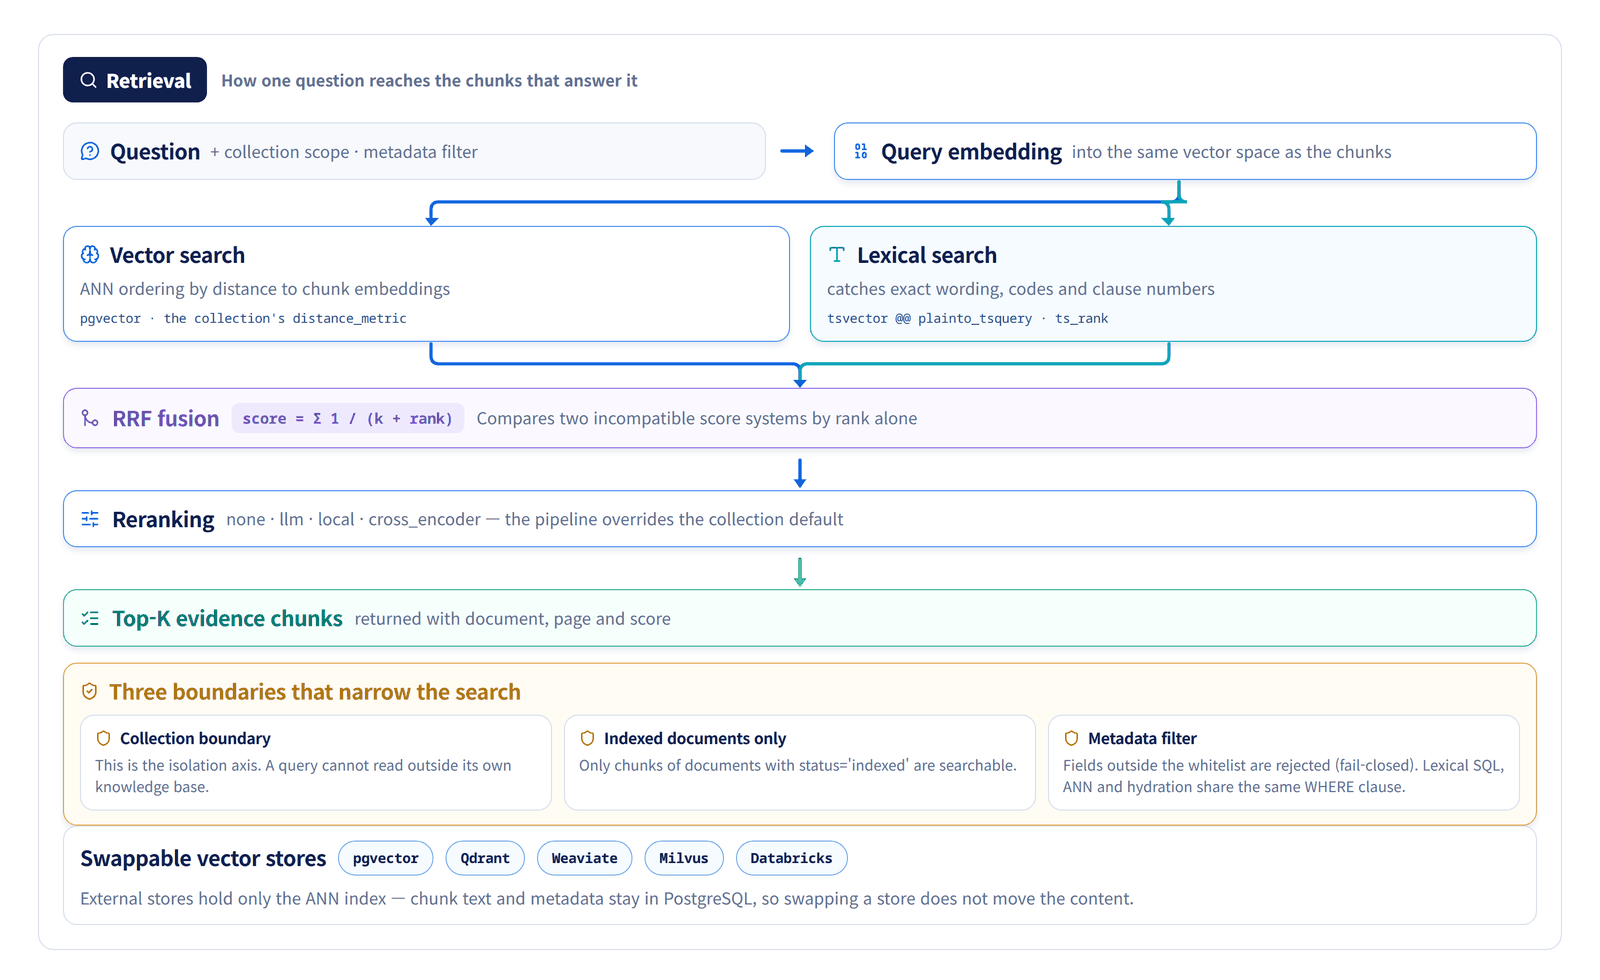
検索 — 根拠を見つける仕組み
質問から作ったベクトルと質問の単語で候補チャンクを探し、RRFで順位を統合します。コレクションの範囲とメタデータフィルターで結果を絞り、本文とメタデータはPostgreSQLから取得します。
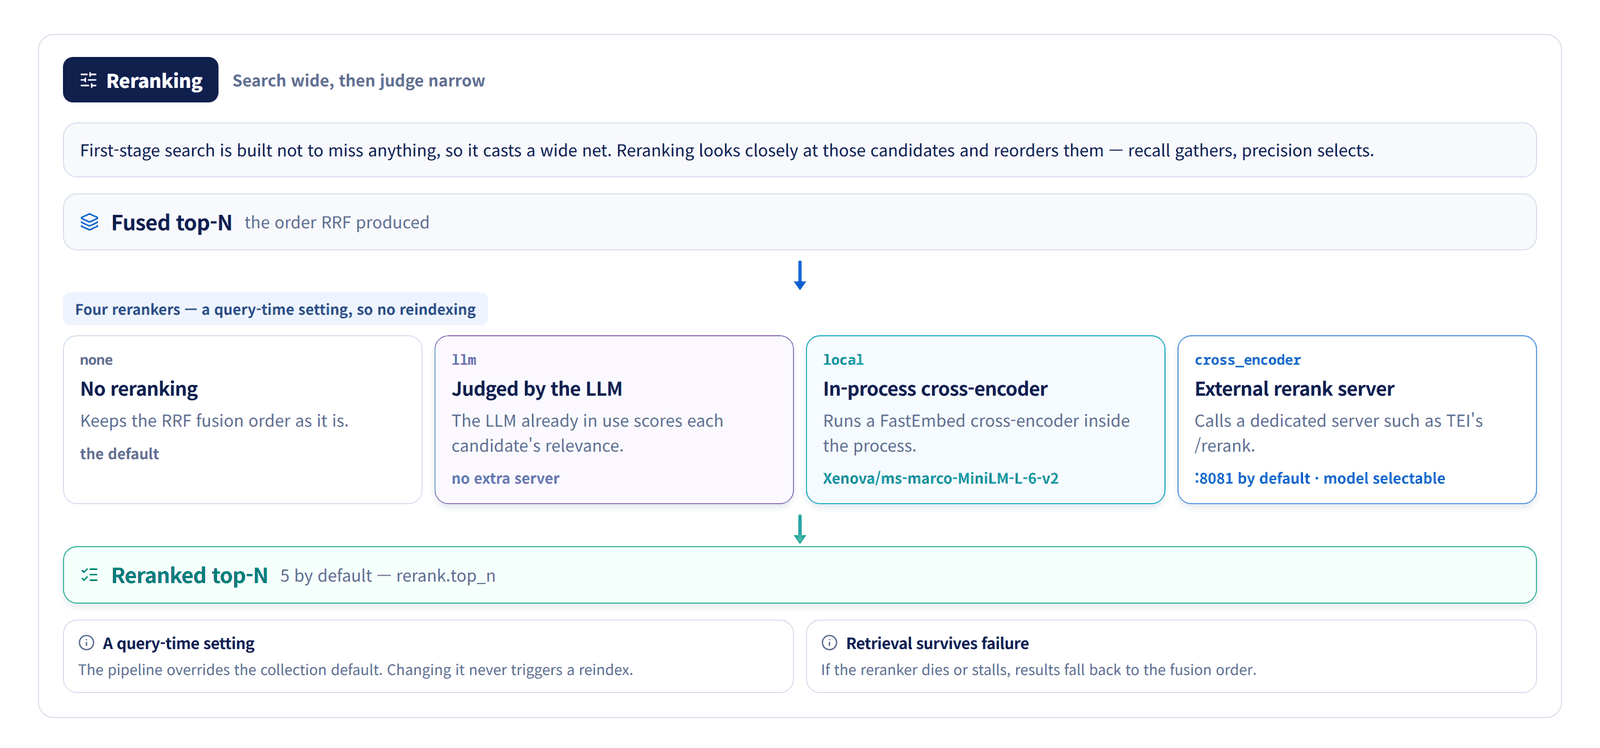
リランキング — 広く探し、狭く選ぶ
リランキングは検索済みの候補を質問と照らして再評価し、順序を変えます。候補にない根拠は復元できず、設定変更に再インデックスは不要です。
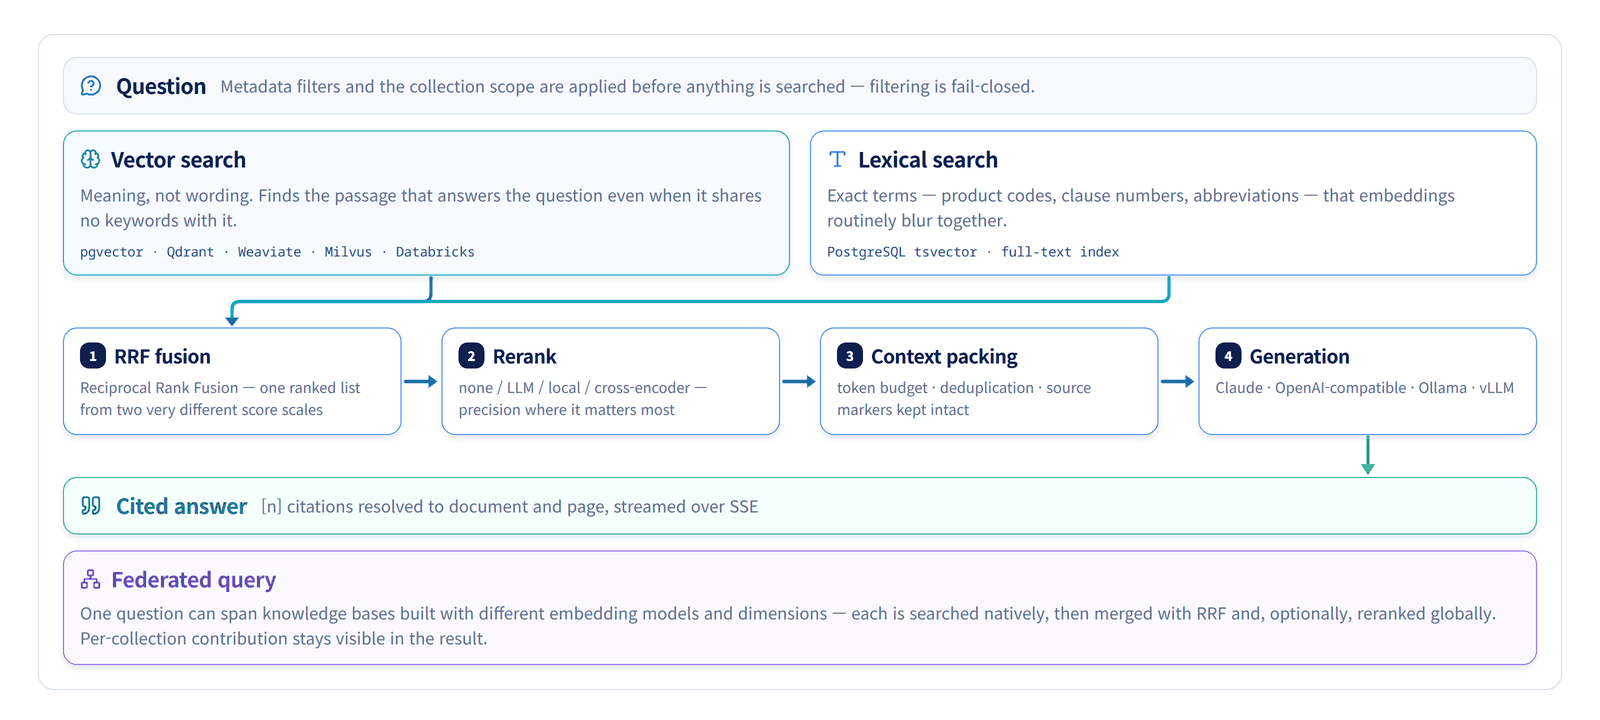
社内文書から引用付き回答へ
文書のインデックス化と質問処理を分け、検索した根拠を生成時のコンテキストに渡します。
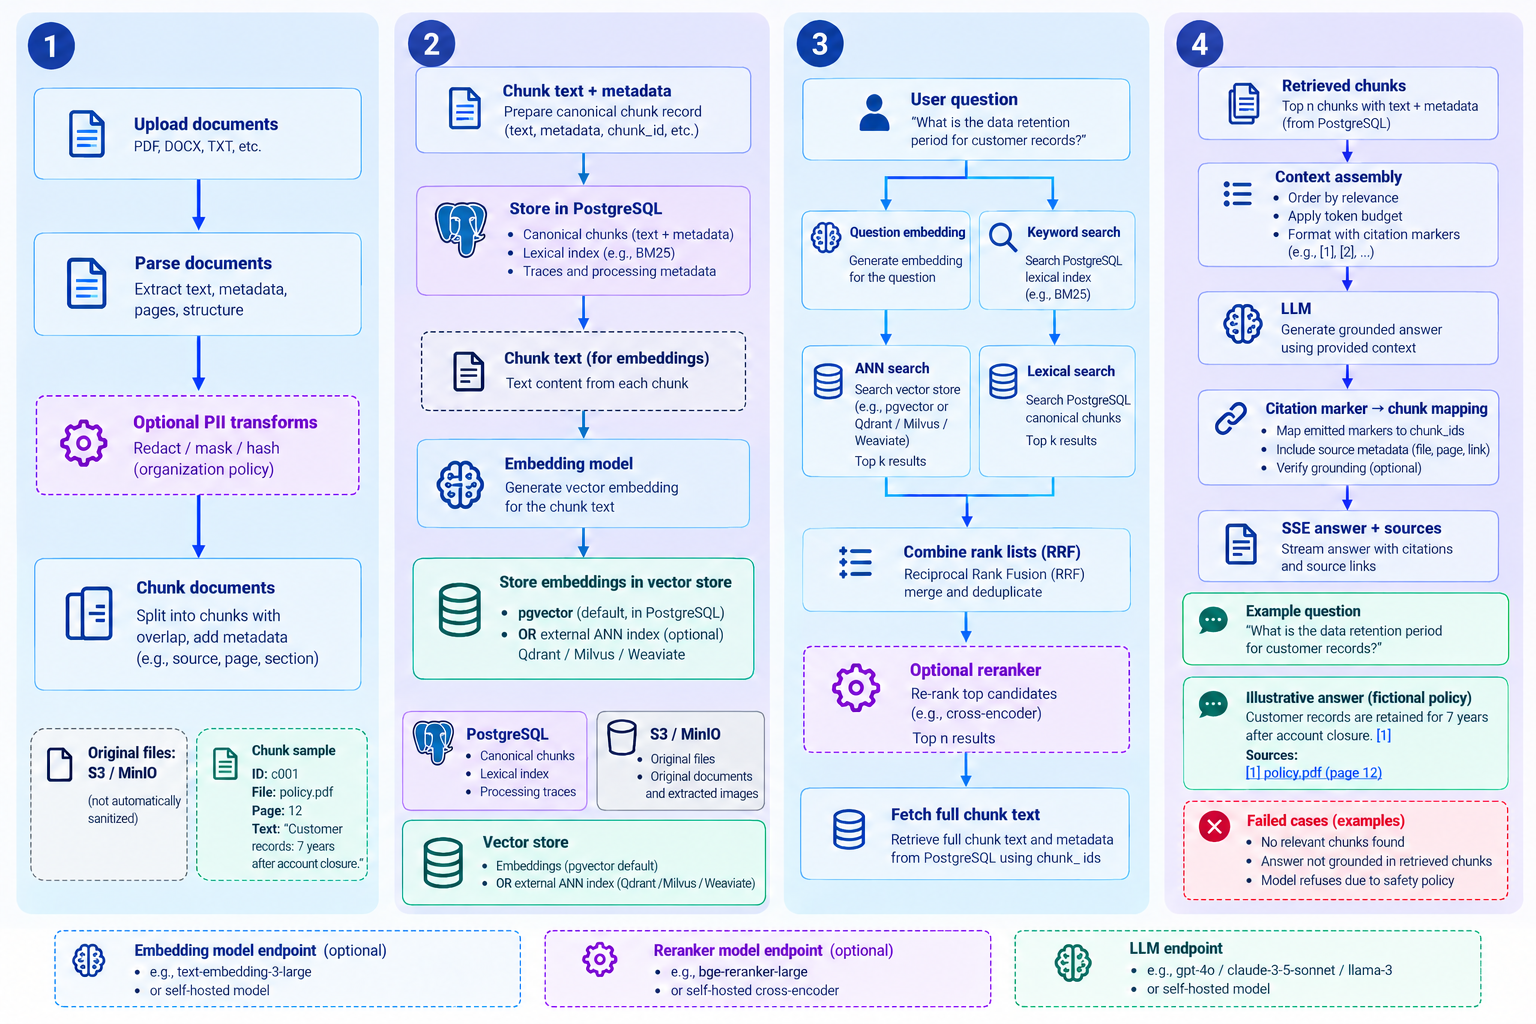
- 1.文書準備
- コレクションを選び、文書を解析して有効なPII変換を適用します。
- 2.インデックス作成
- チャンク・メタデータ・ベクトルを保存し、原本文書はオブジェクトストレージで管理します。
- 3.根拠検索
- ベクトル検索と語彙検索の順位をRRFで統合し、必要に応じてリランキングします。
- 4.引用付き回答
- 検索箇所をモデルに渡し、ストリーミング回答の引用マーカーをチャンクと結び付けます。
PII変換と外部推論サーバーは選択構成です。引用マーカーを検索チャンクに対応付けますが、全ての回答文の正確性は保証しません。
GitHubの文書・コードを見る04 · 品質の評価と改善
検索と回答の品質を確認し、設定を比較して、検証したバージョンを本番環境に適用します。
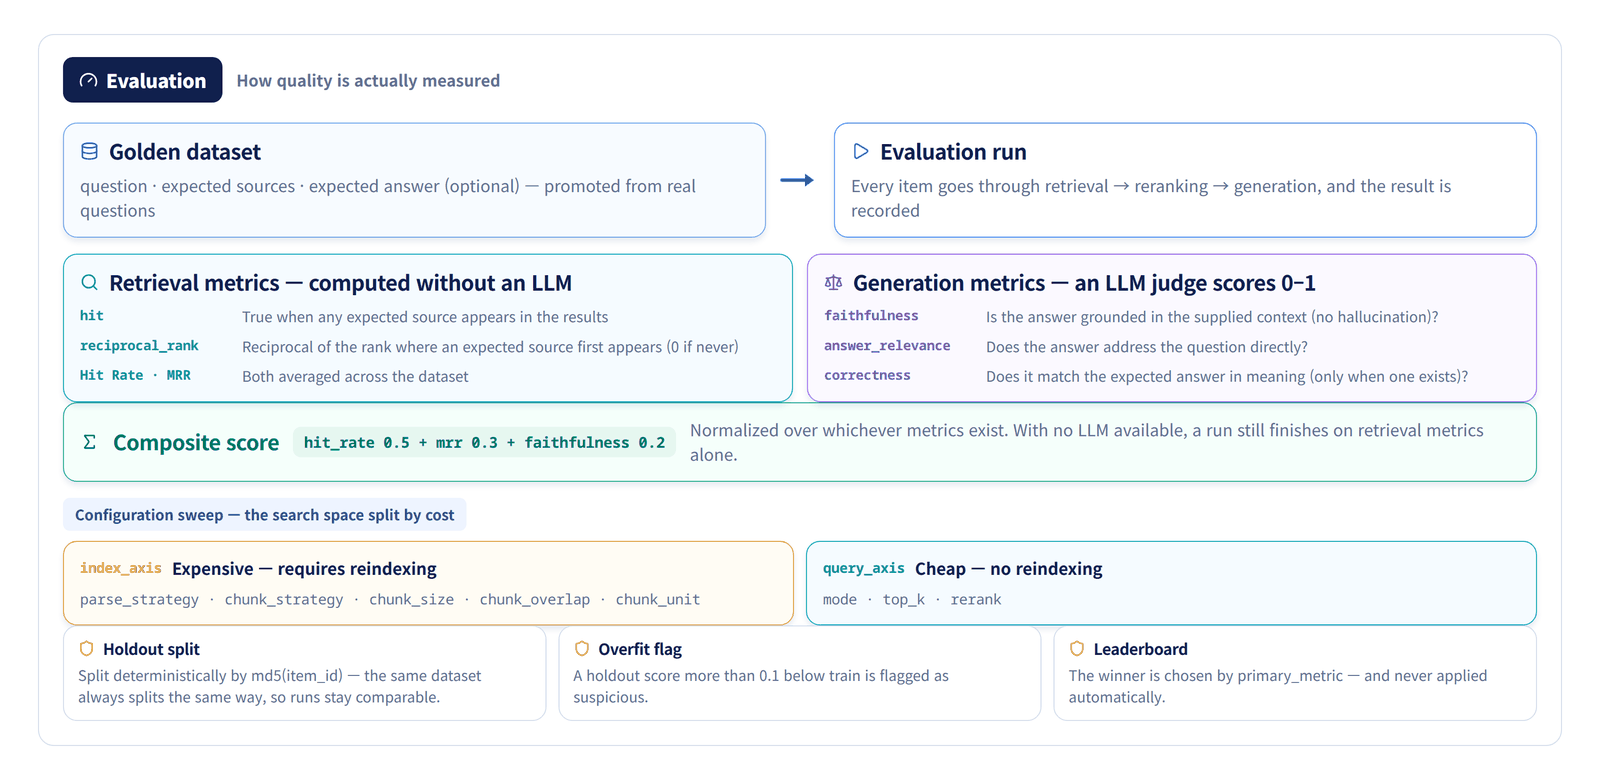
評価 — 品質を数値で測る
検索は LLM なしで Hit Rate・MRR として計算し、回答は LLM 判定者が忠実性・関連性・正確性の 3 軸で採点します。設定スイープは再インデックスの要否で探索空間を分け、ホールドアウトと過学習フラグが優勝設定を検証します。
評価・運用
品質を評価し、設定・実行設定のバージョン・運用状態を管理する段階
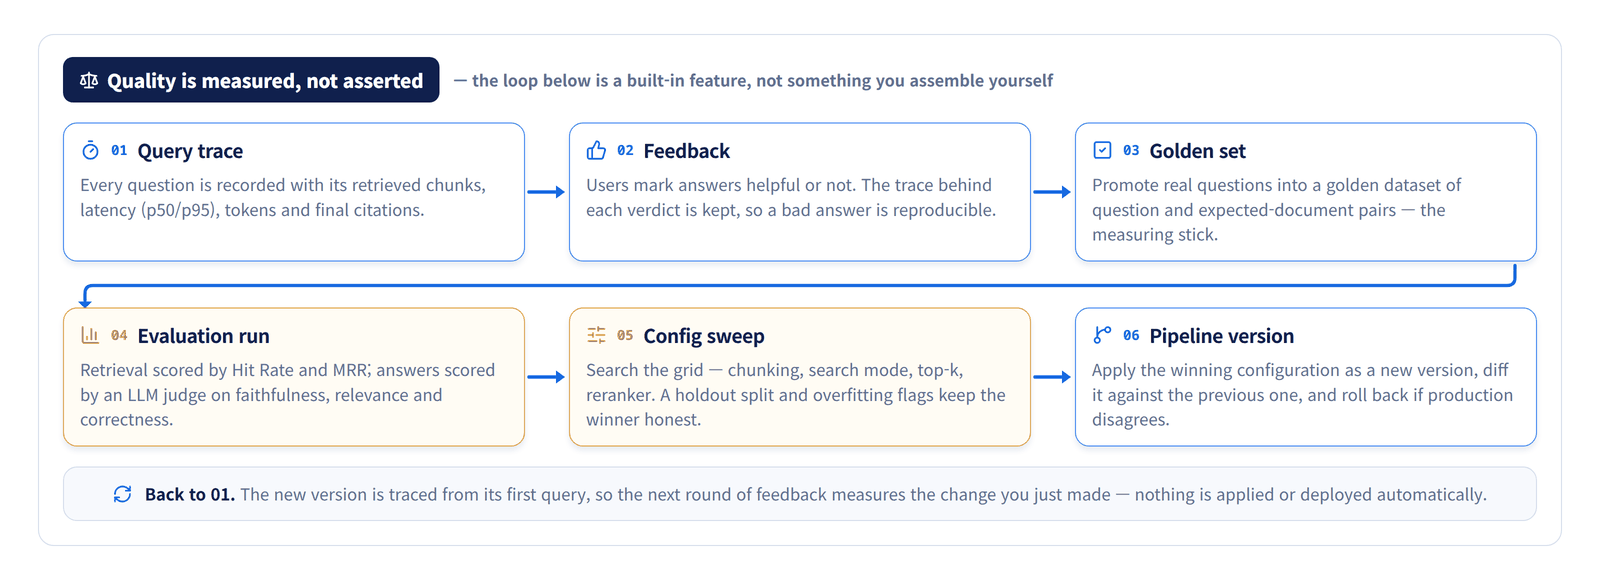
評価結果を次の運用設定へ
ゴールデンデータセットで品質を測り、設定を比較してバージョンと配備状態を管理します。
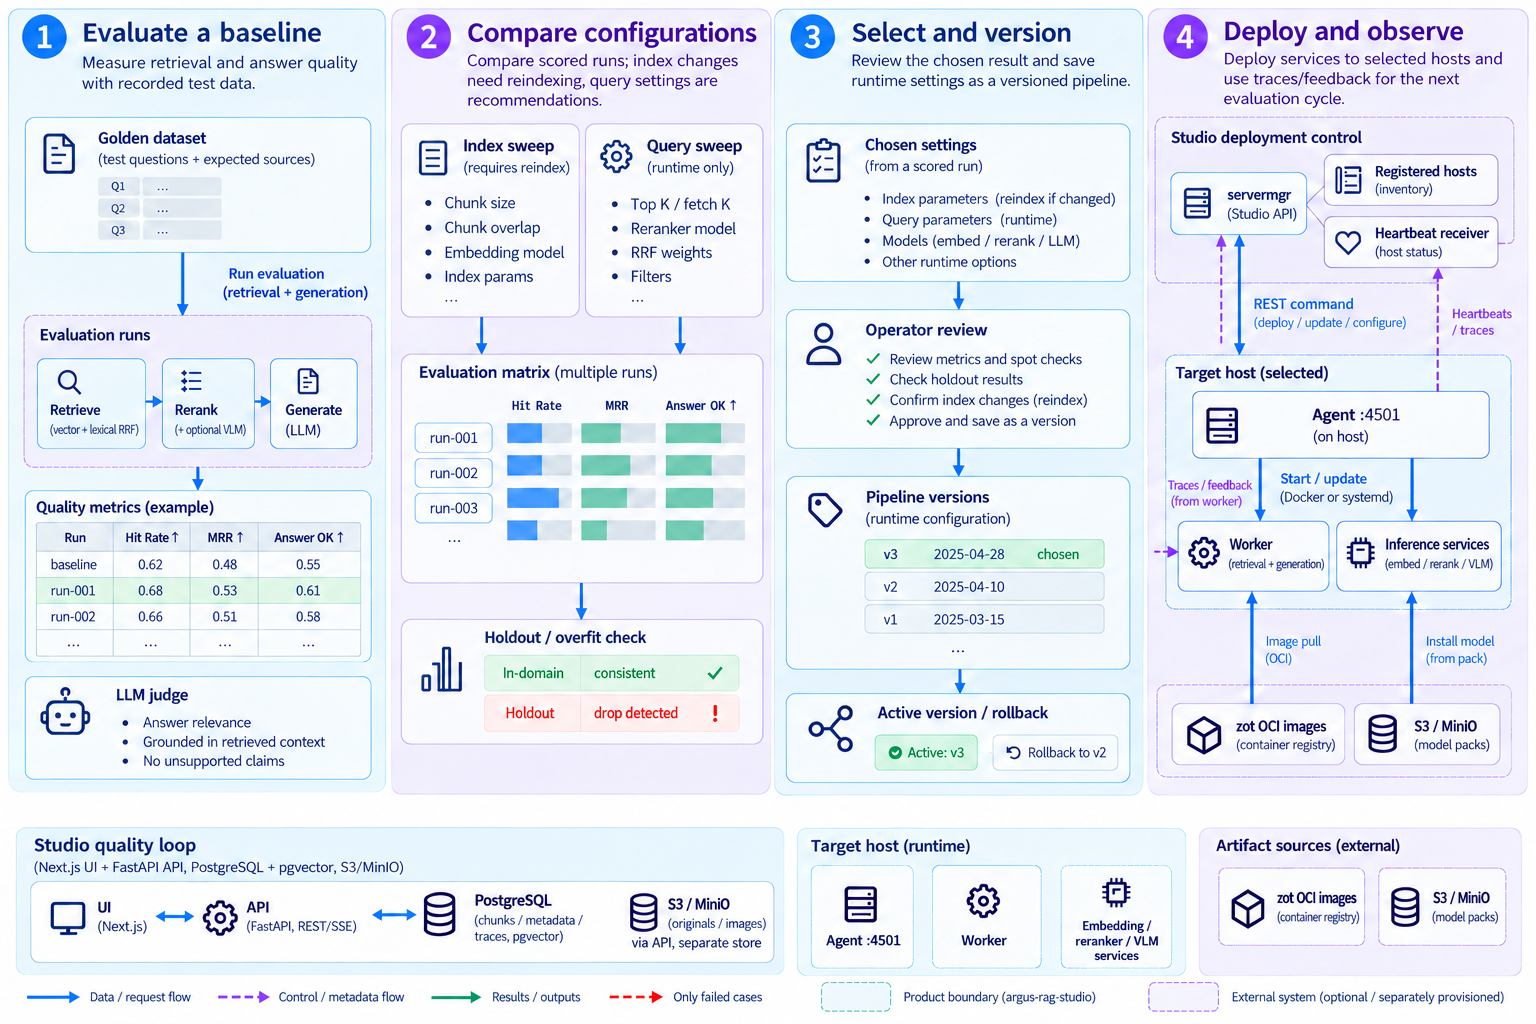
- 1.基準品質の評価
- ゴールデン質問でHit Rate・MRRとLLM評価指標を記録します。
- 2.設定比較
- インデックス・クエリのスイープ結果、ホールドアウト評価、過学習フラグを確認します。
- 3.選択と版管理
- 設定を確認して適用し、実行設定をパイプラインのバージョンとして保存します。
- 4.配備と観察
- ホストエージェントでワーカー・推論サービスを配備し、トレースと反応を次の評価に反映します。
スイープは指定した探索範囲で比較します。インデックス変更には再インデックスが必要な場合があり、クエリ推奨設定の適用とサービス配備は別の操作です。
GitHubの文書・コードを見る05 · システム構成を理解
ここまで見てきた文書処理・検索・評価を、各サービスとストレージがどう分担するかを確認します。
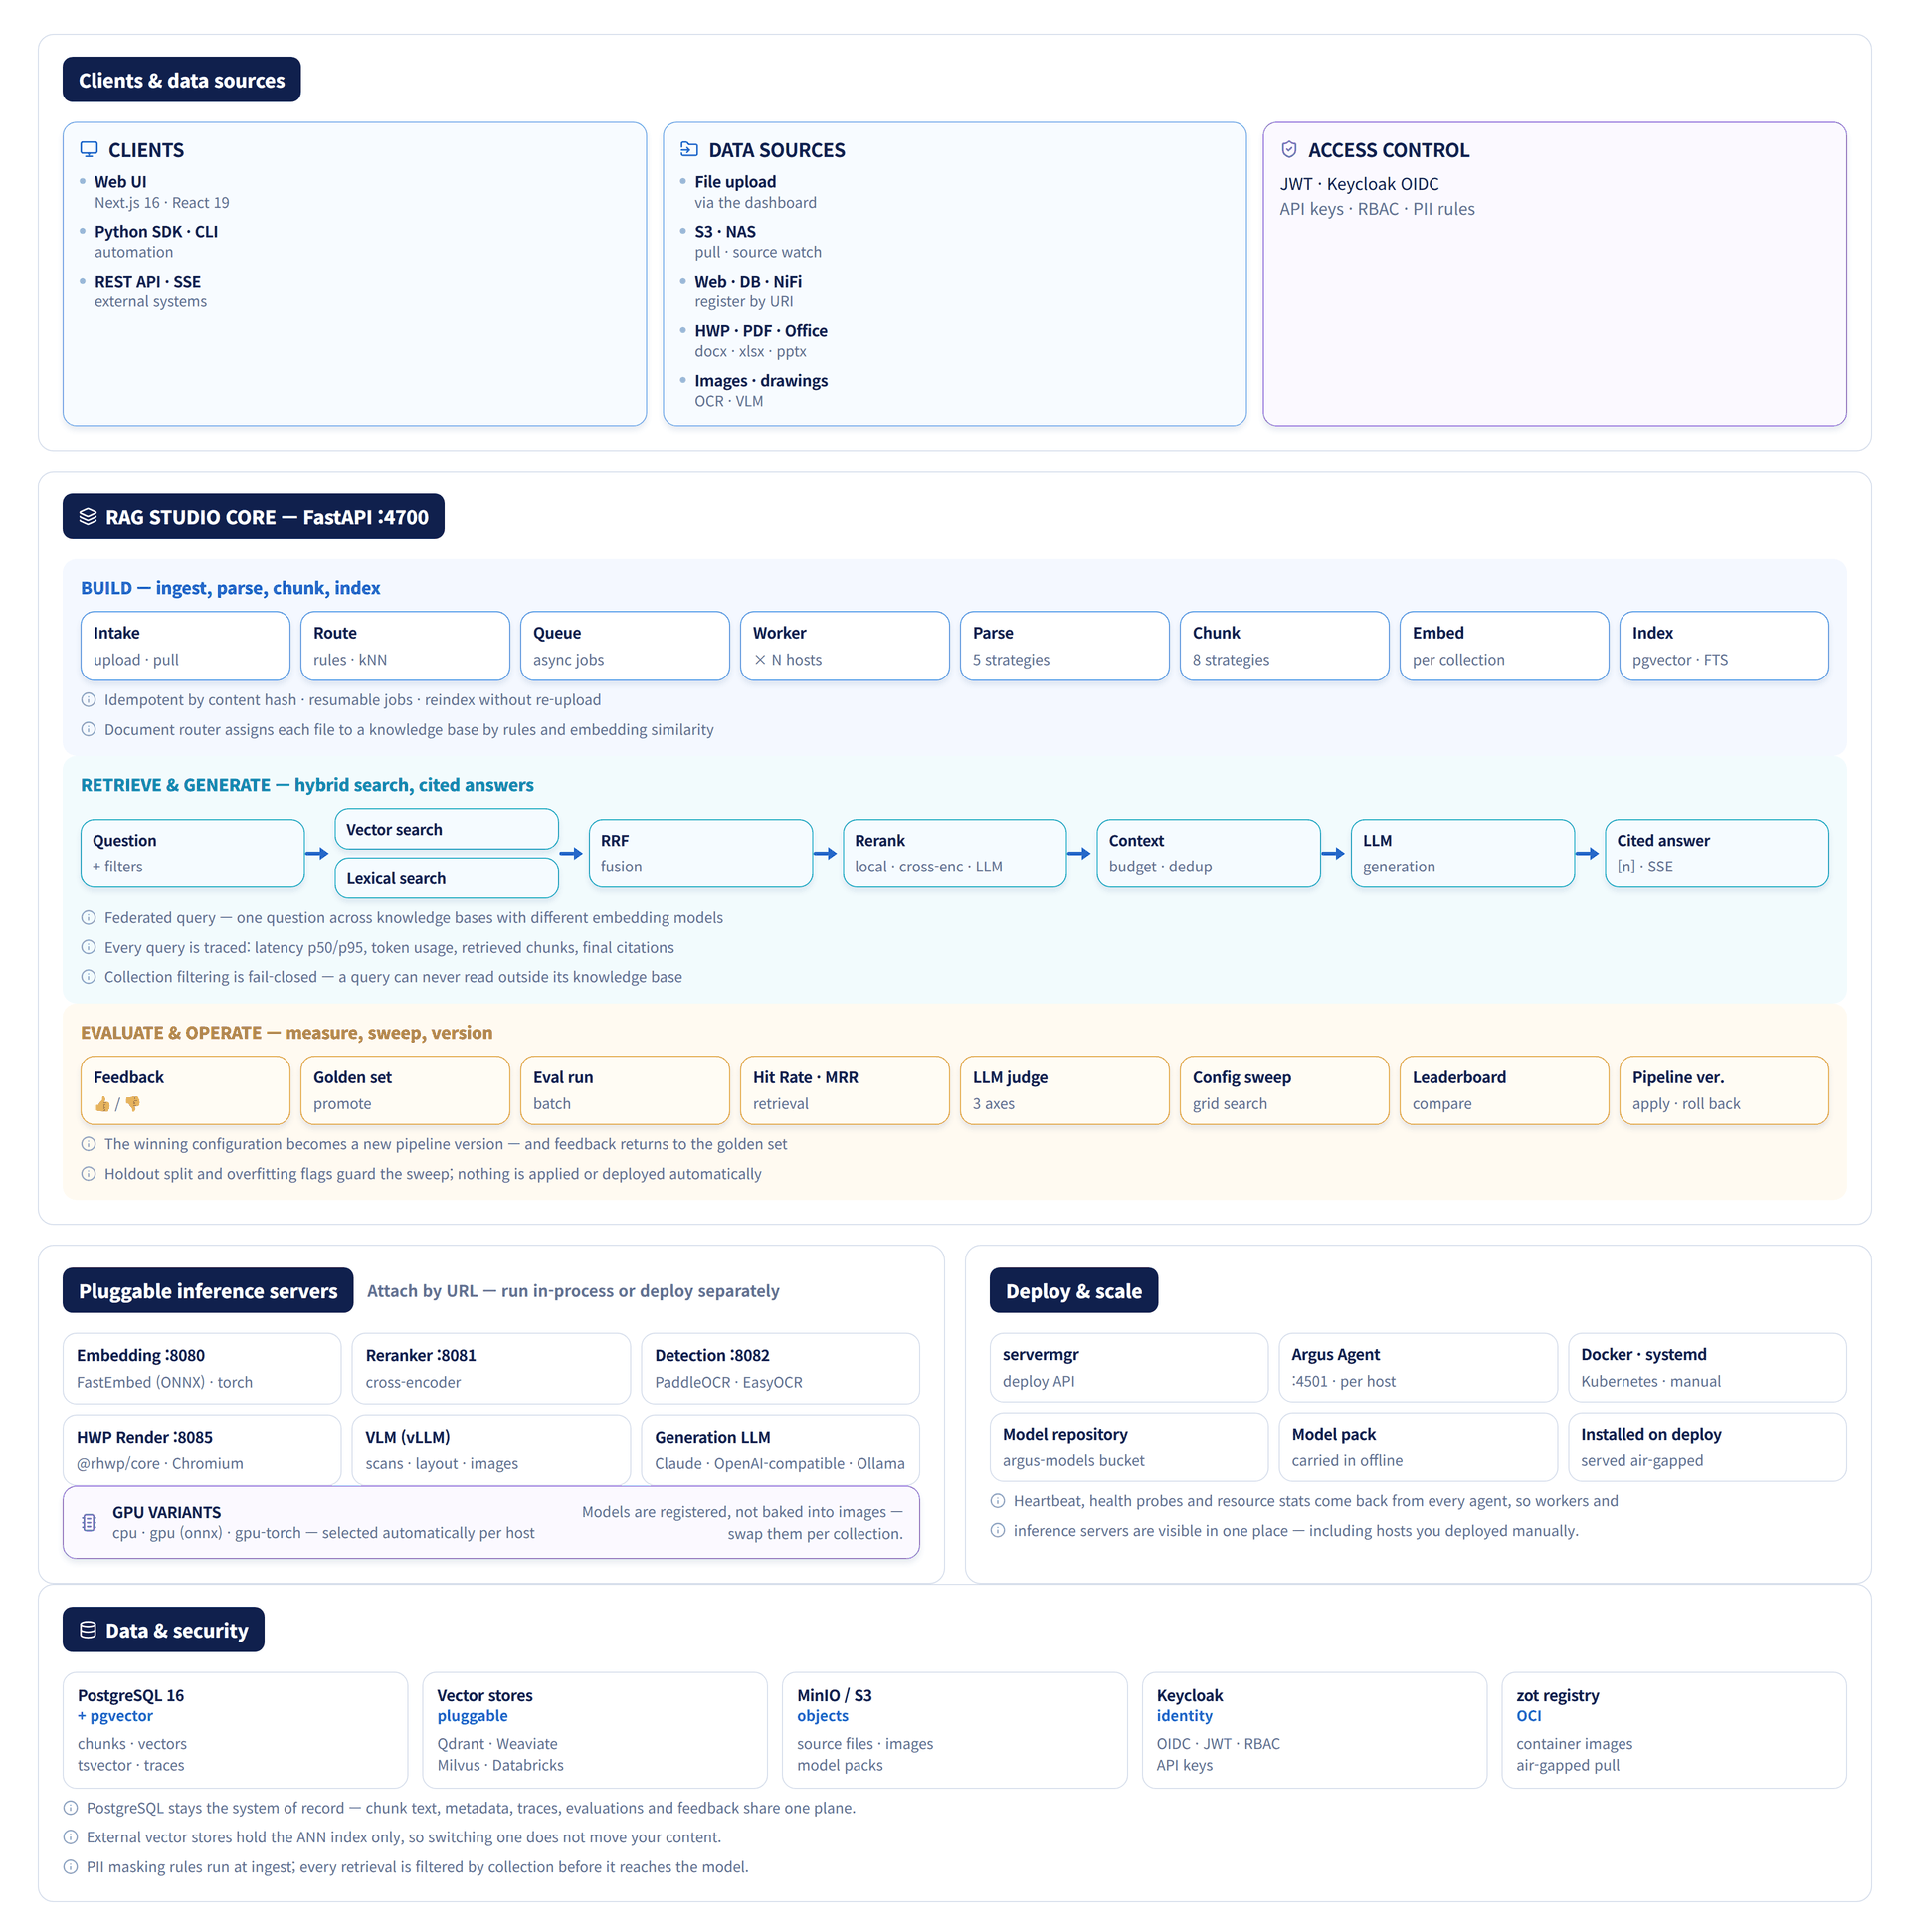
概念図
APIとワーカーが文書準備と質問処理をつなぎます。PostgreSQLはチャンクと運用データ、S3/MinIOは原本と画像を管理し、推論サービスとホストエージェントが処理と配備を支えます。
06 · デプロイと運用の拡張
基本の流れを理解したら、エアギャップ環境、エージェント、連携、運用機能を確認します。
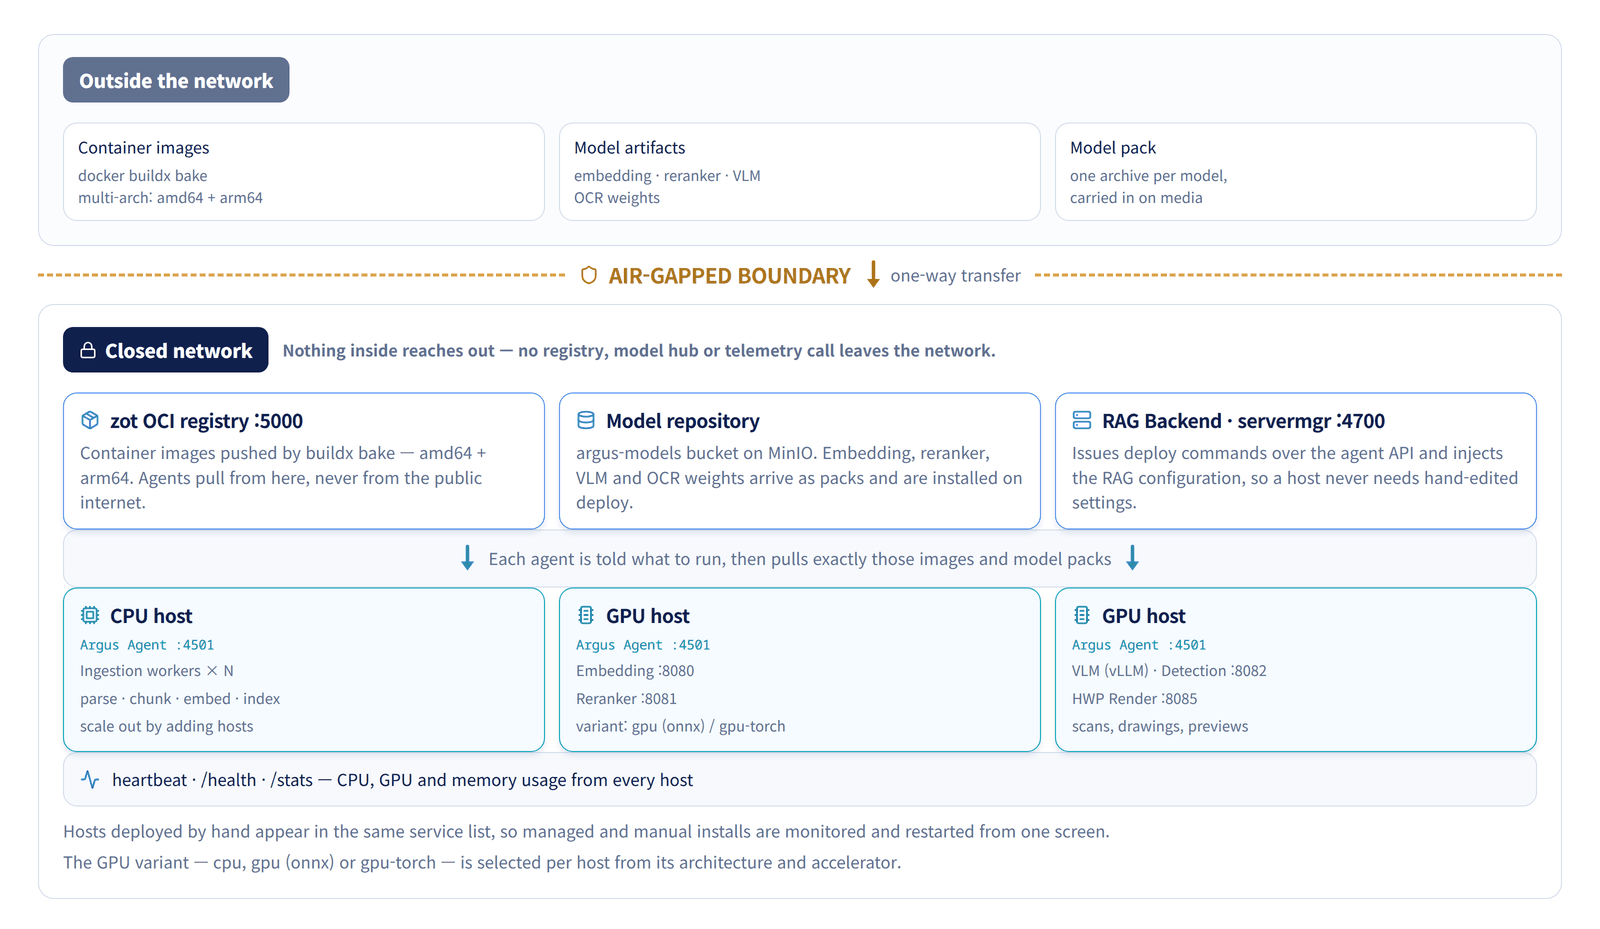
閉域網(エアギャップ)への配備
コンテナイメージとモデルパックを別々に搬入し、各ホストのArgus Agentでワーカーと推論サービスを配備します。オフライン運用には内部レジストリ、モデル保存先、ローカルエンドポイントの準備が必要です。
品質改善と閉域運用
評価、検索学習、ホストエージェント、画像レビューを RAG パイプラインに接続します。
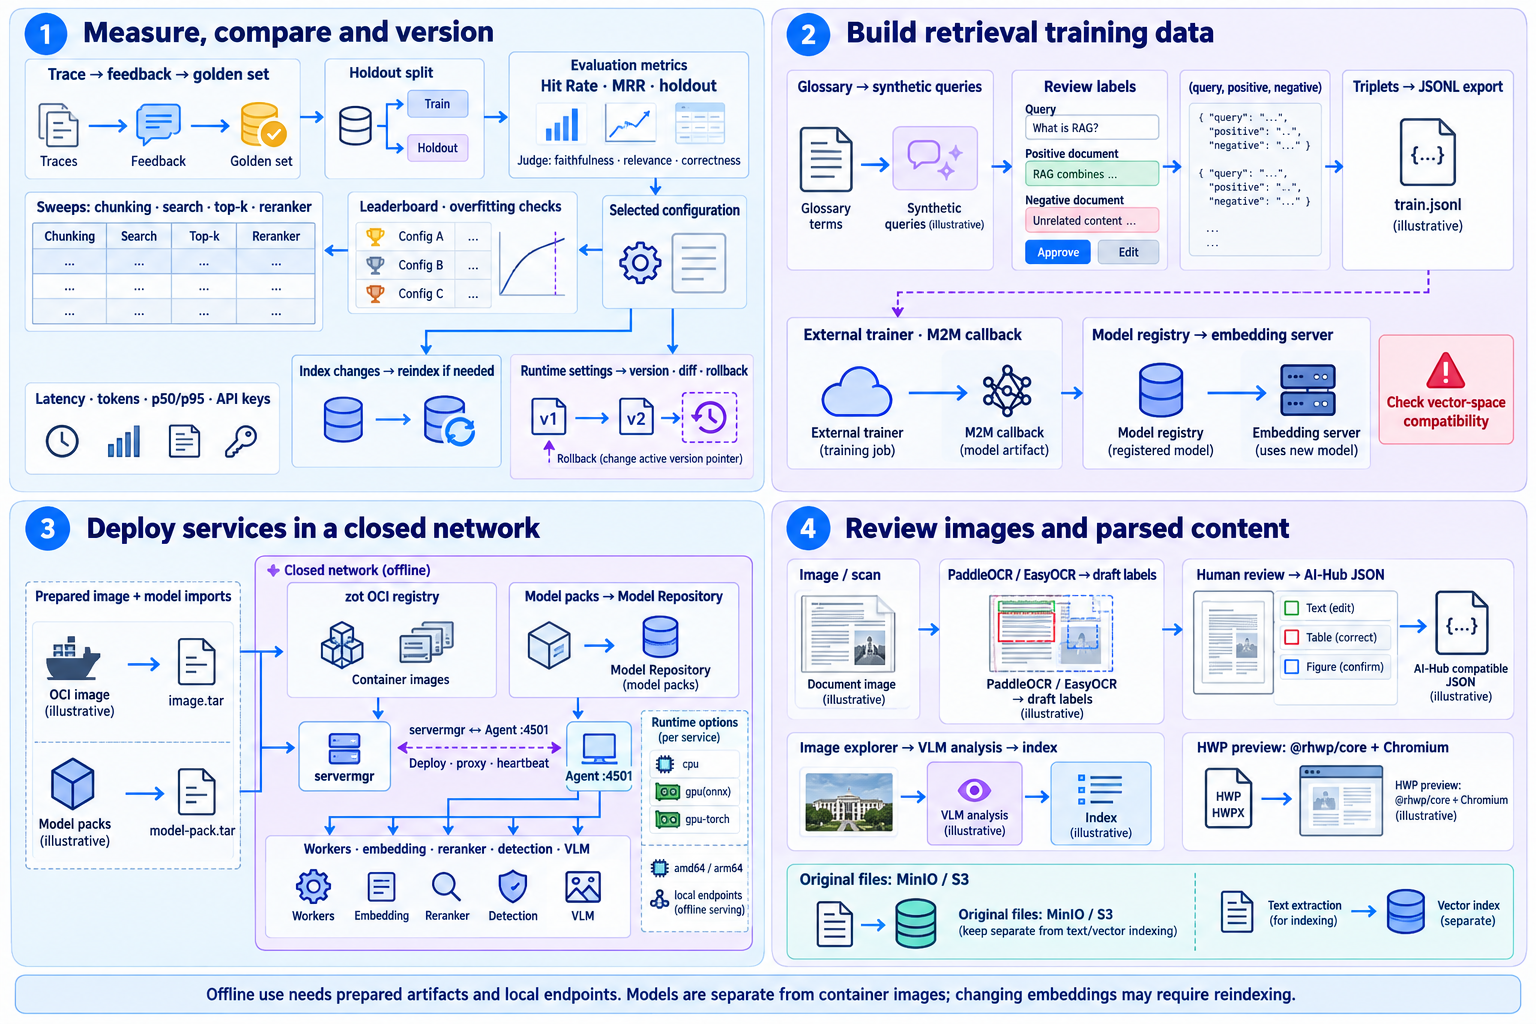
- 1.評価とバージョン
- ホールドアウト指標を比較し、インデックス変更と実行設定を分けて管理します。
- 2.検索学習
- 合成トリプレットを確認し、外部学習とモデル登録を接続します。
- 3.閉域展開
- イメージとモデルを個別に搬入し、ホストエージェントで配置します。
- 4.画像処理
- OCR 注釈を確認し、画像探索と VLM 分析を索引化につなげます。
オフライン運用には事前搬入とローカル接続先が必要です。モデルはイメージとは別で、埋め込み変更時は再インデックスが必要な場合があります。
GitHubの文書・コードを見るオープンソースで公開されるRAGプラットフォーム
Argus RAG Studio は Apache License 2.0 で GitHub に公開されます。バックエンド(FastAPI)・フロントエンド(Next.js)・スタンドアロンの埋め込み/リランカーサーバーまでRAGエンジン全体を公開し、企業がコードを直接検証し、自社環境に合わせて拡張し、データを外部に出さずに運用できます。
- 商用利用の制約がない Apache 2.0
- コードを直接検証・拡張可能
- エアギャップ・オンプレミスで自社運用