
Cloudera
Clouderaパートナーとして、オンプレミス環境の導入設計、構築、運用支援、教育を提供します。
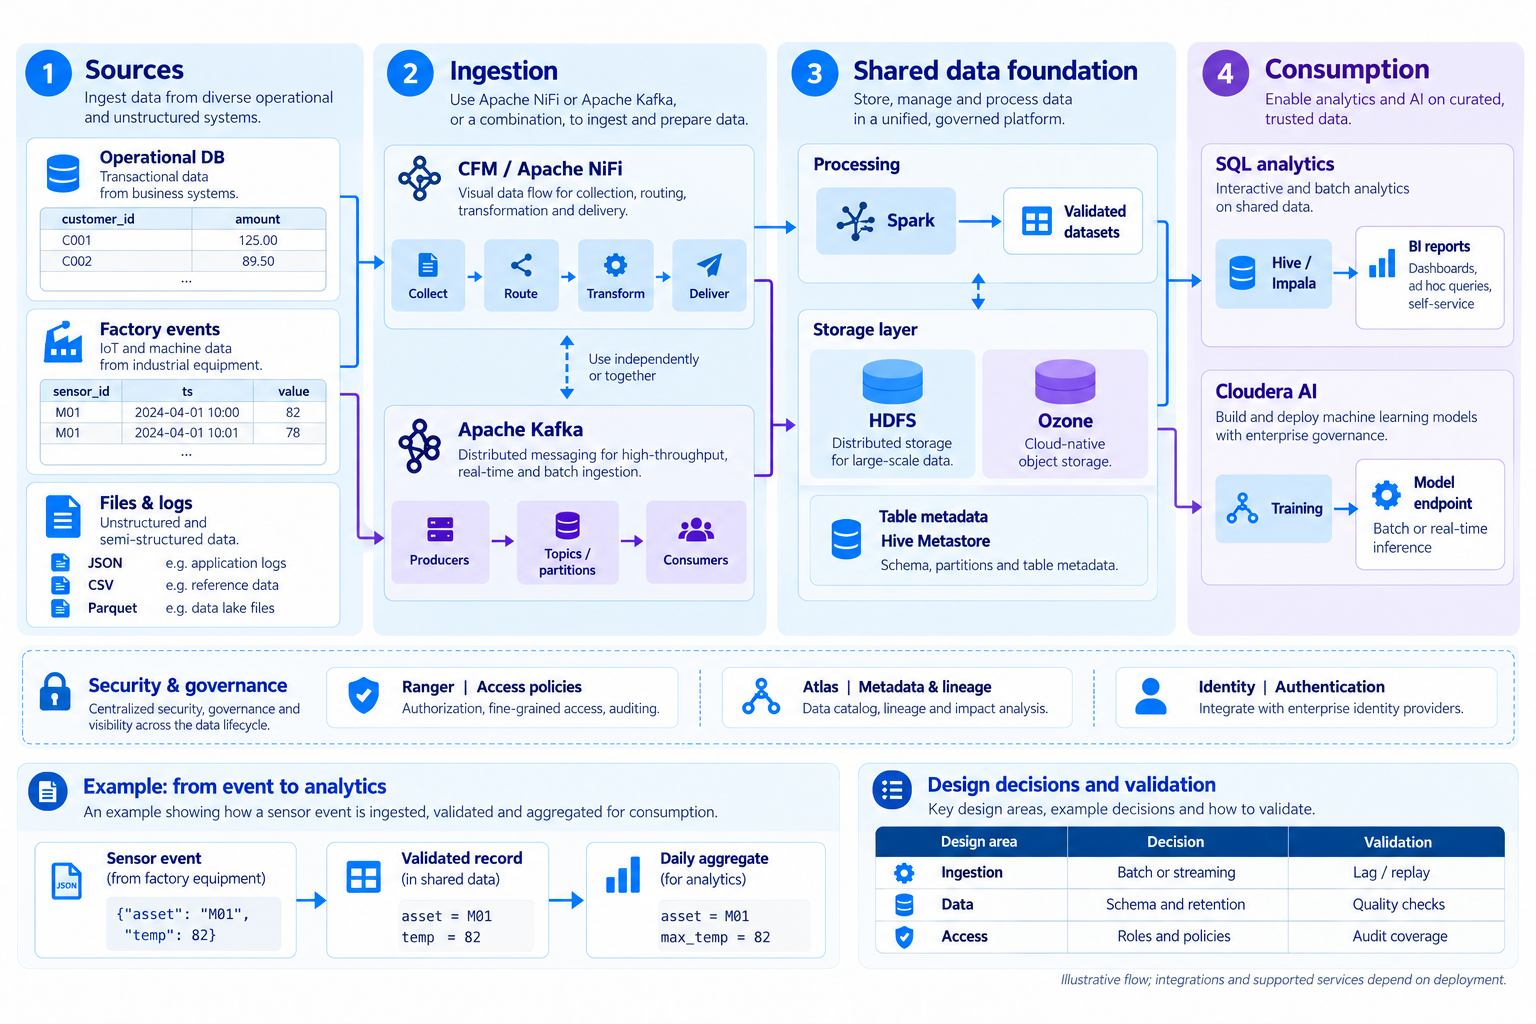
企業データを分析とAIにつなぐ流れ
設備や業務システムのデータを収集し、共通のデータ基盤で分析とAIサービスを運用します。
図・製品・サービスの詳細を見る
- 1.データソース
- 設備センサー、業務DB、ログや文書から必要なデータを収集します。
- 2.収集と配信
- NiFiのデータフローとKafkaのイベントストリームを要件に合わせて構成します。両者は並列の経路として利用できます。
- 3.共通データ基盤
- Clouderaのストレージと処理環境でデータを管理し、Sparkなどで加工します。
- 4.分析とAIの活用
- 同じデータ基盤をSQL・BI分析とモデル学習・推論でそれぞれ活用します。
Clouderaオンプレミスデータプラットフォーム
Clouderaは保存、処理、分析、AI向けのデータプラットフォームです。オンプレミスではCloudera BaseとData Servicesを中心に構成し、SDX技術でセキュリティとメタデータ管理を設計します。既存資産とデータ保存場所の要件に応じてサービスを選択します。
- Cloudera Base:HDFS、Ozone、Hive、Impala、Spark、Kafkaなどコアデータサービス
- Cloudera Data Services:KubernetesベースのCDW、CDE、Cloudera AIによるコンピュート分離
- SDX(Shared Data Experience):RangerおよびAtlasによる統合セキュリティ・ガバナンス
- Cloudera Managerによる統合運用・モニタリング
概念図です。セキュリティ、ガバナンス、連携の適用範囲は実際の構成に合わせて設計します。
公式ドキュメントCloudera BaseとData Servicesの関係
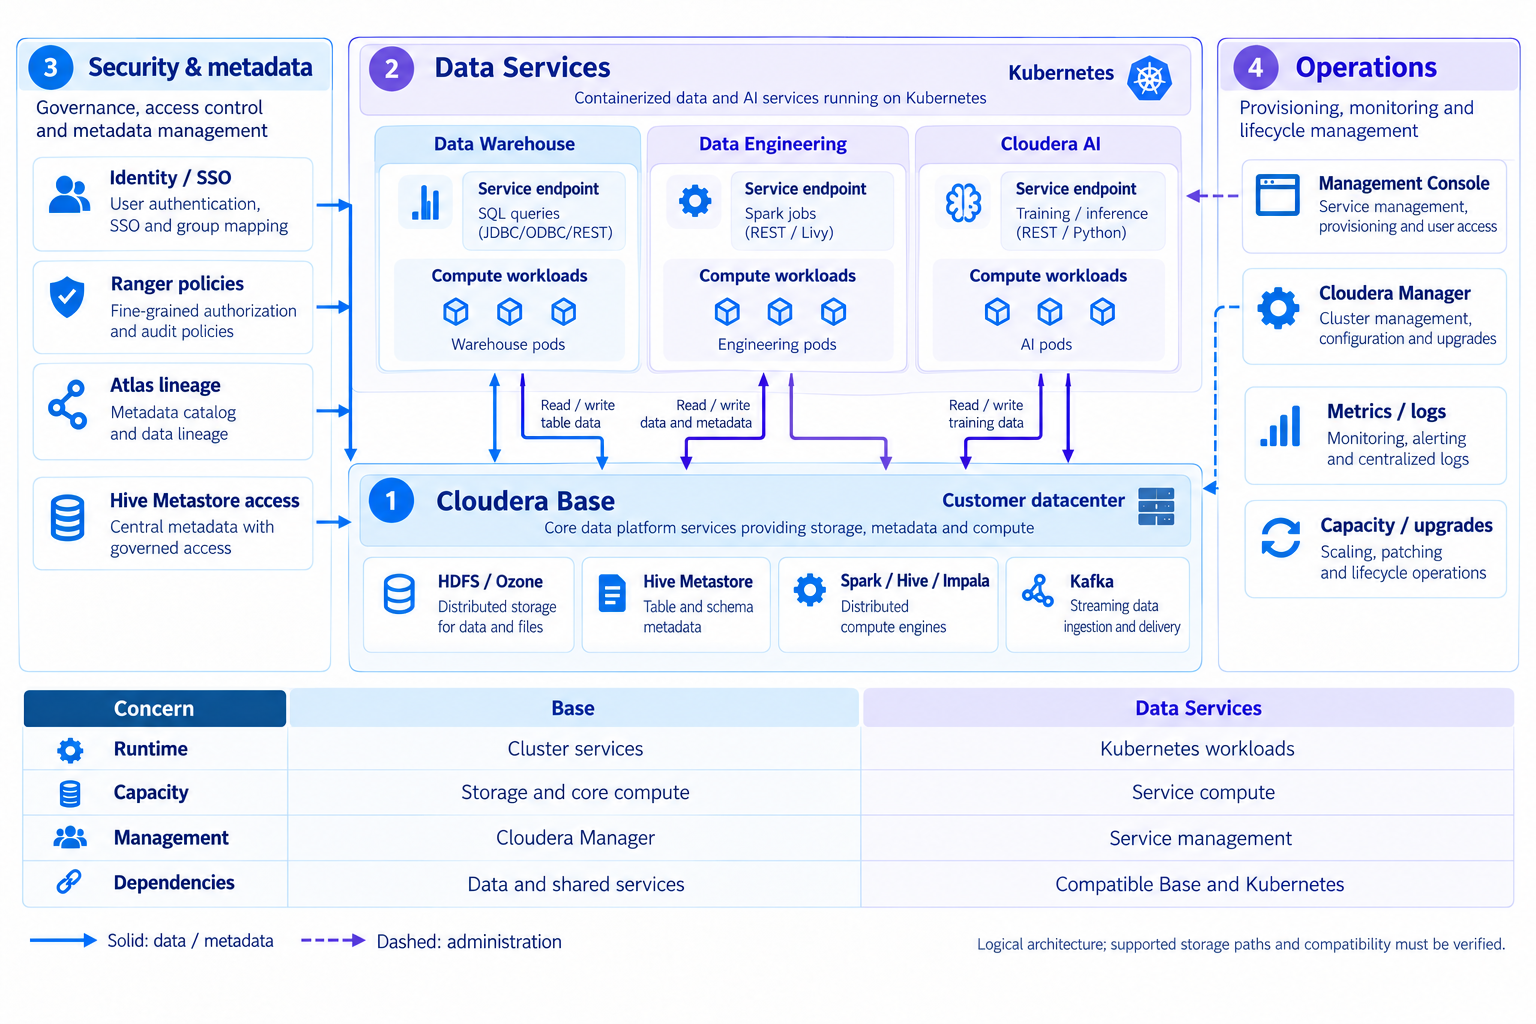
共通データ基盤とサービス別のコンピュートを分けて、製品と運用の役割を整理します。
図・製品・サービスの詳細を見る
- 1.Cloudera Base
- HDFSやOzoneなどのストレージと基本的な処理サービスを構成します。
- 2.Data Services
- KubernetesベースのData Warehouse、Data Engineering、Cloudera AIが共通データ基盤を利用します。
- 3.セキュリティとガバナンス
- Ranger・AtlasなどのSDX技術でアクセス制御とメタデータ管理を設計します。
- 4.運用と管理
- Cloudera Managerによる基盤クラスタ管理とData Servicesの管理機能を区別します。
CDP Private Cloud Base/Data ServicesとCMLは旧称です。導入時に対応構成とバージョンの互換性を確認します。
公式ドキュメントCloudera CDPのデータ・サービス・ガバナンス
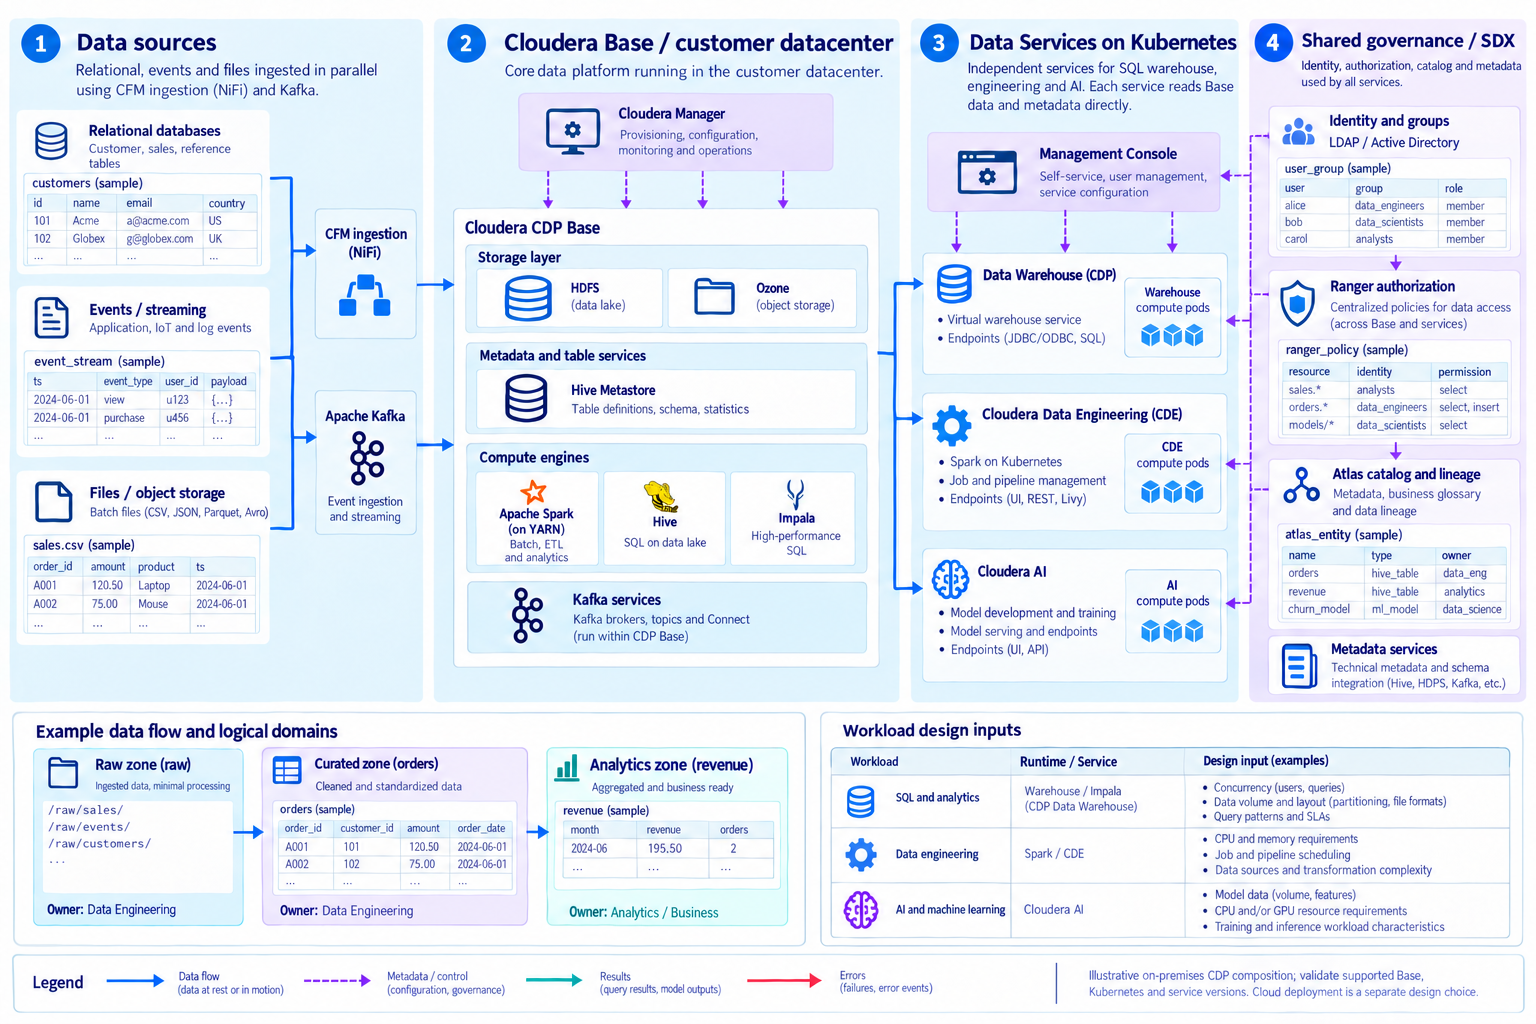
Cloudera BaseとKubernetes Data Servicesの構成と管理境界を示します。
図・製品・サービスの詳細を見る
- 1.取り込み
- DB、イベント、ファイルをNiFiやKafkaの適切な経路へ接続します。
- 2.Cloudera Base
- HDFS・Ozone、メタデータ、基本処理を構成し、Cloudera Managerで運用します。
- 3.Data Services
- Warehouse、CDE、Cloudera AIが共通データへ独立してアクセスし、Management Consoleで管理します。
- 4.SDXガバナンス
- ID・グループ、Ranger権限、Atlasリネージとメタデータを管理します。
オンプレミスの構成例です。Base、Kubernetes、各サービスの互換性を確認します。クラウド構成は別途設計します。
公式ドキュメントCFM・Apache NiFiのデータフロー
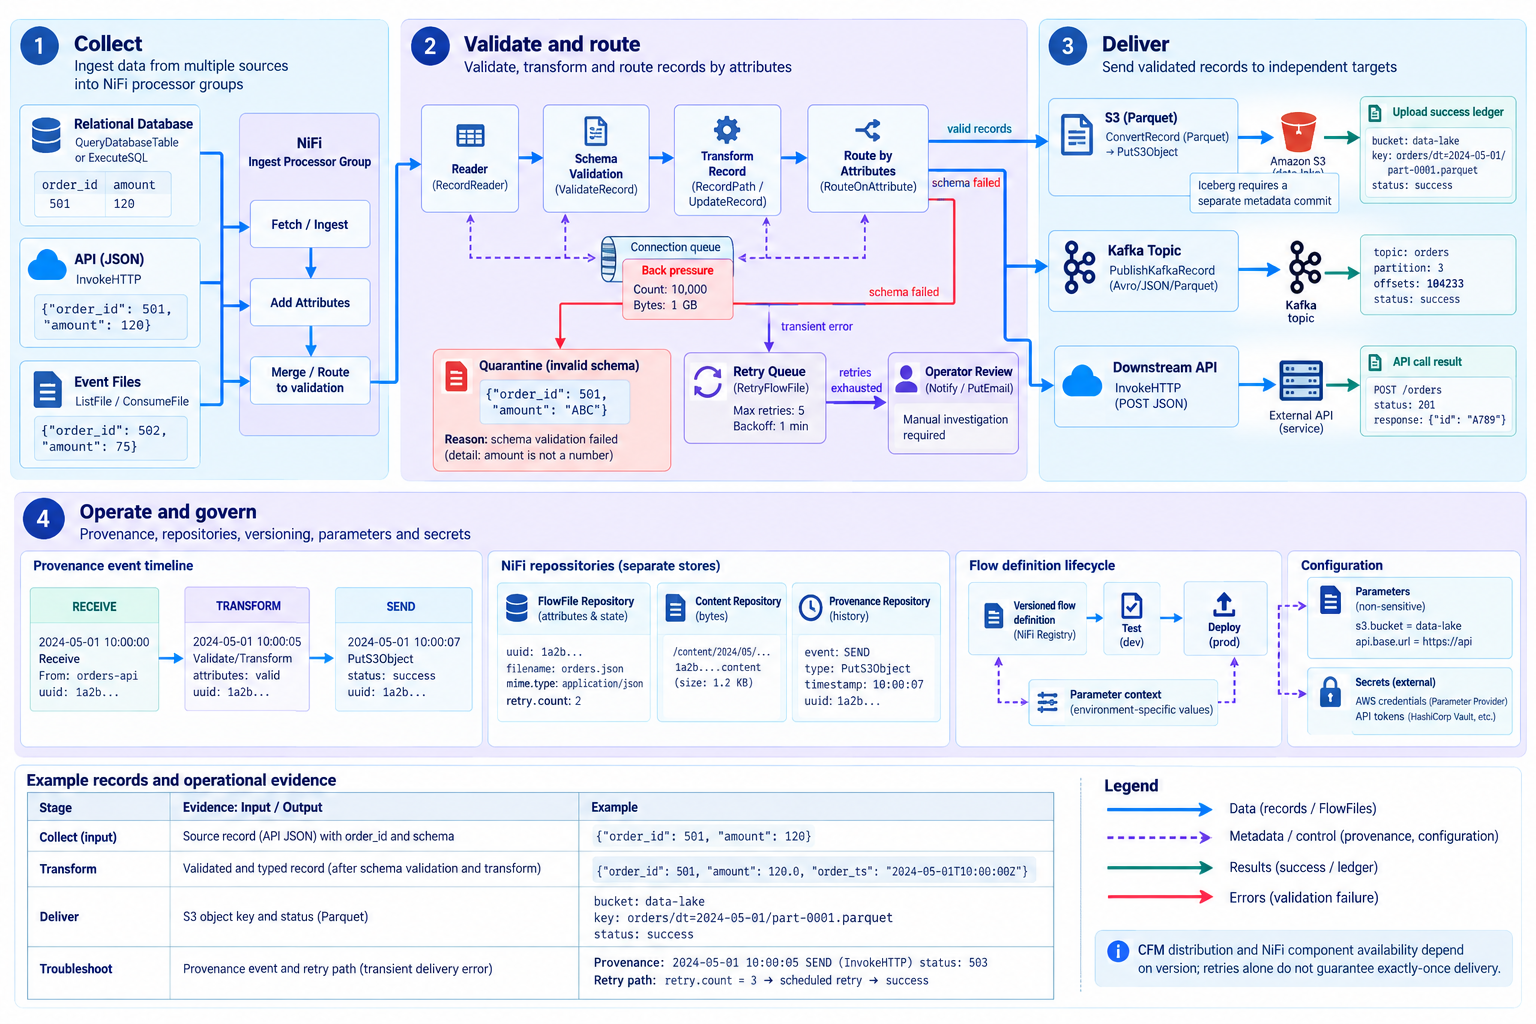
プロセッサー、キュー、バックプレッシャー、エラー経路、データ来歴を詳しく示します。
図・製品・サービスの詳細を見る
- 1.収集
- DB、API、イベントファイルをFlowFileとレコードとして処理します。
- 2.検証と振り分け
- スキーマ・属性で変換し、キューの流入を調整して隔離と再試行を分離します。
- 3.配信
- S3 Parquet、Kafka、APIを独立した宛先とし、状態とオブジェクトキーを記録します。
- 4.運用と追跡
- FlowFile、コンテンツ、来歴の各リポジトリを分け、バージョン管理したフローとパラメーターを展開します。
対応コンポーネントはリリースに依存します。再試行だけではexactly-onceを保証しません。S3ファイルをIcebergで読むにはメタデータのコミットが必要です。
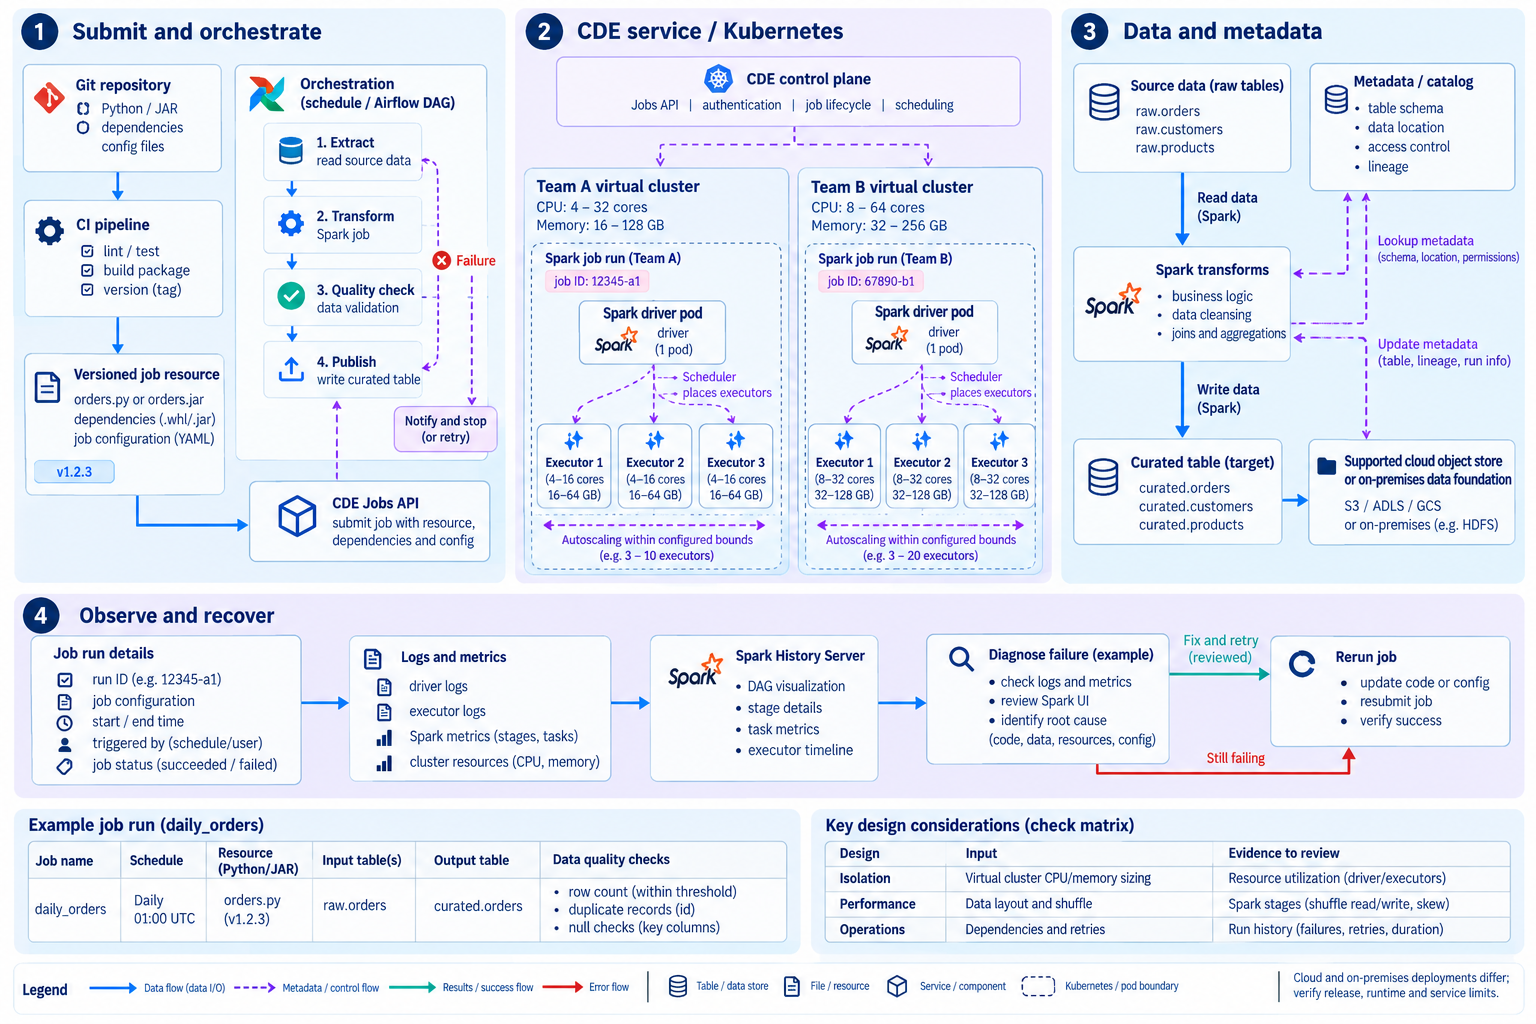
公式ドキュメントCDEの仮想クラスターとSparkジョブ
コード・依存関係の登録からSpark実行、品質検証、運用までを示します。
図・製品・サービスの詳細を見る
- 1.登録と実行制御
- Python・JARと依存関係をCDEジョブに登録し、スケジュールまたはAirflow DAGで実行します。
- 2.仮想クラスター
- チーム別CPU・メモリー範囲でドライバーとエグゼキューターを実行します。
- 3.データ処理
- 対応ストレージから読み取り、変換・品質検証後に整備済みテーブルを公開します。
- 4.観測と復旧
- 実行ID、ログ、メトリクス、Spark History Serverで調査し、失敗ジョブの再実行を検討します。
クラウドとオンプレミスでストレージ・ランタイムの対応が異なります。リソース範囲、自動拡張の上限、依存関係を確認します。
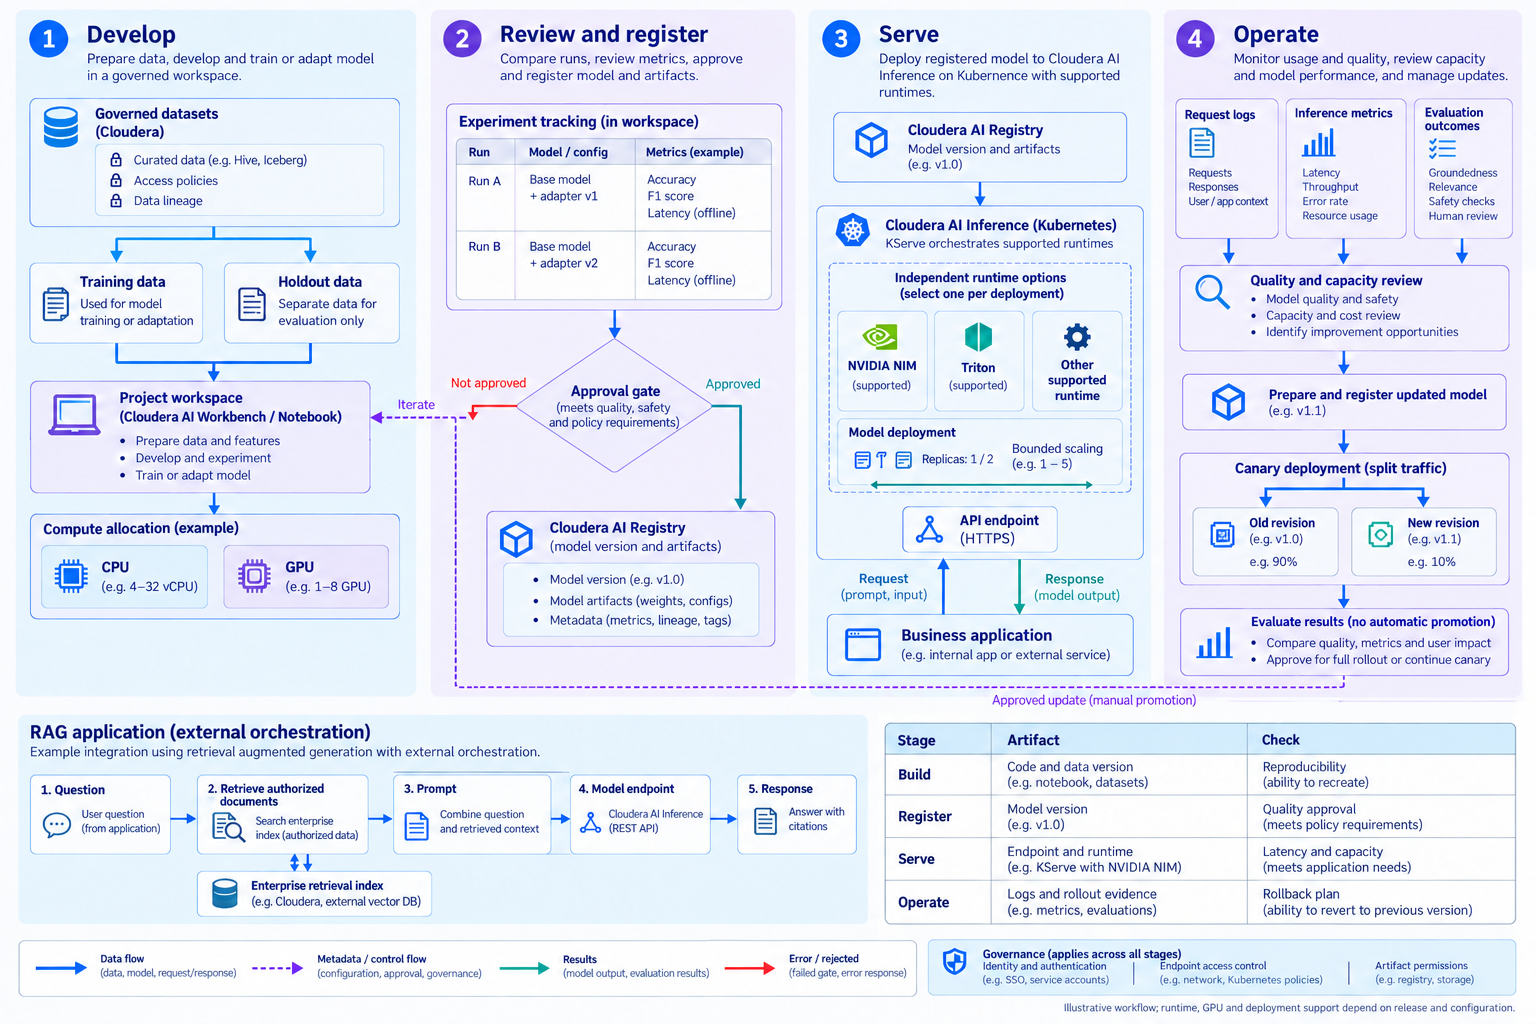
公式ドキュメントCloudera AIの開発・登録・推論・運用
モデル開発・評価からAI RegistryとInferenceサービスへつなぎます。
図・製品・サービスの詳細を見る
- 1.開発
- 管理されたデータとプロジェクト環境で学習・調整し、独立した評価データで検証します。
- 2.確認と登録
- 実験を審査し、承認したモデルの版と成果物をCloudera AI Registryへ登録します。
- 3.推論
- KServe基盤で対応するNIM・Tritonなどのランタイムとエンドポイントを構成します。
- 4.運用
- ログ、推論指標、品質、容量を確認し、段階的な展開と復旧を管理します。
ランタイム、GPU、配置、アクセス制御は版と構成ごとに確認します。RAG検索とプロンプト組み立てはアプリケーションの役割で、推論サービス内のベクトル保存を意味しません。
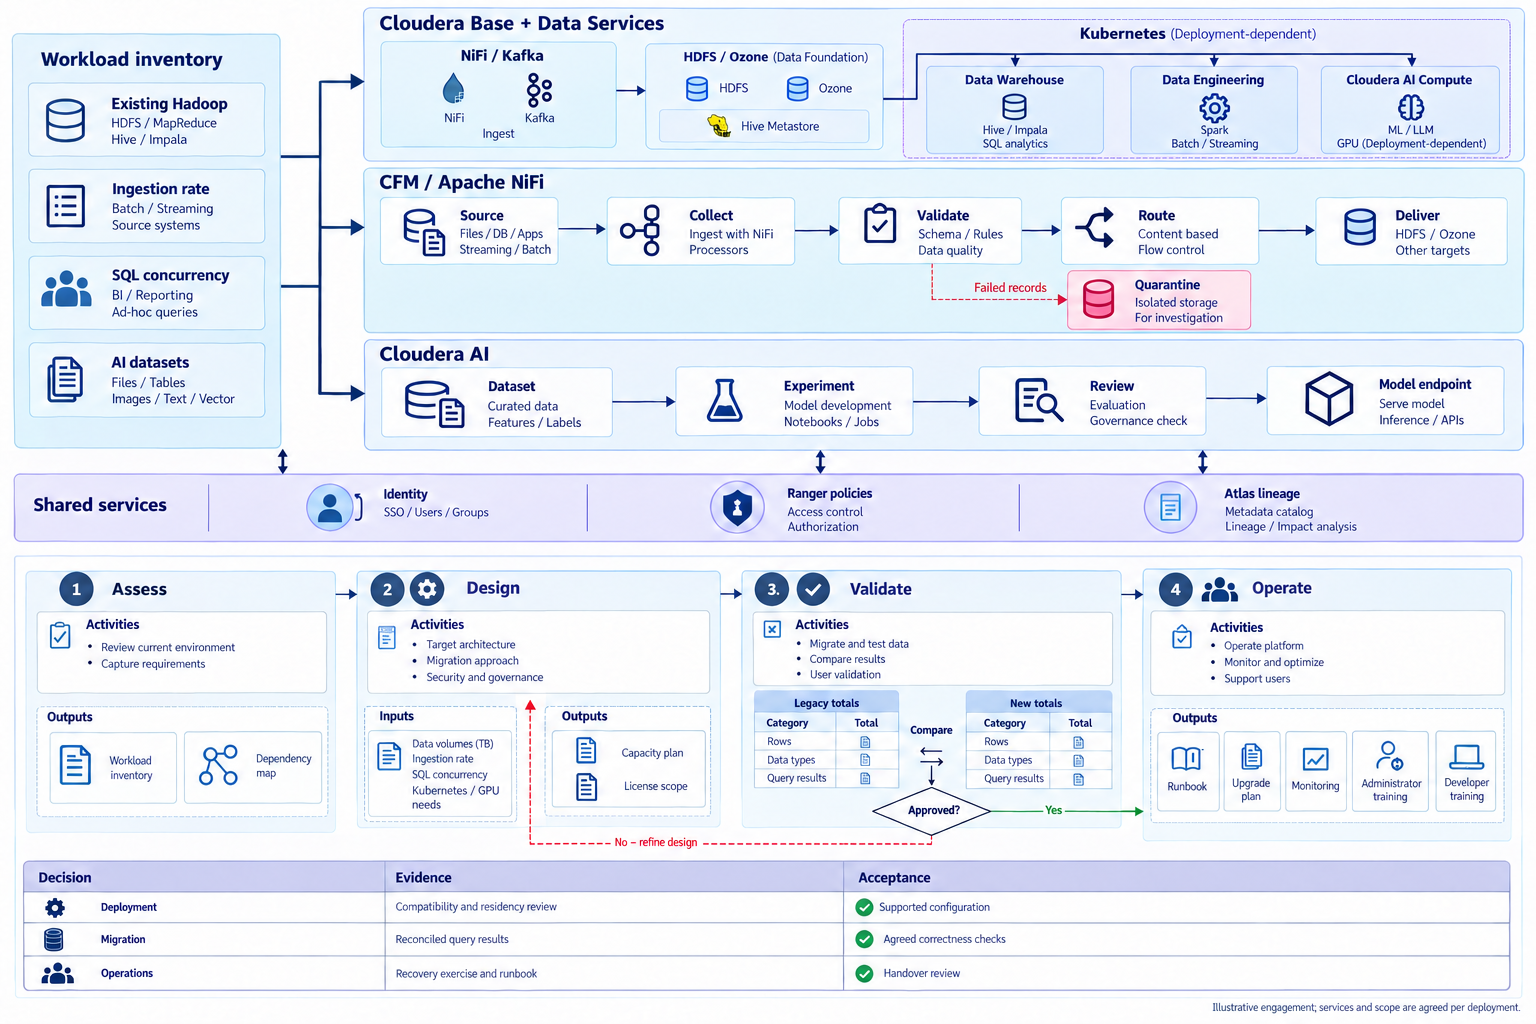
公式ドキュメントData DynamicsのClouderaサービス
製品と用途の選定から、要件分析、検証、運用引き継ぎまでをつなぎます。
図・製品・サービスの詳細を見る
- 1.要件分析
- 既存システム、データ、ワークロード、運用制約を調査し、導入範囲を定めます。
- 2.製品と構成の選定
- 用途に合わせて製品、配置方式、容量、アクセス権、調達範囲を検討します。
- 3.検証と移行
- 代表的なワークロードで整合性、性能、連携を確認し、受け入れ基準と復旧手順を検討します。
- 4.運用と教育
- 監視、運用手順書、アップグレード計画、担当者教育を通じて引き継ぎを準備します。
Cloudera製品ポートフォリオ
- Cloudera Base · Data Services
Cloudera Baseのデータ基盤とKubernetesベースのData Servicesを組み合わせ、ウェアハウス、エンジニアリング、AIを構成します。
Cloudera Base · Data Services · SDX · Cloudera Manager
- CFM (Cloudera Flow Management)
Apache NiFiを基盤としたエンタープライズデータフロー管理。数百のコネクタでデータをリアルタイムに取り込み、変換、配信。エッジ、オンプレミス、クラウドに対応。
Apache NiFi · NiFi Registry · MiNiFi · Flow Designer
- Cloudera AI
Cloudera Machine Learning(CML)とCloudera AI Inferenceにより、データサイエンティストはCDPデータ上でモデルのトレーニング、デプロイ、サービングが可能 — 生成AIおよびRAGワークロードを含む。
CML · MLflow · Model Serving · LLM / RAG
導入前に確認するポイント
機能一覧だけでなく、実際のデータ要件と運用条件から導入範囲を決めます。
- 適した環境
自社データセンター、既存Hadoop資産、データ保存場所の要件を検討します。
- 構成とサイジング
データ量、収集量、同時利用者数、KubernetesやGPUの要否を確認します。
- 導入・運用支援
現状調査、構成設計、移行検証、運用手順、教育の範囲を協議します。
Data DynamicsのClouderaサービス
- ライセンス販売
公式パートナーとして、Cloudera Base/Data Services、CFM、Cloudera AIライセンスを競争力のある条件で提供。お客様の環境に合わせたサイジングとお見積りも承ります。
- Cloudera BaseおよびData Servicesライセンス
- CFM(NiFi)ライセンス
- Cloudera AI(CML)ライセンス
- ワークロードベースのサイジングおよびTCO分析
- 技術サポート
CDP、CFM、Cloudera AIに対するエンドツーエンドの技術サポート — ソリューション設計・実装からインシデント対応、パフォーマンスチューニングまで。
- CDP Private Cloudのデプロイおよびアップグレード
- CDH/HDPからCDPへの移行
- Cloudera Manager、Ranger、Atlas運用
- NiFiフロー設計およびパフォーマンスチューニング
- CML環境セットアップおよびMLOpsサポート
- インシデント対応およびパフォーマンス最適化
- トレーニング
管理者、開発者、データサイエンティスト向けのハンズオンClouderaトレーニング。お客様の内部専門性を迅速に構築します。
- CDP管理者コース
- Spark、Hive、Impala開発者コース
- NiFi(CFM)データフローハンズオンコース
- Cloudera Machine Learningハンズオンコース
- カスタマイズワークショップおよびオンサイトトレーニング
導入手順の例です。製品・バージョンごとの対応範囲、受け入れ基準、提供サービスは環境と契約に応じて確定します。