
Starburst (Trino)
Trinoベースのエンタープライズ・レイクハウス分析プラットフォームです。すべてのデータを一か所に事前集約せず、複数ソースをSQLで分析できます。Starburst EnterpriseとフルマネージドのGalaxyがセキュリティ、ガバナンス、運用機能を提供します。
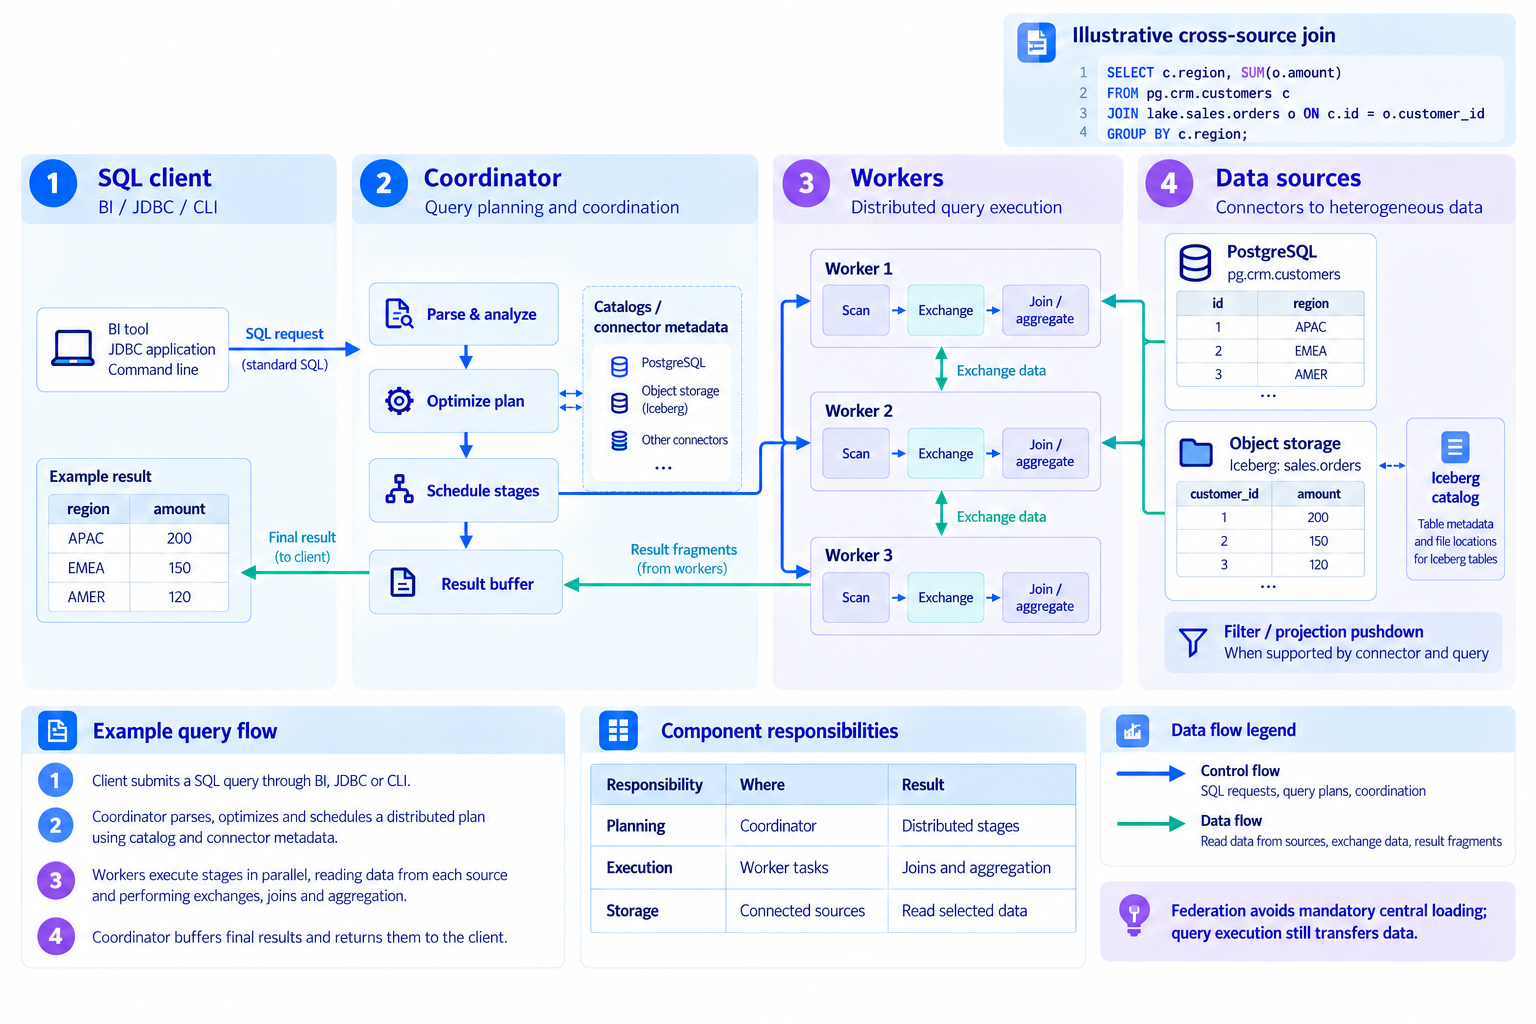
一つのSQLで複数のデータソースをつなぐ
すべてのデータを一か所に事前集約せず、必要なデータを接続して分析します。
図・製品・サービスの詳細を見る
- 1.SQLリクエスト
- BIツールが顧客・注文テーブルを結合し、地域別の注文金額を集計するSQLを送信します。
- 2.実行計画
- コーディネーターがクエリを解析し、ソースと統計に基づいて実行計画を作成します。
- 3.分散処理
- ワーカーがソースを読み取り、返されたデータを結合・集計します。対応する条件や集計はプッシュダウンできます。
- 4.データソース
- PostgreSQLの顧客情報とIcebergの注文データを必要な範囲で読み取り、結果を返します。
Starburst と Trino の概要
StarburstはTrinoベースの分散SQLエンジンに企業向けのセキュリティ、運用、性能機能を加えた分析基盤です。コネクターでレイクハウスやデータベースを接続し、全データを事前に一か所へ集約せずにSQL分析を開始できます。対応ソースと機能は製品・バージョン別に確認します。
- Trino ベースの MPP クエリエンジン: 常時稼働のコーディネーター+ワーカー構成でペタバイト級データに対話型応答
- データフェデレーション: Iceberg・Delta Lake・RDBMS・NoSQL・Kafka・SaaS など 50+ コネクタを単一 SQL で
- Warp Speed 加速: スマートインデックス・キャッシングでクエリ最大 5 倍、CPU 最大 10 倍改善
- エンタープライズガバナンス: 行/列単位の RBAC・ABAC、動的マスキング、Ranger 連携、クエリ監査
性能はコネクター、ソースの負荷、ネットワーク、データ分布、同時実行数に左右されます。反復クエリには事前加工や取り込みが適する場合があります。
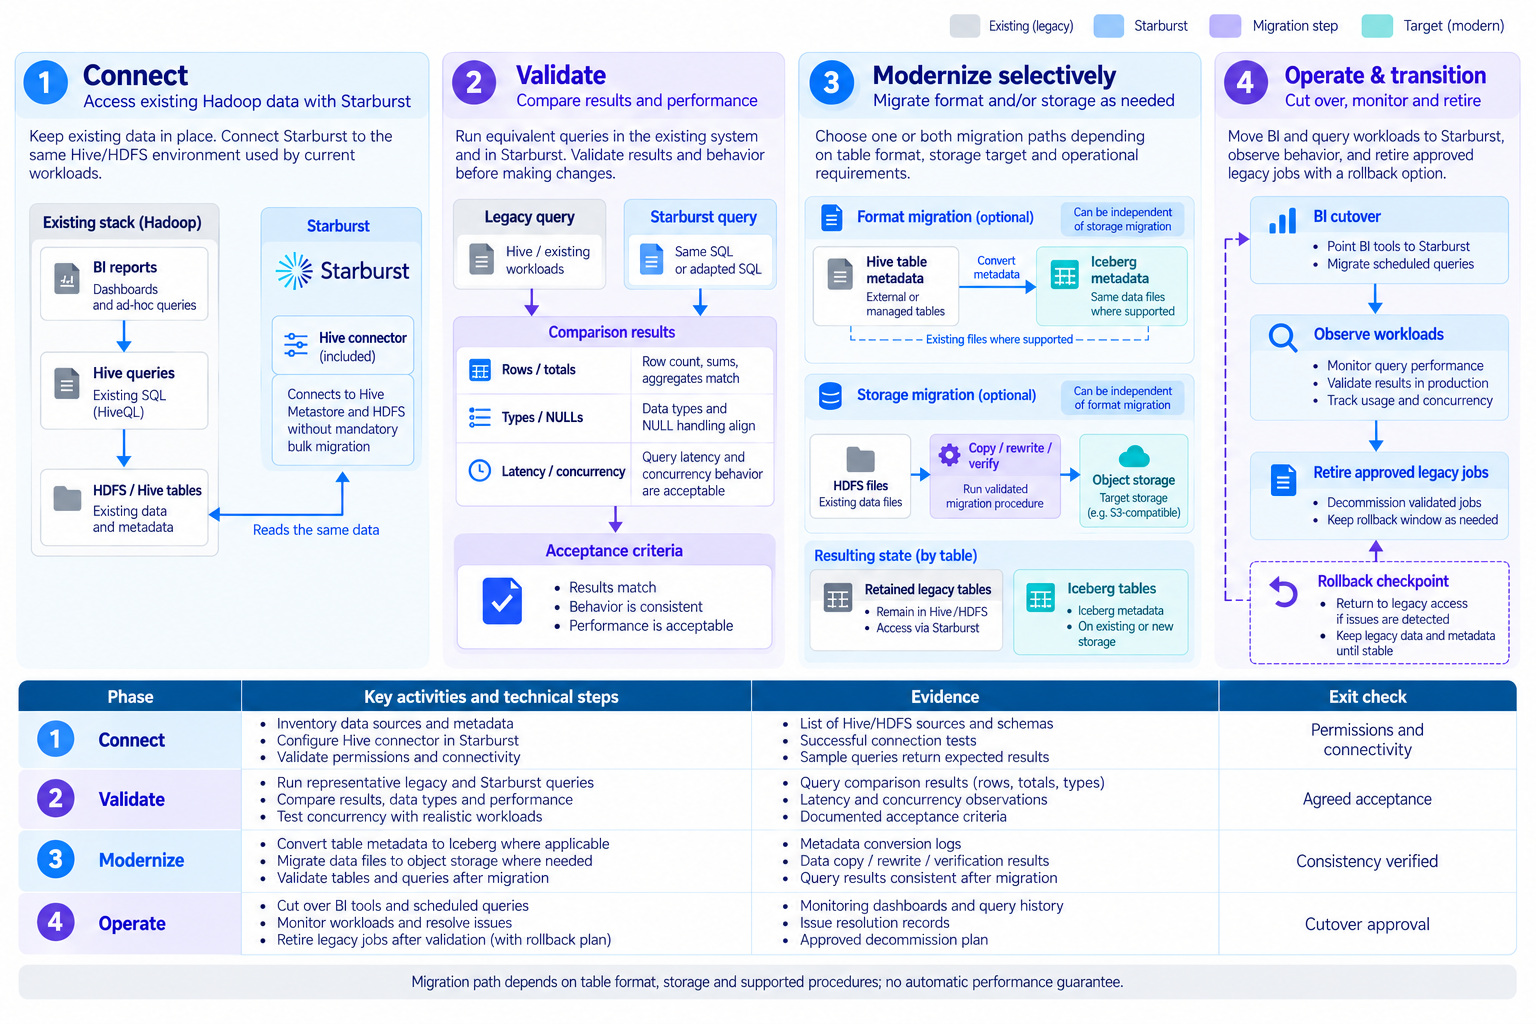
公式ドキュメントHadoop・Hive環境を段階的にモダナイズ
接続、検証、選択的な移行、運用定着の各段階で成果を確認して移行範囲を広げます。
図・製品・サービスの詳細を見る
- 1.接続
- 既存ストレージとメタストアに接続し、権限とクエリ互換性を確認します。
- 2.並行検証
- 一部の分析クエリを並行実行し、結果の一致、応答時間、ソースの負荷を測定します。
- 3.選択的な移行
- テーブル形式の変換と保存先の移動を区別し、対応手順を選んでデータ・メタデータの整合性と復旧手順を検証します。
- 4.運用定着
- 監視、権限、教育を整備し、受入条件と切戻し基準に沿って範囲を拡大します。
移行方式の例であり、性能向上や無停止を保証するものではありません。EnterpriseとGalaxyの機能、配置、運用責任を個別に確認します。
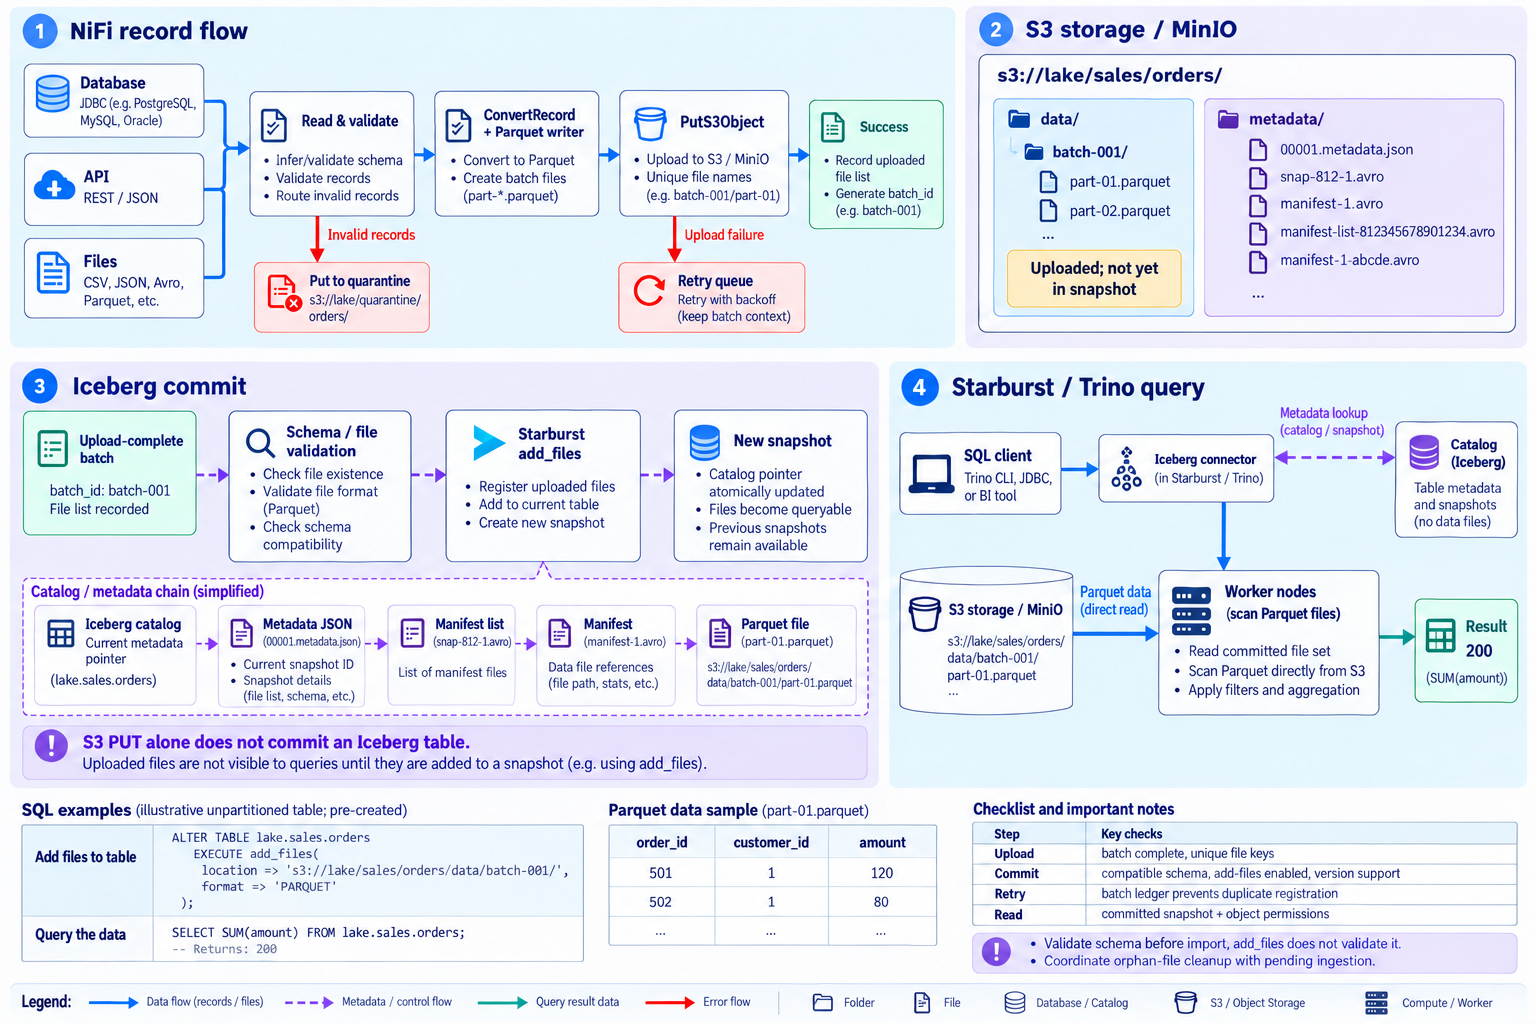
公式ドキュメントNiFi・S3からIcebergとStarburstのクエリへ
ParquetのアップロードとIcebergメタデータのコミットを分けて説明します。
図・製品・サービスの詳細を見る
- 1.NiFiのレコード処理
- 検証とParquet変換後、PutS3Objectでアップロードし、成功したバッチのファイル一覧を記録します。
- 2.S3への保存
- MinIOなどのテーブル用データパスに保存します。アップロードだけではIcebergスナップショットに入りません。
- 3.メタデータのコミット
- スキーマを事前検証し、add_filesなどの対応手順で登録します。add_files自体はスキーマ互換性を検証しません。
- 4.Starburstの読み取り
- カタログから確定したスナップショットを解決し、ワーカーが参照先のParquetを直接読み取ります。
事前作成した非パーティションテーブルの例です。add_filesの対応版・設定、スキーマ、権限を確認し、重複登録と書き込み途中のファイル削除を防ぎます。
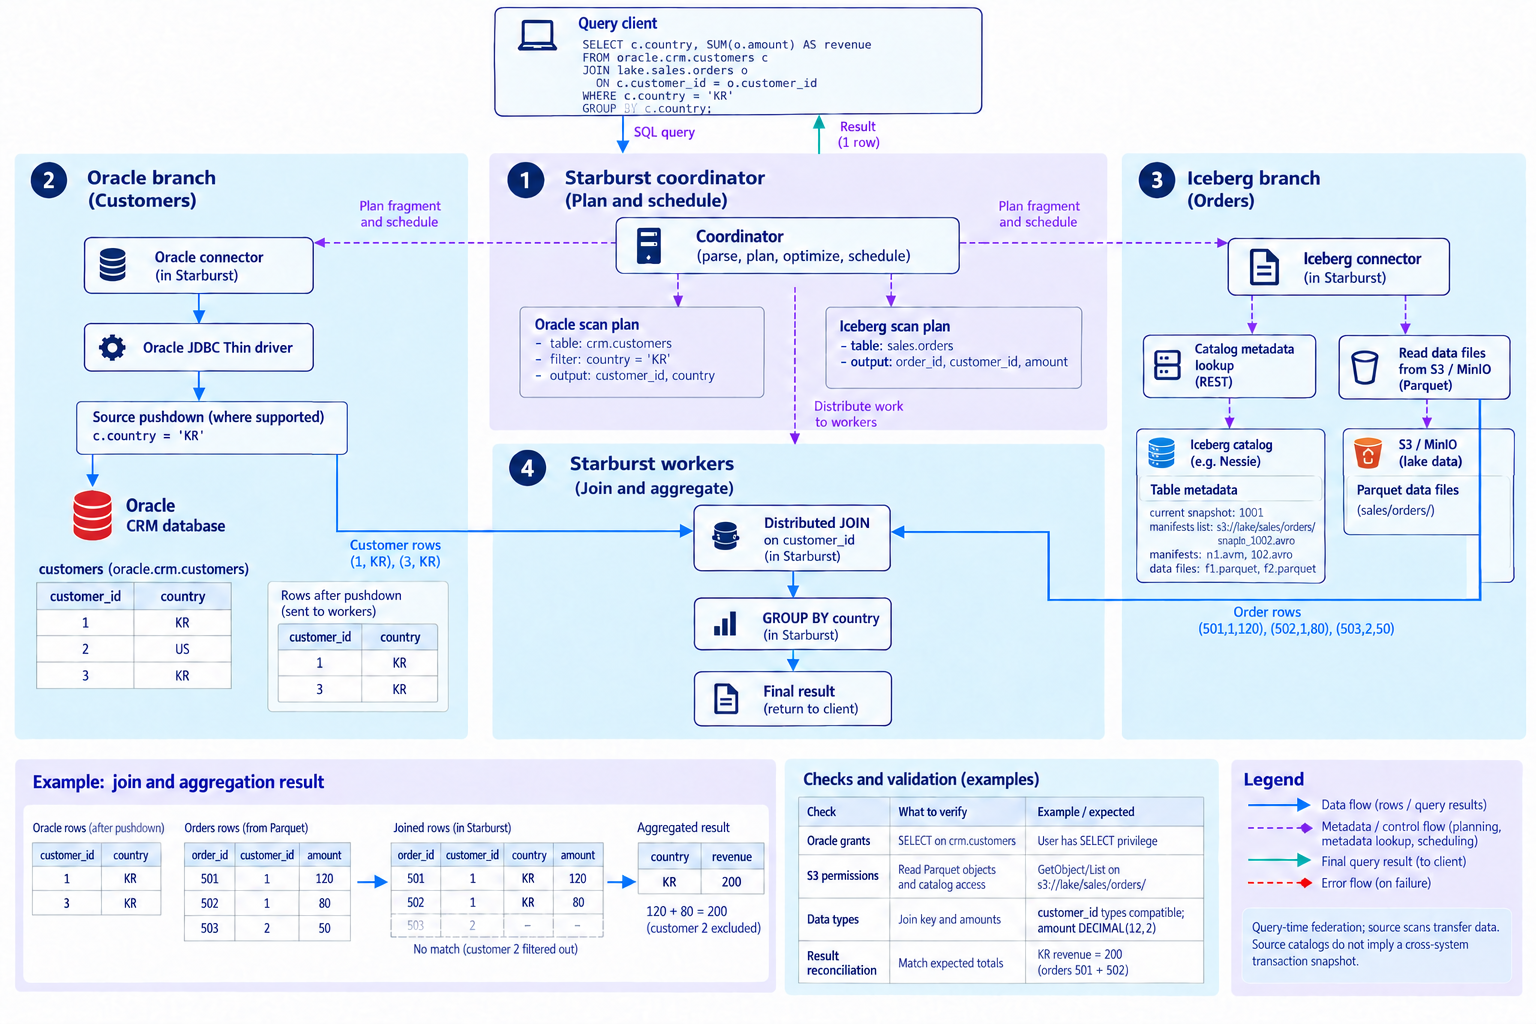
公式ドキュメントOracleとIcebergを1つのSQLでJOIN
Oracleの顧客とS3上のIceberg注文をStarburstワーカーで結合・集計します。
図・製品・サービスの詳細を見る
- 1.業務SQL
- customer_idで顧客と注文を結合し、国条件で絞って売上を集計します。
- 2.Oracleの読み取り
- OracleコネクターとOracle JDBC Thinドライバーを利用し、対応する条件をDBへ渡します。
- 3.Icebergの読み取り
- カタログの確定したファイル参照とMinIO・S3上のParquetを別々に読み取ります。
- 4.分散JOIN
- 両方の入力をワーカーで結合します。例のKRの注文120と80の合計は200です。
このカタログ間JOINはStarburstで実行します。ソース間で同一時点のトランザクションを保証するものではありません。キー、型、権限を検証します。
公式ドキュメントOracleプッシュダウンとIcebergスキャン最適化
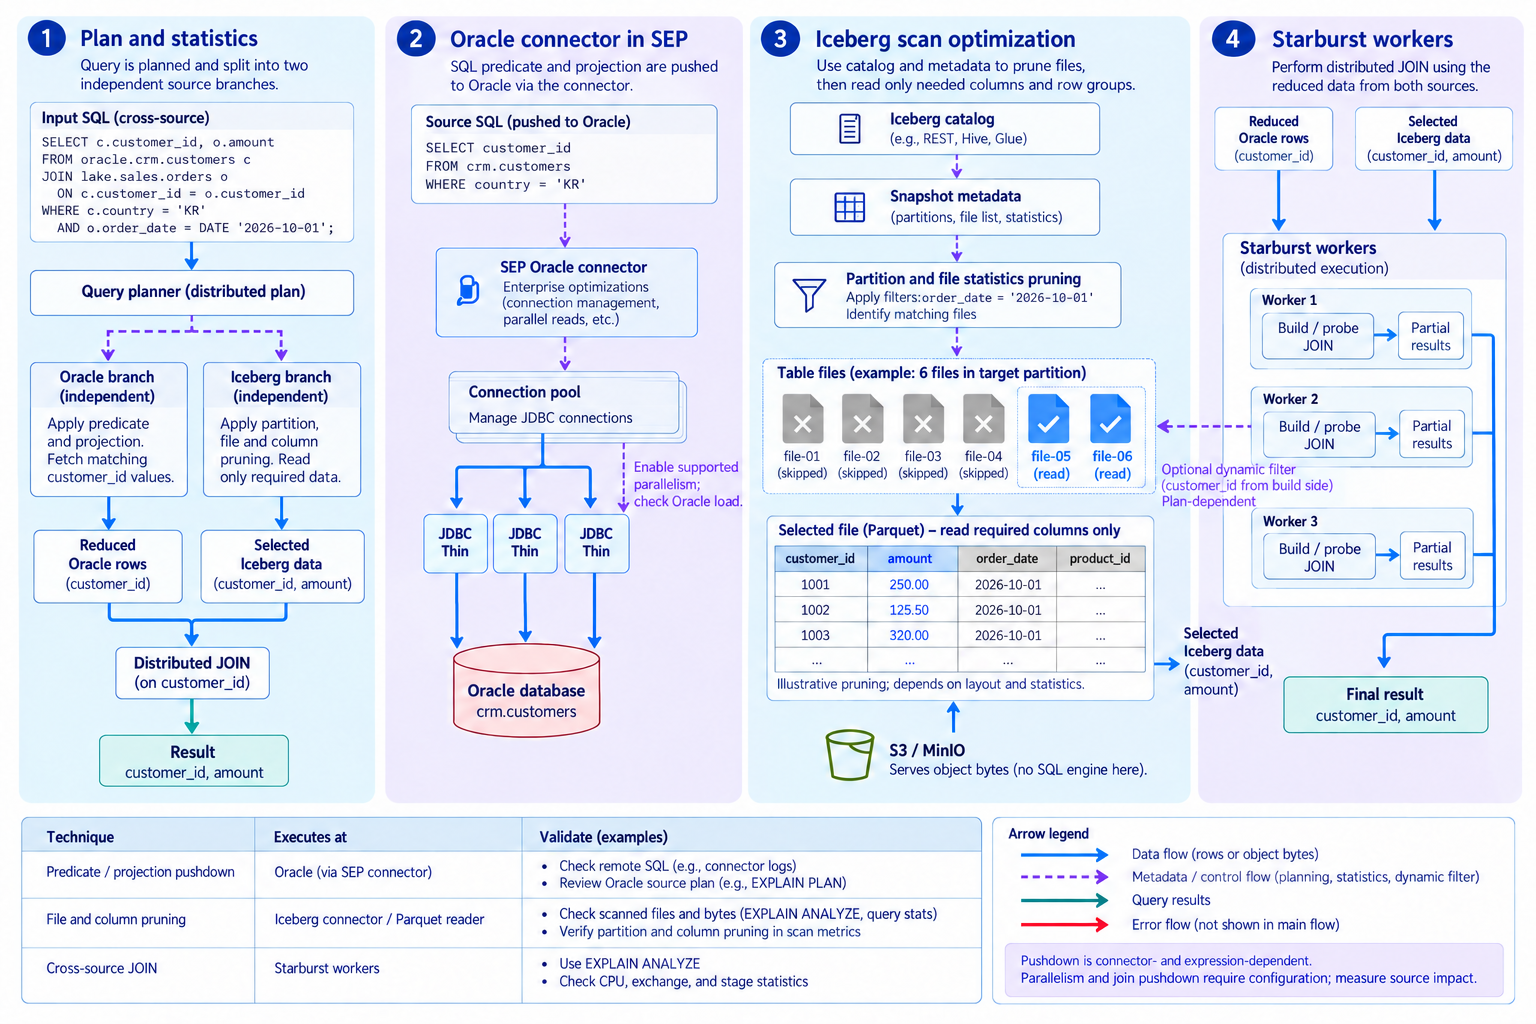
Oracleの行・列の削減とIcebergのファイル・列の読み取り削減を区別します。
図・製品・サービスの詳細を見る
- 1.計画と統計
- 条件と統計からOracleとIcebergの独立した読み取り計画を作成します。
- 2.Oracle最適化
- 対応するフィルター・列選択をOracleへ渡し、接続プールと設定済みの並列読み取りを利用します。
- 3.Icebergプルーニング
- パーティション・ファイル統計とParquetリーダーで対象範囲を削減します。S3はオブジェクトのバイトを返します。
- 4.ワーカーで結合
- 削減した入力をStarburstで結合します。動的フィルターは計画に依存し、EXPLAIN ANALYZEとスキャン量で検証します。
OracleコネクターはOracle JDBC Thinドライバーを使用します。SEPの拡張機能とドライバーを区別し、並列読み取り、対応演算、ソース負荷を実行計画と計測で確認します。
公式ドキュメントStarburst AI — 企業データを AI エージェントへ
データフェデレーションに MCP、自然言語分析、SQL AI 関数と RAG を組み合わせます。データ参照とモデルへ渡すコンテキストの経路を確認できます。
参照文書: Starburst Enterprise 483-e STS · 2026-10-18。構成は活用例です。導入バージョン、ライセンス、モデルごとの対応範囲を確認してください。
企業データから AI 回答へ、3 つの接続経路
AIDA、外部エージェント、SQL アプリケーションが Starburst のデータアクセス基盤を利用します。
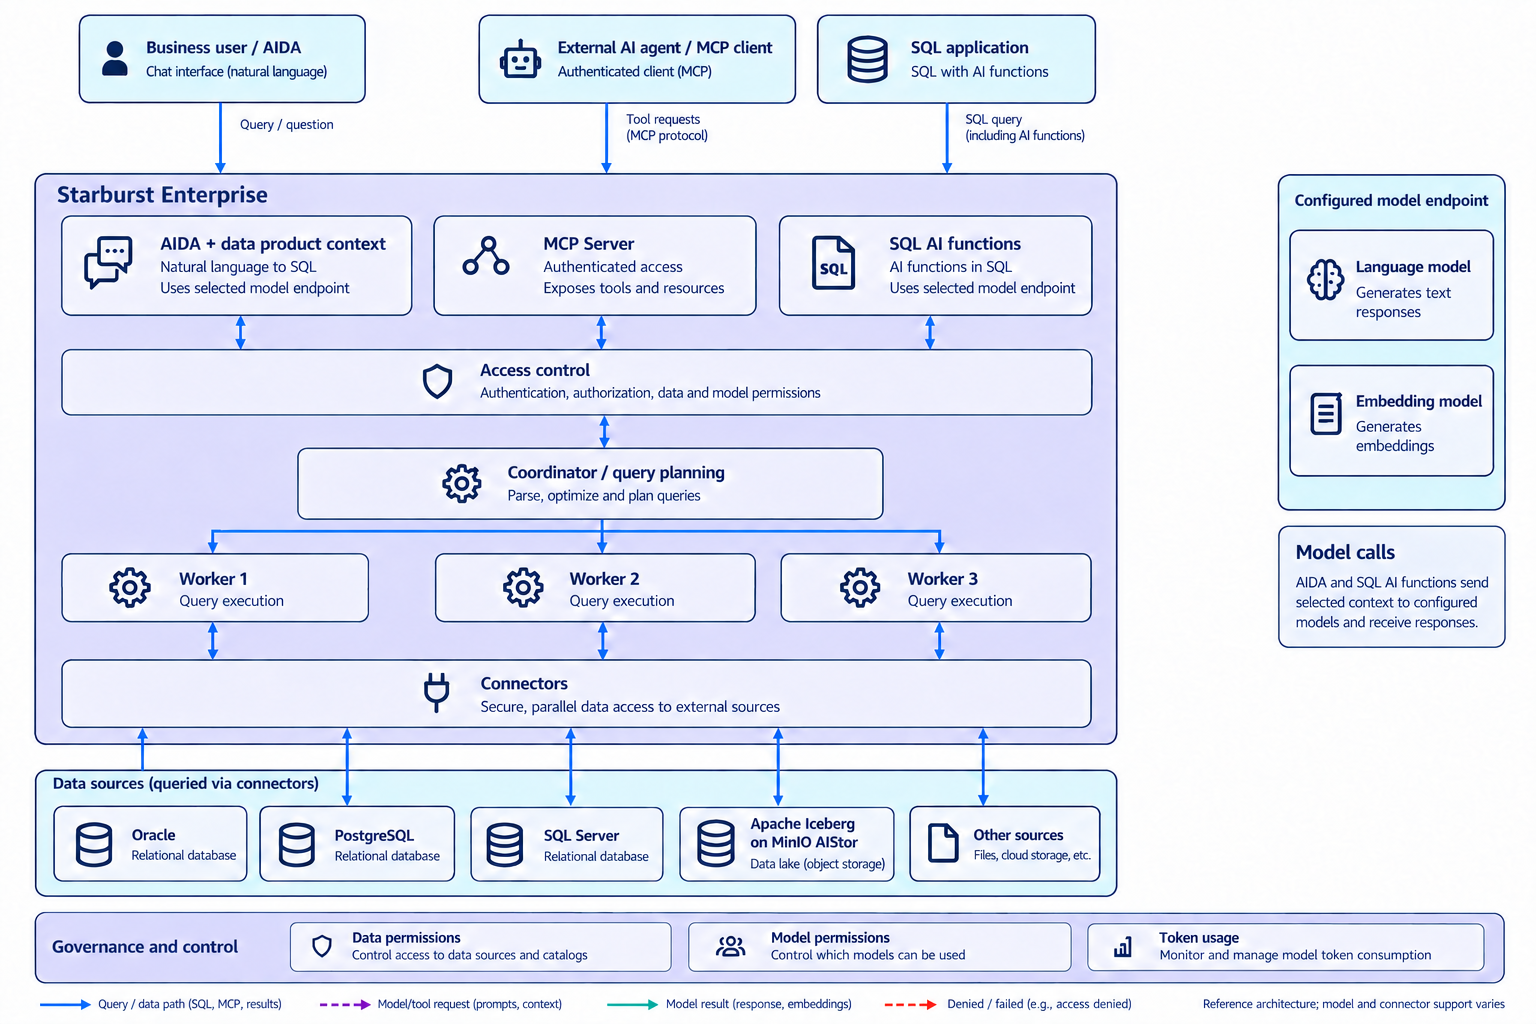
- 1.利用方法を選択
- 業務ユーザーは AIDA、外部エージェントは MCP、開発者は SQL AI 関数を使います。外部 MCP クライアントのモデル設定は SEP と別です。
- 2.分散データを照会
- Oracle、PostgreSQL、SQL Server と MinIO AIStor 上の Iceberg などを照会します。全件事前ロードを減らせますがクエリ中の転送は発生します。
- 3.モデルへ接続
- AIDA と AI 関数が設定済みモデルを呼び出します。質問、メタデータ、選択した結果の送信範囲とモデル権限を確認します。
Starburst がすべてのモデルを学習・内蔵する構成ではありません。AWS Bedrock や OpenAI 互換 API などの接続方式とモデル別機能を確認します。
公式ドキュメントMCP Server で AI にデータ参照ツールを提供
認証済みの外部エージェントがデータを探索し、読み取り専用 SQL の結果を取得します。
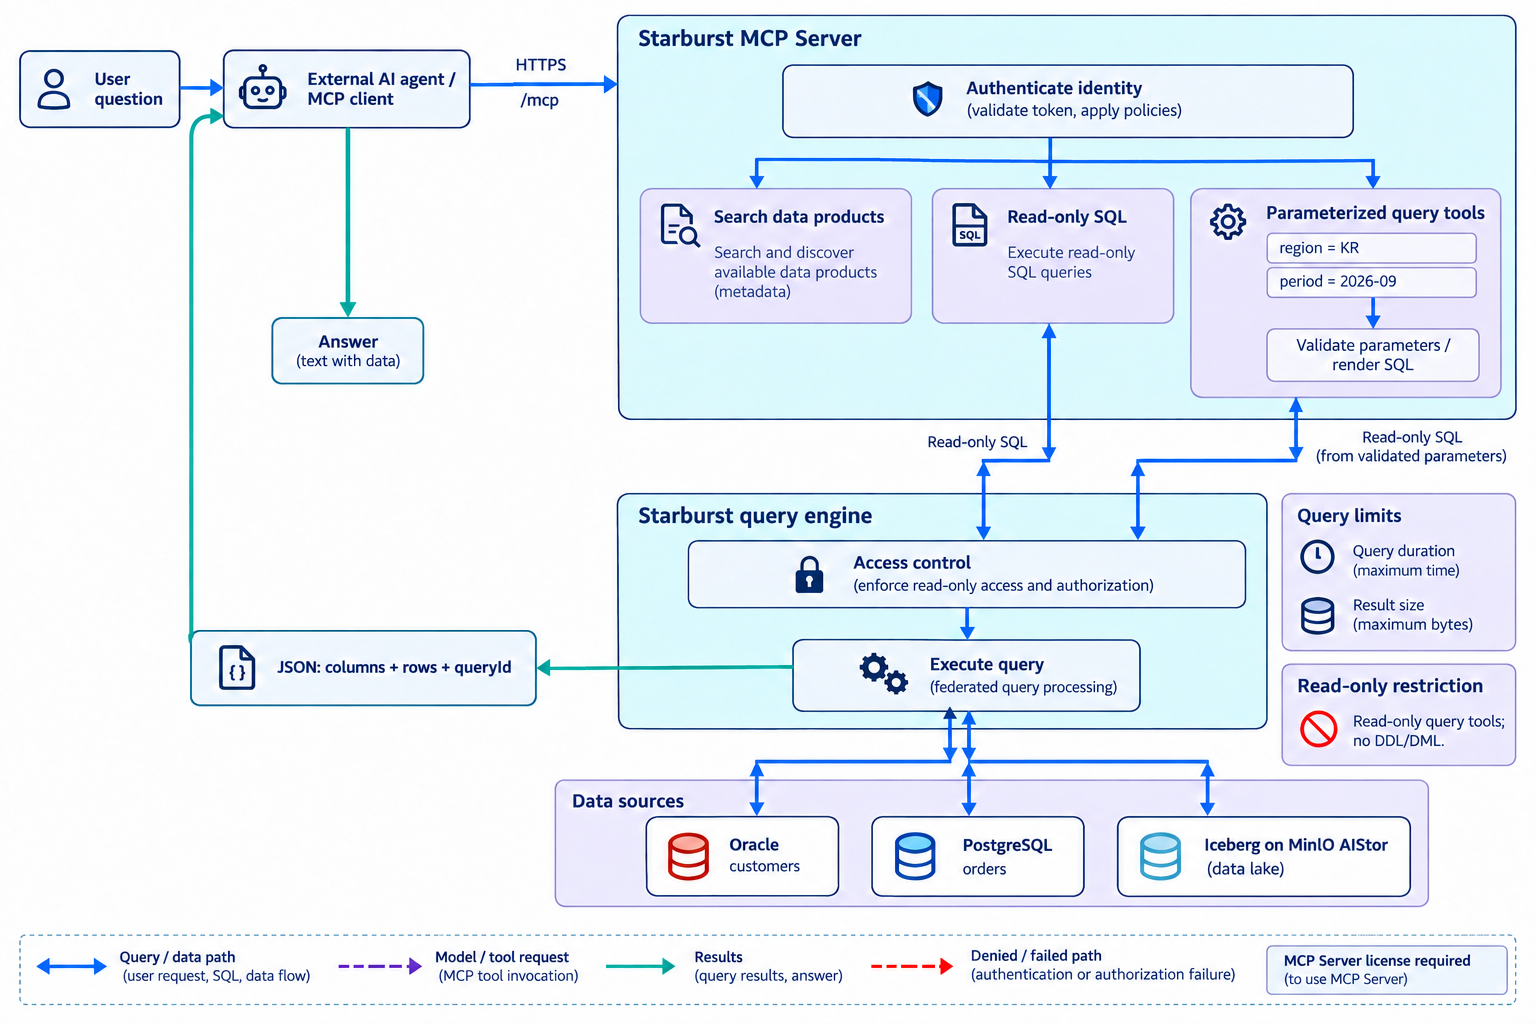
- 1.認証と探索
- 認証情報を使い、コーディネーターの HTTPS /mcp に接続します。必要に応じて searchDataProducts で分析対象を探します。
- 2.SQL またはパラメーター
- 読み取り専用 SQL、または定義済みツールへ地域・期間を渡します。入力値と最終 SQL の読み取り専用性を検証します。
- 3.実行と返却
- 接続ユーザーの権限で分散 SQL を実行し、columns、rows、queryId を含む JSON を返します。外部エージェントが回答に利用します。
MCP Server ライセンスが必要です。queryReadOnly は同期実行で、実行時間と結果サイズを制限します。汎用のデータ更新ツールではありません。
公式ドキュメントAIDA に質問し、SQL・表・グラフを確認
データプロダクトの説明と業務ルールを自然言語分析のコンテキストにします。
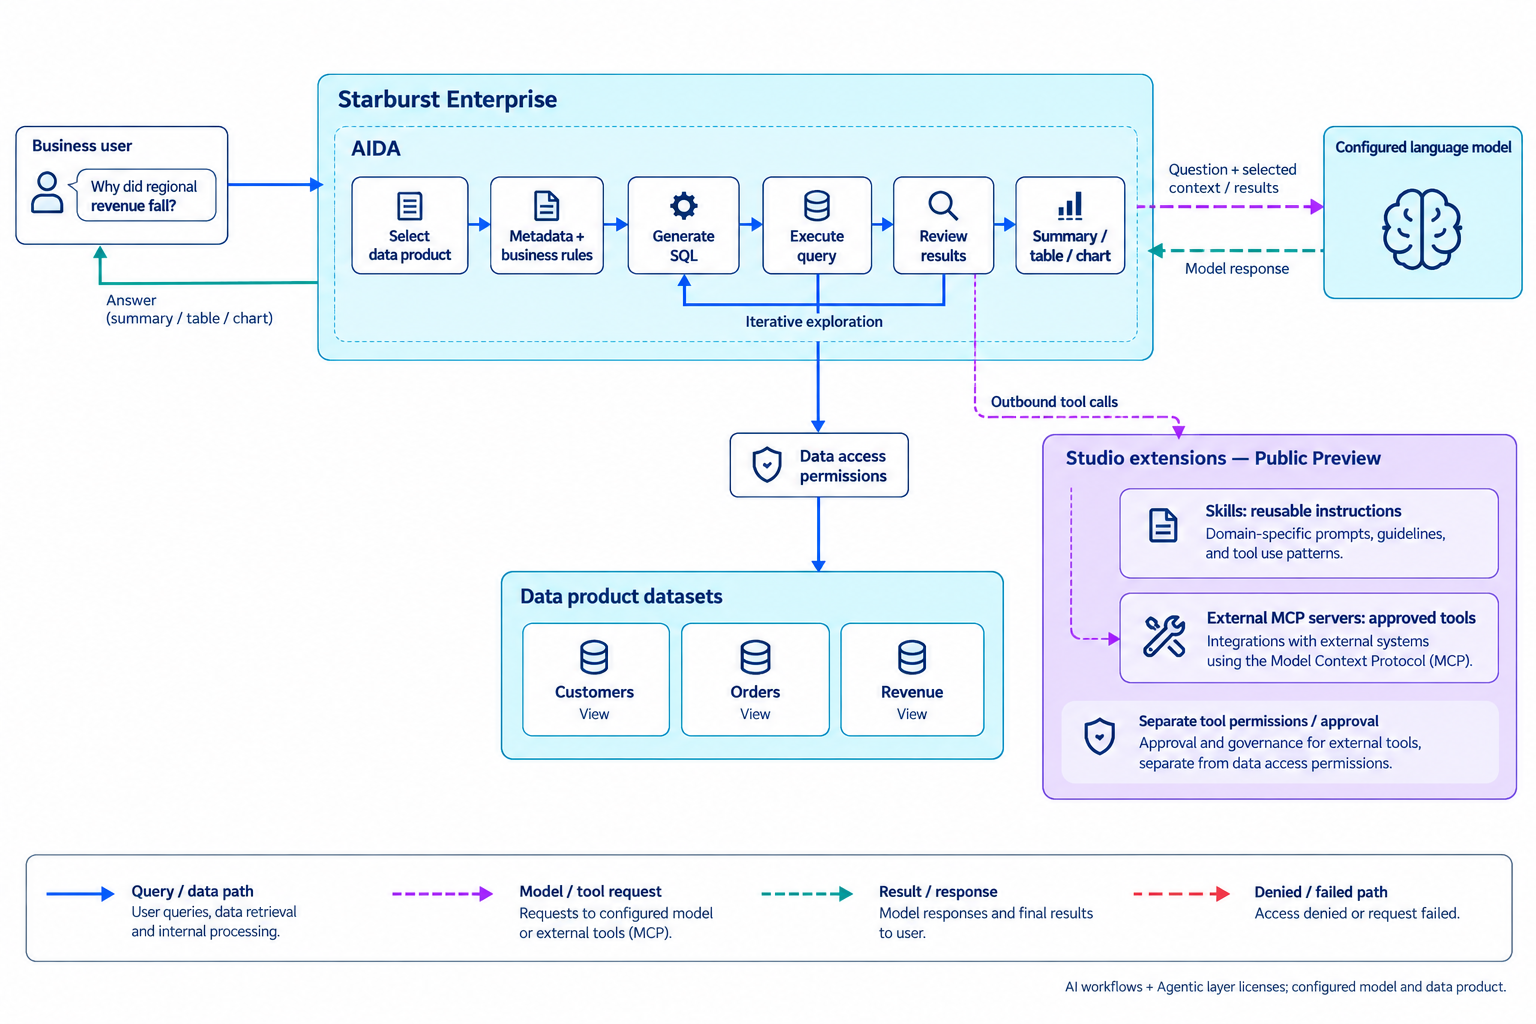
- 1.コンテキストを選択
- モデルとデータプロダクトを選び、指標の定義、期間、業務ルールを確認します。選択したデータが既定の分析範囲です。
- 2.質問・実行・確認
- AIDA が SQL を生成・実行し、必要に応じて探索を繰り返します。SQL、要約、表、グラフを確認して質問を具体化します。
- 3.外部ツールを拡張
- Skills と外部 MCP ツールを選択できます。AIDA → 外部サーバーと、外部エージェント → Starburst MCP を区別し、権限・承認を別途設定します。
AIDA には AI workflows と Agentic layer ライセンス、モデル、データプロダクトが必要です。Skills と外部 MCP 接続はパブリックプレビューです。
公式ドキュメントSQL AI 関数でテキスト処理と RAG を構成
埋め込み生成、類似度検索、LLM 呼び出しをデータ処理へ組み込みます。
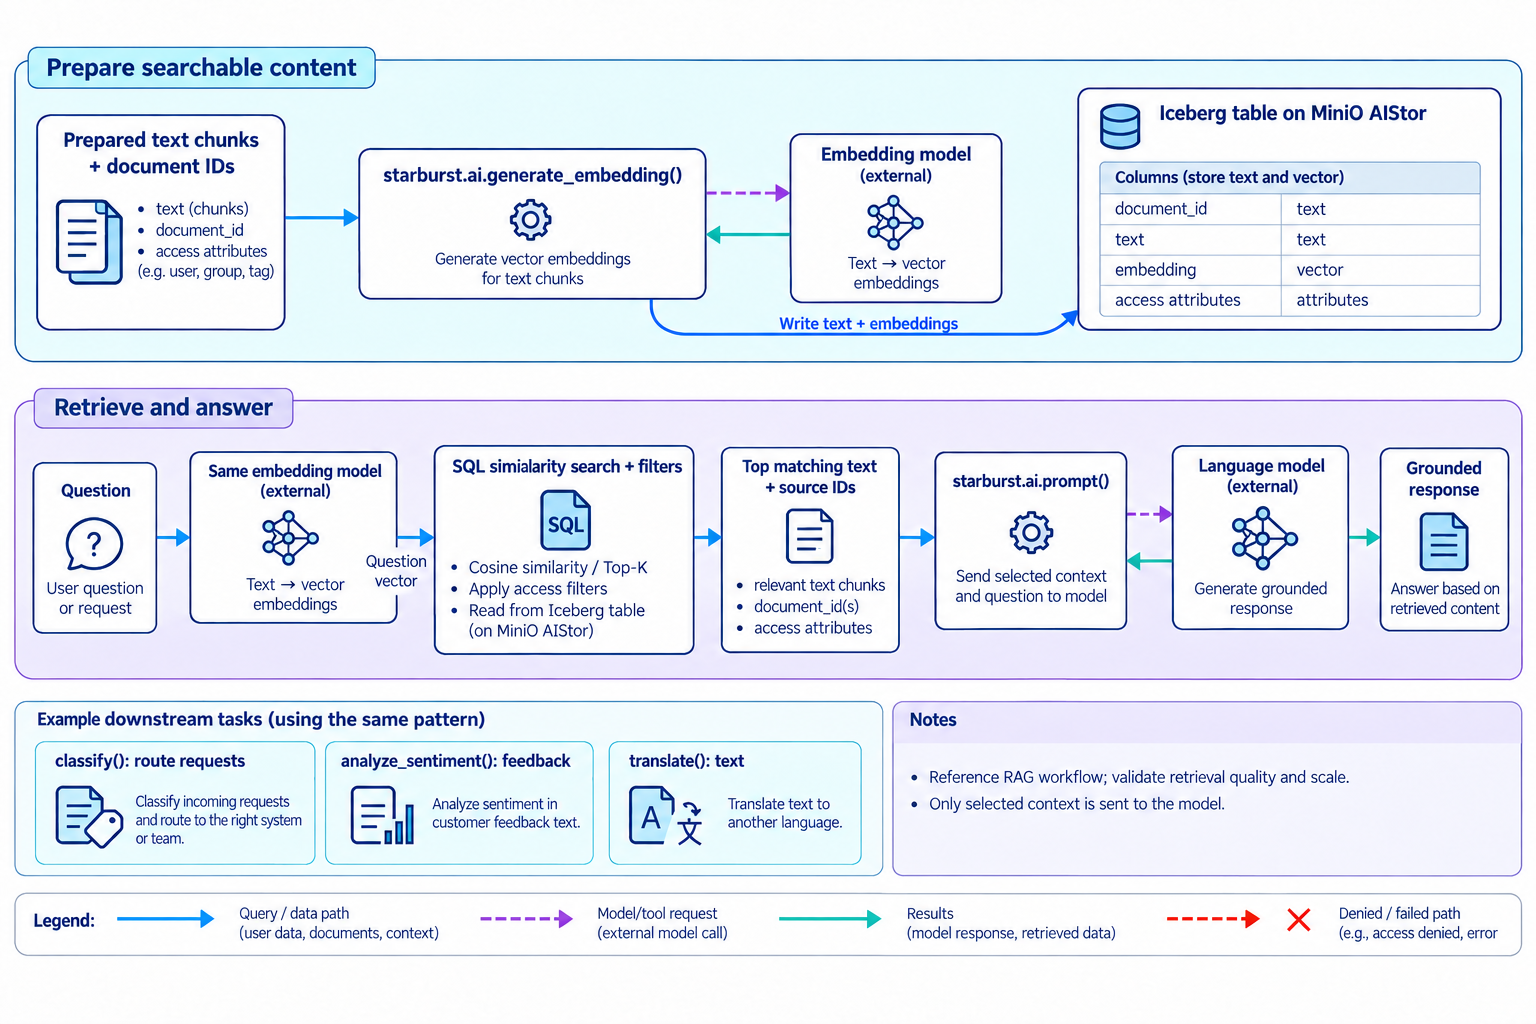
- 1.テキストとベクトル
- starburst.ai.generate_embedding() で埋め込みを生成し、文書 ID、テキスト、アクセス属性とともに Iceberg などへ保存します。
- 2.検索して回答
- 同じモデルで質問を埋め込み、類似度とフィルターで検索します。選んだテキストと ID を starburst.ai.prompt() へ渡します。
- 3.業務 SQL に適用
- starburst.ai.classify()、analyze_sentiment()、translate() などで分類、感情分析、翻訳を行います。AI workflows、モデル、組み込みアクセス制御が必要です。
参照 RAG 構成です。PDF 解析とチャンク分割は別工程です。検索品質、遅延、スキャン量、モデル費用を検証し、専用ベクトル DB や ANN が常に不要とはしません。
公式ドキュメントAI 分析に向けてデータプロダクトの説明を拡充
AI が意味を提案し、担当者が確認して保存します。
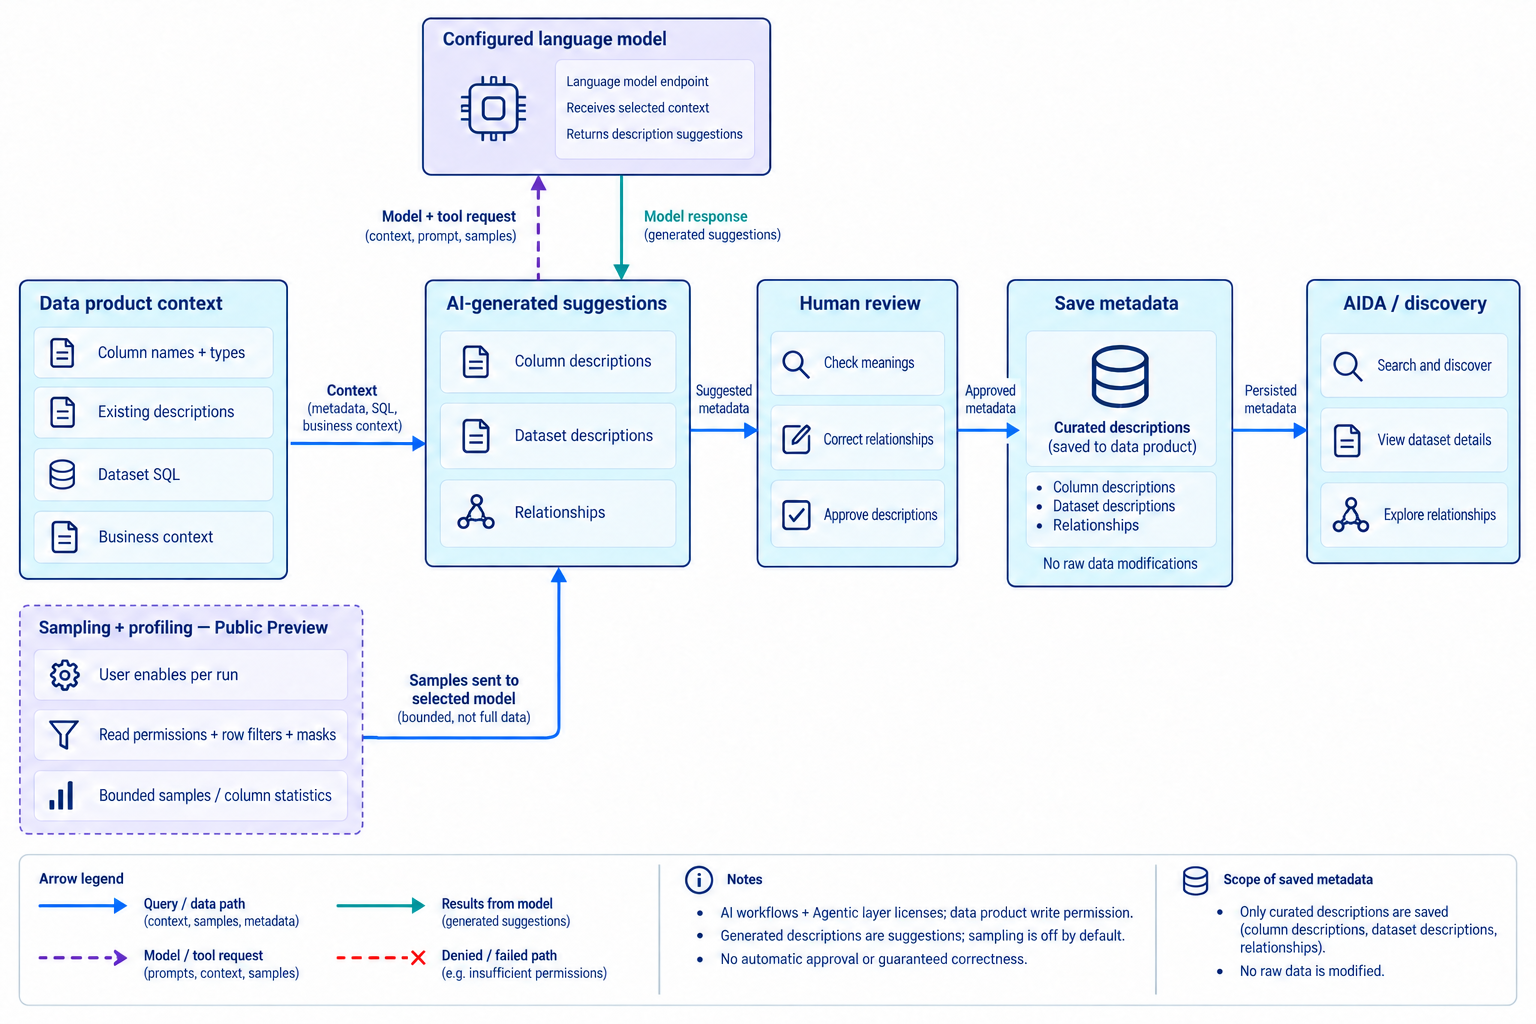
- 1.既存情報を使用
- カラム名・型、既存説明、データセット SQL、業務文脈からカラムとデータプロダクトの説明を生成します。
- 2.任意のサンプリング
- 実行ごとに許可すると、ユーザーの読み取り権限、行フィルター、カラムマスク内で限定サンプル・統計を収集し、モデルへ送信します。
- 3.人が確認して保存
- 推定した意味と関係を修正して保存します。元データ値ではなく説明を更新し、AIDA とデータ探索に活用します。
AI workflows・Agentic layer ライセンスと書き込み権限が必要です。サンプリング・プロファイリングはパブリックプレビューで既定では無効です。
公式ドキュメントデータ権限・モデル権限・AI の動作を個別管理
参照できるデータ、呼べるモデル、回答方針を区別します。
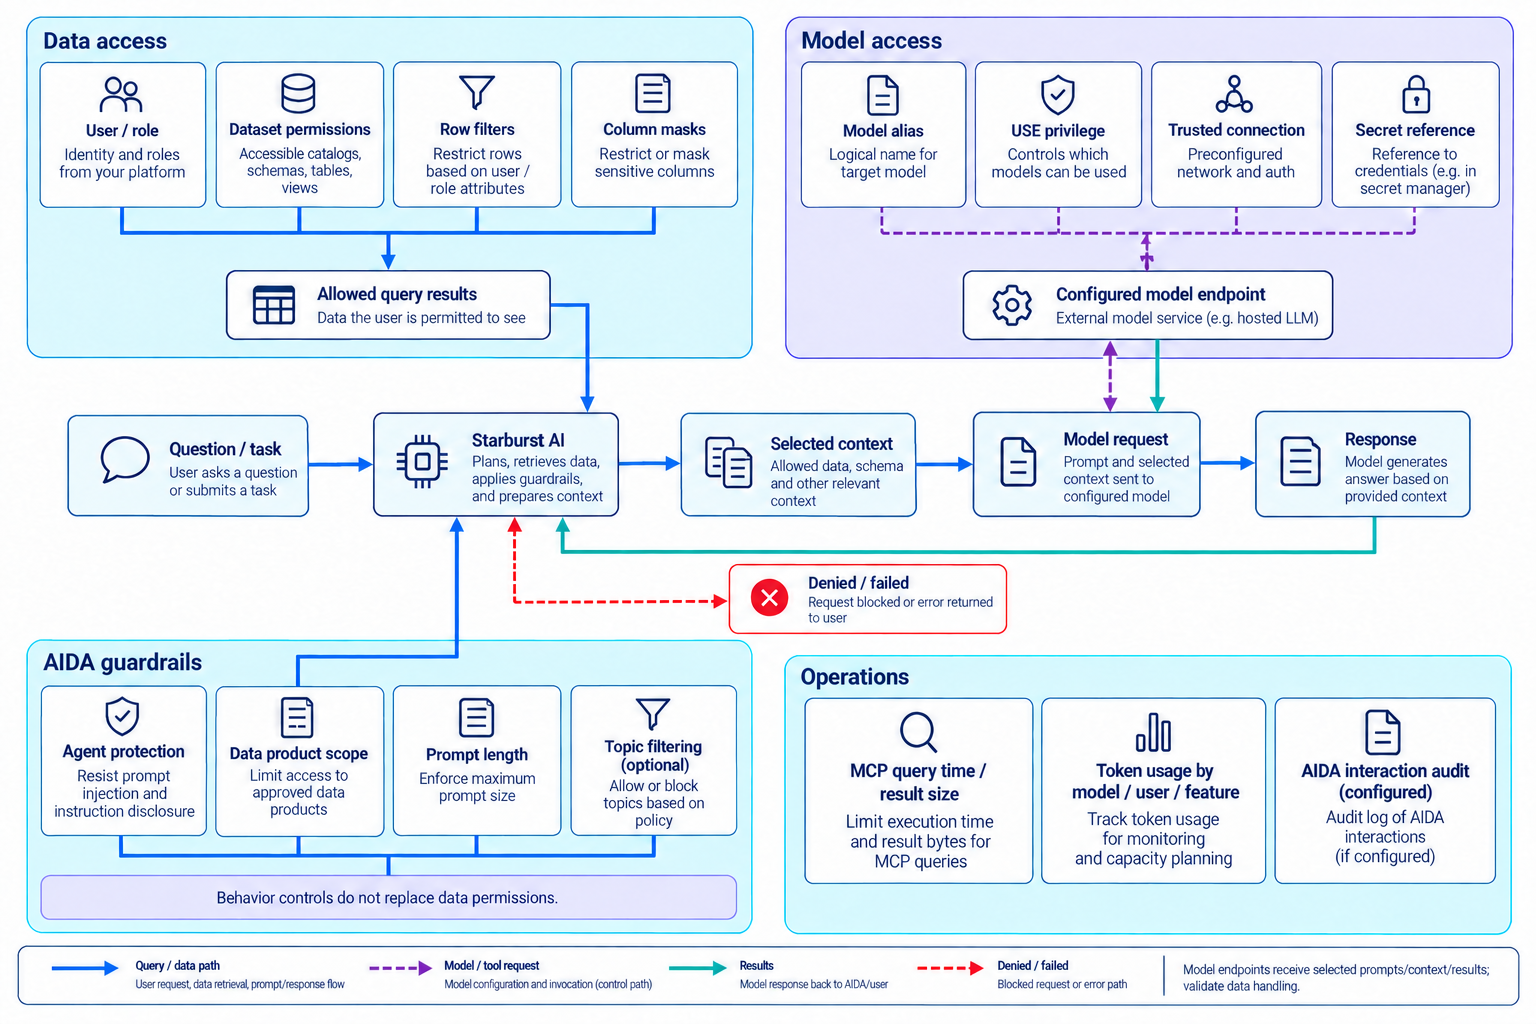
- 1.データとモデルの権限
- データ権限、行フィルター、カラムマスクとモデル USE 権限を分けます。Trusted connection の接続先と認証情報をシークレット参照で管理します。
- 2.AIDA ガードレール
- エージェント保護、データ範囲、入力長、任意のトピックフィルターを設定します。モデル指示に依存する制御を DB のセキュリティと併用します。
- 3.使用量と実行を確認
- モデル・機能・ユーザー別トークン量を確認し、MCP 実行時間と結果サイズを制限します。必要な AIDA 対話監査ログを設定します。
モデルへ送る質問・コンテキスト・結果を確認します。全ガードレール拒否を統合監査できるとは限りません。外部 MCP 権限も別途管理します。
公式ドキュメント導入条件と機能の提供範囲
ライセンス、接続設定、パブリックプレビューを区別して導入範囲を決めます。
| 機能 | ライセンス・構成 | 確認する範囲 |
|---|---|---|
| MCP Server | MCP Server ライセンス、有効化、認証設定 | 読み取り専用クエリ、パラメーター化ツール、実行時間・結果サイズ制限。エージェントツールには AI 構成も必要です。 |
| SQL AI 関数・モデル | AI workflows ライセンス、設定済みモデル、組み込みアクセス制御 | 言語・埋め込みモデルの機能、API 互換性、呼び出し費用と出力品質。 |
| AIDA | AI workflows + Agentic layer ライセンス、言語モデル、データプロダクト | 選択したデータプロダクトと業務ルールで分析します。生成 SQL と回答を検証します。 |
| データ説明の拡充 | AI workflows + Agentic layer ライセンス、モデル、データプロダクトの書き込み権限 | サンプリングにはデータ読み取り権限も必要です。サンプリング・プロファイリングはパブリックプレビューで、実行ごとに有効化します。 |
| AIDA 拡張 | AIDA 構成と機能別の管理者・利用者権限 | Skills と外部 MCP 接続はパブリックプレビューです。外部ツールの権限と呼び出し承認を別途設定します。 |
| 運用管理 | 管理者権限と機能別の設定 | ガードレール、トークン使用量、設定済みの対話監査ログ。使用量表示と予算の強制制限は異なります。 |
Data Dynamics は対象 SEP バージョンと契約範囲を確認し、モデル接続、データプロダクト整備、MCP ツール設計、権限設定、代表質問の評価と運用教育を支援します。図は参照構成であり、製品画面や性能保証ではありません。
公式文書: AI トークン使用量Data Dynamics が提供するサービス
製品と用途の選定から、要件分析、検証、運用引き継ぎまでをつなぎます。
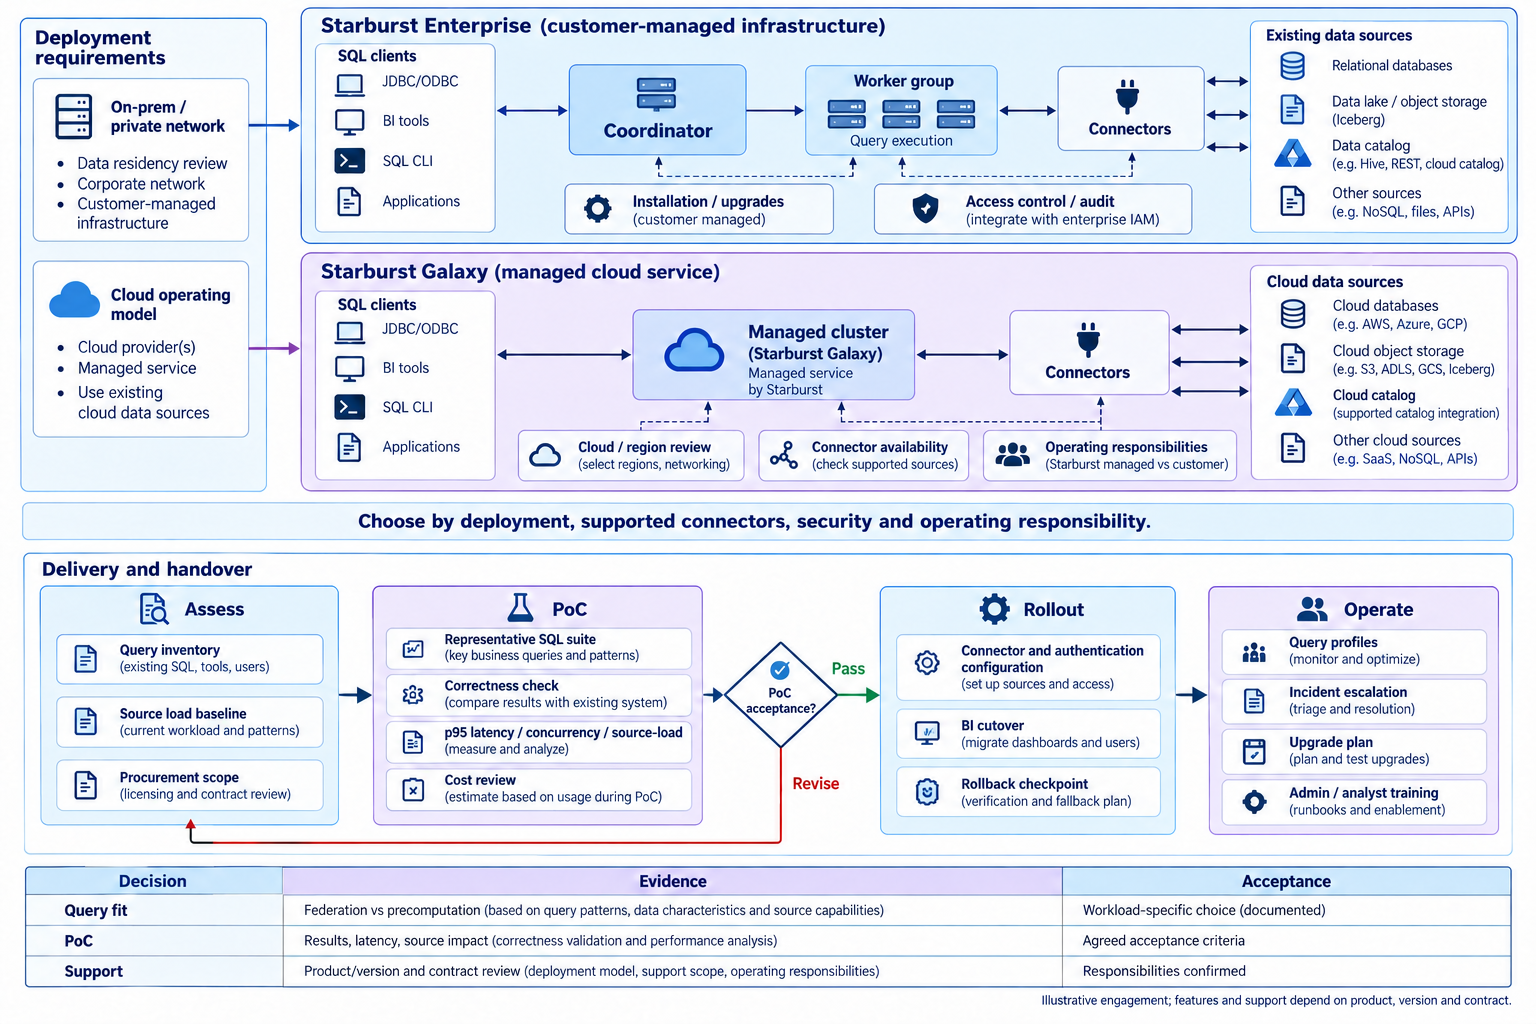
図・製品・サービスの詳細を見る
- 1.要件分析
- 既存システム、データ、ワークロード、運用制約を調査し、導入範囲を定めます。
- 2.製品と構成の選定
- 用途に合わせて製品、配置方式、容量、アクセス権、調達範囲を検討します。
- 3.検証と移行
- 代表的なワークロードで整合性、性能、連携を確認し、受け入れ基準と復旧手順を検討します。
- 4.運用と教育
- 監視、運用手順書、アップグレード計画、担当者教育を通じて引き継ぎを準備します。
Starburst 製品ファミリー
- Starburst Enterprise
顧客インフラ(On-prem・Private VPC)に直接デプロイする自己管理型の商用 Trino ディストリビューション。データの統制権を保持しつつエンタープライズのセキュリティ・運用機能を活用でき、データ重力・ネットワーク分離・規制上の保存要件に適しています。
Self-managed · K8s · OpenShift · Ansible · LTS / STS · データ主権 · 閉域網
- Starburst Galaxy
AWS・Azure・GCP で動作するフルマネージド SaaS。クラスタ自動スケーリングとペイパークエリ、クロスクラウドフェデレーションにより、運用負担なしで即座に分析を開始できます。
Fully Managed · Auto-scaling · Multi-cloud · Pay-per-query
オンプレミス・プライベート環境中心のエンタープライズ(特に規制産業)には SEP が、クラウドファーストの組織には Galaxy が一般的な出発点です。
導入前に確認するポイント
機能一覧だけでなく、実際のデータ要件と運用条件から導入範囲を決めます。
- クエリ方式
フェデレーションで照会するデータと事前加工・取り込みが必要なデータを分けます。
- PoC検証
応答時間、同時実行数、結果の正確性、元DBの負荷、実行コストを測定します。
- 配置と支援範囲
Enterprise・Galaxyのコネクター、機能、運用責任、契約別のサポート条件を確認します。
Data Dynamics が提供するサービス
- ライセンス販売
Starburst Enterprise・Galaxy ライセンスの見積もりと発注を支援します。
- 容量・ノードベースの算定
- PoC ライセンス支援
- 更新・拡張コンサルティング
- 技術サポート
構築から運用まで Starburst 全般の技術サポートを提供します。
- インストール・アップグレード支援
- クエリ性能チューニング
- 障害対応・エスカレーション
- 教育 · PoC
Trino・Starburst の技術教育とカスタム PoC を実施します。
- 管理者コース
- データアナリスト教育
- カスタム PoC 設計・実施
Trino・Iceberg・オブジェクトストレージベースのレイクハウス構築と Hive/Impala マイグレーションの実務経験を保有し、関連技術資料をブログで継続的に公開しています。
導入手順の例です。製品・バージョンごとの対応範囲、受け入れ基準、提供サービスは環境と契約に応じて確定します。
Starburst の機能比較・性能・導入事例を見る
Trino と Starburst Enterprise の関係
Starburst EnterpriseはTrinoを基盤に企業向け機能とサポートを提供する商用ディストリビューションです。
Trino
オープンソースの分散 MPP SQL エンジン(旧 PrestoSQL)。常時稼働のコーディネーター+ワーカー構成でペタバイト級データに対話型応答を提供し、約 2 週間ごとに新バージョンをリリースします。
Starburst
Trino の創始者たちが設立した会社で、2024 年の Trino コードコミットの約 84% を貢献した最大の Trino 専門家組織です。
Trinoベースのエンジン
アップストリームTrinoに製品固有の機能、パッチ、最適化を追加しています。選択するバージョンと設定で動作と性能を検証します。
拡張される表面積
その上にセキュリティ(BIAC・Ranger)、専用コネクタ、Warp Speed 加速、管理 UI・Insights、サポートされるデプロイ経路、24×7 サポート契約が積み重なります。
SEP = Trino エンジン + エンタープライズレイヤー
Trinoを基盤とする共通点が、すべてのバージョンと構成で同じ機能や性能を保証するわけではありません。
Why Starburst — 4 つのコアバリュー
データフェデレーション
データを移動・複製せずに複数ソースを単一 SQL で JOIN。ETL で事前に集約する構造自体が不要になります。
Iceberg ネイティブ
隠しパーティショニング・パーティション進化・タイムトラベル・ACID を完全サポートし、コンパクションやスナップショット失効などのテーブルメンテナンスを自動化します。
性能加速・安定性
Warp Speed のスマートインデックス・キャッシングでクエリ最大 5 倍・CPU 10 倍改善。耐障害実行(FTE)は最大 60TB のバッチまでハードニング済みです。
きめ細かなセキュリティ
行/列単位の RBAC・ABAC、動的カラムマスキング、Apache Ranger 統合、クエリ監査まで — 規制産業の要件をプラットフォームで満たします。
コネクタ — エンタープライズデータのロングテールまで
一般的なエンタープライズのデータは Oracle・Teradata・SAP・Salesforce のような場所にあります。SEP 専用コネクタがライセンス価値の大きな部分を占める理由です。
SEP 専用コネクタ (アップストリーム Trino になし)
Snowflake · Teradata · IBM Db2 · SAP HANA · Salesforce · Azure Synapse · Greenplum · Netezza · Cosmos DB · DynamoDB · Splunk · Neo4j · Generic JDBC · Stargate(クラスタ間フェデレーション)
アップストリームコネクタの改良版
プッシュダウン強化・Warp Speed 統合・追加認証 — Hive · Iceberg · Delta Lake · Oracle · BigQuery · SQL Server · PostgreSQL · MySQL · MongoDB · Kafka · Elasticsearch · Redshift · ClickHouse など
アップストリーム Trino と同一
DuckDB · Druid · Pinot · Prometheus · Redis · OpenSearch · Google Sheets などコミュニティコネクタ全体
判断基準: "S3 + PostgreSQL 上の Trino" だけで要件が満たせるなら OSS で十分です。アーキテクチャに Snowflake・Oracle・Teradata・SAP・Salesforce が登場した瞬間、天秤は SEP に傾きます。
Apache Iceberg レイクハウス — パーティションの壁を越え、運用まで自動化
Iceberg はオブジェクトストレージ上のファイルの山をデータベーステーブルのように扱える開放型テーブルフォーマットです。隠しパーティショニング・パーティション進化は Trino + Iceberg の共通メリットで、SEP はその先に残る運用課題(スモールファイル・スナップショット・統計)を自動化します。
Trino + Iceberg の共通メリット
- 隠しパーティショニング — パーティションをディレクトリではなくカラム transform(day・bucket・truncate)で定義 — 元カラムのフィルタだけで自動プルーニングされ、うっかりフルスキャンがなくなります。
- パーティション進化 — データ書き換えなしでパーティション戦略を変更 — 新旧スペックが混在しても 1 つのクエリが透過的に処理します。
- ACID · タイムトラベル — スナップショットベースのトランザクション、時点照会(FOR VERSION/TIMESTAMP AS OF)、スキーマ進化、誤書き込みはスナップショットロールバックで復旧。
- マニフェストプルーニング — ファイル単位の min/max 統計でプルーニング — RDBMS メタデータのボトルネックなしに数百万ファイルへ拡張します。
SEP が加えるもの — テーブル自動メンテナンス
- 自動コンパクション — optimize(スモールファイル統合)をスケジュールベースで自動実行します。
- スナップショット · 孤児ファイル整理 — expire_snapshots · remove_orphan_files の自動化でメタデータ肥大化を防ぎます。
- 統計の自動収集 — CBO が使用するテーブル統計を最新に保ちます。
- ストリーミングインジェスト · ファイルローダー — Kafka などから Iceberg テーブルへの連続ロードをマネージドで提供 — 別途 Spark/Flink パイプラインは不要です。
OSS Trino でも同じコマンドを手動/スケジュールで実行できますが、運用責任はプラットフォームチームの負担になります。SEP はこれをマネージド・自動化で提供し、MinIO など S3 互換オブジェクトストレージと組み合わせればオンプレミスのレイクハウスが完成します。
性能 — Warp Speed とベンチマーク
キャッシュ、インデックス、データ配置の効果をワークロード別に評価します。以下は特定のベンチマーク条件での結果です。
クエリ実行時間の短縮 — Warp Speed (TPC-DS SF1000)
CPU 時間の削減 — Warp Speed
Hive 比クエリ性能 (TPC-DS · Iceberg)
クラウド DW 比コスト効率
Warp Speed 効果 — 標準実行との比較
標準実行 = 100 基準、低いほど良い (TPC-DS SF1000 · Iceberg)
基準実行を100に正規化したベンチマーク例です。製品、バージョン、構成、ワークロードにより結果は異なります。
Hive 比のクエリ実行時間
秒、低いほど良い — 1TB ソース(S3·Parquet)、Starburst 476-e vs Hive 3.1.3
出典: Concurrency Labs ベンチマークレポート (2025-09) · TPC-H 9 ノード / TPC-DS 17 ノード (各 32 vCPU·128GB)
Warp Speed スマートインデックス・キャッシング
ブロック単位で最適なインデックス(bitmap・dictionary・tree)を自動選択し、頻繁にアクセスするデータをワーカーの NVMe SSD にキャッシュ — 手動のインデックス設計なしで反復的・選択的ワークロードを加速します。
Hive 比最大 22 倍
TPC-DS・Iceberg 基準で 37,901 秒 → 1,737 秒(10.5 時間 → 29 分)。エンジン交換だけで 6~8 倍、Iceberg 移行まで行えば 12~22 倍 — ビッグバンなしで段階的に効果を高められます。
クラウド DW 比の価格性能
オープンテーブルフォーマット上の SQL 実行基準で最大 6.3 倍高速なクエリと最大 12.7 倍のコスト削減 — Runtime と Cost の両方が最下位圏なのは Starburst だけです。
耐障害実行 (FTE)
長時間のバッチ・ETL クエリが丸ごと失敗しないよう自動リカバリ — 最大 60TB 規模までエンタープライズ級に検証済みです。
性能数値は Starburst 公開ベンチマーク基準であり、ワークロードにより異なります — 導入前の PoC 検証を推奨します。
セキュリティとアクセス制御 — 規制産業の基本
認証は OSS Trino でも十分です。分かれるのはきめ細かな認可(Authorization)と監査 — 金融・医療・公共で SEP が決定的な理由です。
Built-in Access Control (BIAC)
SEP ネイティブの認可モデル — カタログ/スキーマ/テーブル/カラム/行単位のロールベース(RBAC)・属性ベース(ABAC)権限を UI で管理します。
カラムマスキング · 行フィルタリング
機密カラムの動的マスキングと行単位フィルタを標準提供 — 個人情報・取引情報の保護要件を満たします。
Apache Ranger 統合
グローバル/カタログ/カラム/行レベル — 既存の Hive/HDFS で使っていた Ranger ポリシーをそのまま共有します。
Credential Passthrough
Kerberos・パスワード資格情報の伝達(キャッシング含む) — ワーカーが長寿命サービスアカウントなしでユーザーの身元でソースにアクセスします。
認証統合
LDAP · OAuth2 · JWT · Kerberos に加え Okta 統合、ユーザーインパーソネーションを一般化します。
Query Audit
誰が、いつ、どのカタログに、どのクエリを実行したかを永続記録 — 監査証跡要件に即応します。
実務効果: ポリシーが一箇所(BIAC または Ranger)に集まり、SEP が公開するすべてのコネクタに均一に適用されます。
ガバナンス · 運用 — 規模を持って回して初めて見える価値
純粋なクエリエンジン(Trino)とデータプラットフォーム(SEP)の差が最も大きく現れる領域 — OSS ではすべて別ツールを組み合わせて自前構築が必要な項目です。
Data Products
オーナー・ドキュメント・SLO・アクセスポリシーが付与されたキュレーション済みデータセットを公開 — データメッシュアーキテクチャのセルフサービス・マーケットプレイスです。
Starburst Insights
クエリパターン・リソース使用量・スロークエリ分析ダッシュボードとデータリネージ・Apache Atlas 統合 — 「クラスタが昨日の午前 3 時に何をしていたか」に答えます。
HA · オートスケーリング
コーディネーターの高可用性、実行中のクエリを殺さない Graceful Scaledown、自動一時停止・アイドル終了・クラスタスケジューリングによるコスト自動化。
品質 · 自動分類
データ品質ルール、スキーマ変更通知、自動データ分類(機密情報検出)、ソース横断の統合検索を提供します。
Stargate
クラスタ間フェデレーション — データを複製せずリージョン・テナント・国境を越えてクエリをルーティングし、GDPR などのデータ主権要件を遵守します。
サポートされるデプロイ経路
Kubernetes Helm チャート · Red Hat OpenShift · Starburst Admin(Ansible) · AWS/Azure/GCP Marketplace、CloudWatch·Stackdriver 可観測性統合。
OSS で得られるのは JMX・ログ・基本 UI まで — その上のクエリ履歴ストア、クエリを尊重するオートスケーラー、メトリクスパイプラインは自前で作る必要があります。エンジニアリング時間をコストに換算すると「自前構築」が有利なケースは稀です。
OSS Trino vs Starburst Enterprise
エンジンの最新性・開放性・コストは OSS Trino、セキュリティ・ガバナンス・性能加速・運用・サポート SLA は SEP 優位 — 規制産業とエンタープライズ規模ほど SEP が有利です。
| カテゴリ | OSS Trino | Starburst Enterprise (SEP) | 判定 |
|---|---|---|---|
| コアクエリエンジン | 完全な Trino エンジン — 最新機能を最速反映 | Trinoベースの配布 + 製品固有の機能・パッチ・最適化 | 共通 |
| セキュリティ · 認可 | ファイル/OPA 手動構成、RBAC UI なし | BIAC(行/列 RBAC·ABAC) · マスキング · Ranger · 監査 UI | SEP 優位 |
| ガバナンス · カタログ | 外部ツール依存(OpenMetadata など) | Data Products · リネージ · 品質ルール · 探索ポータル | SEP 優位 |
| 性能加速 | CBO · dynamic filtering | + Warp Speed(自動インデックス・キャッシング) · ワークロード管理 | SEP 優位 |
| テーブルメンテナンス | optimize などを自前スケジューリング | コンパクション · スナップショット失効 · 統計収集の自動化 | SEP 優位 |
| コネクタ | 50+ コミュニティコネクタ(品質にばらつき) | 認定コネクタ + 専用(Snowflake·SAP·Salesforce など) | SEP 優位 |
| デプロイ · 運用 | Helm 自己管理 | HA/DR · オートスケール · OpenShift · Marketplace | SEP 優位 |
| サポート | コミュニティ Slack · GitHub | 24×7 · 30 分 SLA · 専任 TAM · LTS 12 ヶ月パッチ | SEP 優位 |
| コスト · ライセンス | Apache 2.0 無料 — ベンダーロックインなし | 商用サブスクリプション(ノード/コンピュート基準) | OSS 優位 |
"S3 + PostgreSQL 上の Trino" だけで要件が満たせるなら OSS で十分です — セキュリティ・ガバナンス・サポート SLA の要件が現れた瞬間、SEP をご検討ください。
バージョンポリシー — LTS / STS
Trino は約 2 週間ごとにリリースされます。SEP はその上に予測可能なリリースサイクルと LTS パッチライフサイクルを加え、エンタープライズが追従できる速度に変えます。バージョン先頭の整数は常に上位の Trino バージョン — パッチ接尾辞(-e.x)があれば LTS、なければ STS です。
| 項目 | LTS | STS |
|---|---|---|
| サポート期間 | リリースから 12 ヶ月 | 次の STS まで |
| パッチリリース | 提供 (-e.0 → -e.1 → …) | なし (次のリリースに反映) |
| リリースサイクル | 四半期に最大 1 つ (2·5·8·11 月) | Trino に追従 (頻繁) |
| セキュリティ (CVE) 修正 | パッチとしてバックポート | 次の STS のみ |
| 本番適合度 | 本番環境のデフォルト | 機能主導 · アップストリーム近接 |
推奨プレイブック
年に 1 回、LTS → 次の LTS への統制されたアップグレード — 残りサポート期間 9~12 ヶ月のラインをターゲットに、breaking changes をライン単位で処理します。
EOL はハードデッドライン
サポート終了後は CVE パッチが提供されません — どの時点でも約 4 つの LTS ラインが重なってサポートされ、アップグレードの滑走路が確保されます。
グローバル導入事例 — 金融業界を中心に
Hive/Hadoop・Teradata・DB2 などのレガシーから Trino ベースの Starburst へ移行・フェデレーションした実際の事例です。
HDFC Bank
インド最大の民間銀行 — レガシー DB2 から開放型アーキテクチャへ転換、Azure AKS とオンプレミス OpenShift を並行運用。
クラウド・オンプレ統合ガバナンス · DB2 コスト削減
Crédit Mutuel Arkéa
フランス — オンプレミスを維持したまま Hadoop 上にフェデレーションクエリエンジンを構築。
Hadoop クエリ 10~20 倍向上 · 1 年で 550+ ユーザー
Bank Hapoalim
イスラエル — 20 年運用した Teradata をデータレイクへ転換、Hive・Spark をベンチマーク後 Starburst を採用。
高同時実行の ad-hoc + BI クエリ性能で最優秀
Banco Inter
ブラジル — Amazon Athena から Starburst へ転換、探索・ガバナンス・セルフサービス分析を単一プラットフォーム化。
インサイト導出 days → seconds · 月 $100K 削減
グローバル投資銀行
HiveをStarburstに置き換え、100以上の国でインプレースクエリを行うAML分析の事例です。元データの中央集約を減らしますが、クエリ処理中のデータ転送は発生します。
データ主権の遵守 · 規制制裁金リスクの低減
グローバル銀行グループ (62 ヶ国)
Stargateを利用した国境を越える分析の事例です。元データの保存場所を維持し、地域別の処理と結果転送の範囲を設計します。
クエリ性能 20 倍向上 · データ主権の遵守