
Argus Flow
Apache NiFi 2.10.0 を実運用環境に載せるために必要なものを一か所にまとめたオープンソースのデータパイプライン配布版です。カスタム拡張バンドル(NAR)、配布パッケージ(tar.gz・RPM・コンテナイメージ)、Kubernetes オペレーター、設定・証明書・ユーザー管理ツールまで、散在していたリポジトリをモノレポに統合し、単一のビルドパイプラインからバージョンの揃った成果物を生成します。
NiFiのデータフローに必要な拡張を接続
CDCやファイル一覧取得、FlowFile処理、書き込み、運用確認を構成します。
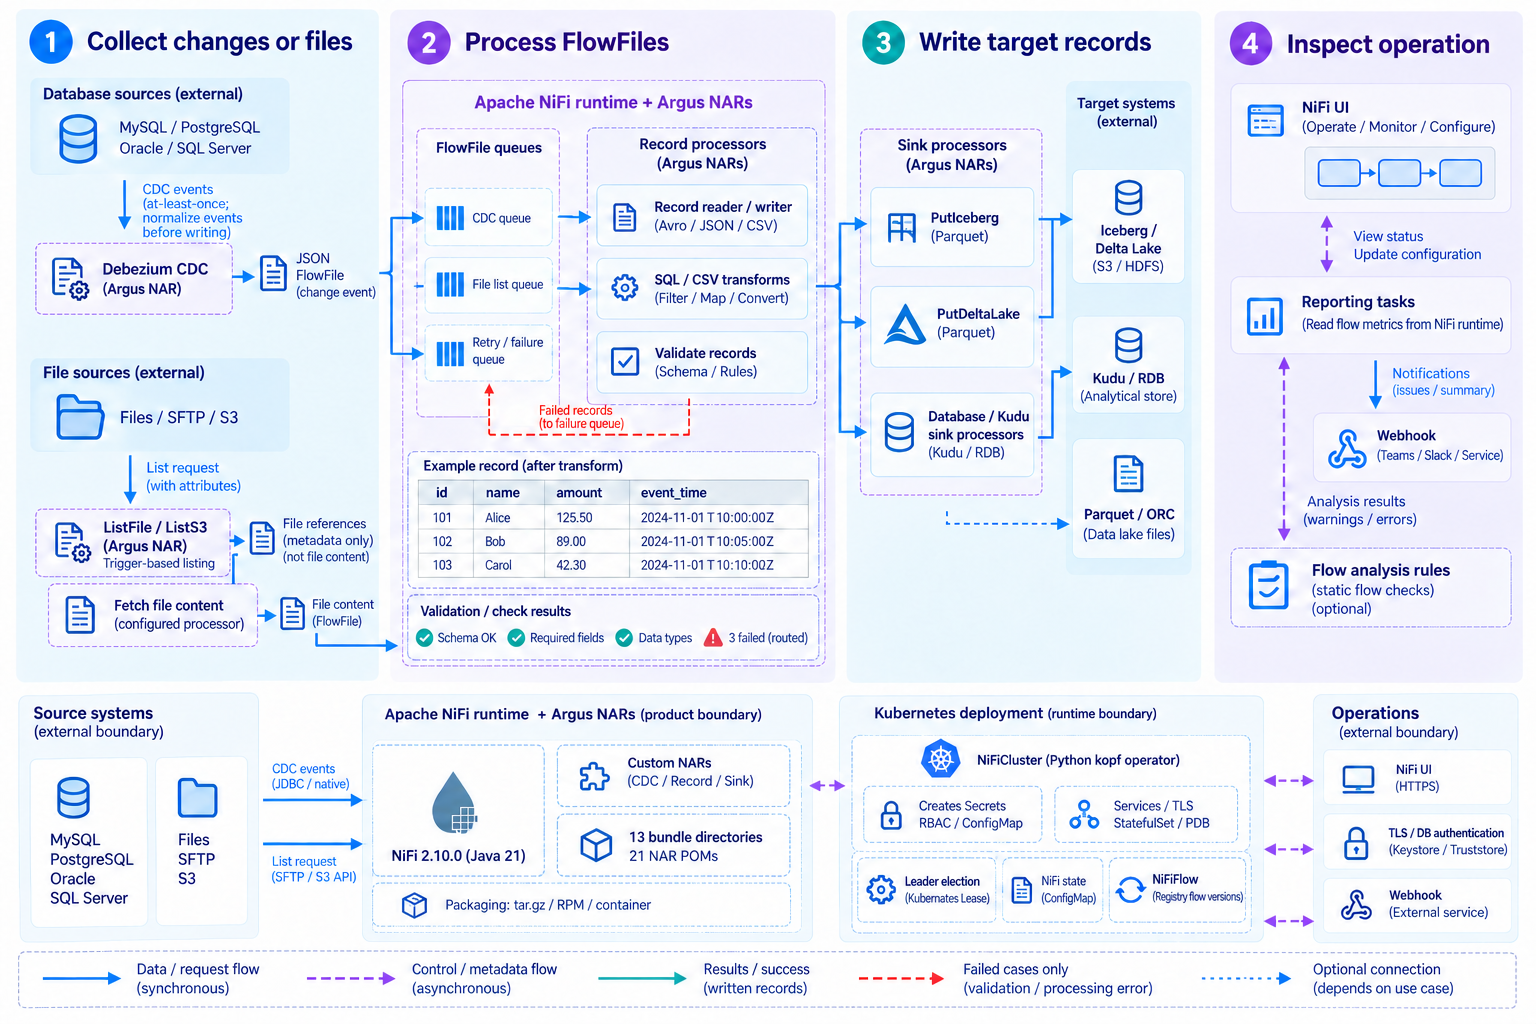
- 1.変更・一覧の収集
- Debezium CDCか、入力FlowFileの属性で動く一覧取得プロセッサを選びます。
- 2.FlowFile処理
- NiFiキューとレコードリーダー・ライターで変換・ルーティングを構成します。
- 3.対象への書き込み
- PutIceberg・PutDeltaLake・PutDatabaseRecordなどで整形済みレコードを保存します。
- 4.運用確認
- NiFi UI、レポーティングタスク、フロー分析ルールで状態や設定を確認します。
CDCはat-least-once配信です。変更イベントから対象レコードへの変換設定が必要で、ファイル一覧取得と内容取得は別の処理です。
GitHubの文書・コードを見る配布物の準備からKubernetes運用まで
拡張をパッケージ化し、接続・TLSを設定して、宣言したクラスタとフローを管理します。
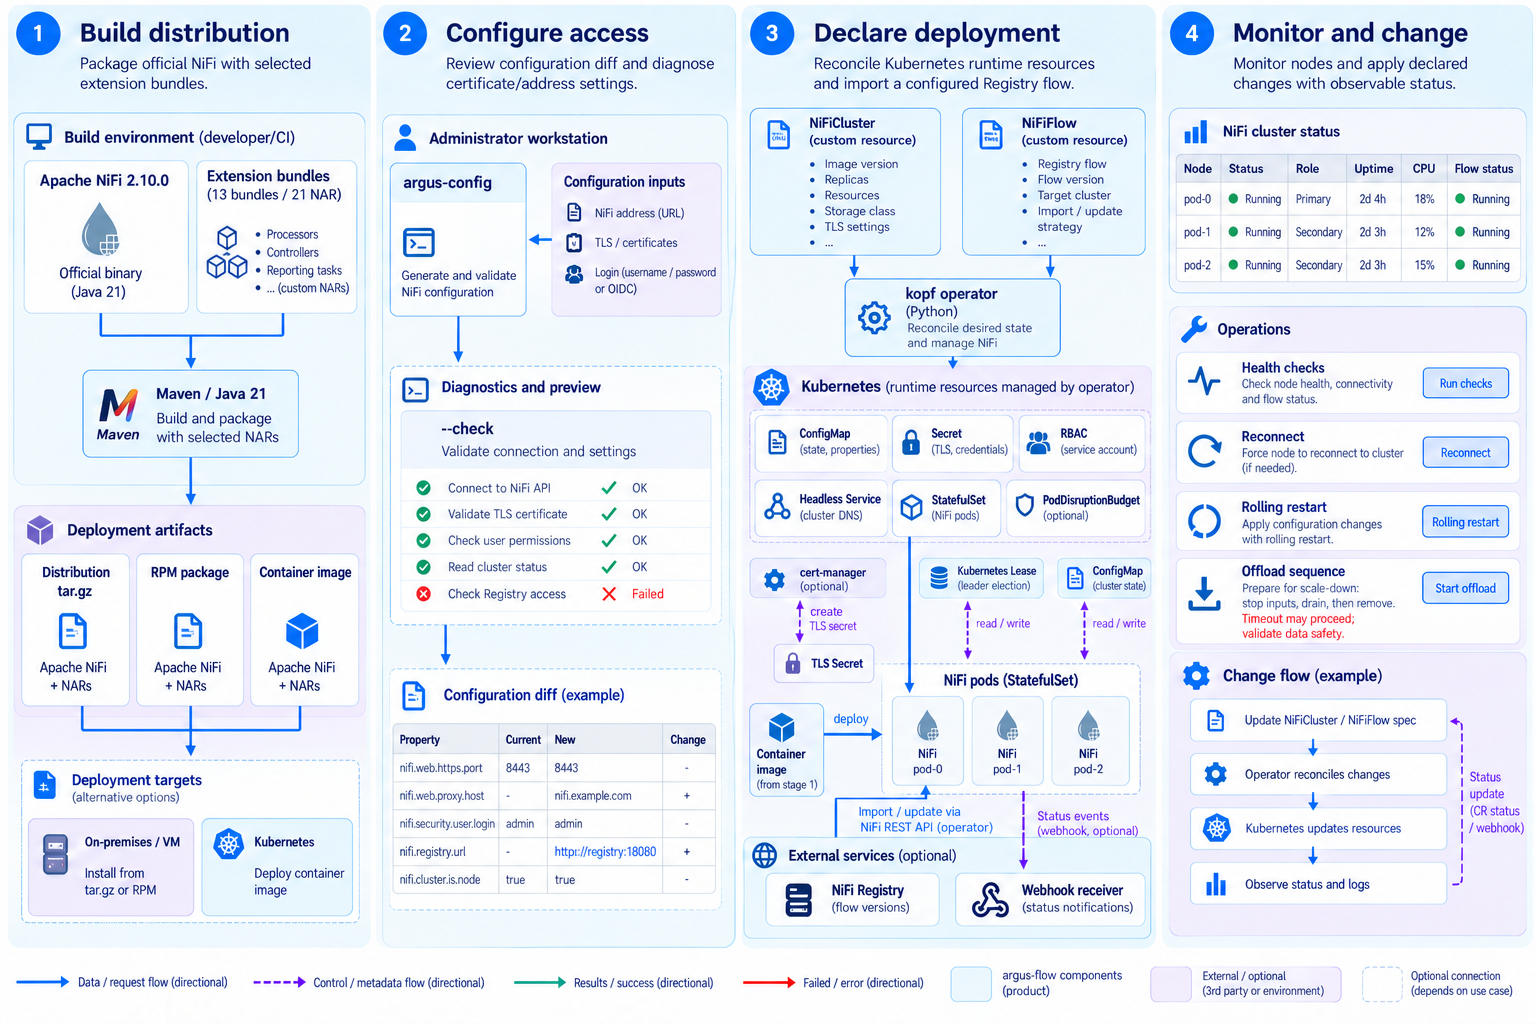
- 1.配布物のビルド
- 公式NiFiと拡張NARをtar.gz・RPM・コンテナイメージにまとめます。
- 2.接続環境の設定
- argus-configでアドレス・TLS・ログインを設定し、差分と診断を確認します。
- 3.配備を宣言
- NiFiCluster・NiFiFlowでリソースとRegistryのフローバージョンを指定します。
- 4.監視と変更
- ヘルスチェック、再接続、ローリング再起動、オフロードで変更を処理します。
Kubernetes構成はLeaseによるリーダー選出とConfigMapによる状態管理を使用します。ローリング再起動や縮小は無停止・無損失を保証しません。
GitHubの文書・コードを見るNiFiプロセッサーとコントローラーサービスの詳細
収集・クエリ・変換・保存を担う30種類のプロセッサーと、接続・シリアライズ・カタログ設定を共有する8種類のサービスです。
プロセッサー30種類
プロセッサーはFlowFileを処理します。CDCは少なくとも1回の配信を前提に重複・順序・削除を処理し、List系では別のFetchプロセッサーで実ファイルを取得します。
| コンポーネント | 分類 | 対応機能 |
|---|---|---|
CaptureChangeMySQL | 変更データキャプチャ | MySQL binlogの行変更をJSON FlowFileとして出力します。 |
CaptureChangePostgreSQL | 変更データキャプチャ | pgoutput・decoderbufsによるPostgreSQL論理レプリケーションで行変更を取得します。 |
CaptureChangeOracle | 変更データキャプチャ | Oracle LogMinerで行変更を取得し、CDB/PDB接続設定に対応します。 |
CaptureChangeSQLServer | 変更データキャプチャ | SQL ServerのCDCテーブルから行変更を読み取り、JSON FlowFileを出力します。 |
ExecuteSQL | データベース | SELECT結果をAvroにストリーミング出力。パラメータ指定、スケジュール、入力トリガーに対応します。 |
ExecuteSQLRecord | データベース | SELECT結果を指定したRecord Writerで出力し、パラメータ指定とストリーミングに対応します。 |
ExecuteFastSQL | データベース | SQL結果を複数スレッドで取得してCSV出力。バイナリはBase64、CLOBは文字列に変換します。 |
PutDatabaseRecord | データベース | レコードをINSERT・UPDATE・DELETE等に変換。トランザクションと成功・再試行・失敗の分岐に対応します。 |
BulkOracleInsertProcessor | データベース | パラメータ付きOracle INSERT ALLで一括登録。バッチ行数とタイムアウトを設定できます。 |
ListS3 | ファイル一覧取得 | 入力属性でバケット・Prefixを指定しS3一覧を取得。実データはFetchS3Objectで取得します。 |
ListHDFS | ファイル一覧取得 | 入力属性でHDFSディレクトリとフィルターを指定し、ファイル情報をFetchHDFSへ渡します。 |
ListFile | ファイル一覧取得 | 許可されたベースディレクトリ配下を処理ノードで一覧取得し、FetchFileと連携します。 |
ListSFTP | ファイル一覧取得 | 入力属性でSFTP接続先とリモートパスを指定し、ファイル一覧をFetchSFTPへ渡します。 |
ListFTP | ファイル一覧取得 | 入力属性でFTP接続先とリモートパスを指定し、ファイル一覧をFetchFTPへ渡します。 |
QueryTrinoRecord | Trinoクエリ・保守 | Trino SELECT結果をRecord Writerでストリーミングし、行数で分割。クエリID・統計を記録し停止時に取消します。 |
ExecuteTrinoStatement | Trinoクエリ・保守 | CTAS・INSERT SELECT・MERGE等を1文ずつ実行。同期・バックグラウンド・入力なしの定期実行に対応します。 |
MaintainTrinoTable | Trinoクエリ・保守 | IcebergのOPTIMIZE・スナップショット期限切れ処理・孤立ファイル削除、Delta LakeのOPTIMIZE・VACUUM、Hiveのパーティション同期を実行。3形式でANALYZEに対応します。 |
PutIceberg | レイクハウス登録 | Record Readerとカタログサービスで既存Icebergテーブルに追加。対応スキーマが必要で、CDC更新・削除は別途構成します。 |
PutDeltaLake | レイクハウス登録 | Delta Kernelでパス指定テーブルにParquetとログをコミット。未作成テーブルを作成し、基本対応はプリミティブ型とfile/HDFSです。 |
PutKudu | レイクハウス登録 | Kuduへの書き込み操作・バッチ・Flush方式を設定。列ごとのタイムスタンプ形式と時刻補正に対応します。 |
SelectHive3QL | Hive連携 | HiveQL SELECT結果をAvro/CSVに出力。定期実行・入力トリガーと取得行数属性に対応します。 |
PutHive3QL | Hive連携 | FlowFile内のHiveQL DDL/DMLを実行し、hiveql.args属性で値をバインドします。 |
PutHive3Streaming | Hive連携 | Hive 3 Streaming APIで登録し、固定値またはレコード内フィールドをパーティションに使用します。 |
UpdateHive3Table | Hive連携 | 入力スキーマに合わせてHiveテーブルを作成、または列・パーティションを追加します。 |
TriggerHiveMetaStoreEvent | Hive連携 | 入力パスとput/delete属性からHive Metastore通知を発生させます。通知リスナーの設定が必要です。 |
PutORC | ファイル形式 | Record Readerで読み取ったレコードを指定ファイルシステム上のORCファイルに保存します。 |
PutParquet | ファイル形式 | 指定スキーマでParquetを作成し、書き込み完了後に一時ファイルを最終名へ変更します。 |
MergeParquet | ファイル形式 | HDFSのParquetファイルを結合し出力パスを返します。コミット後の原本保持・削除を設定できます。 |
MultilineCsvParser | 変換・外部コマンド | 複数行フィールドのCSVを解析。区切り・文字コード・引用符・ヘッダー・列数を設定し、不正入力を失敗に分岐します。 |
PrePostExecuteStreamCommand | 変換・外部コマンド | FlowFile内容を外部コマンドへ渡し、実行前後のコマンドも設定できます。 |
コントローラーサービス8種類
コントローラーサービスは接続・読み書き・カタログ設定を共有します。名称はNiFiで選択する実際のコンポーネント名です。
| コンポーネント | 分類 | 対応機能 |
|---|---|---|
CSVReader | レコードリーダー・ライター | CSV行をレコード化し、ヘッダーによるスキーマ推論または明示スキーマとタイムスタンプ形式指定に対応します。 |
TimestampFormatAvroRecordSetWriter | レコードリーダー・ライター | バイナリAvroを出力し、スキーマ属性の時刻形式・時刻補正・圧縮を設定します。 |
TimestampFormatParquetRecordSetWriter | レコードリーダー・ライター | Parquetを出力し、スキーマ属性の時刻形式・時刻補正・INT96フィールドを指定できます。 |
Hive3ConnectionPool | データベース接続 | Hiveプロセッサー用のHive 3 JDBC接続をプール管理し、Kerberosと連携します。 |
VendorHive3ConnectionPool | データベース接続 | 外部ベンダーHive JDBCドライバーで接続をプール管理。サービス別パスとKerberosを設定し、JARは別途用意します。 |
HiveCatalogService | Icebergカタログ | Hive MetastoreでIcebergテーブル情報を管理し、PutIcebergのカタログとして使用します。 |
HadoopCatalogService | Icebergカタログ | HDFS等、アトミックな名前変更に対応するファイルシステム上でIcebergカタログを提供します。 |
StandardTrinoConnectionService | データベース接続 | DBCPService互換のTrino JDBC接続を提供。NONE・PASSWORD・JWT・Kerberos・OAuth2、セッション属性、外部JARに対応し、接続プールは使用しません。 |
PostgreSQL CDCを具体的なNiFiフローで確認
論理レプリケーション、JSON変更イベント、対象別変換、復旧をつなぎます。
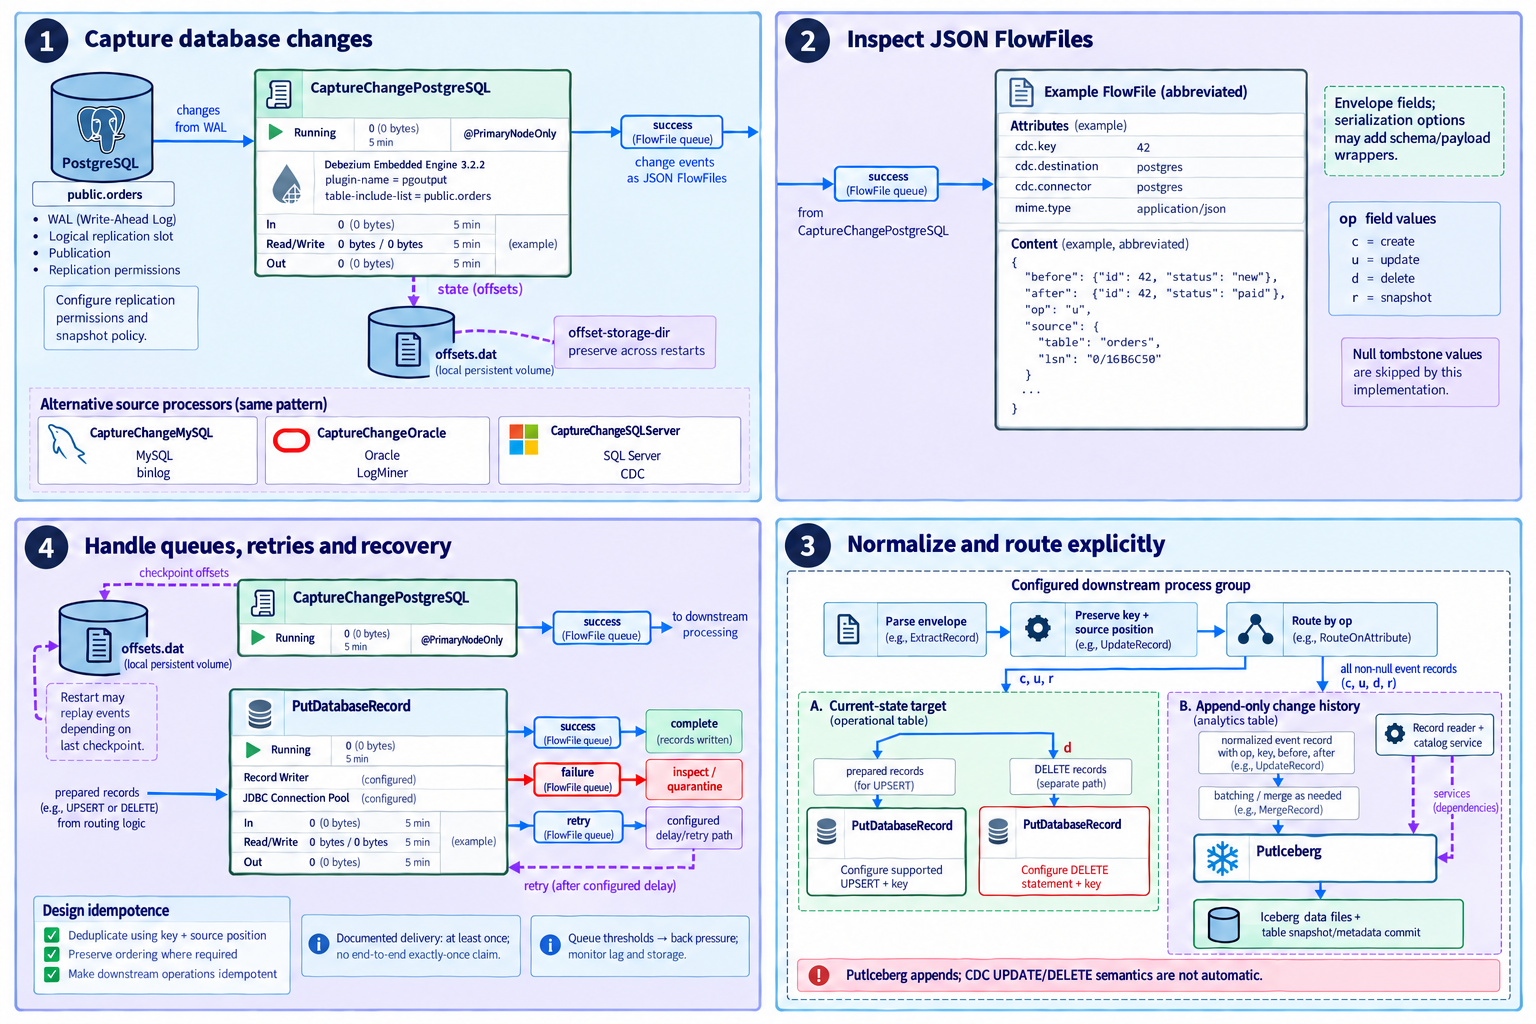
- 1.論理レプリケーションを設定
- 権限・スロット・publicationとローカルオフセット保存先を設定します。
- 2.イベントを確認
- before・after・opとcdc.keyなどの属性を確認します。
- 3.対象別に変換
- 現状反映用UPSERT・DELETEと変更履歴の追記を区別します。
- 4.復旧を設計
- 対象処理の失敗・再試行キューと再配信の重複排除を設定します。
CDC文書は少なくとも1回の配信を記載しています。重複排除、順序、削除処理には個別設定が必要です。PutIcebergの追記はCDCの更新・削除を自動適用しません。
GitHubの文書・コードを見る配布・セキュリティ・運用点検とエディション比較
公開配布版の運用機能とEnterpriseの支援サービスを整理します。
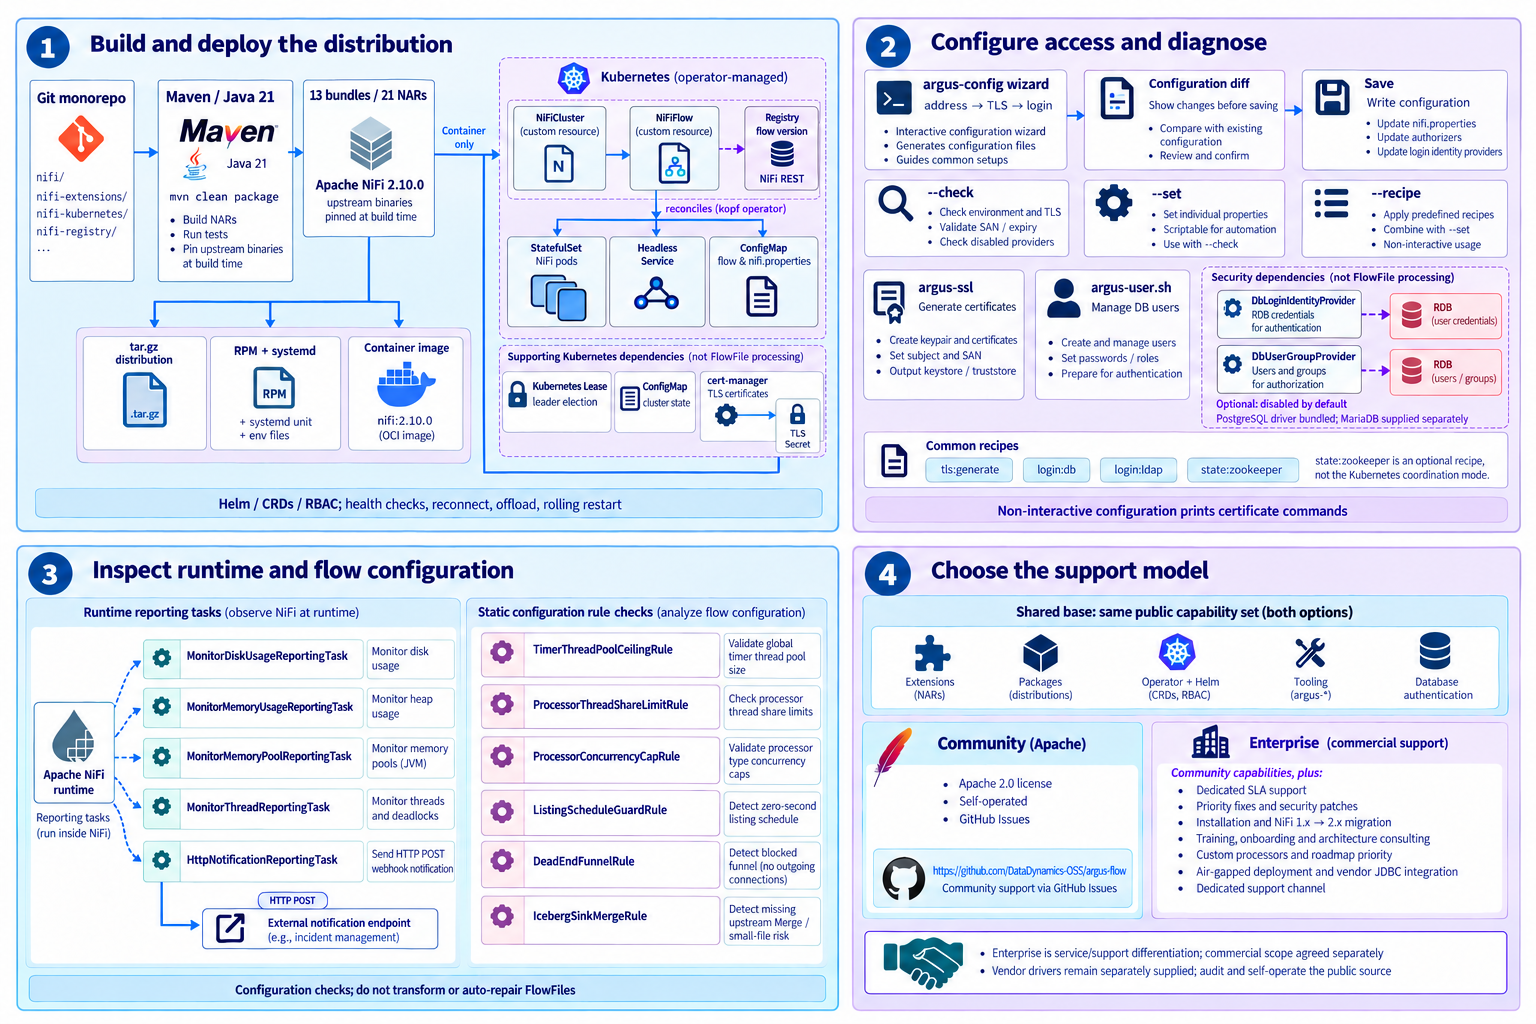
- 1.配布版を構成
- 13バンドル・21 NARを配布し、KubernetesではLeaseとConfigMapを使用します。
- 2.アクセスを設定
- アドレス・TLS・ログインを診断し、必要に応じDB認証・認可を有効化します。
- 3.運用を点検
- 5種類の報告タスクと6種類の静的ルールで点検します。
- 4.支援方式を選択
- 自社運用のCommunity、またはSLA・移行・個別開発のEnterpriseを選びます。
拡張・配布・オペレーター・ツールはCommunityで公開されます。EnterpriseはSLAと専門サービスを追加し、ベンダードライバーは別途提供です。ローリング再起動や縮小は無停止・無損失を保証しません。
GitHubの文書・コードを見るオープンソースとして公開する NiFi 運用配布版
Argus Flow は Apache License 2.0 で GitHub に公開されています。拡張バンドルのソースから配布パッケージング、Kubernetes オペレーター、運用ツールまですべてを公開し、企業がコードを自ら検証し、自社環境に合わせて拡張し、閉域網でも自前で運用できるようにしています。
- 商用利用に制約のない Apache 2.0
- アップストリーム帰属とライセンスヘッダーをビルドで検証
- オンプレミス・閉域網での自主運用