
レイクハウスの構築
DB・ファイル・API のデータを Iceberg テーブルで管理し、履歴分析と再利用を支援します。
データ収集・保存から分散データの統合分析まで。Argus Flow、Apache Airflow 3、Starburst Enterprise、MinIO AIStor を構築・運用パッケージとして提供します。
拡張性の高いオブジェクトストレージと分析用テーブルの管理機能を組み合わせます。ストレージと計算処理を分離し、Apache Icebergでスキーマ、スナップショット、データ変更を管理します。
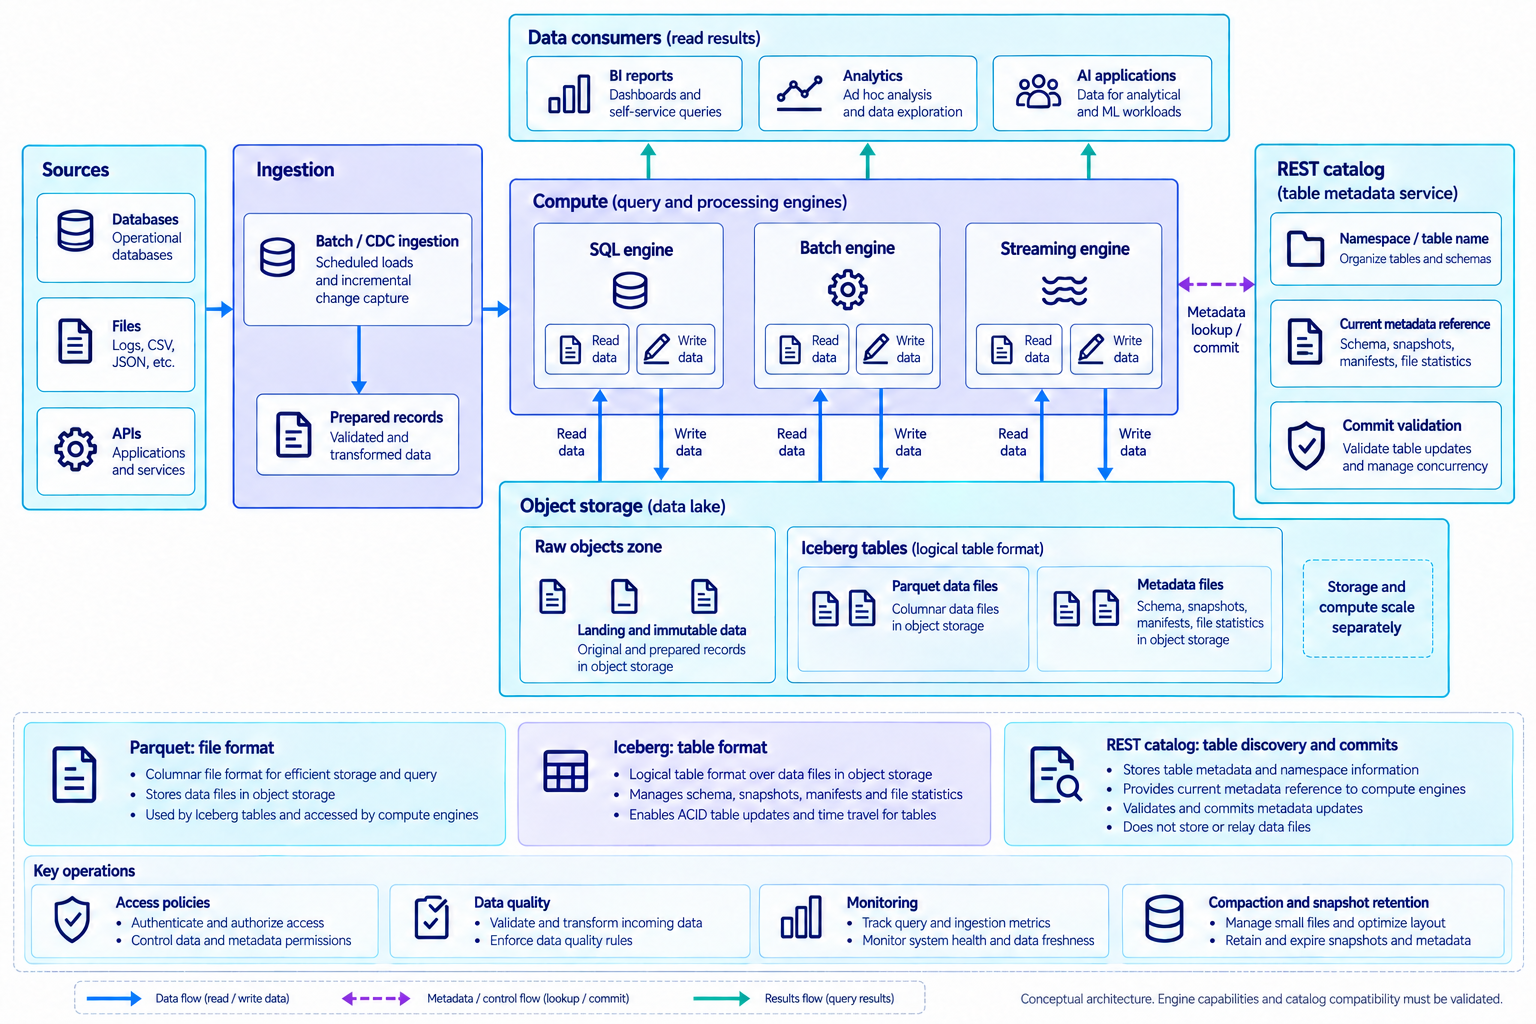
概念アーキテクチャです。SQL、バッチ、ストリーミングは用途を示し、各エンジンの読み書き機能とカタログ互換性を確認します。ストレージと計算資源はそれぞれの要件に合わせて設計します。
公式技術ドキュメント異なる役割を組み合わせ、一貫したテーブル状態でデータを利用します。
| 構成概念 | 役割 |
|---|---|
| Parquet · ファイル形式 | レコードを列指向ファイルで保存します。ファイルだけではテーブル全体のスナップショットやコミット状態を管理しません。 |
| Apache Iceberg · テーブル形式 | 複数のデータファイルをテーブルとして管理し、スキーマ、パーティション構成、スナップショット、ファイル統計を提供します。 |
| RESTカタログ | テーブル名を現在のメタデータ参照に結び付け、コミット要求を処理します。データファイルはエンジンがストレージから直接読みます。 |
| オブジェクトストレージ | データとメタデータのファイルを保存します。本プラットフォームではMinIO AIStorがS3互換ストレージを担当します。 |
Open LakehouseではArgus Flow・NiFi 2が収集・変換、Airflow 3がタスク調整、StarburstがSQL分析とテーブル処理、MinIO AIStorが保存を担当します。後続の構成図で製品間の接続を示します。
ordersテーブルへの追加例で、ファイル保存とスナップショットのコミットの違いを説明します。
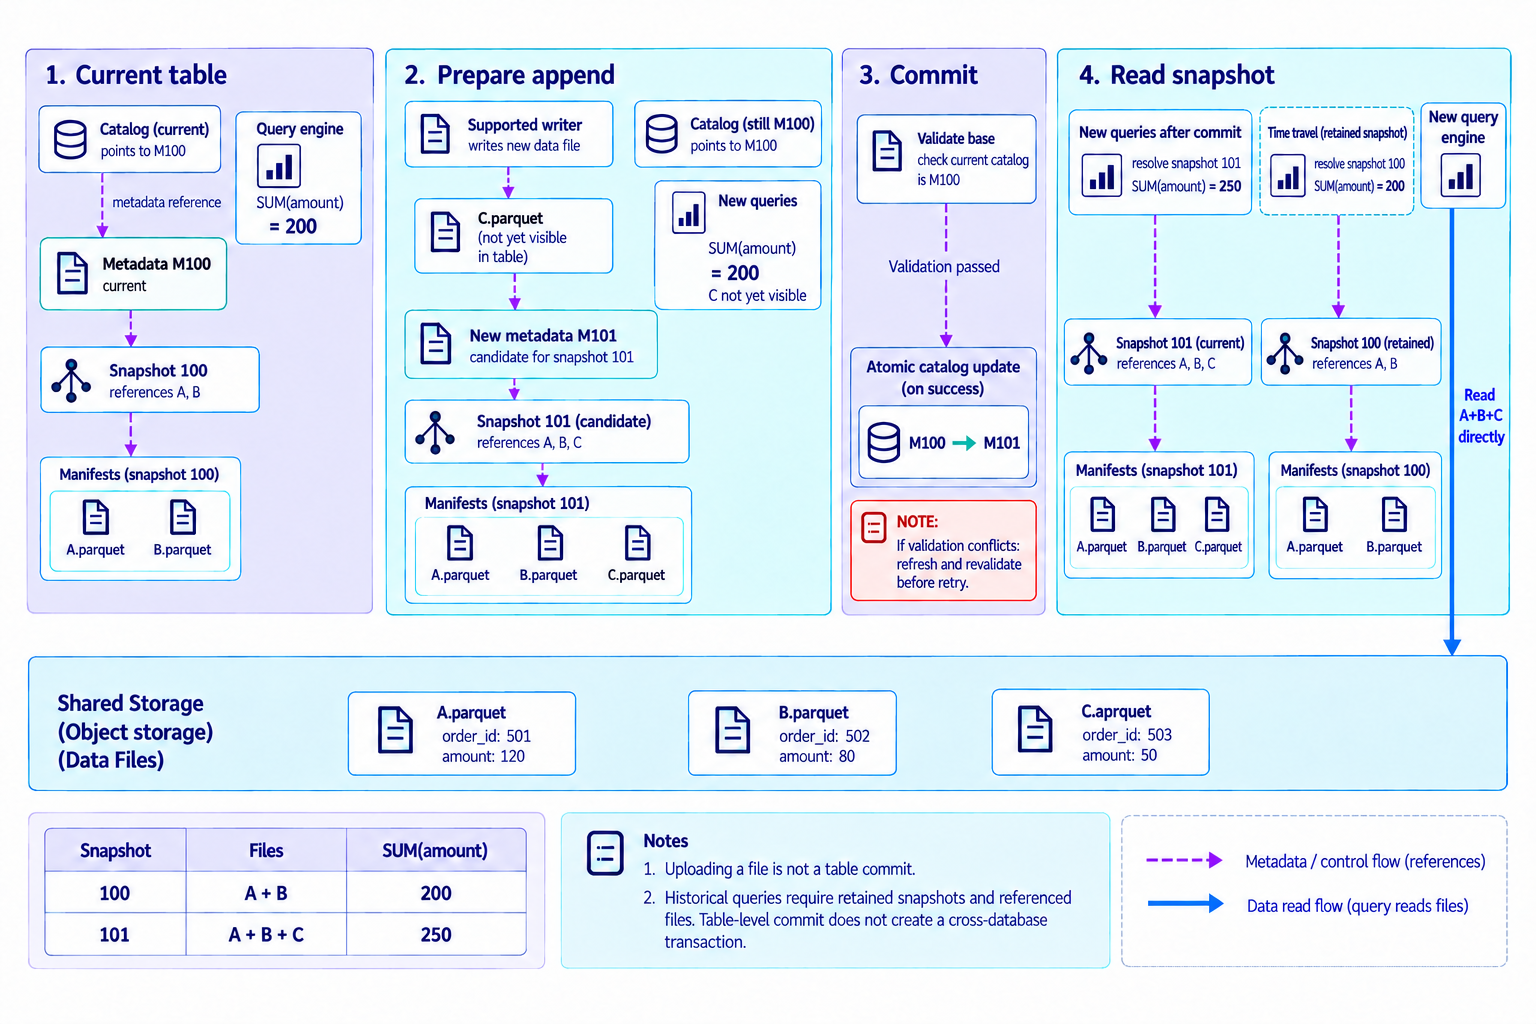
ファイルのアップロードとテーブルのコミットは別の段階です。タイムトラベルにはスナップショットと参照ファイルの保持が必要です。テーブル単位のコミットは外部DBを含む分散トランザクションを意味しません。
公式技術ドキュメントデータ変更、過去の状態の照会、保守を業務要件に結び付けます。
| 機能 | 活用価値 |
|---|---|
| テーブル単位のトランザクション | 未コミットの変更を現在のテーブル照会に公開せず、選択したスナップショットを基準に読みます。 |
| タイムトラベル | 保持された過去のスナップショットで分析結果を再現し、変更前後を比較します。 |
| スキーマ・パーティションの進化 | 対応する列・パーティション定義を変更し、データとクエリの変化に対応します。既存ファイルすべてを自動で再配置するものではありません。 |
| ファイルプルーニング | パーティションや列統計で読み取るファイルを絞ります。効果は配置、統計、クエリに依存します。 |
| データ変更の反映 | 対応エンジンでINSERT・UPDATE・DELETE・MERGEを実行します。CDC収集、重複排除、変更順序は別途設計します。 |
| テーブル保守 | 小さいファイルのコンパクション、スナップショットの期限切れ処理、未参照ファイルの削除を、実行中ジョブと保持期間を考慮して実施します。 |
エンジン、コネクタ、Icebergテーブルのバージョン、カタログ実装ごとに対応範囲を確認します。複数エンジンの同時利用と書き込み互換性は導入環境で検証します。
StarburstのIceberg読み書き・保守ドキュメント履歴をレイクハウスに蓄積し、業務システムのデータには必要に応じて直接接続します。
DB・ファイル・API のデータを Iceberg テーブルで管理し、履歴分析と再利用を支援します。
全データの事前コピーを必須とせず、Starburst の SQL と JOIN で複数のソースを分析します。
Data Dynamics が設計、構築、連携、データ検証、性能測定と運用手順を整備します。
レイクハウスへの収集と、既存ソースへの直接接続を組み合わせます。
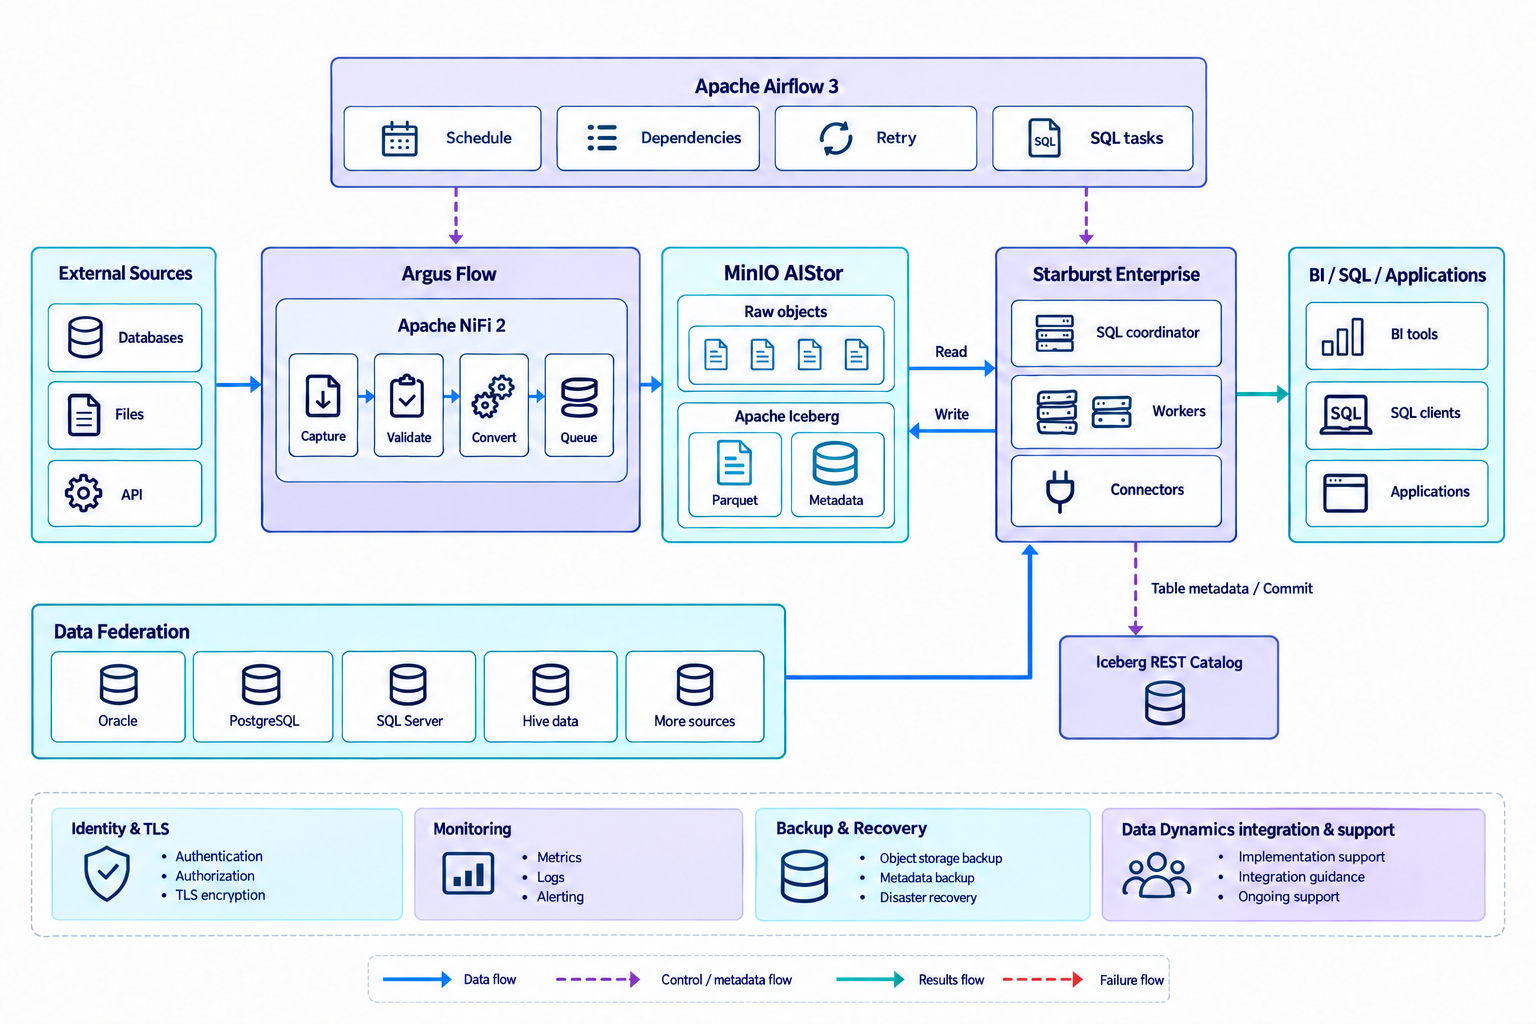
Iceberg はテーブル形式、MinIO AIStor はストレージです。REST カタログは参照構成であり、実装・バージョン・認証・書き込み経路を導入時に検証します。
公式技術ドキュメント業務に合わせたデータフローと運用基準で各製品を接続します。
| 構成要素 | 担当機能 |
|---|---|
| Argus Flow · Apache NiFi 2 | プロセッサーとコントローラーサービスによる収集、CDC、変換、転送、キュー管理と再処理。 |
| Apache Airflow 3 | スケジュールと依存関係、後続 SQL、品質検査、テーブル保守の実行を調整。 |
| Starburst Enterprise | 各種 DB のフェデレーション、ソース間 JOIN、Iceberg の読み書きと分散 SQL。 |
| MinIO AIStor | 原本、Parquet、Iceberg メタデータ用の S3 互換ストレージと商用サブスクリプション・技術支援。 |
| Apache Iceberg · REST カタログ | スナップショットとテーブルメタデータを管理。実装、認証と書き込み互換性は導入時に検証します。 |
Oracle、Hive・Impala 環境を含む多様なソースの接続を設計します。
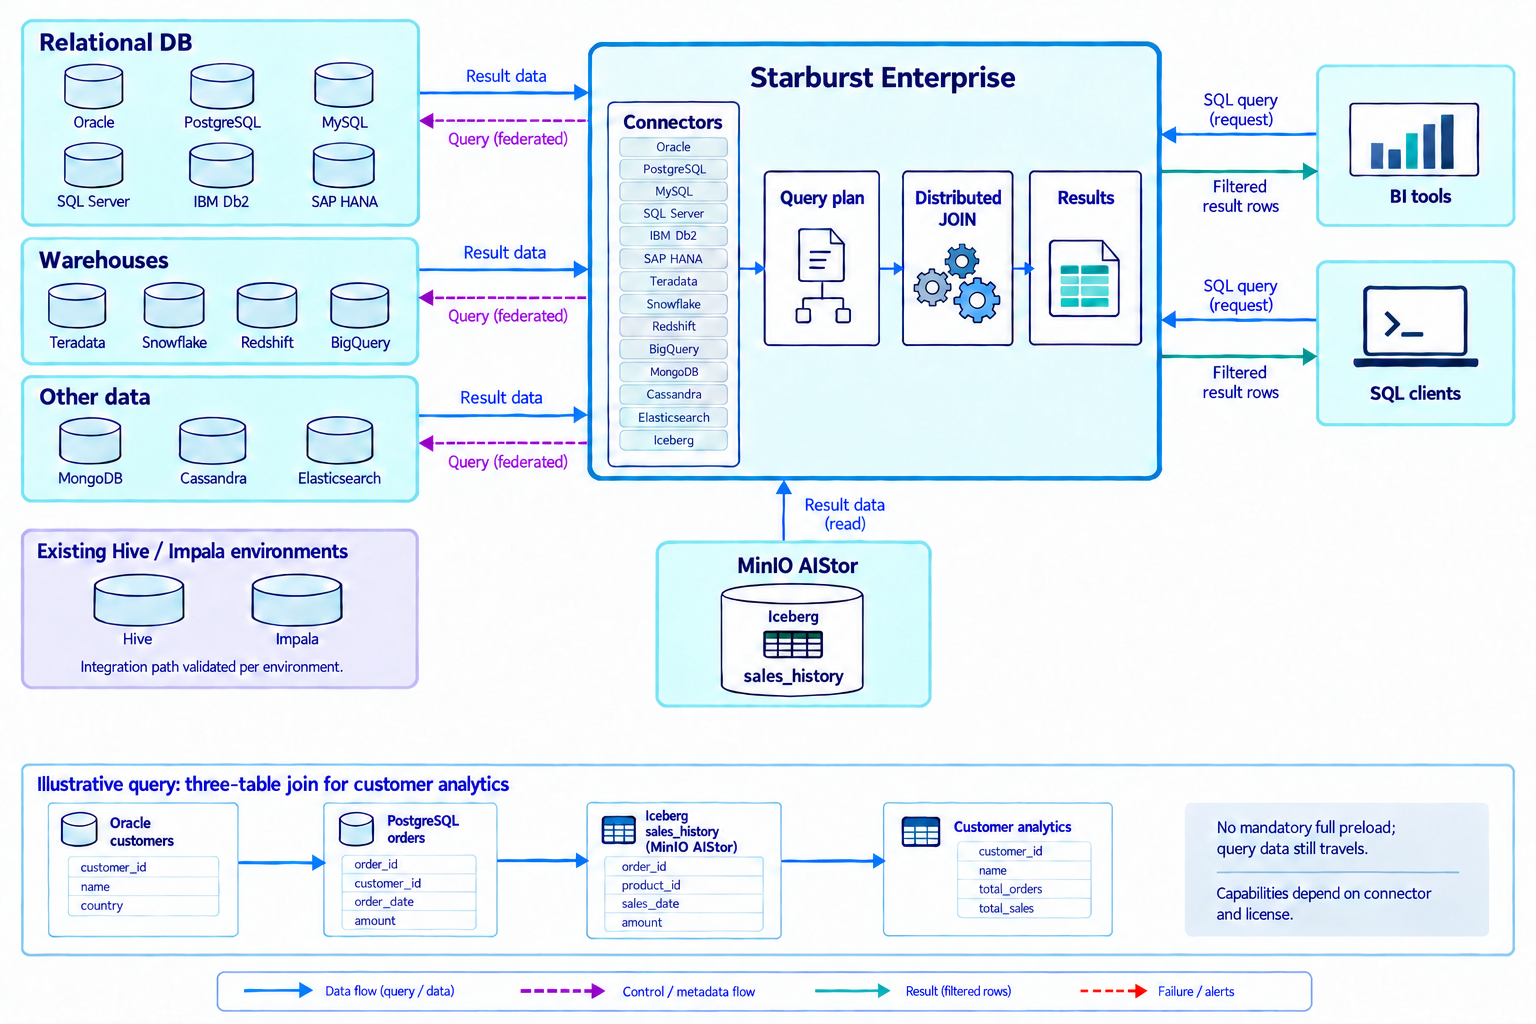
全データの事前集約を減らせますが、クエリ実行中のデータ転送は発生します。ソースの負荷と権限も管理します。
公式技術ドキュメント業務 DB、既存分析環境、クラウドウェアハウスとレイクハウスを SQL で分析します。
| 接続領域 | 代表的なソース |
|---|---|
| リレーショナル DB | Oracle · PostgreSQL · MySQL · SQL Server · IBM Db2 · SAP HANA |
| データウェアハウス | Teradata · Snowflake · Amazon Redshift · Google BigQuery |
| NoSQL・検索 | MongoDB · Cassandra · Elasticsearch |
| 既存ビッグデータ環境 | Hive · Impala 環境 — 既存テーブル、ストレージとアクセス方式に応じて接続経路を設計 |
| プラットフォーム内のレイクハウス | MinIO AIStor に保存した Apache Iceberg テーブル |
機能・認証・ライセンスはコネクターによって異なります。専用 Impala コネクターの正式サポートを前提とせず、既存環境のアクセス経路と互換性を検証します。Generic JDBC は PoC 向けに検討し、本番サポートは別途確認します。
Starburst コネクターのサポート範囲プロセッサーのデータ処理と後続タスクの順序を接続します。
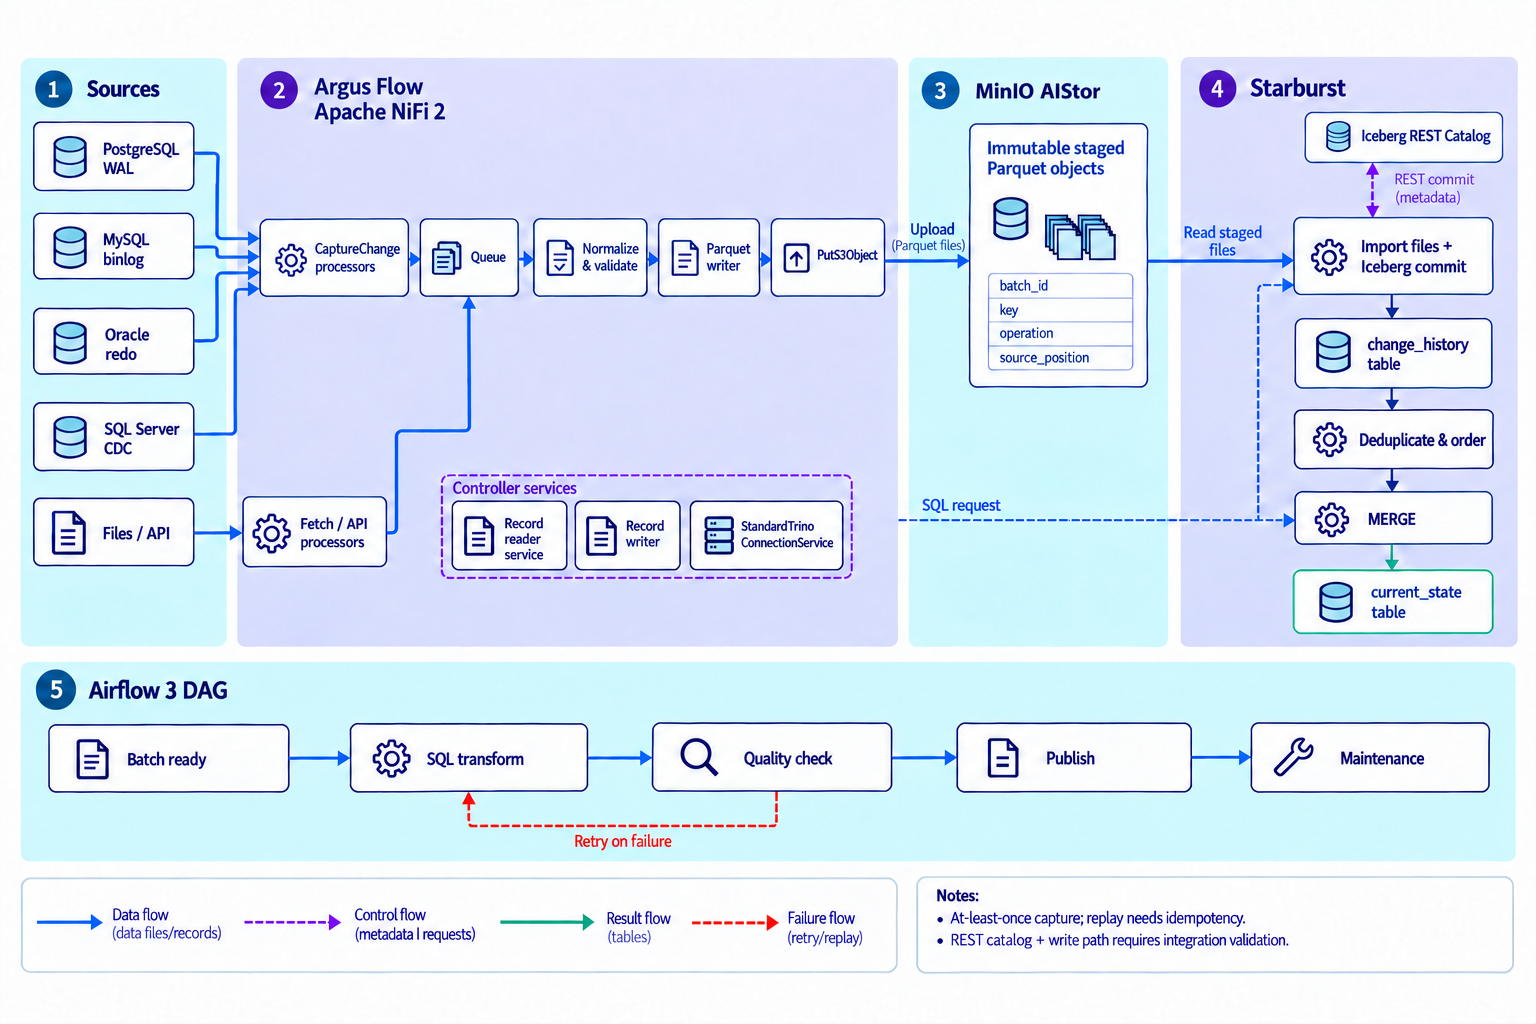
参照経路は S3 アップロードと Starburst のファイル登録を使用します。add_files はスキーマを検証しないため、スキーマ・パーティション検証、重複登録防止と保存ポリシーを構成します。NiFi PutIceberg から REST カタログへの直接書き込みは前提にしません。
公式技術ドキュメント商用サブスクリプションと技術支援を含む企業向け構成です。
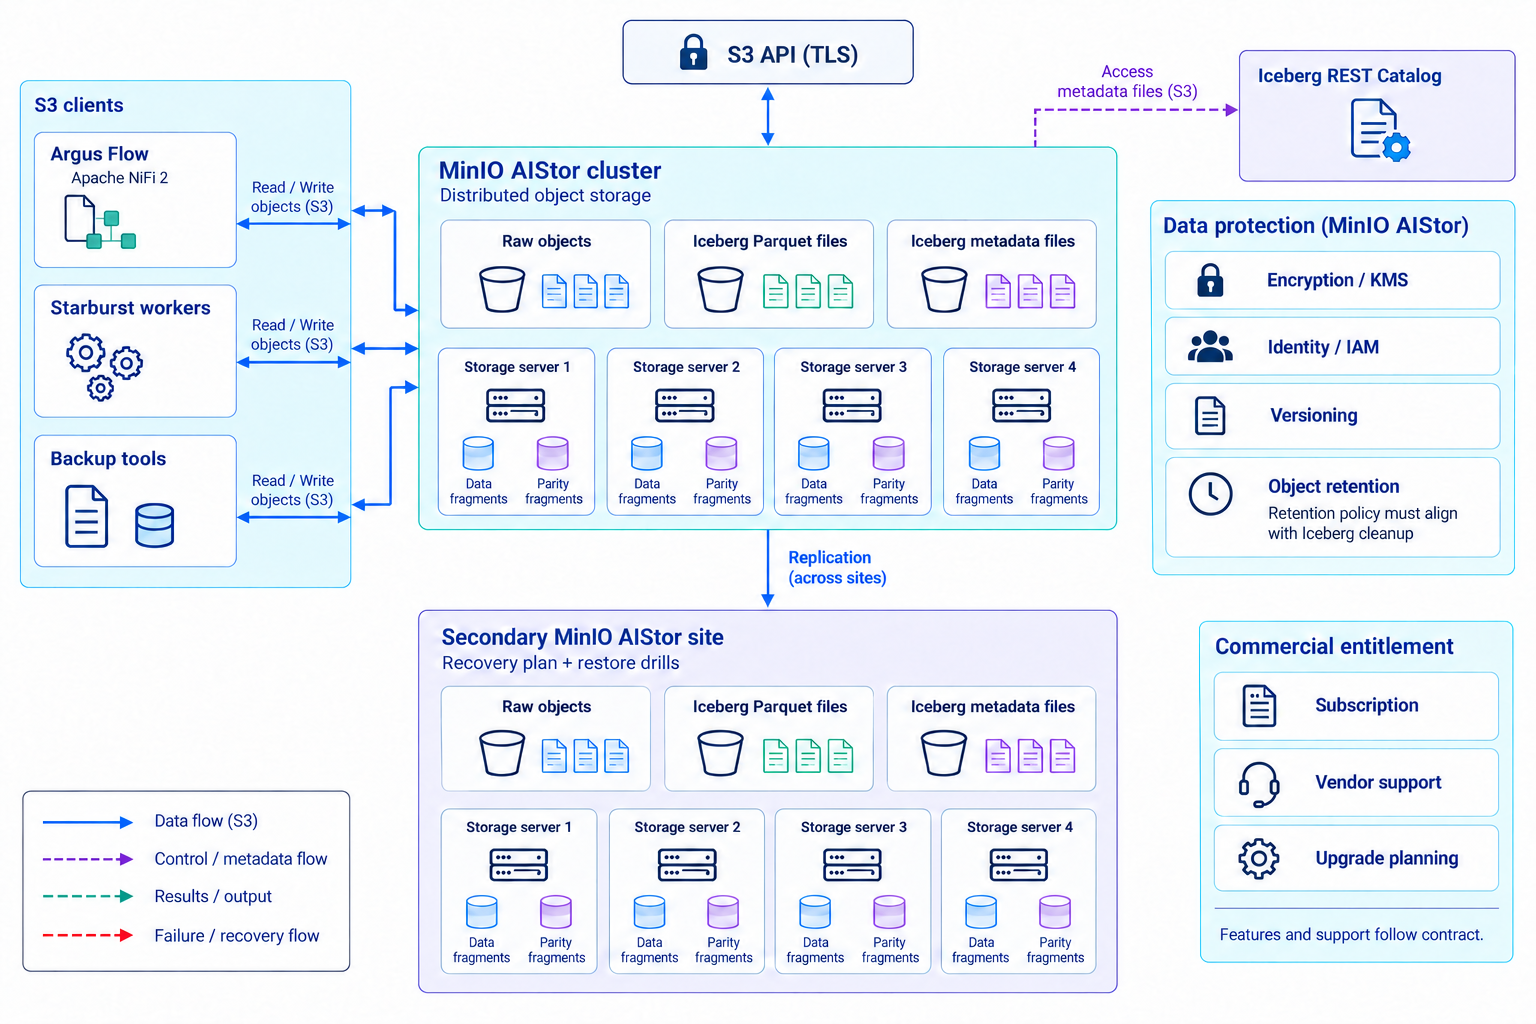
契約製品の提供範囲を確認し、保持・ロックと Iceberg のファイル整理を調整します。
公式技術ドキュメントDB プッシュダウンと Iceberg のスキャン最適化を区別します。
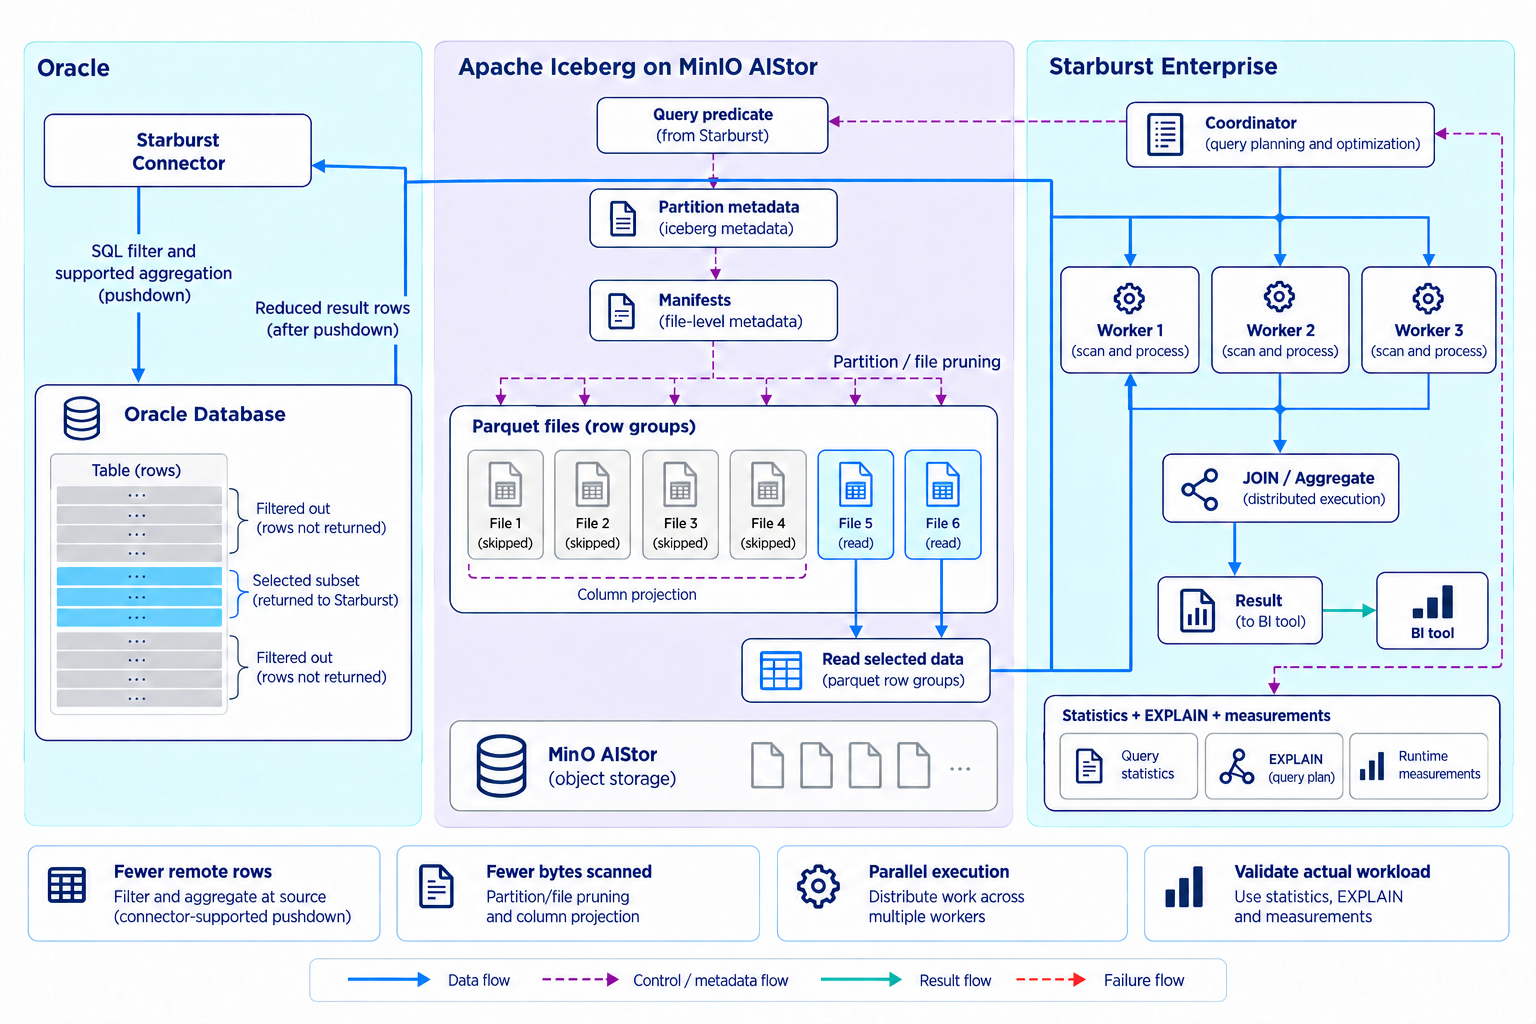
対応範囲はコネクターとクエリによります。MinIO AIStor は SQL を実行しません。データ分布、統計、ネットワークと同時実行条件で実測します。
公式技術ドキュメント処理・クエリ・保存状態を監視し、復旧と保守を反復可能にします。
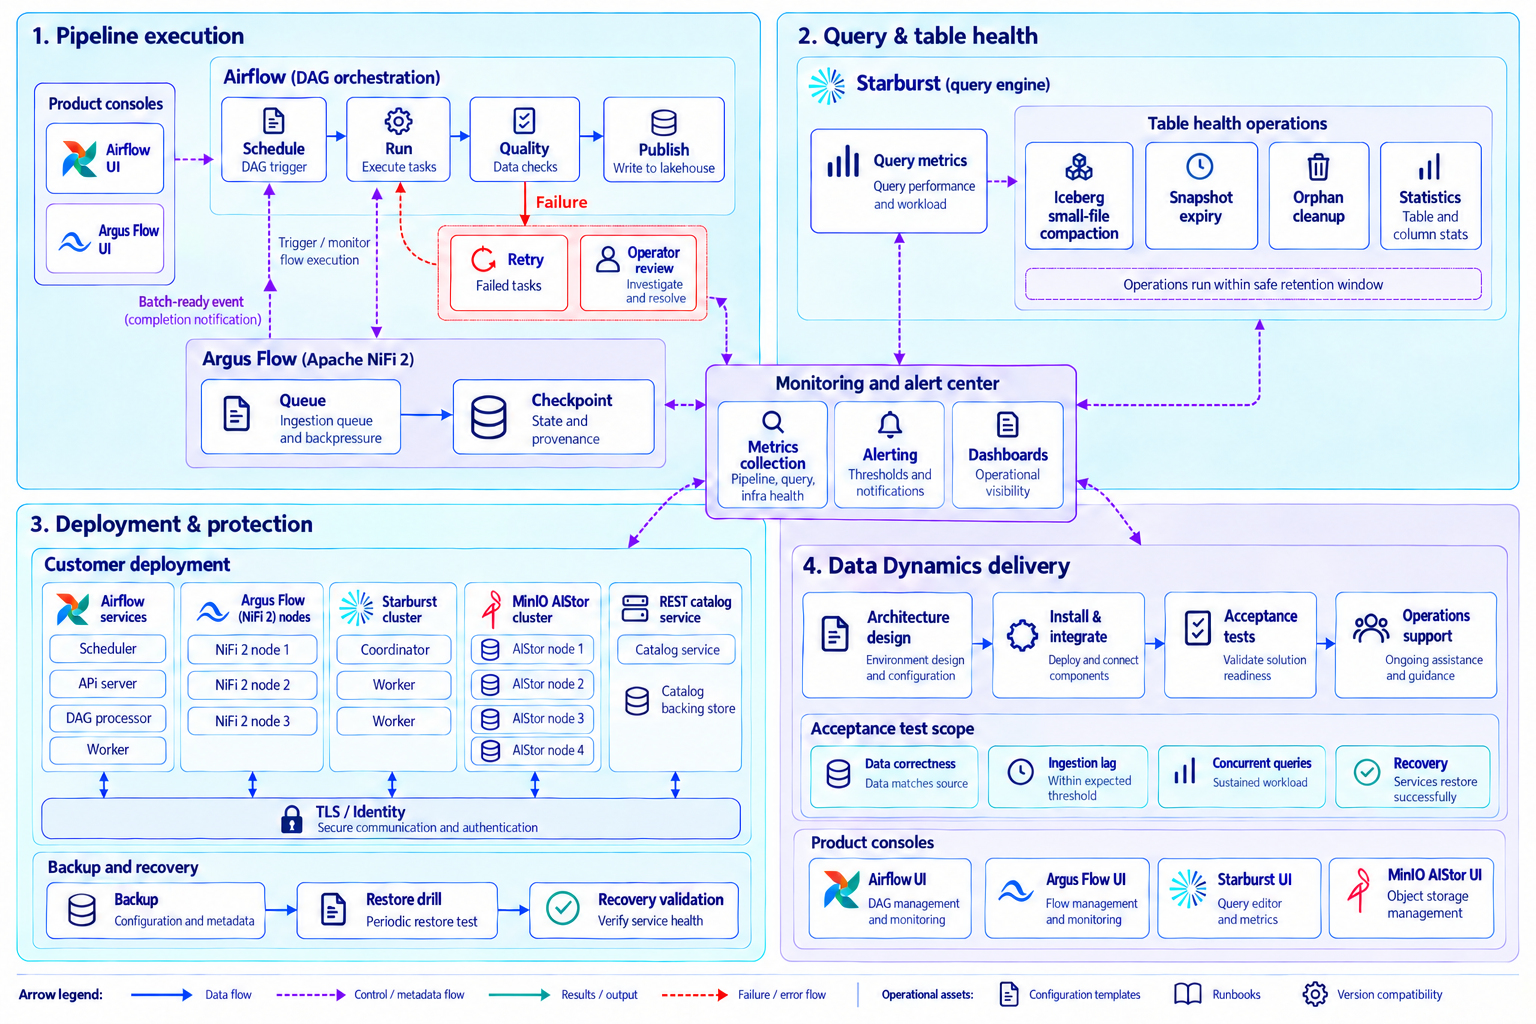
再試行では冪等性を確保し、スナップショット・孤立ファイルの整理は実行中の処理と保持期間を考慮します。復旧目標は訓練で確認します。
公式技術ドキュメントデータフロー、受入基準と運用手順を含めて提供し、範囲とサポート条件を契約で定義します。
代表データとクエリで連携を検証し、容量、同時実行、セキュリティと復旧要件を定義します。
バージョン構成、テンプレート、NiFi フロー、Airflow DAG、認証、監視と運用手順を整備します。
障害窓口、ベンダー連携、更新時の互換性、性能確認とバックアップ・復元訓練を支援します。
製品別コンソールを利用する統合構築・運用パッケージです。MinIO AIStor と Starburst の製品、ライセンスとサポート範囲は提案・契約で確定します。
構成要素の詳細と拡張の選択肢をご確認ください。